TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Google 將 Gemini 3.8 Live 與 Extended Thinking 兩款即時語音模型轉正式版並開放 API,音訊輸入每分鐘 0.005 美元,第三方實測每小時成本 0.84 美元,推理與代理成績登上語音模型排行首位,直接對上 OpenAI 的 GPT-Live-1。
用 AI 摘要這篇文章:
Google 在台北時間 9 月 16 日凌晨把兩個即時語音模型送上正式版:Gemini 3.8 Live 與 Gemini 3.8 Live Extended Thinking。這次發布對開發者的意義,是 Google 頭一回把「反應快、好聊」和「背景推理強」拆成兩個各自穩定的型號讓你按場景選性格,再配上一張把音訊、文字、思考全部包進去的單一價目表。
先講結論給正在選型的人:熱線客服、前台對話這類講求流暢的場景,選標準版 3.8 Live,它的人類偏好評分與任務完成率都在第三方排行前列,實測成本也是付費同類最低;需要多步驟推理的語音代理,才上 Extended Thinking,它的綜合指標是目前語音模型最高,但代價是成本四倍出頭,真人盲測裡反而沒有標準版討喜。
照 Gemini API 官方更新日誌的記載,9 月 15 日這兩個模型「generally available」,脫離預覽轉為正式版。Google DeepMind 的官方部落格在同日發布公告,Google AI Studio 的 Logan Kilpatrick 隨後在 X 上宣布,時間戳經雙重驗證為 UTC 9 月 15 日 17 時 13 分,換算台北時間是 16 日凌晨一點多。模型頁面上,兩個型號都掛上了 New Stable 標籤。
兩款模型的官方定位寫得很直白。gemini-3.8-live 是「多數低延遲語音代理體驗的預設選項」,不需要推理等待;gemini-3.8-live-extended-thinking 則是「高推理語音模型」,在直播音訊互動中做背景推理,官方建議用在需要更深推理的請求。用白話說:一個負責即時接話,一個負責邊想邊講。
同一天還有一個容易被忽略的變動:上一代的 Gemini 3.1 Flash Live 被標為 legacy,官方文件建議直接更新到 3.8 Live。如果你的語音代理還掛在 3.1 Flash Live 上,這次屬於官方把遷移建議直接寫進模型對照表的等級,不是可選的順手升級。
有個身分細節值得注意:模型本身是穩定版,但承載它們的 Live API 整體仍標示為 Preview。正式產品可以接,但介面後續仍有調整空間,這點會影響你綁定多深。
Google 在公告裡自己引用了 Artificial Analysis 的語音對語音排行榜,說 Extended Thinking「排名第一」。該排行確實如此,但把整張表拆開看,會看到更有選型價值的故事:兩個型號在不同欄位互換領先。Artificial Analysis 的 Speech to Speech Index 是推理、代理任務、人類偏好、任務成功率的加權總分,截至 9 月 16 日造訪的快照如下:
| 模型 | Index | 人類偏好 Elo | 任務成功率 | 代理任務 | 每小時實測成本 |
|---|---|---|---|---|---|
| Gemini 3.8 Live Extended Thinking (High) | 82.6 | 990 | 89.1% | 68.6% | $3.50 |
| GPT-Live-1(Astra 後端) | 81.5 | 1048 | 87.4% | 67.9% | $5.83 |
| Gemini 3.8 Live 標準版 | 76.0 | 1083 | 93.2% | 30.1% | $0.84 |
綜合指標的部分,Extended Thinking 的 82.6 確實居首,贏過 OpenAI 上週才開放 API 的 GPT-Live-1(Astra 後端 81.5),Google 把這點寫進官方公告不意外。
但看人類偏好 Elo,標準版 3.8 Live 拿到 1083,是全表第二,僅次於自家舊款 3.1 Flash Live Minimal 的 1096;深想版的 Elo 反而只有 990,落到中段,明顯落後 1048 到 1096 的前段集團。任務成功率也是標準版 93.2% 領先深想版的 89.1%。真人盲測裡,「更會想」的模型比較不討喜:合理推測是回應前的思考停頓與進度旁白吃掉了對話手感,這個代價在偏好欄位被誠實反映了出來。
代理任務欄位的差距最戲劇化:深想版在 τ-Voice 客服情境解決率 68.6% 全表最高,標準版只有 30.1%,中間夾著 GPT-Live-1 的 67.9%。換句話說,「好聊」的模型一遇到要連續呼叫工具、多步驟完成的場景,成功率就掉到三成。這正是 Google 拆成兩個型號銷售的理由,也是選型時唯一要回答的問題:你的語音代理是在陪聊,還是在辦事。對手動態順帶定位:GPT-Live-1 的 Astra 與深想版的代理成績只差 0.7 個百分點,兩家在綜合指標與代理成績已經貼身(Astra 這個引擎的提示詞寫法我們先前整理過),差別拉開在計費結構與價格。
看這張榜還要帶著它的量測限制讀。Artificial Analysis 在代理欄位特別註記:GPT-Live-1 的兩個後端版本各只跑了 1 次試測,GPT-Realtime-2.1 High 是 2 次,樣本窄的數字本來就更容易抖動;τ-Voice 情境也只涵蓋全雙工模型,25 款裡有量到分數的是 18 款。再往榜單下看,Grok Voice Think Fast 2.0 以 81.3 緊咬在兩強之後,Deepslate 等新面孔也在擠進來。82.6 的「第一」是真實的,但它是 9 月 16 日這一天的快照,不是長期格局。
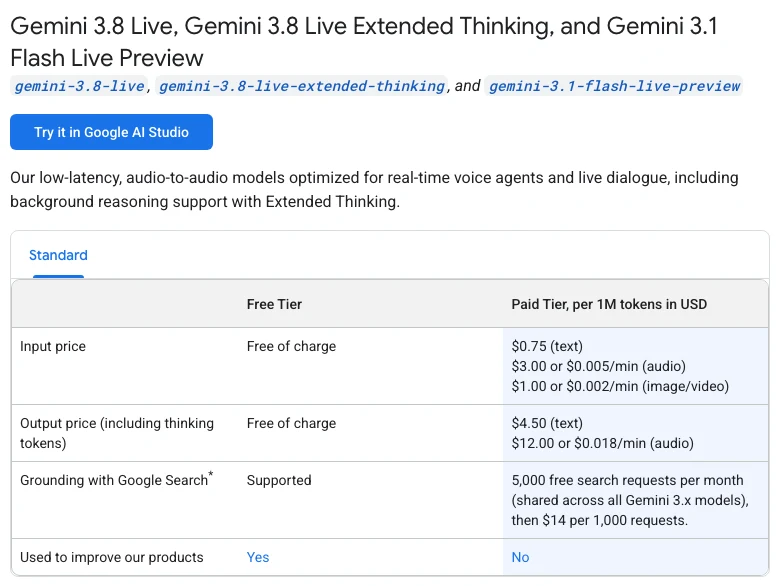
官方公告的定價逐字是「音訊輸入每分鐘 0.005 美元、音訊輸出每分鐘 0.018 美元」。直接換算:一小時的語音輸入約 0.30 美元,一小時的語音輸出約 1.08 美元,純語音對話來回一小時的成本約 1.38 美元。定價頁同一張卡上,文字輸入是每百萬 tokens 0.75 美元,文字輸出每百萬 4.50 美元,而且註明思考產生的 tokens 也照文字輸出計費。兩個型號共用這張價目表,價差來自深想版會多想、多講。
真正的重點在計費結構。OpenAI 的 GPT-Live-1 把帳單拆成兩層:每分鐘 0.05 美元的語音層,加上後端推理模型的 tokens 費用另計,我們先前拆解過這個設計。Google 這邊沒有分層,音訊進、音訊出、文字思考全部在一張價目表內,預估成本時不需要猜後端用了多少 tokens。對要把語音代理的成本算給財務看的人,這個差異比單價本身更實際。
第三方實測可以佐證結構差。Artificial Analysis 用固定的 40 題語音基準子集,按輸入音訊長度把完成任務的成本換算成每小時數字:標準版 3.8 Live 是 0.84 美元,是表列付費原生語音模型中最低;深想版 3.50 美元;GPT-Live-1 的 Astra 後端 5.83 美元、Sol 後端 4.47 美元。這不是價目表的數學換算,而是跑完同一組任務的實際帳單,同口徑下標準版與 Astra 版差了將近七倍。要留意的是,這個數字對應基準任務的輸入長度分布,實際用量結構不同,倍數會浮動,但量級差距很難翻轉。這也是今年模型市場的主旋律之一:DeepSeek 用 token 價格換代、Google 用語音計費結構壓低成本,價格競爭已經打到每個品類。
價目表上還有兩行對實際部署有感。走視覺情境的話,影像輸入是每分鐘 0.002 美元或每百萬 tokens 1.00 美元,「看得見」的代理成本比純語音再加一層但不算貴。接 Google 搜尋接地(Grounding with Google Search)的話,每月 5,000 次查詢免費,名額跨所有 Gemini 3.x 型號共用,超過後每 1,000 次 14 美元,而且官方提醒一次使用者請求可能觸發多筆搜尋查詢、逐筆計費。要讓語音代理即時查外部資料的團隊,這行要先算進去。
免費層能直接試,但定價頁有一行要先看清楚:免費層的「Used to improve our products」欄是 Yes,付費層才是 No。用免費額度做的測試對話,會被 Google 拿去改進產品。要拿真實客戶情境驗收,直接上付費層比較乾淨。
價格與成績之外,這次更新的工程差異集中在官方模型對照表裡,三個地方最容易出事。
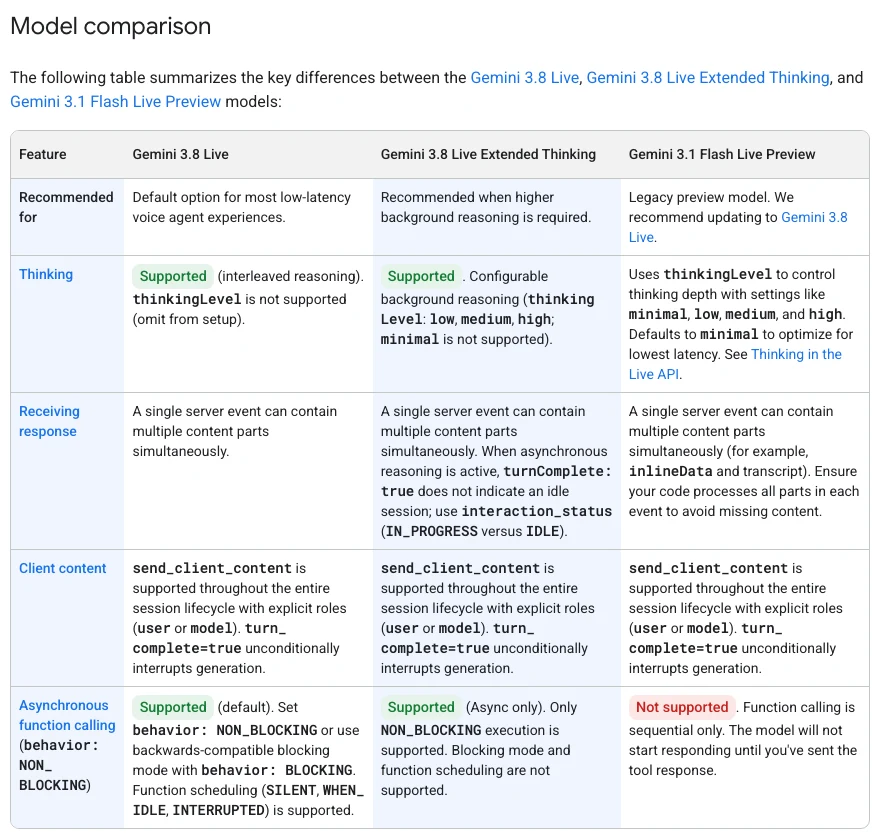
函式呼叫的行為分了梯度。標準版 3.8 Live 預設走非同步(NON_BLOCKING),工具在背景執行的同時模型繼續講話,但也保留阻塞模式(BLOCKING)當相容選項,還支援 SILENT、WHEN_IDLE、INTERRUPTED 三種工具排程。深想版只支援非同步,阻塞模式與排程都不給。舊的 3.1 Flash Live 則完全不支援非同步,工具呼叫是順序式的,模型會等你回傳工具結果才開口。從 3.1 遷移的專案,除非顯式設成 BLOCKING 維持舊語意,否則工具呼叫這段要重新檢視。
事件語意也變了。官方文件明寫:在深想版上,當非同步推理進行中,turnComplete: true 不再代表 session 空閒,要改用 interaction_status 的 IN_PROGRESS 與 IDLE 來判斷。客戶端邏輯如果是靠 turnComplete 決定何時開放麥克風,搬上深想版後這段判斷必須換掉,否則會在模型還在想事情時就把話權交回使用者。
思考深度的設定同樣分家。標準版 3.8 Live 不支援 thinkingLevel,設定裡必須整個省略;深想版支援 low、medium、high 三檔,minimal 不提供。這也是兩個型號性格分歧的程式面證據:標準版的推理是交錯進行、不可調,深想版才能把背景推理當參數轉。
對照表裡還有一條對舊專案友善的延續:兩個新型號都支援在整個 session 生命週期裡用 send_client_content 帶明確角色(user 或 model)送入內容,而且 turn_complete 設 true 時會無條件打斷生成中的回應。舊版一個伺服器事件可能同時塞多種內容型別,官方特別提醒程式要把每個事件的全部 parts 都處理到,否則會漏內容;深想版又因為背景推理的關係,同一個事件流裡會攪進進度旁白與思考後的最終回答兩種節奏,前端狀態機要照 interaction_status 去分派,不能只認單一事件。
API 之外,這批模型的消費端去向,發布當天就跟著定案。據 9to5Google 引述 Google 提供的素材,Extended Thinking 已開始推送進 Gemini Live app,Gmail 的對話搜尋、Docs 的草稿生成、Keep 的筆記功能用的也是它;標準版 3.8 Live 則會驅動 AI Mode 裡的 Search Live 語音搜尋。你在 Google 自家產品裡講話的對象,跟 API 裡買到的是同一批模型,這對穩定性的意義比任何行銷文字都大。
官方公告列的能力清單裡,有兩項對企業場景特別實用。一是視覺情境,模型可以接著直播的視覺輸入對話,做「看得見」的語音代理;二是英數精確度,官方明說能正確解析確認碼、理賠編號這類技術性內容,這正是過去語音模型最常出錯、也最讓客服系統不敢上線的一環。語言支援是 97 種,原生音訊模型會在對話中自然切換語言;不過中文在清單上是單一條目,沒有區分繁簡,而且官方文件明言無法強制指定語言代碼,只能靠系統指令去限制。
有幾件事只能標註為未定,引用時請留意層級。Google 向媒體提供的成績單裡有一項「Sierra τ-Voice-banking 銀行情境 35.1%」,這個數字目前只在 9to5Google 的報導裡出現,Google 官方文件沒有對應頁面,同情境也沒有其他獨立來源可對照;同一份成績單裡的 Big Bench Audio 97.7%,倒是與排行頁顯示的 98% 四捨五入後一致。消費端的推送時程也只有「開始推送」四個字,何時全量上線沒有承諾。
排行數字本身也有保存期限。排行快照取於 9 月 16 日,GPT-Live-1 上週才開放 API,兩家都在快速迭代,兩週內回查一次是合理頻率;價格同理,任何一方調整價目表,上文的成本倍數就要重算。至於實際通話品質、延遲體感、中文口音的表現,排行榜回答不了,訂了 API 自己跑一輪語料再下判斷。
整體看下來,這次發布把即時語音代理的選型題從「哪家模型最強」換成「你的場景要哪種性格」,再用一張全包的價目表把試錯成本壓到願意實驗的水位。模型市場打到語音這一局,競爭的單位已經從能力清單變成性格與帳單結構,這對開發者是好事。
要動手的話,入口在 Google AI Studio 的即時語音頁,公告裡附了 GitHub 範例與 live api skill,Agora、LiveKit、LangChain、Pipecat、Vercel 等整合夥伴都已經掛上支援。先用免費層確認行為符合預期,正式驗收換付費層,在 AA 實測的付費行列裡,這條路徑已經是最低價。