TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

NVIDIA GEAR 團隊開源機器人框架 ASPIRE v1.0,讓程式代理自己寫控制程式並把驗證過的修法收進技能庫。同一套框架換上更強的後端模型,LIBERO-Pro 任務成功率就從 15% 跳到 99%,但真機端官方只給了四個操作展示,99% 的計分範圍值得分開讀。
用 AI 摘要這篇文章:
NVIDIA 的 GEAR 研究團隊在台北時間 10 月 17 日凌晨 0 點 15 分,由計畫共同主持人 Jim Fan 在 X 發文宣布,機器人框架 ASPIRE 以 v1.0 版開源,這一版補上了完整的真機技能發現與自我改善能力。貼文裡最值得停下來讀的一句話是:Astra 到站當天,實驗室把後端模型換掉,一夜之間把所有基準洗到約 99%。機器人不重訓任何權重,只換掉寫程式的語言模型,成績就整批跳級。這個架構選擇對機器人開發的意義,比任何單一表演都大,但它同時決定了 99% 這個數字該怎麼讀:那是在模擬基準上,真機端官方只給了四個操作示範。
ASPIRE 是 NVIDIA 與密西根大學、UIUC、UC 柏克萊、卡內基美隆合作的研究專案,論文在 6 月 30 日送交 arXiv,儲存庫 7 月 8 日公開。官方 README 的動態欄把前後差異寫得很清楚:今年 6 月的初版用 Claude Opus 4.6 當後端,在三個模擬套件拿到當時最佳成績,端出的是收桌子的跨模擬到真機轉移;10 月的 v1.0 則宣布機器人能解魔術方塊了,並在 80 個 LIBERO-Pro 的 Goal、Object、Spatial、Long 任務加上選定的 Robosuite 與 BEHAVIOR-1K 任務上達到 99% 成功率(官方專案頁的評測面板另以 160 個任務計,兩處口徑並不一致)。
| 版本 | 時間 | 後端模型 | 官方亮點 |
|---|---|---|---|
| 初版 | 2026 年 6 月(論文) | Claude Opus 4.6 | 三套件當時最佳成績、收桌 sim-to-real 影片 |
| v1.0 | 2026 年 10 月(開源公告) | 多模型,真機示範標 GPT-6 Astra | 魔術方塊、80 個 LIBERO-Pro 任務 99% |
有個工程事實值得記下:儲存庫目前沒有打任何 git 標籤,也沒有發布 release,v1.0 這個版本號只存在於 README 的動態欄文字裡,程式碼分支只有 main 與 v0.1 兩條。要追蹤版本的人,現在只能盯著 README 與送交紀錄;公告前半天儲存庫還有一次推送,星數目前約 356 顆,還在早期採用階段。
ASPIRE 的正式名稱是 Agentic Skills Discovery for Robotics,論文裡展開成「透過迭代機器人探索的代理技能編程」。它做的事用一句話講:讓程式代理自己寫機器人控制程式,執行、看失敗紀錄、修程式、驗證,再把驗證過的修法存進技能庫,下次遇到相似動作直接取用。README 開頭用三個重定義描述這套思路:訓練是技能精煉,與梯度下降無關;訓練好的模型是一個感測動作技能的儲存庫,與浮點權重無關;分散式訓練是一組代理各自練不同技能,與分批資料無關。
這就是「換模型就升級」的來源。系統裡有兩層可以累積或替換的東西:技能庫存的是程式碼,會隨著任務越做越多;後端語言模型是引擎,隨時可以換新款。權重派的機器人學習,能力鎖在參數裡,模型換代等於重新來過;ASPIRE 把能力放在技能庫這層,模型換代時程式資產原封不動,新引擎直接吃舊技能。
迴圈內部有三個組件,分工值得認識,因為它們決定了技能庫會長成什麼樣子。執行引擎在每次感知、規劃、抓取與控制的呼叫中記錄觀察、輸入、輸出與可行時的視覺證據,讓代理能回頭翻原始執行痕跡、把失敗定位到具體一次呼叫,修完再用重跑驗證,這是修復可信的前提。技能庫把驗證過的修法蒸餾成可轉移的知識,之後以情境內指引的形式被檢索回來,官方強調這些技能能跨任務、跨模擬與真實、跨機器人身體存在。演化搜尋則在單軌自我修正之外生成多樣的任務序列與控制程式,避免整個系統只沿著一條軌跡打轉。
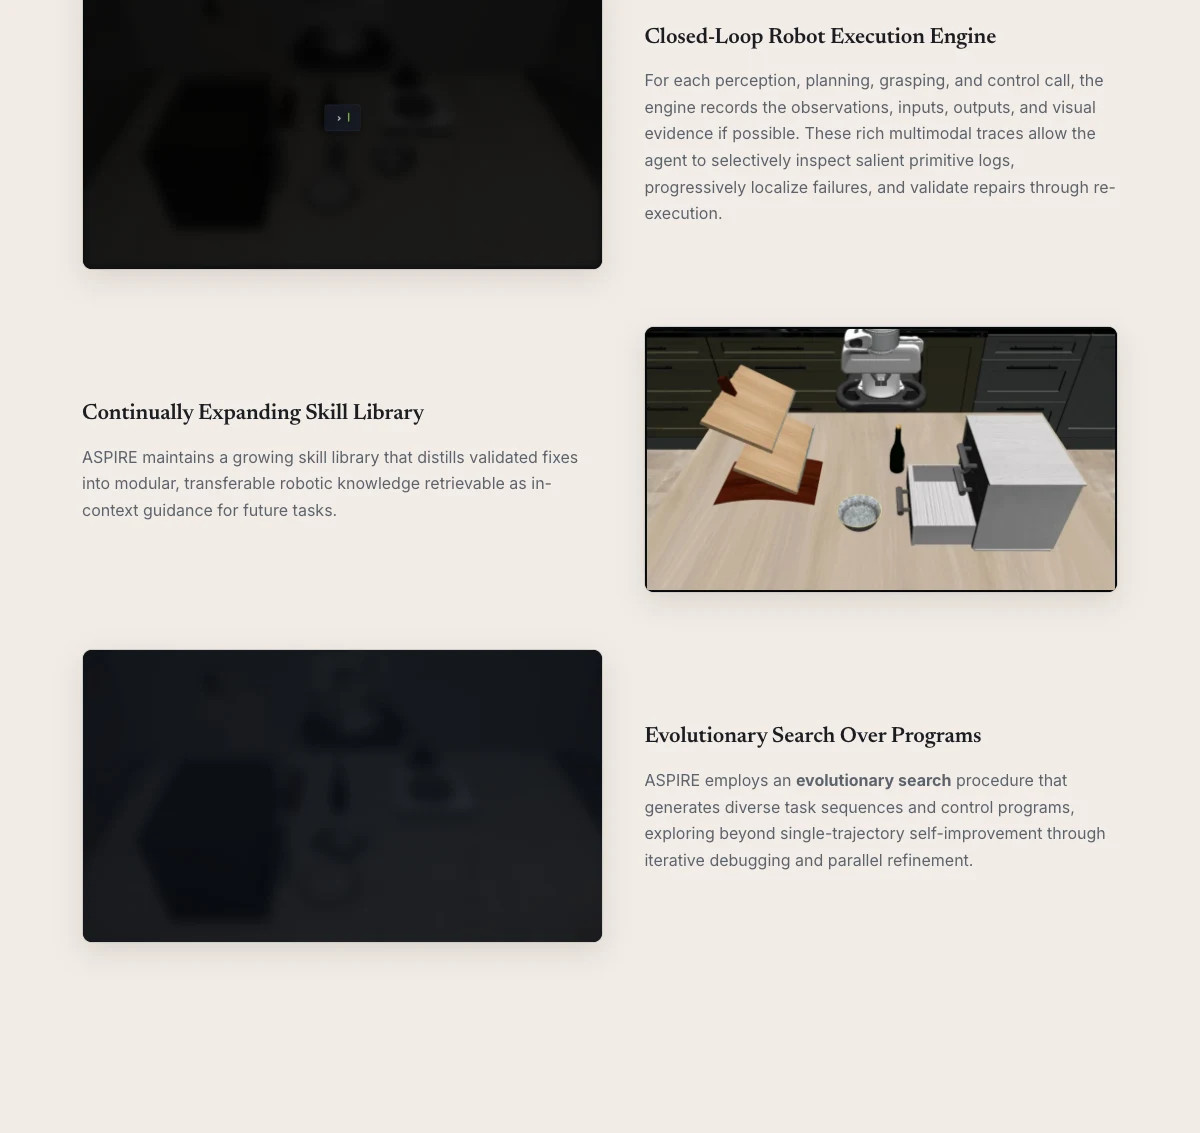
技能庫是資產的證據有兩組。其一,用 LIBERO-90 學到的技能面對沒見過的 LIBERO-Long 長流程任務,技能庫越大成功率越高,零樣本轉移那句 31% 對 4% 就是這條線的延伸。其二,真機跨身體實驗裡,有無掛上模擬中發現的對應技能相比,coding 代理用更少的 token 就第一次跑成功,而且那份程式在保留評測 trial 上的成功率也更高,量到第一次成功為止的輸出與總 token 數都省了下來。官方在魔術方塊任務上還量了效率:隨著情境與技能累積,每轉動一面所消耗的 token 數與等待時間都往下降,數字把失敗嘗試、恢復與情境壓縮都攤提進去了。
模型縮放成績是這次公告最硬的證據。研究團隊固定環境、機器人程式介面與評測協議,只換後端:在 10 個 LIBERO-Pro 任務上,GPT-6 Luna 寫出來的程式成功率 15%,換 Claude Opus 5.5 直接到 99%;Opus 5.5 在 LIBERO-Pro、Robosuite、BEHAVIOR-1K 三個套件的每個任務上都落在 97% 到 100%。測過的模型清單包括 GPT-6 Astra、Claude Opus 5.5、Sonnet 5.5、Fable 5.1,以及開放權重的 Kimi K3 與 Qwen 3.8 Max。官方還畫了一條成本對成功率的曲線,結論寫得直白:最強的模型不是最貴的。
對正在選模型的團隊,這組數字的用法是:機器人任務上模型差距被放大到誇張的程度,選錯引擎等於讓整套系統空轉,而貴的型號不保證較高的成功率,成本曲線要自己量。細節上也有誠實標註,Opus 5.5 沒有在 BEHAVIOR-1K 上評測,三套件全綠是挑過範圍的陳述。
更有意思的差異發生在策略品質,官方用同幾個任務比較不同模型寫出來的程式。把書推進低矮層架時,Opus 5.5 與 Astra 會先放開書再往裡推;推盤子時 Opus 5.5 先清空桌面雜物,Astra 則直接把盤子抬過障礙;開最底層抽屜時兩者都會傾斜夾爪去勾低把手,跟人的動作一樣;把馬克杯放進微波爐時都懂得抓把手、直著滑進去。專案頁另有對照案例,把人類遙操作示範與 Opus 4.6、Opus 5、Opus 5.5、Astra 各自寫出的評測程式並排放,模型代次的行為差異可以直接用眼睛看。換句話說,語言模型在一般文字任務上那種「想得更周到」的進步,搬到機器人控制程式上就變成抓取策略的差距,這是模型縮放成績背後的質性故事。
論文階段的對照數字可以當背景:比先前方法在 LIBERO-Pro 最多高 77%、Robosuite 雙手交接高 72%、BEHAVIOR-1K 長流程家務高 32%;技能庫還能零樣本轉移到沒見過的長流程任務,LIBERO-Pro Long 上 31% 對先前方法的 4%。這些是 6 月論文的故事,10 月這則新聞的主體是上面那組模型縮放成績與真機技能發現。
99% 是模擬套件上的數字,計分方式官方寫得很完整:LIBERO-Pro 的 Object、Goal、Spatial 類是在物件位移與指令改寫的擾動下評測,每個任務用 50 個保留種子;Robosuite 測的是接觸密集的桌面操作,每任務 100 個保留種子;BEHAVIOR-1K 測長流程的移動式家務操作,每任務 25 個。ASPIRE 只在一小塊除錯分割上學習,成績回報自不相交的保留種子,對照組 CaP-Agent0 則是每個種子都重新生成程式並享有測試時推理與重試。換句話說,這個 99% 是「技能庫在沒見過的種子上」的成績,乾淨度夠,但範圍就是這三個研究用模擬套件。
真機端是另一種證據等級。官方端出四個任務:解魔術方塊、倒疊杯子成一疊、轉開瓶蓋並倒出內容物、把藥丸放進瓶子再鎖緊瓶蓋,後端都是 GPT-6 Astra;收桌子那個舊案例則是模擬用 Opus 4.6、真機用 GPT-5.5。README 在真機段落的措辭值得逐字看:三個新的操作配方是從 demo 場次蒸餾出來的,原文明寫這些「不是一次新的真機驗證」,藥丸配方還特地區分瓶蓋有沒有真正鎖緊。這些畫面證明框架做得到這些動作,與量測過的成功率是兩種東西。
專案頁的限制段落是這類研究頁少見的誠實。五條限制照官方順序:還不是全自主的真實世界學習器,真機部署仍需要可靠的成功偵測、安全重置、監控與校正;依賴凍結的前沿語言模型,小模型能否撐住除錯迴圈未驗證;受預定義的原語 API 限制,能表達的行為有邊界;技能庫的長期記憶管理未解決,條目會過時、過度特化、冗餘甚至誤導新任務;除錯與演化搜尋的運算成本高昂,每個任務要燒掉大量模型呼叫與滾動測試。
安全警告比限制更硬。框架會執行語言模型生成的 Python,擁有完整的匯入權限,官方明說試驗程序與看門狗程式不構成安全沙箱,README 要求在隔離主機上跑、不掛憑證與敏感資料、限制網路,並且永遠不要讓模擬代理接觸實體硬體;真機工作需要另外的控制規則與操作員授權。授權條款方面,NVIDIA 擁有的部分採 Apache-2.0,第三方材料保留原始條款,散布完整技術棧前要先讀 NOTICE 與授權索引。
研究機器人控制與程式代理的團隊,這是現在就能上手的等級。ASPIRE 對 coding 代理不作假設,模擬工作流打包成 Claude Code 與 Codex 的技能包,兩個技能分別是迭代除錯與演化搜尋,README 給了一段可以直接貼給代理的啟動提示詞,而且這段提示詞本身有安全設計:代理被要求先報告需要的 GPU、憑證、gated 權重、服務、預期執行時間與輸出路徑等,等使用者確認後才會開跑,並且明確禁止碰真機程式碼與操作員手冊。硬體前提是 CUDA、uv 套件管理,以及 Hugging Face 權杖,因為要用到 gated 的 SAM3 權重;真機那一側需要校正過的 YAM 工作站、操作員手冊與另外的授權流程,屬於實驗室配置,家裡沒有機械手臂的讀者看影片就好。
真機上的運作方式也值得認識一下。魔術方塊那段實機影片裡,coding 代理扮演系統二:它呼叫可執行的感知與動作工具逐步轉動方塊,把過程中學到的經驗寫成文字技能存起來,之後的嘗試直接沿用。這與模擬裡的迴圈是同一套精神,只是跑在實體機器上,收斂的單位從模擬 roll 變成一次一次的真實轉動。
一般讀者真正該帶走的是架構訊號:機器人能力的進步正在與模型換代掛鉤,這與 Google 用人類影片當機器人訓練場走的世界模型路線、以及 Odyssey-3 一個模型驅動汽車與人形機器人的端到端路線,是同一個問題的三種答案。ASPIRE 的答案把可累積的投資放在技能庫,模型層保持隨時可換,這個選擇讓它吃到語言模型進步的紅利,也讓它繼承語言模型的帳單與風險。想看 agent 直接寫程式修東西的實例,Eleven 的反組譯工作台是同一股潮流在逆向工程端的樣子。
未指名的後端模型是最大的未確認項:v1.0 公告那句 99% 沒說是哪個模型跑出來的,Jim Fan 的貼文把功勞放在 Astra 到站,README 的縮放圖表則以 Opus 5.5 達到 97% 到 100%,兩處官方表述並列,硬合併成一個答案會超出證據。除此之外,git 標籤與 release 何時補上、星數與社群採用會長到哪裡、模型清單會不會再擴充,都還在變動。這些數字兩週內就可能翻頁:11 月初再查儲存庫的 release 頁與 README 動態欄,就能確認標籤與新模型成績補上了沒有,這篇文章的時效就抓到那時為止。