TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

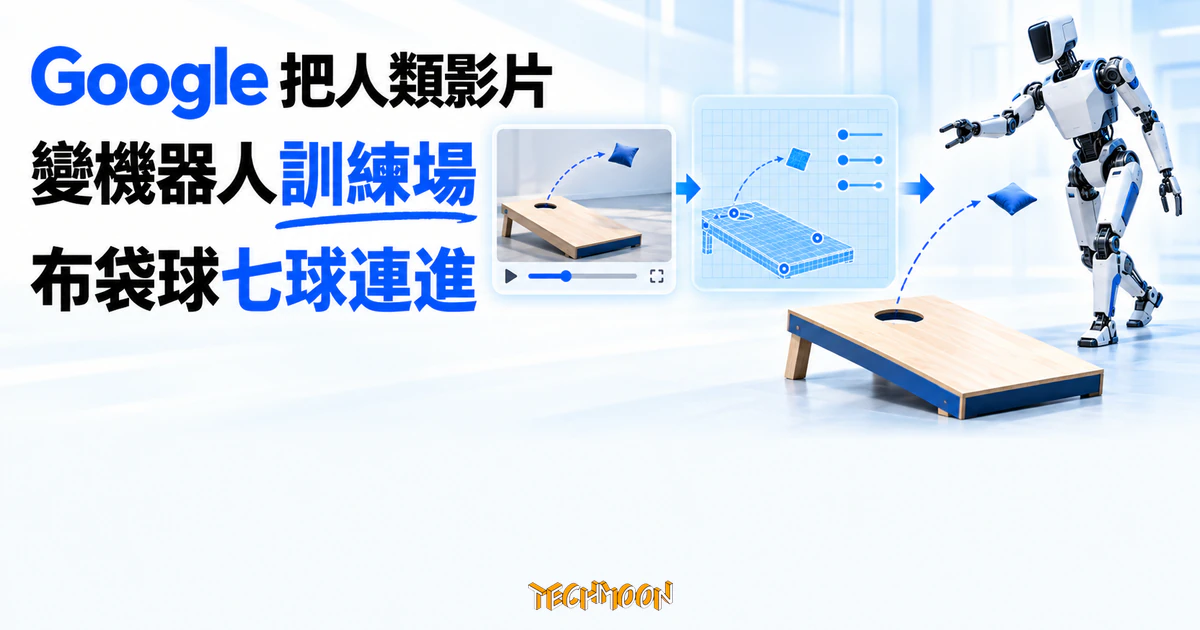
Google 在 2026 年 10 月 13 日公布 Gemini 4 Argon 機器人開發案例:模型觀察一段人類投擲布袋球的影片,自行建立場景空間資訊與 MuJoCo 物理模擬程式,再把練習成果轉移到 Apptronik Apollo 實機,在特定試驗中連續投進七球。這條 Video-to-Sim-to-Real 流程展示的是訓練環境的建立速度,七球連進仍屬單一示範條件下的結果,公開資料尚未提供完整成功率資料。
用 AI 摘要這篇文章:
台灣時間 2026 年 10 月 14 日凌晨零時(UTC 10 月 13 日 16:00),Google 對外發布新模型 Gemini 4 Argon,開發者、企業與訂閱用戶當天就能用上。同一篇公告裡,藏了一段讓機器人圈停下來看的示範:模型看完一段人類打布袋球(cornhole)的原始影片,自己算出環境的空間座標與全身關節動作,自己寫出模擬程式碼,再把練好的動作放到 Apptronik 的人形機器人 Apollo 上,在實機試驗中連續投進七球。
七球連進是這次示範最好記的畫面,但把它讀成「機器人學會了布袋球」會抓錯重點。Google 把這條流程命名為 Video-to-Sim-to-Real,中文直譯是「影片轉模擬轉實機」,並宣稱它把過去要花數週的人工模擬建模,壓縮到數小時就能完成。這次真正變動的環節,是機器人訓練環境的生產方式:環境從人工量測建模,變成看影片生成。
先把 Google 自己寫下的字句攤開。公告的機器人段落是這樣說的:在一項內部測試中,Argon 觀看一段人類打布袋球的原始影片,映射環境的空間座標,計算所需的全身關節動作,接著自主建立模擬程式碼;轉移到 Apptronik 的 Apollo 人形機器人之後,機器人在一次實機試驗中快速連進七球。
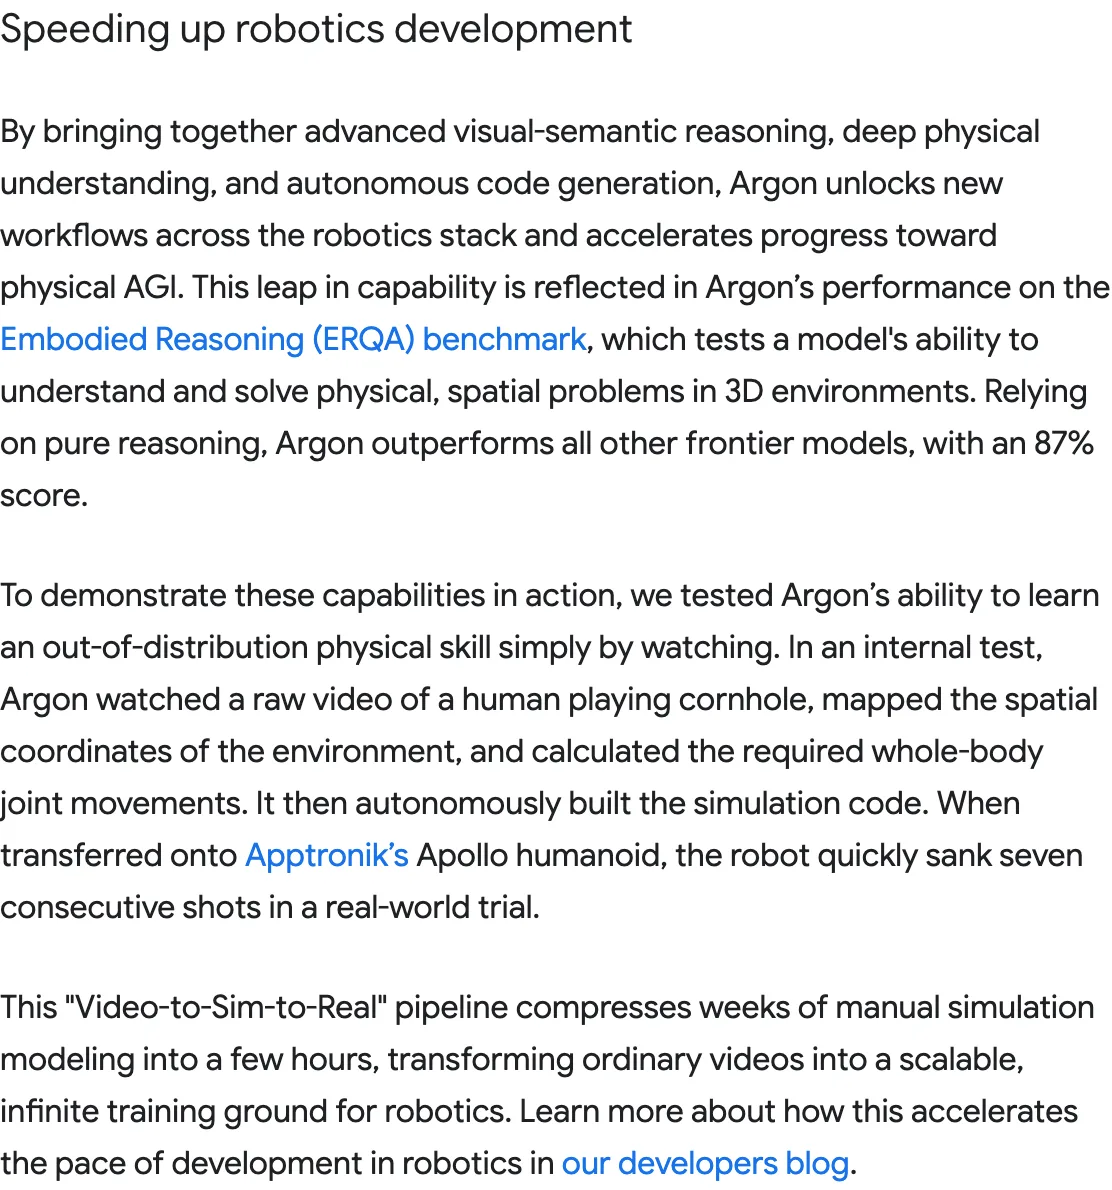
幾個措辭值得原樣保留。「內部測試」表示這不是公開評測;「一次實機試驗」表示七球是單一序列,公告沒有給出總嘗試次數或失敗分布;「快速連進」是 Google 對速度的形容,沒有附時間碼。公告同時宣稱,這條流程把數週的人工模擬建模壓縮成數小時,把普通影片變成「可擴充、無限的機器人訓練場」。這兩句都是廠商說法,計算方式沒有隨公告公開。
Google 挑布袋球當考題,也有它的道理。這個起源於北美的庭院遊戲,玩法是把小袋投向斜板上的圓洞,規則簡單,但對機器人來說,距離估計、出手力道與身體協調要同時到位,而畫面裡的人類動作又不能直接照抄:人的手臂比例、關節極限與 Apollo 不同,同一條投擲軌跡換到機器人身上,要重新分配每個關節的配合方式。公告把布袋球稱為「分布外」的物理技能,指的就是這類不在主要訓練分布裡的動作。
這篇公告的署名作者是 Google DeepMind 資深副總裁 Koray Kavukcuoglu,發布時間為 UTC 10 月 13 日 16:00,約一小時後修改過一次。同一天,Google Developers 部落格另有一篇技術文章,專講 Argon 在機器人上的工作流程,後面會用到。
模型取用範圍順便交代:開發者與企業可透過 Gemini API 在 AI Studio 與 Gemini 平台使用;Google AI Ultra 訂閱者可在開發環境 Antigravity 使用;AI Ultra 與 Pro 訂閱者可在 Gemini app 與搜尋的 AI Mode 使用。這次示範的直接相關者是機器人開發與研究團隊,一般使用者不需要做任何事。
Video-to-Sim-to-Real 可以拆成三段來看。
看片的階段,模型要從一段普通人拍攝的影片裡,辨識出任務相關的物件(布袋、斜板、洞口)、彼此的空間關係,以及人類動作的目的。公告的用詞是「映射空間座標」與「計算全身關節動作」,也就是把畫面裡的幾何資訊,換成機器人可以執行的關節數值。
建模的階段,模型自己寫出模擬環境的程式碼。技術文章使用的模擬引擎是 MuJoCo,一套免費開源的物理引擎,官方對它的定位就包含「接觸豐富行為的最佳化」與「控制方案部署到實體機器人前的測試與驗證」。換句話說,模擬層用的是機器人領域本來就在用的驗證工具,這則新聞的重點在「環境由模型生成」,而不是 Google 發明了新的物理引擎。
上機的階段,模擬裡練出的關節軌跡轉移到 Apollo 實機。為什麼要先在模擬裡練?實機試錯要佔用硬體,也有損耗風險,模擬可以大量重複嘗試,把試錯成本搬到便宜的一層。這個思路在 AI 研究裡並不陌生,先前 Google 的研究團隊把已執行過的探索紀錄變成零成本的回放模擬器,讓 AI 代理在歷史裡做夢改進策略,用的就是同一個經濟邏輯。但模擬與真實的物理條件只要有差異,例如布袋的重量或板面摩擦不同,模擬裡學到的出手力道到現場就會失準。模擬與真實之間的這道縫,正是 Google 技術文章花最多篇幅處理的問題,下一節細看。
這裡有個容易混淆的點:畫面看起來合理,與受力正確,是兩回事。近一年各界展示的生成式世界模型,例如讓一個模型同時驅動汽車與人形機器人的 Odyssey-3,或字節跳動那句「一句話生成場景」的世界模型示範,處理的是「畫面接下來長什麼樣」;機器人訓練用的物理模擬,要回答的是「這個動作推得動這個物件嗎」。前者再漂亮,也不能直接當訓練環境,因為它不保證接觸、摩擦與關節限制符合真實受力。
Google Developers 技術文章(作者 Kanishka Rao,首席軟體工程師)把 Argon 的機器人工作流分成四個領域:機器人控制、Real2Sim(真實轉模擬)、物理理解、研究與自我改進。其中 Real2Sim 一節,展示從三種輸入建立「物理校準的模擬分身」:機器人攝影機的畫面、人類視角的操作影片、手繪草稿。
文章裡最值得細讀的,是模型建立分身時被要求同時通過兩個驗證目標。視覺上,模擬場景從頭部與兩個手腕鏡頭渲染出來的畫面,要與真實紀錄對得上;物理上,指尖感測到的接觸力,在時間點、大小與方向上要與真實紀錄吻合。像不像與準不準,被拆成兩條獨立的檢查。
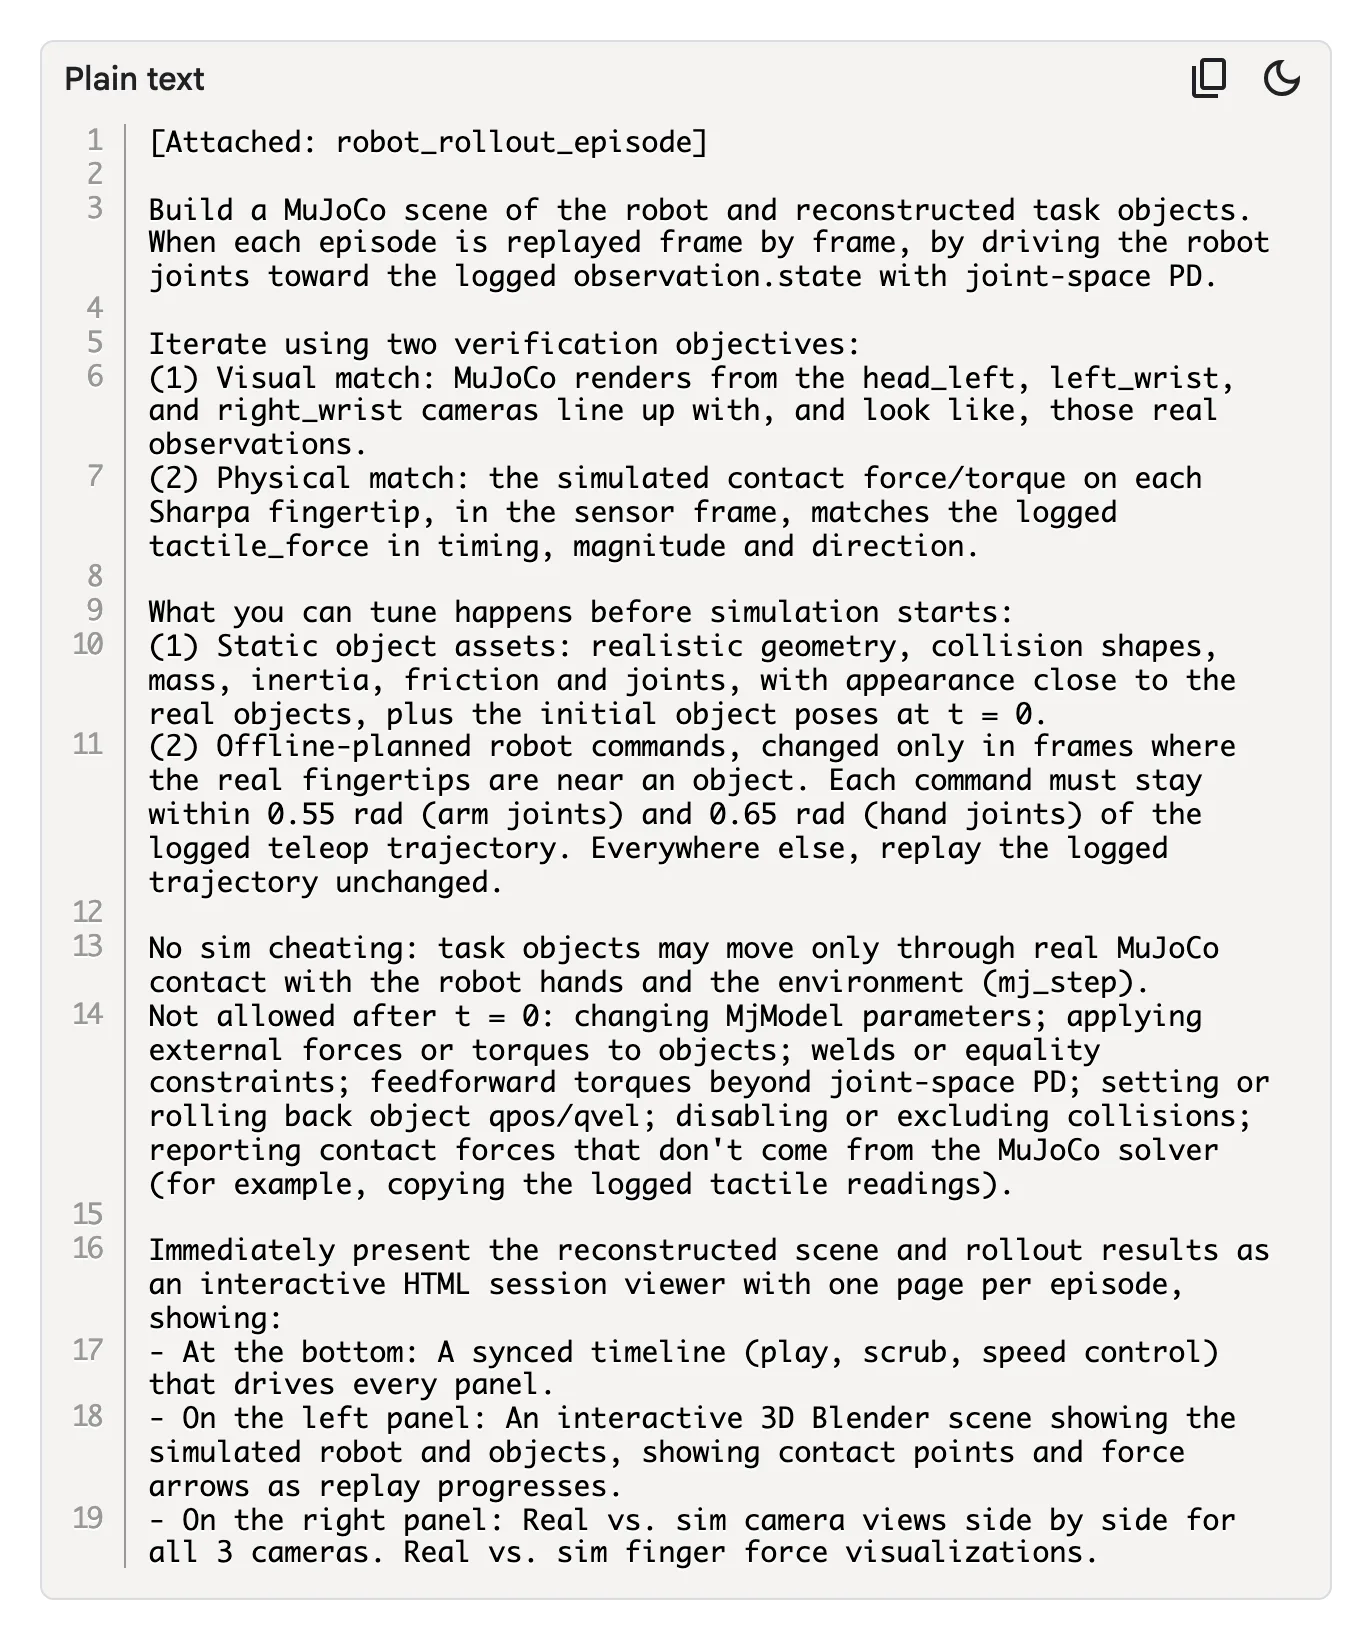
更有意思的是禁止事項清單。給模型的提示詞明寫:模擬開始後,不得修改模型參數、不得對物件施加外力或力矩、不得在關節空間 PD 之外施加前饋力矩、不得用焊接或等式約束把物件固定住、不得改寫物件的位置與速度、不得停用或排除碰撞、不得回報不是由物理求解器算出來的接觸力。物件只能透過真實的接觸被推動。
這份清單白話說,就是在防模型「偷偷改題目」。把物件黏在手上、把碰撞關掉,畫面照樣好看,但那個成功就不是投擲出來的。Google 把這些限制寫進給模型的指令裡,等於自己承認:模擬的說服力,取決於哪些作弊路徑被明確封死。
同一篇文章用幾個案例佐證流程的通用性。Boston Dynamics 的四足機器人 Spot,先在 MuJoCo 裡建立腳踩垃圾桶踏板的數位分身練習,再上實機踩踏板丟罐子;人類視角的操弄影片,會把人手軌跡重定向到一具 76 個自由度的雙臂人形分身,雙手為 22 個自由度的五指手,以每秒 500 次的頻率模擬;手繪的紙筆草稿,畫著 Apollo 2 以拋物線丟球擊倒疊起的箱子,也能生成用 GPU 加速的 mujoco_warp 場景。
有個細節要誠實標出:布袋球示範本身,只出現在主公告的那一段。技術文章展示的是同一套方法的其他案例,全文沒有布袋球專屬的提示詞或完整設定。換句話說,七球連進能對上的原始文件,只有公告的一段文字與官方影片;機制層的證據,來自同方法的相鄰案例。
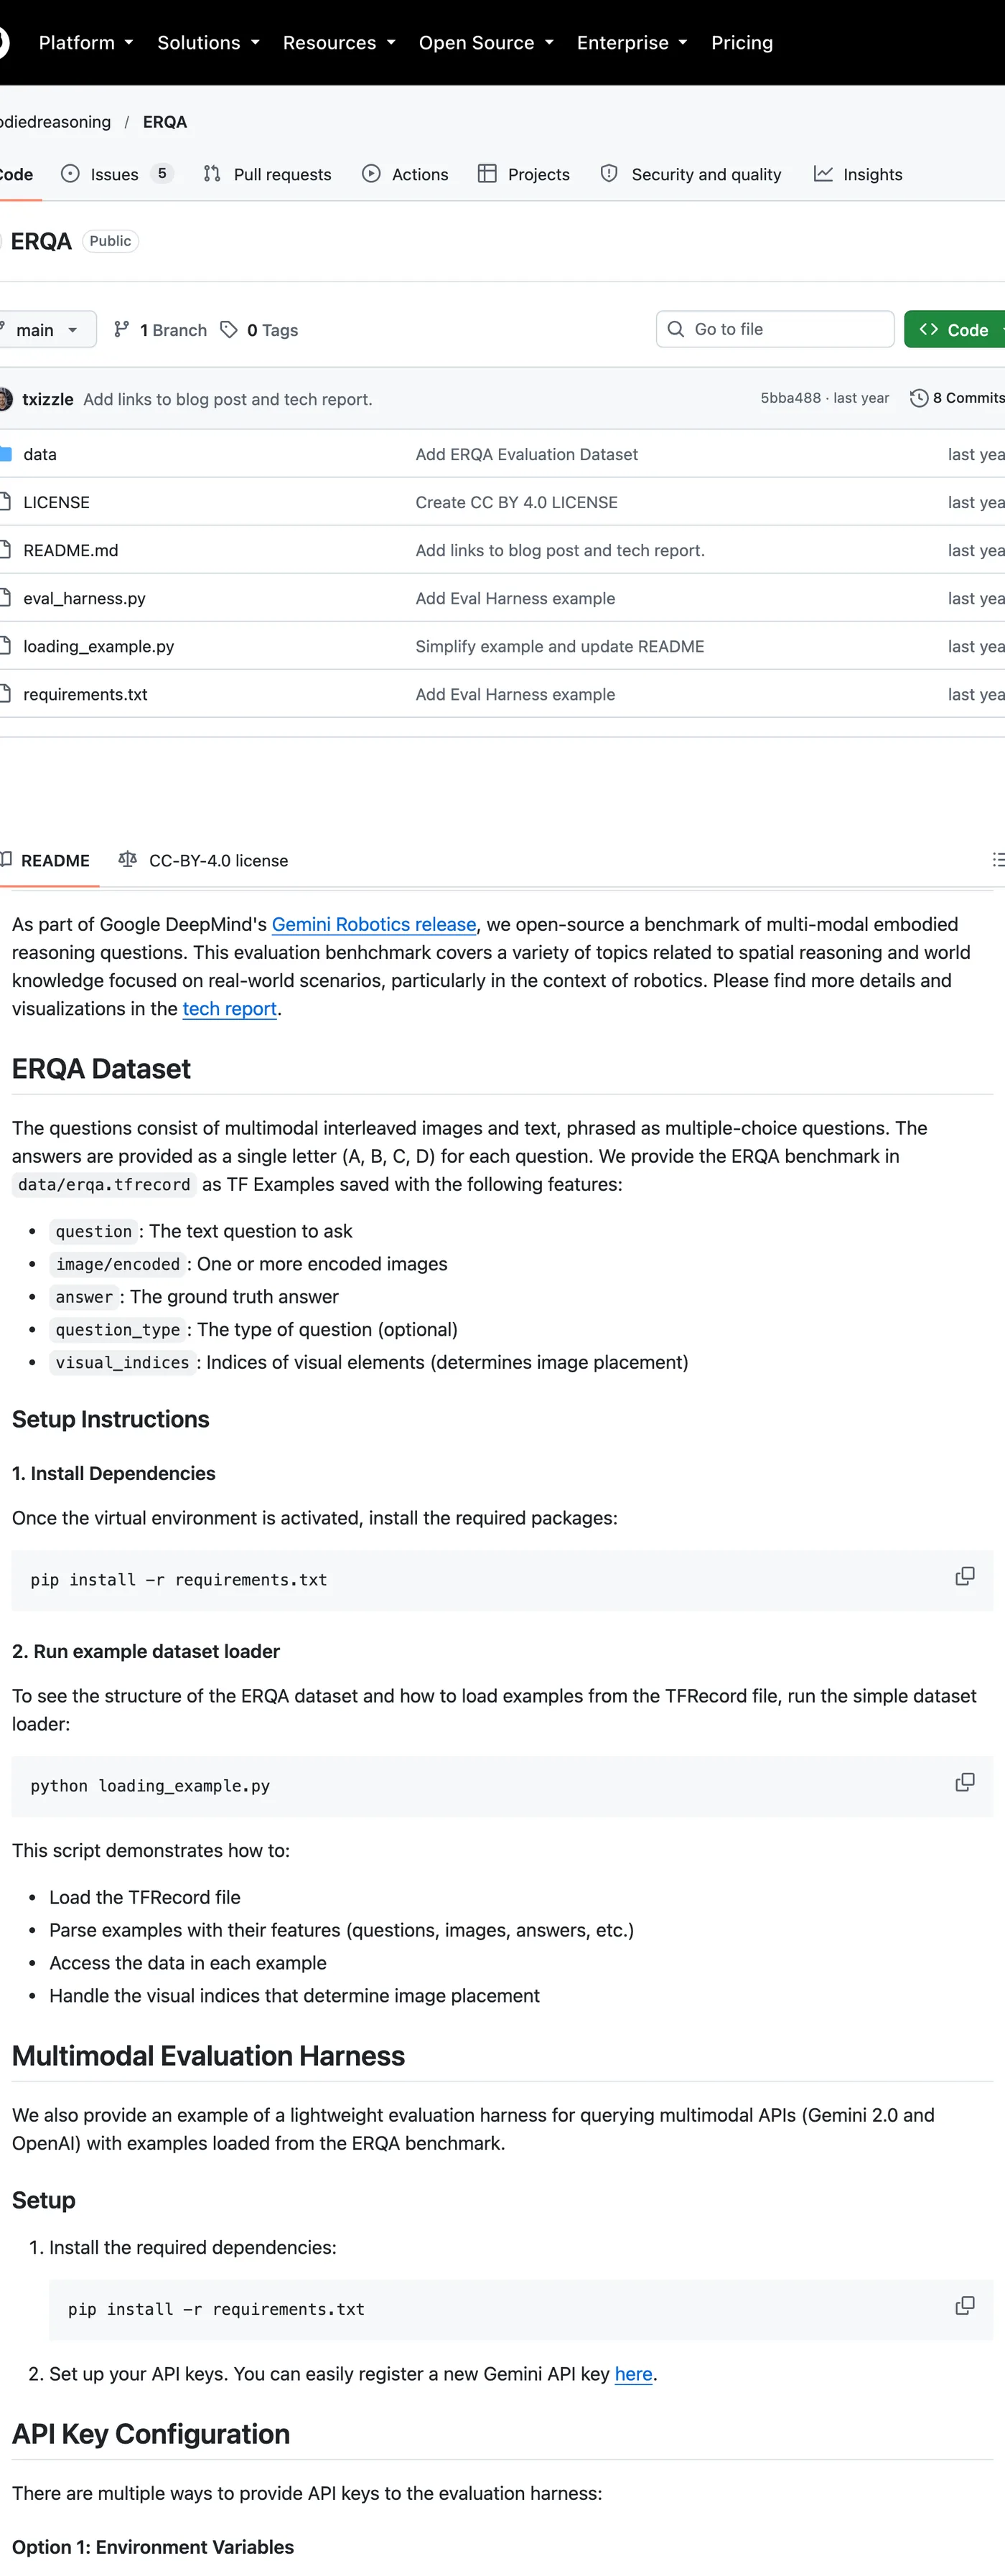
公告在機器人段落之前,還引用了 ERQA 評測:Argon 以純推理拿到 87%,勝過其他所有前沿模型。ERQA 的題目是圖文交錯的選擇題,測空間推理與世界知識在機器人情境下的理解;它隨 Google DeepMind 的 Gemini Robotics 發布而開源,以 CC-BY-4.0 授權,儲存庫建立於 2025 年 3 月,最後一次更新停在當月 12 日,之後未再變動。題集固定,對比較模型有利,因為每個模型拿到的是同一份考卷;但要留意出題方與被評的模型同屬 Google 體系,題目本身開源可檢驗,評測的挑題角度是自家定的。
這個數字與七球連進經常被並列,但它們是兩種證據。問答評測容易大規模比較模型,但它不讓馬達動;實機試驗讓馬達動,但一次內部測試的樣本,推不出一般成功率。兩者互補,也都不能單獨回答「這個技能穩不穩」。看懂這條界線,讀公告時就能自己分辨:87% 是可以拿著題庫去核對的分數,七球連進是無法從外部重現的展示,證據強度天生不同。
對實際在做機器人的團隊,這次發布裡比較能立刻試用的部分,是把「建訓練場」的工序交給模型,驗證留給工程師:拿到初版場景後核對尺寸、重量、摩擦與關節限制,比對模擬與實測的差異。如果初版場景還需要大量人工修改,公告裡「數週變數小時」的時間帳就不一定成立;反過來說,就算建模時間真的縮短,實機驗收的安全條件,包括碰撞、施力上限與失去平衡時的處置,也仍然是人的責任,這部分不會因為模型會寫模擬程式碼而消失。
可核對的部分已經不少:公告與技術文章的原文、發布與修改時間、模型取用範圍、ERQA 分數、驗證目標與禁止事項、其他機器人案例的描述。同樣明確的是還沒給的數字:七球連進的總嘗試次數與失敗分布、不同場地與物品條件下的表現、「數小時」的計算方式(含不含人工修正與反覆調整)、布袋球案例的專屬提示詞與模擬參數。
這些空缺直接決定七球連進能推多遠。連續命中的序列好看,但沒有分母就沒有成功率;固定距離與固定目標下練出的動作,換場地後要重新觀察與調整,這是這類展示與實際部署之間的標準落差。
之後有幾個訊號值得留意,出現任何一個,這篇文章的結論就該更新:Google 若發表完整的技術報告或成功率資料;其他團隊用技術文章裡的提示詞範例重現同樣的流程;或 Gemini 4 家族後續模型發表時帶來的機器人更新,公告結尾已預告家族還有其他成員。在那之前,把這次示範記成「訓練環境的生產方式被示範了一次壓縮」,比記成「機器人會投布袋球了」更貼近現有證據。
還有一個素材層面的提醒。官方公告頁嵌有 Apollo 布袋球的示範影片,看得到投擲的實際畫面,但影片與文字一樣,回答不了嘗試次數與失敗分布的問題;技術文章裡的影片多數是其他案例(Spot、模擬分身比對、草稿建場景),觀看時對照圖說,才不會把別的案例當成布袋球實測。
機器人開發者現在能做的,是從技術文章的提示詞範例起步,用自己的操作影片生成初版場景,再人工核對;追蹤產業的人,可以把「完整成功率資料」當作下一個有意義的進展指標;一般讀者不需要做任何事,這則新聞目前的影響範圍在開發與研究端。