TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

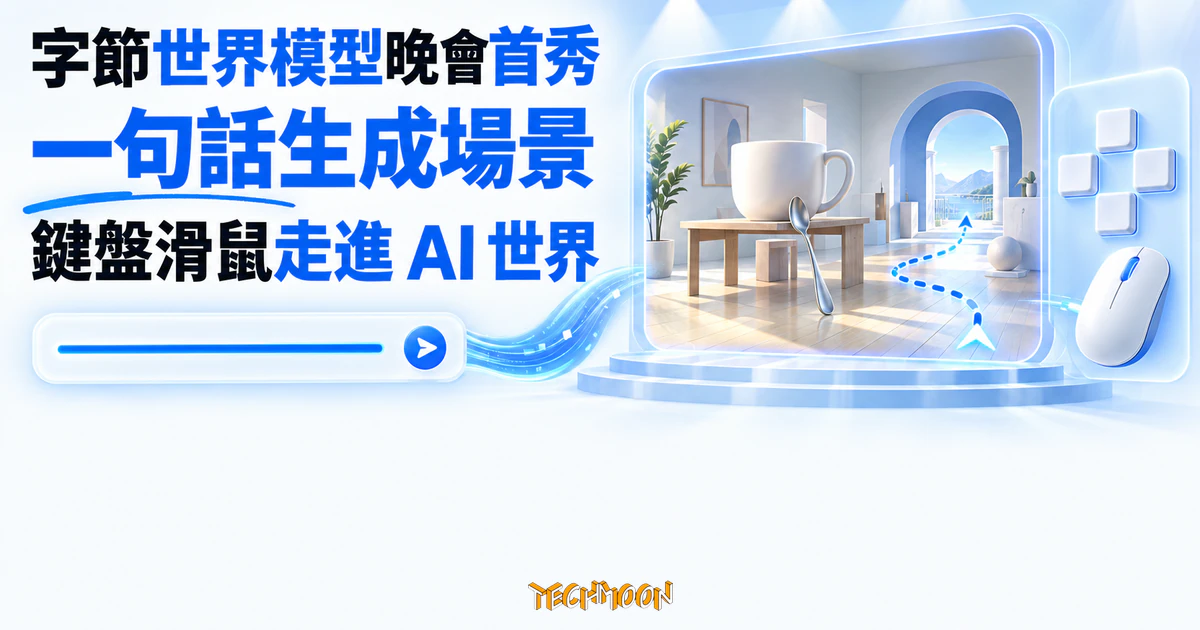
字節跳動未公開的世界模型 10 月 11 日在北京衛視晚會上首次被創作者公開演示:文字生成三維場景、鍵盤自由探索、即時指令新增物件、開門連通兩個空間,同場還有機器人訓練與自駕環境模擬。官方至今零公告,彭博九月報導指向十月推出,名稱與開放時程仍未定。
用 AI 摘要這篇文章:
字節跳動一款連名字都還沒有的世界模型,10 月 11 日晚間在北京衛視與抖音雙平台直播的《2026 美好奇妙夜》晚會上,被創作者潘天鴻(Tim)用一段七分鐘的演講首次公開演示。觀眾看到的流程很直白:輸入一段文字生成三維房間,用鍵盤與滑鼠在場景裡移動,中途再下指令,讓一支湯匙落到主角面前供他攀爬。北京衛視官方微博當晚 8 點 13 分釋出完整影片,官方帳號在貼文裡直接稱它為世界模型;但截至 10 月 13 日,字節跳動 Seed 官網的模型清單上沒有這款產品的任何條目,名稱、開放時程、價格全部未揭曉。
一場電視晚會,因此成了這款產品目前唯一的公開線索。大型模型公司發表重量級產品,慣例是技術報告、開發者大會或官方部落格,字節這次卻選擇把首次公開演示放進綜藝晚會,交給影視創作者而不是研究員主講,場合本身就自帶訊息:這套東西瞄準的是大眾市場的想像力,不是學術圈的審視。把它當產品發表會來讀會失望,把它當判斷素材來讀,資訊量其實不小。
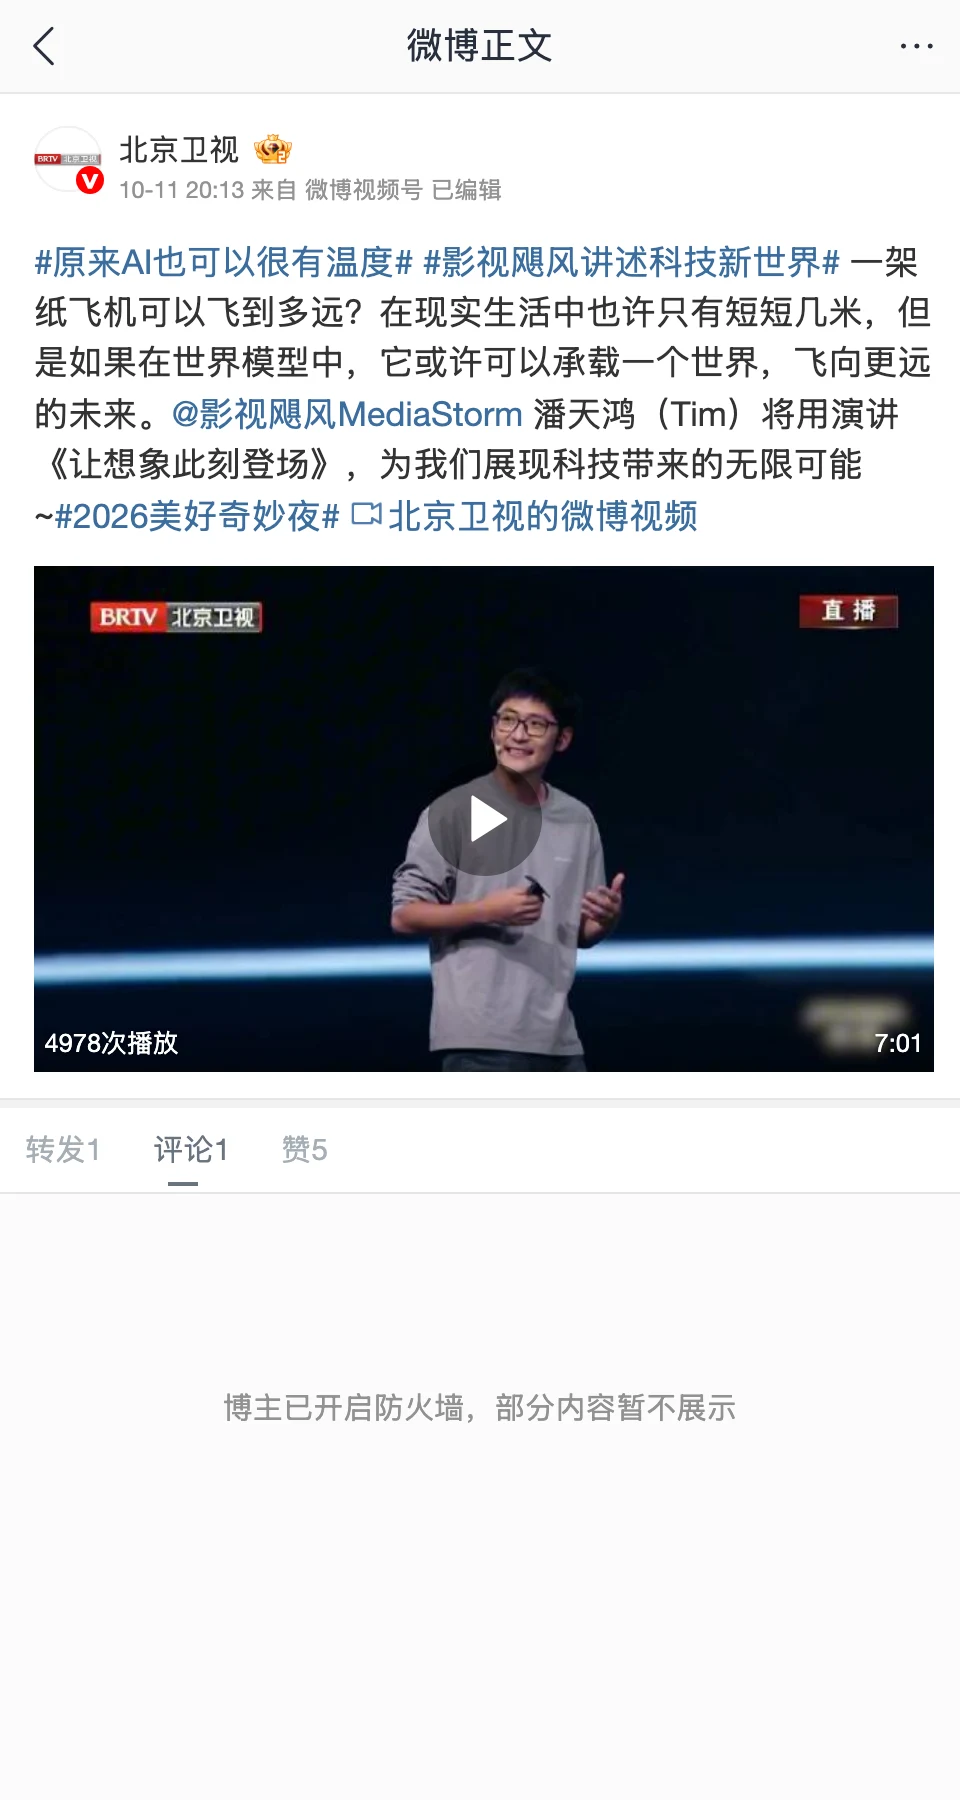
北京衛視釋出的影片全長 7 分 01 秒,演講名稱是《讓想像此刻登場》,北京衛視的子帳號稱它為整場晚會的開場演講。前半是一輪 AI 生成影片的集錦,雙翼機掠過雪山、紙飛機穿過雲層,舞台大螢幕隨後打出「沒有拍不了的鏡頭,只有想不到的故事」的標語,還示範了教學素材與水墨風格插畫等應用案例;真正屬於世界模型的段落從中段開始,畫面左下掛著世界生成區的標籤。
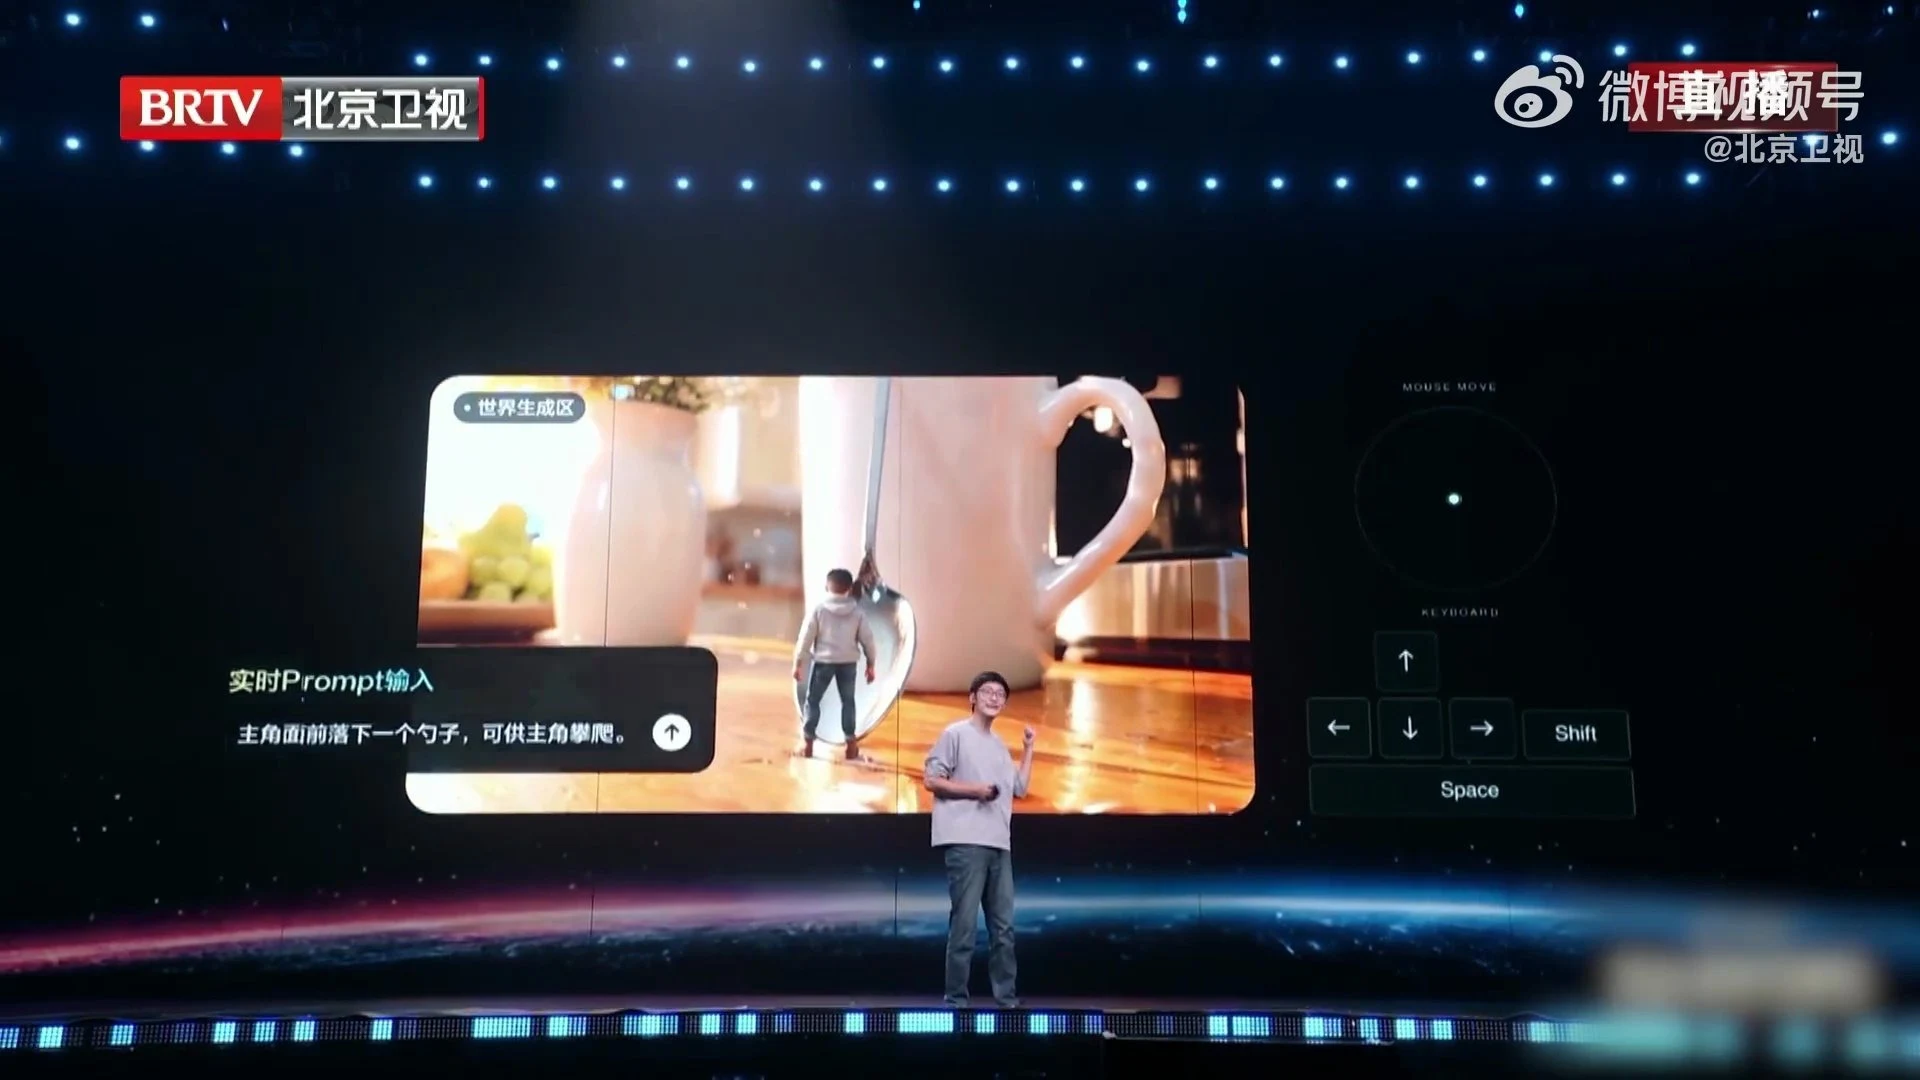
起手是文字生成場景。輸入一段描述,畫面生成鋪著木地板的房間,鏡頭切到縮小的第三人稱角色視角,桌面上的馬克杯、花瓶與葡萄都變成需要仰望的巨大物件。畫面右側同時浮出鍵盤提示,方向鍵加上 Shift 與空白鍵,角色在房間裡自由走動、轉換視角,鏡頭也能俯視整個場面。
接下來的一段才是重點:即時修改。輸入框標題寫著即時 Prompt 輸入,示範指令是讓一支湯匙落到主角面前、供主角攀爬,畫面隨即多出斜靠在杯緣的巨型湯匙,原來的場景沒有跟著重來。這正是世界模型與一般 AI 影片生成最直接的差別:後者輸出的是一段固定時間順序的成片,播完就結束;前者要維持一個可以被操作、被修改、修改之後仍然連貫的空間狀態,你走過的角落、剛剛生成的物件,回頭時都還要在原地。這種一致性說來平常,卻是此類系統最難的一關,探索時間越長、轉角越多,穿幫的機會就越大,也正是未來拿到公開版本時第一個該壓力測試的地方。
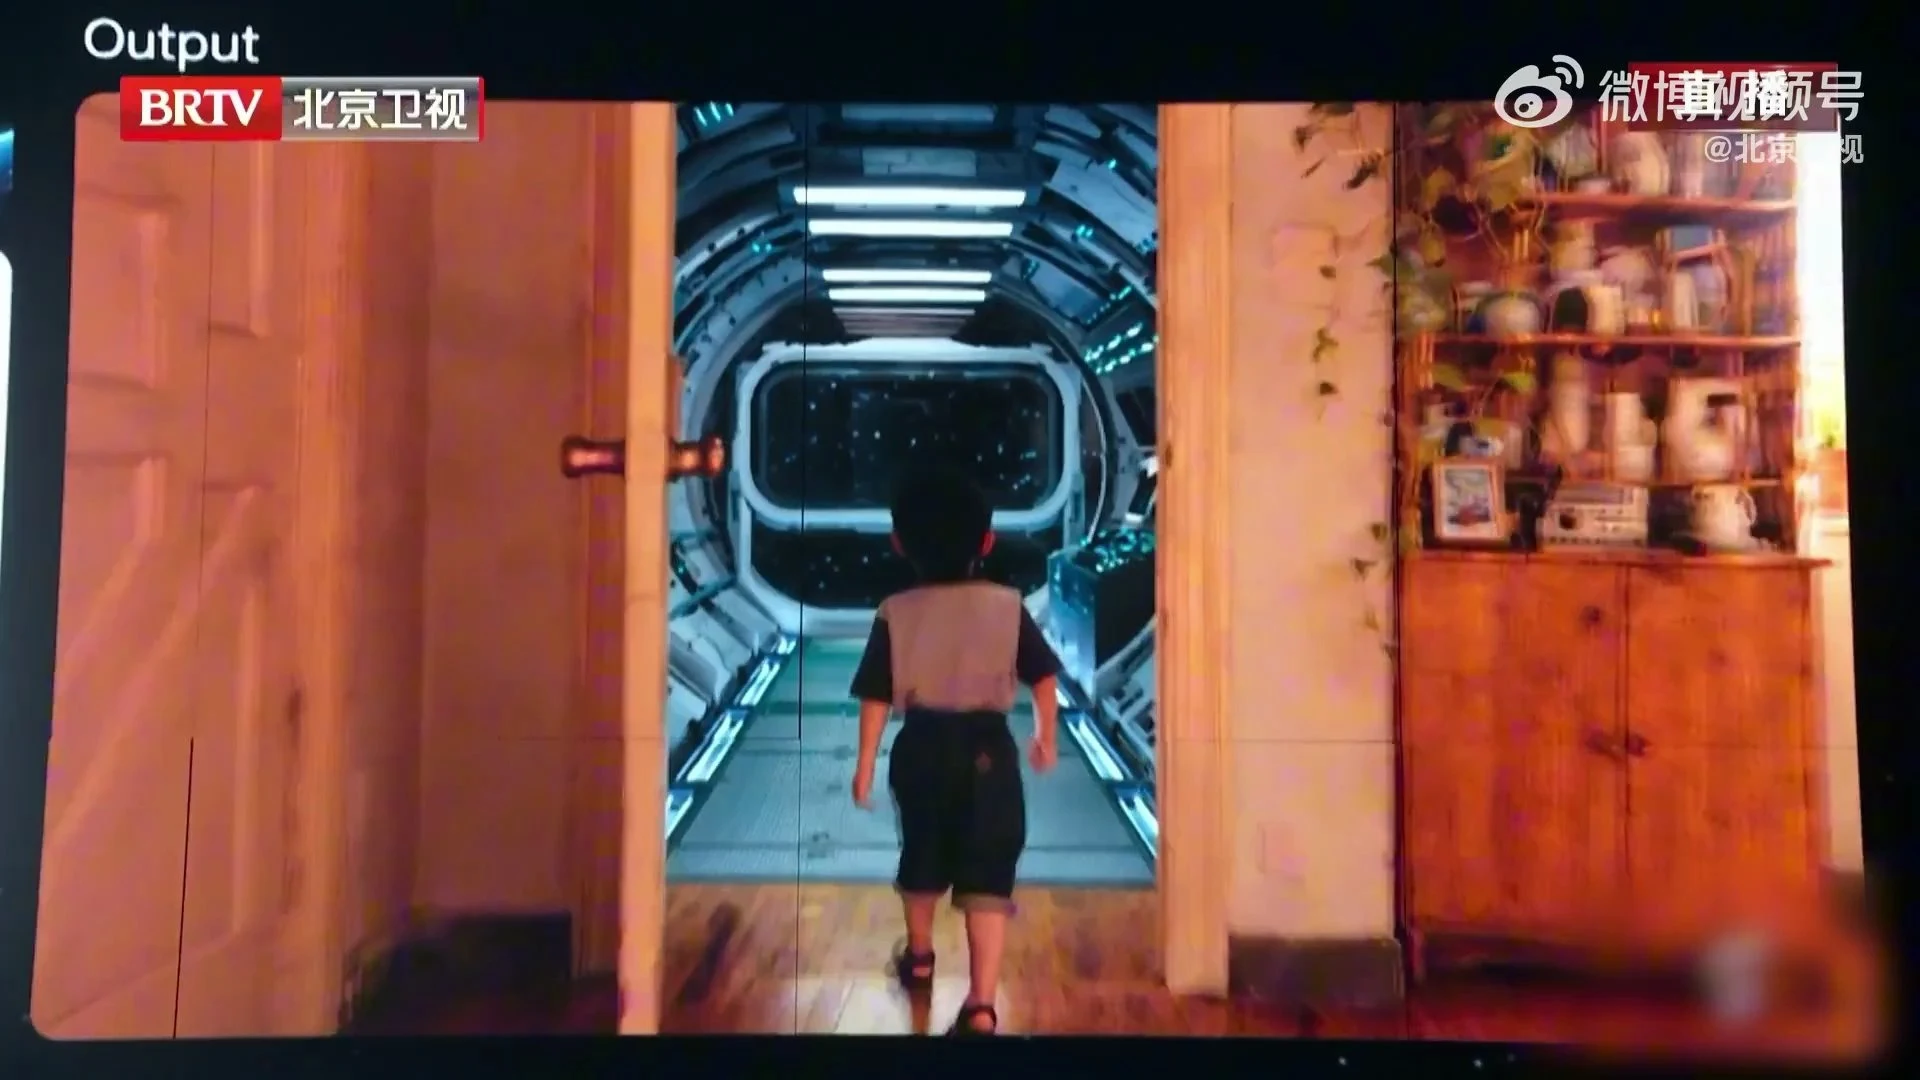
展示還往電影感推了一步。同一個馬克杯場景一路演到方糖落入黑色咖啡的特寫,光線與景深都朝商業影片的水準靠攏,暗示這套系統的目標已經越過示範用的方塊房間,指向敘事創作。再往後,螢幕切到輸入與輸出對照的介面,輸出畫面裡的小孩推開家裡的木門,門後直接接上冷色調的太空船走廊,兩個原本毫無關係的空間被一扇門連通,小孩就這樣從屋內走進艙道、站到能看見星空的舷窗前。跨空間連通能不能撐住長時間探索,畫面裡沒有答案,但「把兩個世界縫在一起」這個動作本身,已經超過目前公開的影片生成產品會做的事。
這些段落前後還鋪了兩層脈絡。演講中段播了一段有人物對白與分鏡的劇情短片,後段又拉出一面標著 2026 用 AI 做影片的案例牆,把一整年用生成模型產出的畫面縮圖鋪滿螢幕。安排的用意不難讀:過去一年 AI 已經接手了「畫面怎麼來」,晚會上這七分鐘要示範的是下一步,把畫面變成可以走進去、可以改的空間。世界模型在字節的敘事裡,接在生成影片之後自然長出來。
演講後段出現了兩個與創作無關的展示。先出現的畫面標籤是機器人訓練,多機位畫面記錄機械手臂在廚房與實驗台上抓取物品的過程;接著的標籤是自動駕駛環境模擬,三聯畫面播放行車視角的街道,油罐車、行人走過斑馬線、紅綠燈路口一一入鏡。
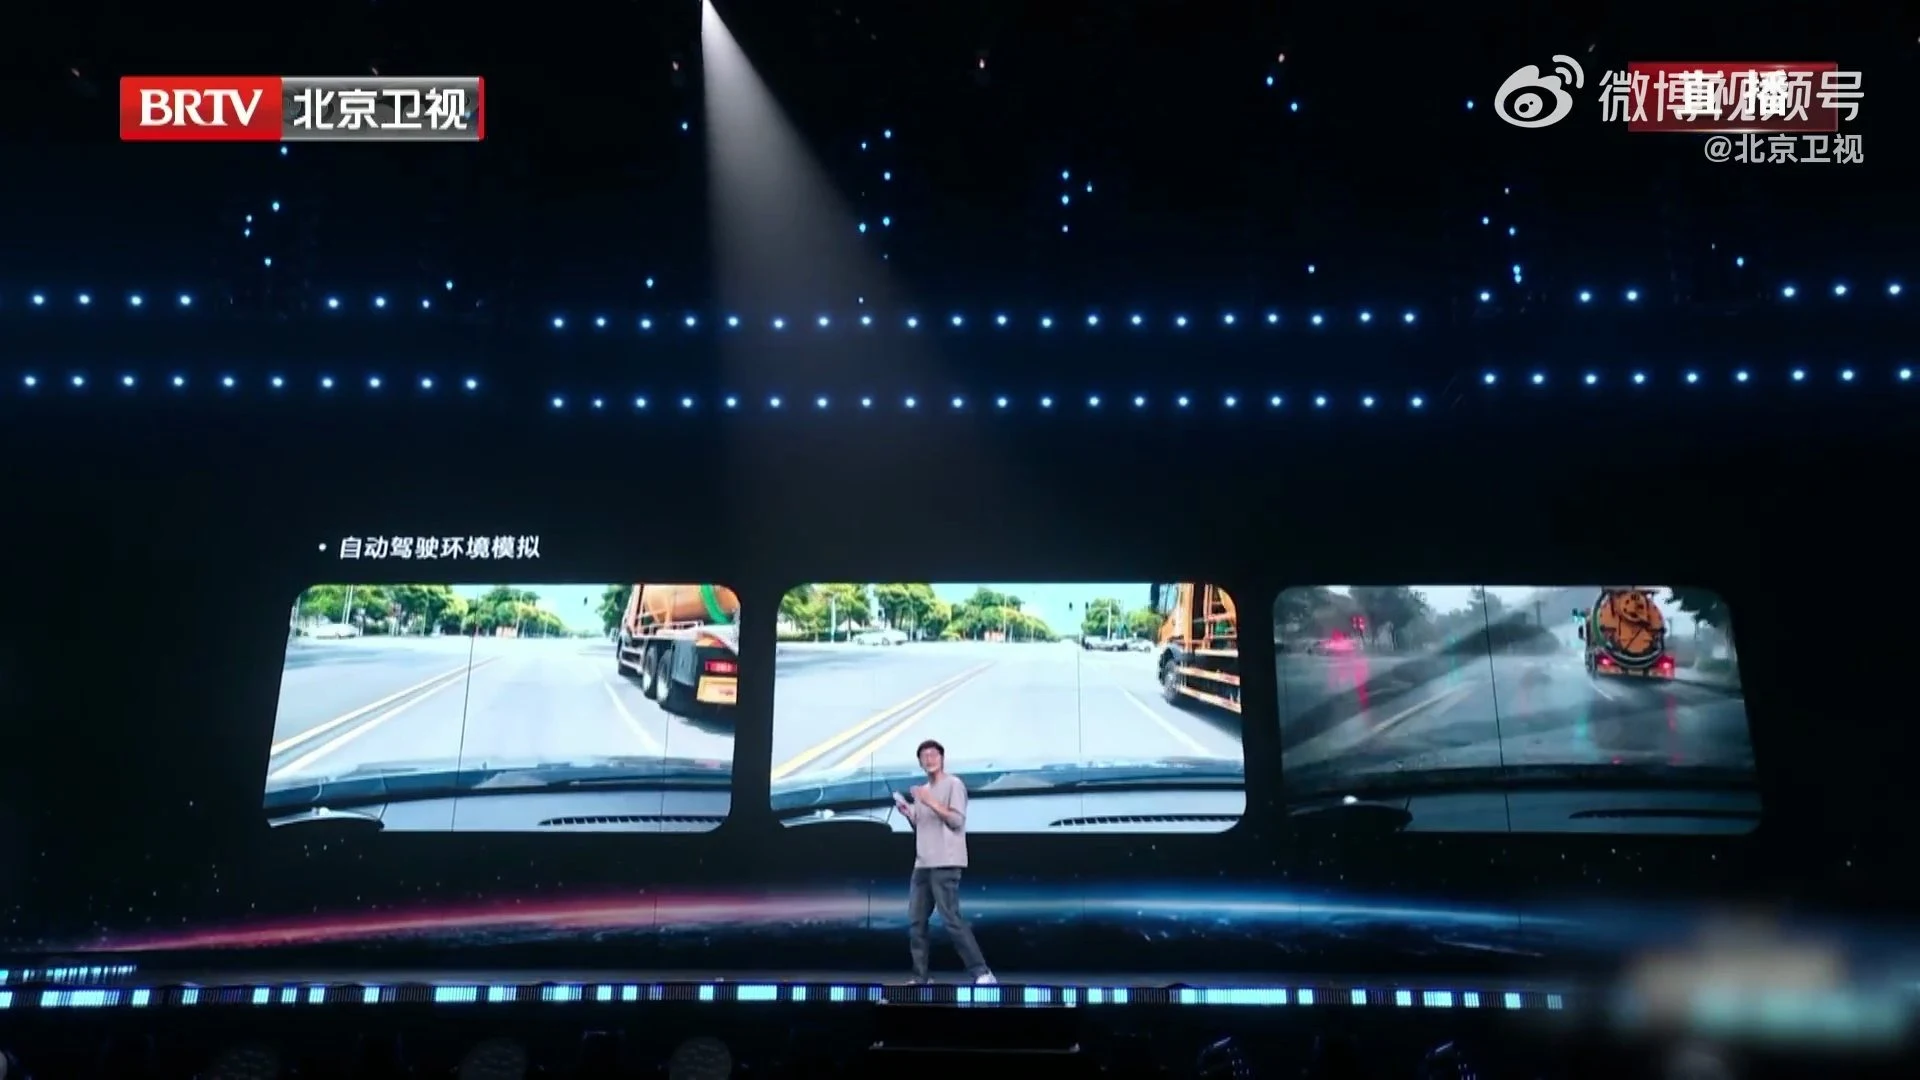
這兩段指向世界模型在內容生成之外的產業用途:把現實環境變成可以反覆生成、反覆驗證的虛擬訓練場,讓機器人和自駕系統在裡面練習真實世界裡稀缺或危險的場景。國外團隊已經在走同一條路,Odyssey-3 就把同一個基礎世界模型同時用在自駕與人形機器人上(可參考先前的 Odyssey-3 世界模型報導)。字節這次的展示沒有公布任何訓練成果數字,畫面本身只證明方向存在。
值得注意的是場合的選擇。機器人訓練與自駕模擬離一般觀眾很遠,世界模型最貼近大眾的面貌仍然是晚會現場那段可走、可改、可連通的場景。把訓練應用放進同一場演講,等於預告字節對這套技術的定位是平台而非單一功能,至於兩條線什麼時候各自落地,影片裡同樣沒有交代。
活動隔天,中國創投媒體投資界以字節世界模型首次亮相為軸做了長文解析,微博上汽車類帳號跟進,稱這場展示印證了彭博九月的一則報導。
那則報導的時間點剛好可以對照。彭博在 9 月 7 日引述匿名知情人士指出(內容經科技媒體 The Next Web 同日轉述),字節跳動正在準備一套即時空間影像模型,創辦人張一鳴親自督軍,最快十月推出,但時程未定、不排除變動;模型將建在 Seedance 影片生成系統之上,用於直播、短劇與遊戲的互動虛擬世界。傳聞規格是每秒約 20 幀、延遲約 0.05 秒、在雲端渲染,並配合字節旗下的 Pico 頭戴裝置,讓生成的世界回應使用者的聲音與動作。雲端渲染是策略核心:運算不放在頭戴裝置上,硬體就能更輕更便宜,競爭也從硬體規格轉向模型、雲端容量與內容傳遞,而這三樣字節都已經有。
TNW 同一篇另引 36kr 年初的調查:世界模型位列字節 2026 年 AI 四大優先方向之首,排在其餘三個方向之前,資料預算是各模型方向中最大的一筆,規模為人民幣八位數、約為對手的三到四倍,目標是年底前至少推出一款,並以 Google 的 Genie 為衡量基準。Genie 目前已經開放讓使用者在即時渲染的街景影像裡走動,走的是消費端可玩的路線;字節選擇從衛視晚會出發,起手式明顯不同。
把這條時間軸與晚會展示並排,這場演出更像是發布前的暖場:彭博說十月,字節十月第二個週末把半成品搬上衛視晚會交給創作者演示,官方管道全程沒有發布任何公告。Seed 官網列出的模型成果仍然是 Seed2.1、Seedance 2.5、Seedream 5.0 Pro、SeedRealtime、Seed Audio 1.0、Seed GR-RL 六項,論文清單裡有 Seedance 2.0 與三維內容生成的研究,唯獨沒有這款互動世界模型的名字。
對觀眾來說,這段影片的證據力有明確上限。能確認的是展示內容:操作介面、輸入的指令、場景的變化、空間連通的段落,以及機器人與自駕兩個訓練應用,這些都在官方影片裡逐格可查。北京衛視兩個官方帳號在貼文中把它稱為世界模型,晚會又是抖音與北京衛視的雙平台直播,展示出自字節技術的推斷有足夠支撐,投資界的報導也做了同樣認定。
不能確認的也一樣清楚。電視播出版無法證明畫面是現場即時生成,還是預先渲染的錄製內容;這個疑慮並不吹毛求疵,傳聞規格裡 0.05 秒的延遲如果屬實,現場直播示範本該是最有說服力的證明方式,而播出版看不到任何等待時間的資訊。單次指令的等待時間、生成解析度、能維持的場景複雜度、視角回頭時的一致性極限,全部沒有揭露。彭博報導裡每秒 20 幀與 0.05 秒延遲的規格,規格數字同樣出自匿名知情人士、未經證實,字節發言人當時對彭博的詢問不予回應。對創作者最實際的問題,例如場景能不能匯出成 Blender 或遊戲引擎可用的三維檔案、生成一個房間要等多久、成本怎麼算,目前一個都答不了。
換句話說,現在能做的結論只有一種:承認方向,保留驗收。世界模型走向消費級創作的路線,在這場展示裡已經有了可看的外形;它距離每天能用的工具還有多遠,要等字節自己開口。
如果彭博的十月時程可信,字節的正式公告可能就在近期,十月結束前若毫無動靜,傳聞時程就需要重估。屆時可以直接用這場晚會展示當基準:產品名稱與使用管道(獨立應用、即夢平台整合,還是 Pico 頭戴裝置優先)、上面答不了的等待時間與匯出問題逐一核對,再加上每秒幀數與延遲的實測是否接近傳聞的 20 幀與 0.05 秒、即時指令修改的範圍有沒有晚會展示的那麼大,以及台灣使用者能不能直接使用。
三維生成這條線上,Hyper3D 的代理生成模式已經把可編輯模型做成按點數計費的服務;字節選擇的路線更激進,直接生成能走進去、能連通的空間。兩者誰先變成創作者每天的生產工具,會是接下來幾個月最值得追的問題。晚會的結尾,潘天鴻把一支白色紙飛機擲出,呼應晚會的《紙飛機》歌曲,大螢幕最後落下一行書法:科技讓每個人的想像起飛。廣告般的收尾背後,模型還沒有名字,這是此刻最誠實的註腳。