TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Crawl4AI 開源爬蟲實測:本機裝完就能把網頁轉成 LLM 可用的 Markdown,不用 AI 服務也能抽結構化資料;庫內建的雲端橫幅與授權附加條款,採用前先看懂。
用 AI 摘要這篇文章:
要把一個網站餵給 LLM,最髒的活從來不是抓下來,是抓下來之後的事。HTML 裡混著導覽列、側欄廣告、折疊選單和一堆樣式標籤,直接整包丟進模型,token 燒在垃圾上,回答品質還被噪音拖下去;自己寫清洗,html2text 加一堆正則,每換一種版面就要重調一次,維護成本藏在細節裡。Crawl4AI 這個在 GitHub 上有八萬五千顆星的開源 Python 專案,做的就是這一段:把網頁抓下來,輸出成 LLM 讀得懂的 Markdown,必要的時候連結構化資料一起抽好。幾年前這件事要嘛買商業服務、要嘛自己輪一個,現在開源庫把入場券降到零。
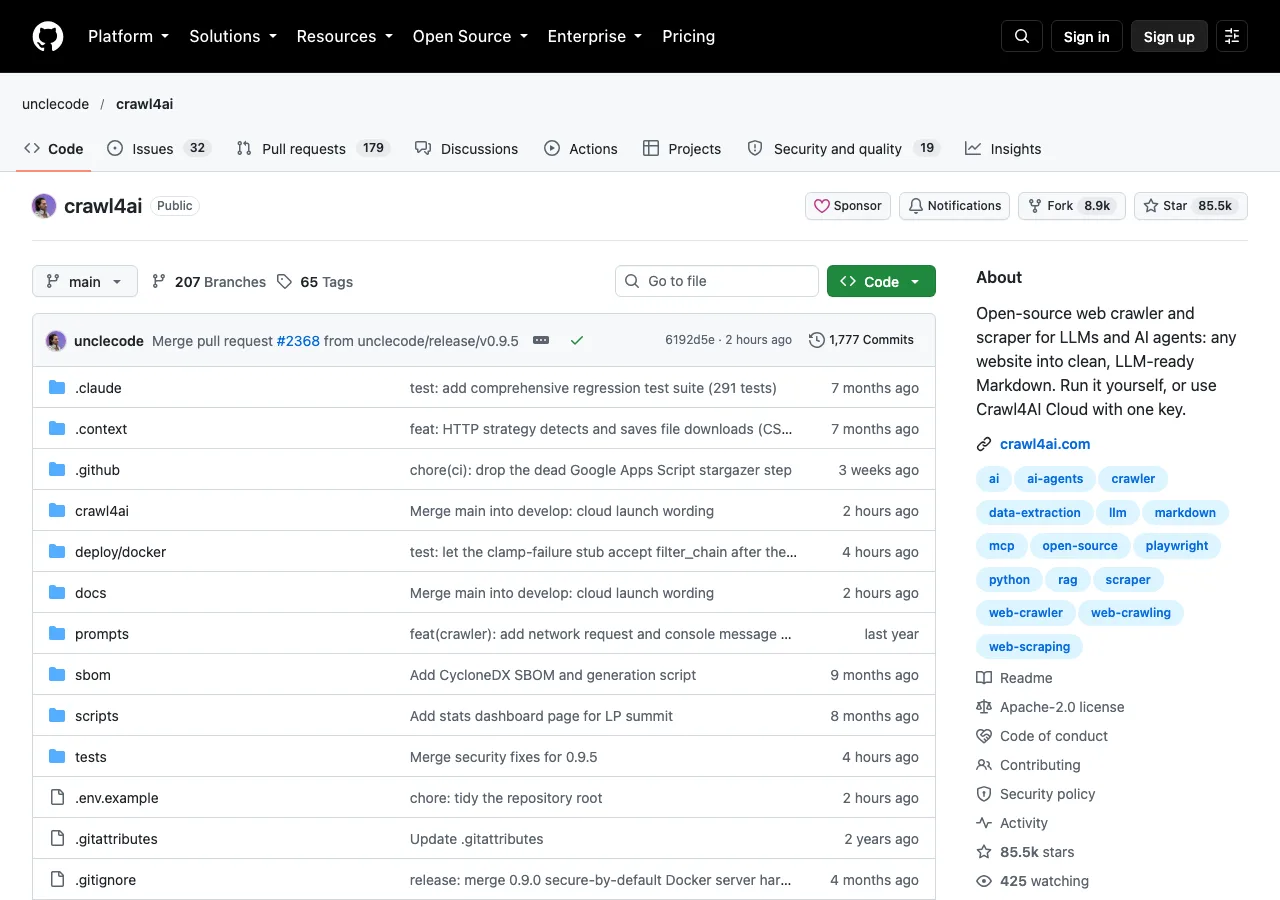
我在 macOS 上把它裝起來跑了一輪,也把原始碼 clone 下來翻了授權檔和幾個關鍵模組。先說結論:引擎是真材實料,本機跑、零遙測、不用任何 AI 服務也能抽出結構化資料;但它已經走到開源本體加雲端收費的雙軌階段,庫裡內建一個會在你被反爬蟲擋下那一刻跳出來的雲端廣告,授權檔在 Apache 條文後面還追加了署名要求。這三件事不影響你免費使用,但值得在你決定採用之前看清楚。
安裝是標準 Python 流程:開一個虛擬環境,pip install -U crawl4ai,然後跑一次 crawl4ai-setup。這一步會下載它要用的無頭瀏覽器(我這次抓的是 Chrome Headless Shell 153,約 94.3MiB),並在本機 home 目錄底下建好 SQLite 快取資料庫。整個過程不需要註冊帳號,不需要 API key,Python 版本要求 3.10 以上。
實際跑第一個爬取,目標是 Hacker News 首頁。從呼叫到結果回來 4.42 秒(包含瀏覽器冷啟動),拿到 17,522 字的 Markdown,頁面上 167 個內部連結和 32 個外部連結都被整理成可點的連結,標題和表格的結構都還在。換成命令列工具 crwl,一行 crwl https://quotes.toscrape.com -o markdown 直接把整頁吐成 4,421 位元組的乾淨 Markdown,管線腳本可以直接接。
第二個測試是真正值錢的內容過濾。它內建幾種過濾策略,我用其中的 PruningContentFilterLXML 測維基百科的 Web Crawler 條目:原始 Markdown 107,904 字,過濾後剩 74,024 字,大約留下七成。要誠實地說,過濾結果開頭還是有一行 Jump to content 的導覽殘留,這個 filter 能把版面噪音壓低,沒有辦法壓到零,重要頁面進 RAG 之前最好還是自己抽驗一下。另外有個小地方值得知道:不設定過濾器時,結果裡的 fit_markdown 欄位是空的,過濾後的版本要你明確掛上 filter 才有。
第三個測試是它對我最有說服力的部分:不用任何 LLM 也能抽結構化資料。我用 JsonCssExtractionStrategy,寫一個 CSS 選擇器 schema(基底選 div.quote,欄位抓 text、author、tags),丟進一個無限滾動的示範頁。它自動捲動載入完整頁面,回傳 50 筆帶型別的 JSON,第一筆是 Einstein 的語錄加四個標籤,最後一筆是 James Baldwin。全程沒有花半毛 AI 的錢,因為抽取是選擇器在做,LLM 根本沒上場。需要 LLM 判讀的場景它也支援,走 LiteLLM 介面自帶 key,provider 自己挑,本地跑 Ollama 也行。
把原始碼 clone 下來掃了一遍遙測:沒有 Sentry、沒有 PostHog、沒有任何分析 SDK,核心爬取路徑裡找不到 phone-home 的呼叫。你抓的頁面落在本機 ~/.crawl4ai/ 底下的 SQLite,快取資料庫就在自己機器上,資料不出門。瀏覽器層還有個貼心設計:預設攔掉 19 個廣告與追蹤網域(google-analytics、doubleclick、hotjar、clarity 這類,清單取材自 uBlock),所以輸出的內容本來就比較乾淨。
資料會離開機器的路徑只有一條,是你自己開的:接 LLM 抽取時,內容會送到你選的模型 provider。LLM 介面這層它用了一個 fork 出來的 LiteLLM(版本鎖死在 1.81.13),provider 清單跟著 LiteLLM 走,OpenAI、Anthropic、Google 或本地 Ollama 都掛得上,key 寫在你自己的設定裡。這條邊界很清楚,跟那種「說是本地工具、照片默默上雲端」的產品不是同一回事。要注意的只有一個工程含義:它的 LLM 相依是鎖版本的 fork,不是上游原版,將來排查抽取問題時記得你跑的是它的分支。
單頁轉 Markdown 只是入口。文件裡載明的能力地圖比我這輪實測跑到的範圍大:深度爬取支援 BFS、DFS 與最佳優先三種走法,長跑任務有斷點恢復(resume_state),掛了可以接著上次的進度續爬;要先把一批 URL 湊齊,有 URL 種子器會吃 sitemap 和 Common Crawl;還有一個 Adaptive 模式,宣稱爬到「足以回答你的查詢」就停,把探索範圍收斂在相關頁面上。這幾項我沒有逐一實測,採信的是官方文件與原始碼裡的對應模組,規模大的專案建議先小範圍驗證再擴大。
兩個跟日常使用貼近的設計值得單獨提。需要登入的網站,它可以開一個持久的瀏覽器設定檔,你登入一次,cookie 和狀態留在本機 profile 裡,之後的爬取帶著同一個身分走;跨頁多步操作有 session 機制,第一步搜尋、第二步進細節頁這種流程不必每次重來。再來是輸出端:頁面上的圖片、音訊、影片標籤和內外連結會被整理成結構化欄位,連結能自動編成編號的參照清單,餵模型時引用來源這件事它先幫你做了一半。
往 RAG 的方向再走一步,它連「切塊」都備好了:長頁面可以按主題、句界或正則切塊,配一個用餘弦相似度挑出跟查詢相關段落的策略;過濾器除了一般剪枝,還有一種帶查詢的 BM25 模式,同一個頁面針對不同問題留下不同段落。這兩個能力決定了它不只是「轉檔器」,而是把檢索前的預處理一併做了,做 RAG 的人可以少寫一層膠水程式。
還有反偵測這條線。它相依 patchright 和 playwright-stealth 這兩個專門對付瀏覽器指紋偵測的套件,也有 magic 模式和 stealth 開關。這是工具的必修課,也是法律模糊地帶:爬什麼、怎麼爬、robots.txt 尊不尊重,責任在使用者身上,工具只提供能力。拿它做什麼之前,先想清楚目標網站的服務條款。
Crawl4AI 現在有雲端服務,而推銷就寫在開源庫裡。cloud_notice.py 這個模組定義了一個黃色橫幅,會在四個時機印出來:安裝完成時、第一次啟動爬蟲時、安裝失敗時,以及爬取被反爬蟲防護擋下時。前兩個我親眼看到了,裝完 setup 橫幅就出現在終端機,第一次跑爬蟲又出現一次(每天最多一次,之後改為每個版本提醒一次,這個頻率寫到 2027 年)。
最值得注意的是第四個觸發點。原始碼 async_webcrawler.py 第 643 行附近:偵測到頁面把你擋下,它把結果標成失敗、寫入錯誤訊息,然後印出雲端廣告。程式註解自己寫得很明白,說那是 hosted crawler 幫助最大的時刻。換句話說,廣告精準地插在你最挫敗的那一秒,因為那一刻你確實最可能願意付錢換一條路。從商業設計看這很聰明;從使用者角度看,你該知道它存在。
橫幅只走 stderr,不會混進 stdout 的管線輸出,連結帶著 ref 標記讓雲端知道你從哪個情境來。不想看到它,設一個環境變數 CRAWL4AI_NO_CLOUD_NOTICE=1 就全部關掉,我實測有效。這點要給它肯定:關閉開關是真的,不是裝飾。
回頭看這套設計的來由,作者的說法可供參考:他在 README 自述 2023 年要做網頁轉 Markdown,當時打著開源名號的方案要註冊帳號、要 API token、還要 16 美元,他幾天內自己寫了一個丟上網,就此爆紅;現在的定位是「程式碼為可用性開源,平台為可負擔而建」。這是單方敘事,聽聽就好,但對照那個時間點的市場,Crawl4AI 確實把「先註冊再說」的慣例打掉重練了一遍,如今 8.5 萬顆星、大約一個月一個版本的速度,也說明這條路徑有它的群眾基礎。
GitHub 把授權標成 Apache-2.0,寬鬆、可商用、可改。但打開 LICENSE 檔案往下捲,在標準 Apache 條文結束之後,還追加了一節署名要求:任何散布、發表或公開使用這套軟體或其衍生作品,都必須附上指定的署名文字(標明 UncleCode 與專案網址),而且列了建議放置的位置,包括文件的致謝段、網站的關於頁,甚至部落格文章。
嚴格說,這已經超過 Apache-2.0 原本的義務範圍(原條文只要求散布時保留 NOTICE 與授權聲明),是一條額外的附加條款。它要求附上的那句話是:”This product includes software developed by UncleCode as part of the Crawl4AI project”,後面帶作者的 X 帳號與 GitHub 網址。放在哪也有建議:軟體散布放 NOTICE 或 README,研究論文放致謝或註腳,網站放關於頁,命令列工具放說明輸出。
實務上怎麼看待這條:公司內部拿來跑資料管線,多半不構成「公開使用」,風險很低;要包進對外提供的產品或在公開服務裡用它產出內容,就把這一節原文丟給法務看一眼,別只看 GitHub 標籤就簽字。條款的措辭範圍寬(連 public uses 都算),解釋空間大,提前盤點比事後補救便宜。
放在同類裡比,這個條件其實算中間值。同一領域的 Firecrawl(19.1 萬顆星)走 AGPL-3.0,對閉源商用的限制嚴格得多;老牌的 Scrapy(6.5 萬顆星)是 BSD-3-Clause,最寬鬆。Crawl4AI 的 Apache 加署名附加條款,落在兩者之間,商用整合的摩擦比 AGPL 小很多。
雲端把同一套引擎放在他們那邊跑,一個 API key 通吃幾個端點:/scrape 把頁面轉 Markdown,/extract 直接抽結構化資料(不用自備 LLM key),/search 做網頁搜尋,/serp 把 Google 結果頁當資料回傳(測試版),批次場景一次串流最多 50 條 URL,背景工作最多 10,000 條,還有盯頁面變動的 monitors 和給 Claude Code、Cursor 用的 MCP 端點。接 agent 的那條路官方給了一行指令,claude mcp add 帶上你的 key 就把爬蟲變成 agent 的工具;monitors 則是反過來的用法,你描述「這個定價頁漲價或下架時通知我」,它定期檢查、比對版本、命中條件就發 webhook,文件裡的示範就是盯競品方案從每月 49 變 59 美元這種事。
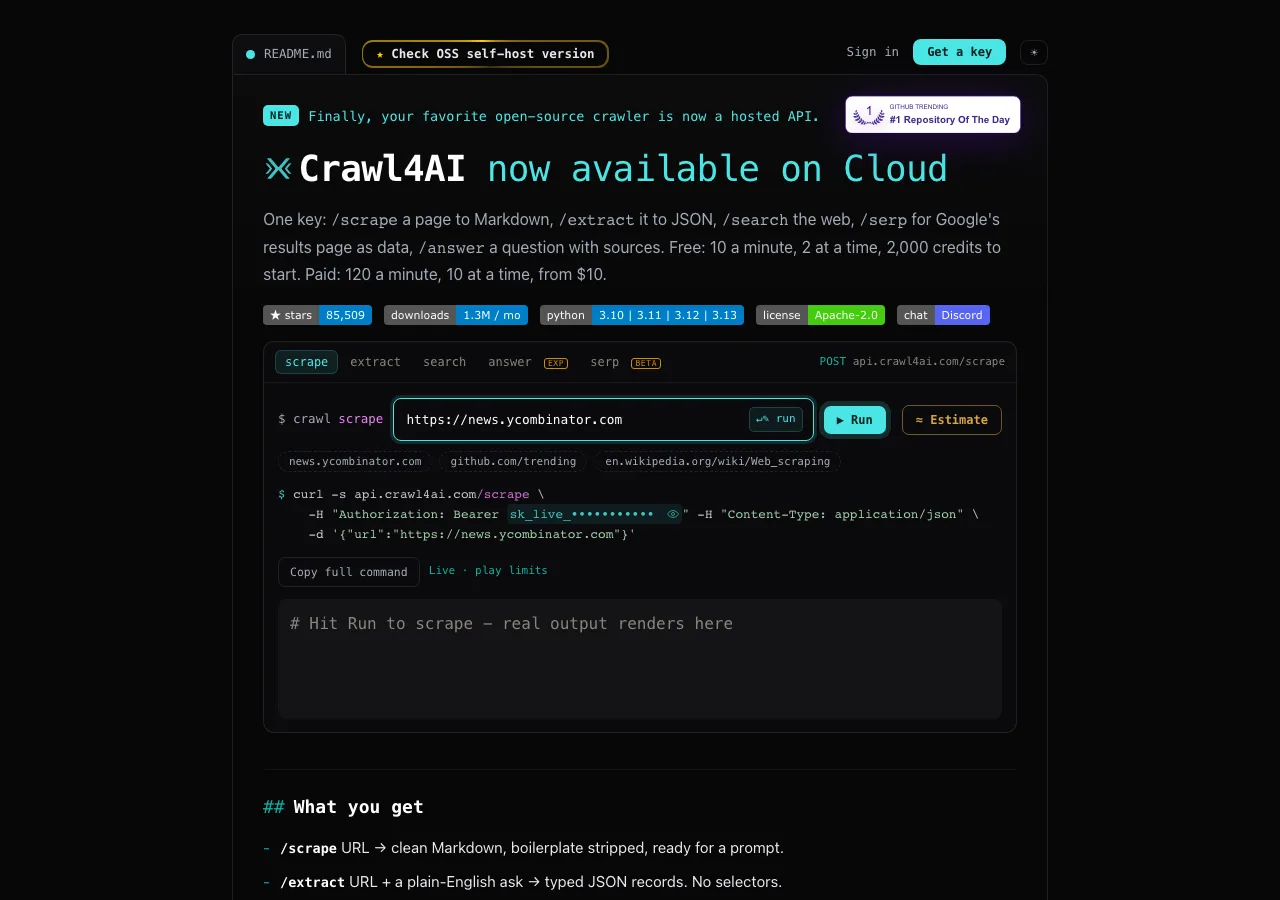
計價用點數制,一點 0.001 美元。免費方案每分鐘 10 個請求,超過會收到 429,文件裡連錯誤訊息都先寫好了:免費方案限的是速度,點數還是你的,任何儲值會把速度永久提到每分鐘 120 個請求、10 個併發。免費額度文件表格寫每月 2,500 點,README 寫 2,000 點起跑,兩個數字對不上,官方也明講現在是軟啟動期,價格與免費額度會調,即時數字以它的 /v1/prices 端點為準。計費的幾個規則寫得清楚:被目標網站擋下或伺服器自己出錯不收錢,目標站回的 4xx 原樣轉達也不收,monitor 每次檢查收 1 點、命中條件的變動另計 3 點,被擋或失敗的檢查不計費。雲端與庫的分工在文件裡也畫得明白:庫在你機器上跑瀏覽器,雲端的引擎會按網域自動挑路徑(快取、純 HTTP、瀏覽器),反爬蟲與代理它扛。
| Python 庫 | 自架 Docker 伺服器 | 雲端 | |
|---|---|---|---|
| 瀏覽器誰跑 | 你的 Python 程序內 | 你機器上的容器 | 站方 |
| JS 重頁面與反爬蟲牆 | 自己調設定與代理 | 自己調設定與代理 | 自動處理 |
| 網頁搜尋 | 無 | 無 | 有 |
| 費用 | 免費 | 免費(自己出機器) | 按點數計費 |
自己的判斷是這樣:資料不能出門(內部文件、客戶資料背景的爬取)或長期大量跑,用庫或 Docker 自架,成本壓得最低;要快速驗證一個想法、或目標網站反爬蟲很兇自己搞不定,雲端的免費額度夠你試出結論再決定。想把爬蟲能力接給 AI agent 又不想管瀏覽器,自架 Docker 的 MCP 端點比把整台瀏覽器塞進 agent 環境乾淨。
Docker 模式值得多說兩句,因為它是「自己跑但服務化」的中間選項。一個容器、一個 CRAWL4AI_API_TOKEN 環境變數,起在 11235 埠,就有一組 REST 端點(轉 Markdown、取原始 HTML、截圖、轉 PDF、執行 JS,最後這項基於安全預設關閉,要用環境變數打開)加上儀表板和 playground 頁。有意思的是它對安全的態度:沒設 token 又綁對外位址時,伺服器直接拒絕啟動;只綁容器內部迴路時,它也會自動生成一個一次性 token 才放行;而且伺服器模式對外來 URL 走一套把 DNS 解析結果釘住、每個重導向重新驗證的轉發代理,防的就是 DNS rebinding 這類 SSRF 攻擊。多數開源工具的自架模式不會做到這一層,這是它工程品質有拿出來的地方。
專案維護得非常活躍,v0.9.5 在我測試當天發布,約一個月一版,未結 issue(不含合併請求)32 筆,有個快取 bug 從回報到修完不到一天。但翻未結清單有幾個值得記下的,各自對應不同的使用情境:Docker 模式在 macOS 上長跑有記憶體漏問題回報(#1256,容器會崩),影響的是把 /md 端點當常駐服務打的人;scan_full_page 搭配抽取時分頁內容可能只剩最後一段(#731),依賴無限滾動抽取的要小心驗證筆數;部分頁面轉 Markdown 會丟失標題層級或表格結構(#1964),對文件類頁面要先抽查大綱;WSL 加系統代理的環境瀏覽器會無限卡住(#1930),公司網路下的 Windows 使用者先看這條再決定部署平台。要在生產環境長跑的人,把這幾條對照自己的部署方式,該迴避的先迴避。
還要交代我測試的邊界:單機 macOS、三個頁面的小樣本,能證明它安裝順、產出可用、承諾的功能真的在,不能證明它在大規模生產環境的穩定性。多頁深爬、Adaptive 模式、雲端端點這三塊我沒有實測,相關段落的事實來源是官方文件與原始碼,不是我的跑分。Windows 原生環境我沒測,WSL 使用者建議先看上面那條 issue。
你在做 RAG、在幫 agent 接網頁能力、或定期要把一批網頁變成乾淨文字,在同類開源方案裡,這是門檻最低的起點之一:免費、本地、無 LLM 也能抽結構,維護頻率放心。重視授權乾淨的商用整合,讀完 LICENSE 附加那節再動工。需要裝好就能用、不想碰瀏覽器設定的人,直接看雲端,或考慮之前介紹過的 BrowserAct 這類 no-code 服務;想用視覺化方式拉爬蟲流程的,KSpider 那種擴充型工具更對味;要的是瀏覽器自動化而非餵資料給 LLM,DrissionPage 那條路更合適。
建環境、裝庫、跑設定,三個指令:
python -m venv .venv && source .venv/bin/activate
pip install -U crawl4ai
crawl4ai-setup
然後用官方文件首頁那個範例就能拿到第一份 Markdown:
import asyncio
from crawl4ai import AsyncWebCrawler

async def main():
    async with AsyncWebCrawler() as crawler:
        result = await crawler.arun(url="https://news.ycombinator.com")
        print(result.markdown)

asyncio.run(main())
要餵 RAG,加上 PruningContentFilter 再抓一次,比對 raw 和 fit 兩個欄位的長度,你會馬上感覺到差別;想看這種清洗在真實檢索應用裡的樣子,可以參考我們之前拆過的 FinSight-AI 投研平台。被雲端橫幅吵到之前,先把 CRAWL4AI_NO_CLOUD_NOTICE=1 放進你的專案環境變數,圖個清靜。