TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

創投 Visionaries 的 General Partner、Langdock 共同執行長 Judith Dada 在 X 發布兩張 AI 能力與成本圖:12 項能力放在熟練人類基準上比較,推理與知識已跨過人類、最便宜達 3,000 倍,長期記憶與規劃仍在圈內;圖上數值為作者判斷式換算,作者同日依批評改版。
用 AI 摘要這篇文章:
AI 到底有多強,最常見的答案是一個分數或一張排行榜。10 月 4 日晚間 7 時 13 分(台北時間),創投 Visionaries 的 General Partner、同時擔任 Langdock 共同執行長的 Judith Dada 在 X 上給了另一種答案:兩張圖。能力圖把前沿 AI 的能力拆成 12 項,畫在熟練人類基準(訂為 1.0)的圓圈上,虛線是 2025 年 10 月的前沿模型,實心尖角是 2026 年 10 月;成本圖換了一個問題,同樣這批能力,跨過人類品質之後比人類便宜多少倍。她對這一年變化的總結寫在貼文開頭:AI got spikier, not rounder,變得更尖,而不是更圓。
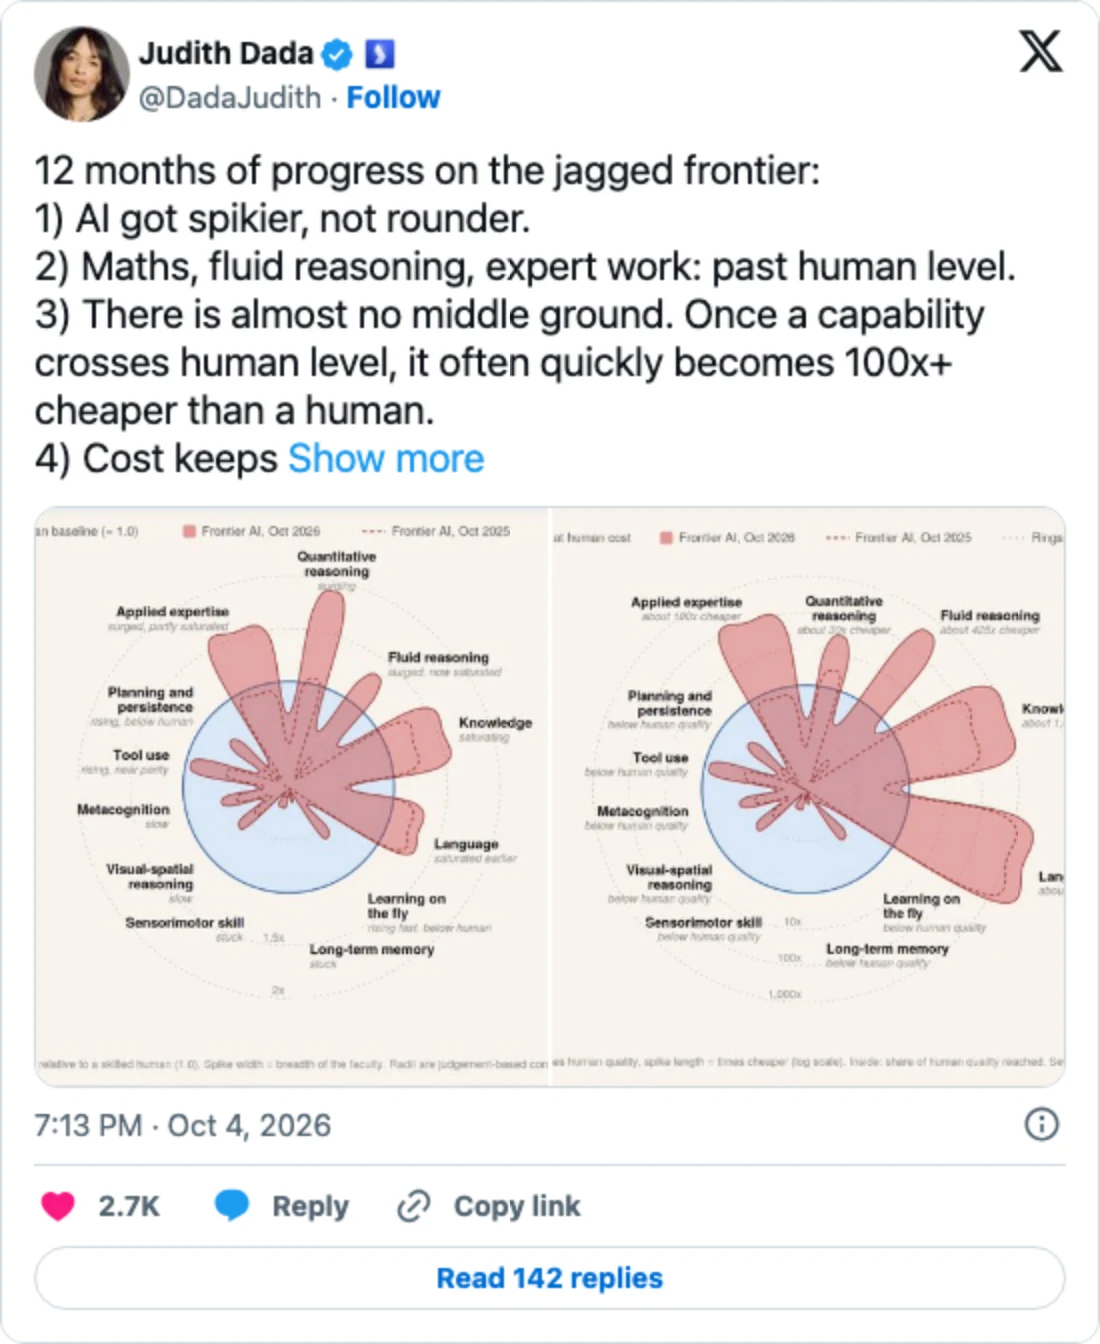
這句話的意思是,強項一路變強,弱項沒有跟著補上。數學、流體推理與應用專業工作被畫在人類圈外,長期記憶與感覺動作技能在圖上標為停滯。成本那張圖更陡:語言約便宜 3,000 倍、知識約 1,000 倍、流體推理約 425 倍,倍數畫在對數刻度上。截至 10 月 12 日凌晨,主貼文累積超過 2,700 個讚與 140 則回覆,作者補上的修正圖與經濟學家 Robin Hanson 的引用文也各有兩百多個讚;X 不提供可第三方複核的瀏覽數字,實際觸及只能從互動量推估。
不過這組圖的價值與限制來自同一個地方。每根尖角的長度,是作者依評測結果自行換算的位置;能力圖的註腳明寫了這一點,成本圖的註腳則明寫部分數值為估計;貼文發出不到兩小時,她因為讀者批評承認雷達圖的形式有誤導,補上一組楔形修正圖。可以核對的是她怎麼畫、怎麼改;不能核對的是每根半徑的精確值。這條線先畫在心裡,再往下看圖。
雷達圖的讀法有三個約定,都寫在圖上。藍色圓圈代表熟練人類基準,訂為 1.0;粉色尖角往外伸得愈長,代表前沿 AI 在該項能力超越人類愈多;尖角的寬度代表該項能力涵蓋的範圍。圖上另畫了 1.5 倍與 2 倍兩圈參考刻度,圈外就是超越人類的區域。從圖上的視覺對比看,虛線的 2025 年 10 月輪廓整體收在實心形狀內側,一年間外推幅度最大的幾軸,正好都落在已經超越人類的那一批。圖上沒有指名任何模型型號,只以 2026 年 10 月與 2025 年 10 月兩個時點呈現前沿模型的整體水準。
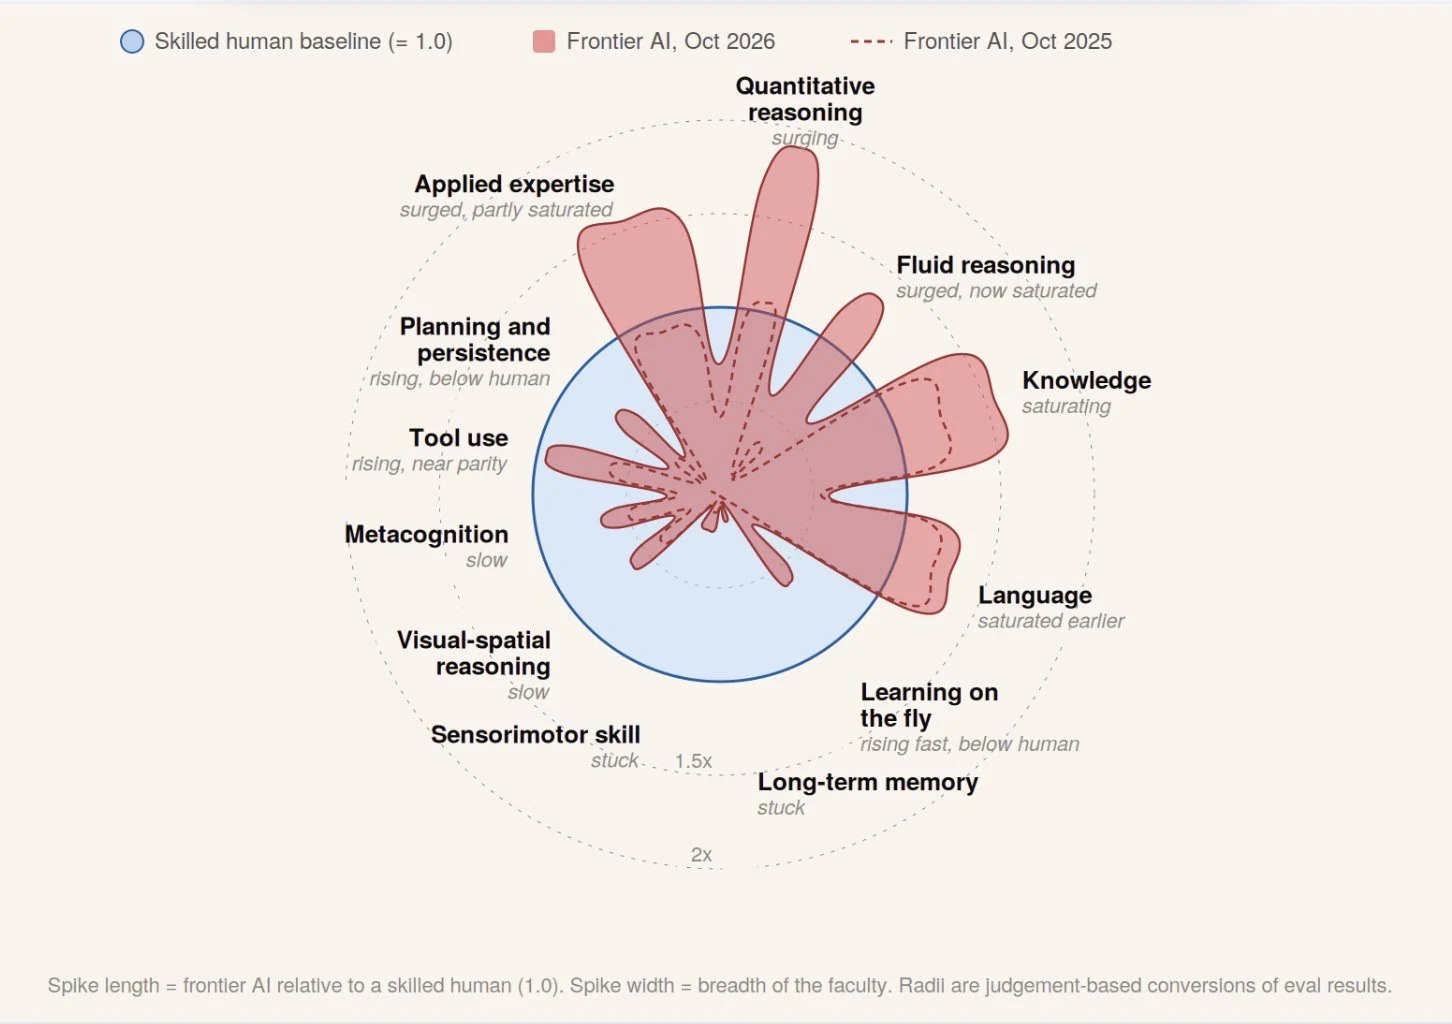
12 項能力的位置與作者在圖上加的註解整理成下表,原圖為英文標籤,表中註解是中譯:
| 能力 | 圖上註解 | 相對熟練人類 |
|---|---|---|
| 量化推理 | 快速竄升 | 超越 |
| 流體推理 | 已大升,現趨飽和 | 超越 |
| 應用專業知識 | 已大升,部分飽和 | 超越 |
| 知識 | 邁向飽和 | 超越 |
| 語言 | 較早飽和 | 超越 |
| 工具使用 | 上升,接近持平 | 貼近 |
| 規劃與堅持 | 上升,低於人類 | 落後 |
| 即時學習 | 快速上升,低於人類 | 落後 |
| 後設認知 | 進展緩慢 | 落後 |
| 視覺空間推理 | 進展緩慢 | 落後 |
| 感覺動作技能 | 停滯 | 落後 |
| 長期記憶 | 停滯 | 落後 |
分組看會浮出一個模式:還在人類圈內的那側,集中了長時間獨立做事需要的能力,記得前情、自己檢查自己、邊做邊學、按計畫推進;已經跨出去的那側,集中在可以單次呼叫完成的推理與知識工作。這個分組屬於編輯觀察,作者本人沒有這樣畫線,但兩張圖並列時方向一致:還在人類圈內的七項,在成本圖上全部落在尚未達到人類品質的區域,連計價都還沒開始。
成本圖把問題從「會不會」換成「多少錢」。圓圈代表以人類成本達到人類品質;尖角伸到圈外,長度就是比人類便宜的倍數,刻度是對數的 10 倍、100 倍、1,000 倍。落在圈外的五項:語言約 3,000 倍、知識約 1,000 倍、流體推理約 425 倍、應用專業知識約 100 倍、量化推理約 30 倍;其餘七項標示為尚未達到人類品質。圖上註腳對圈內那側也有交代:落在圈內呈現的是已達到人類品質的比例,換句話說,圈內計的是已達到人類品質的比例,還沒有走到用倍數計價的那道門檻。
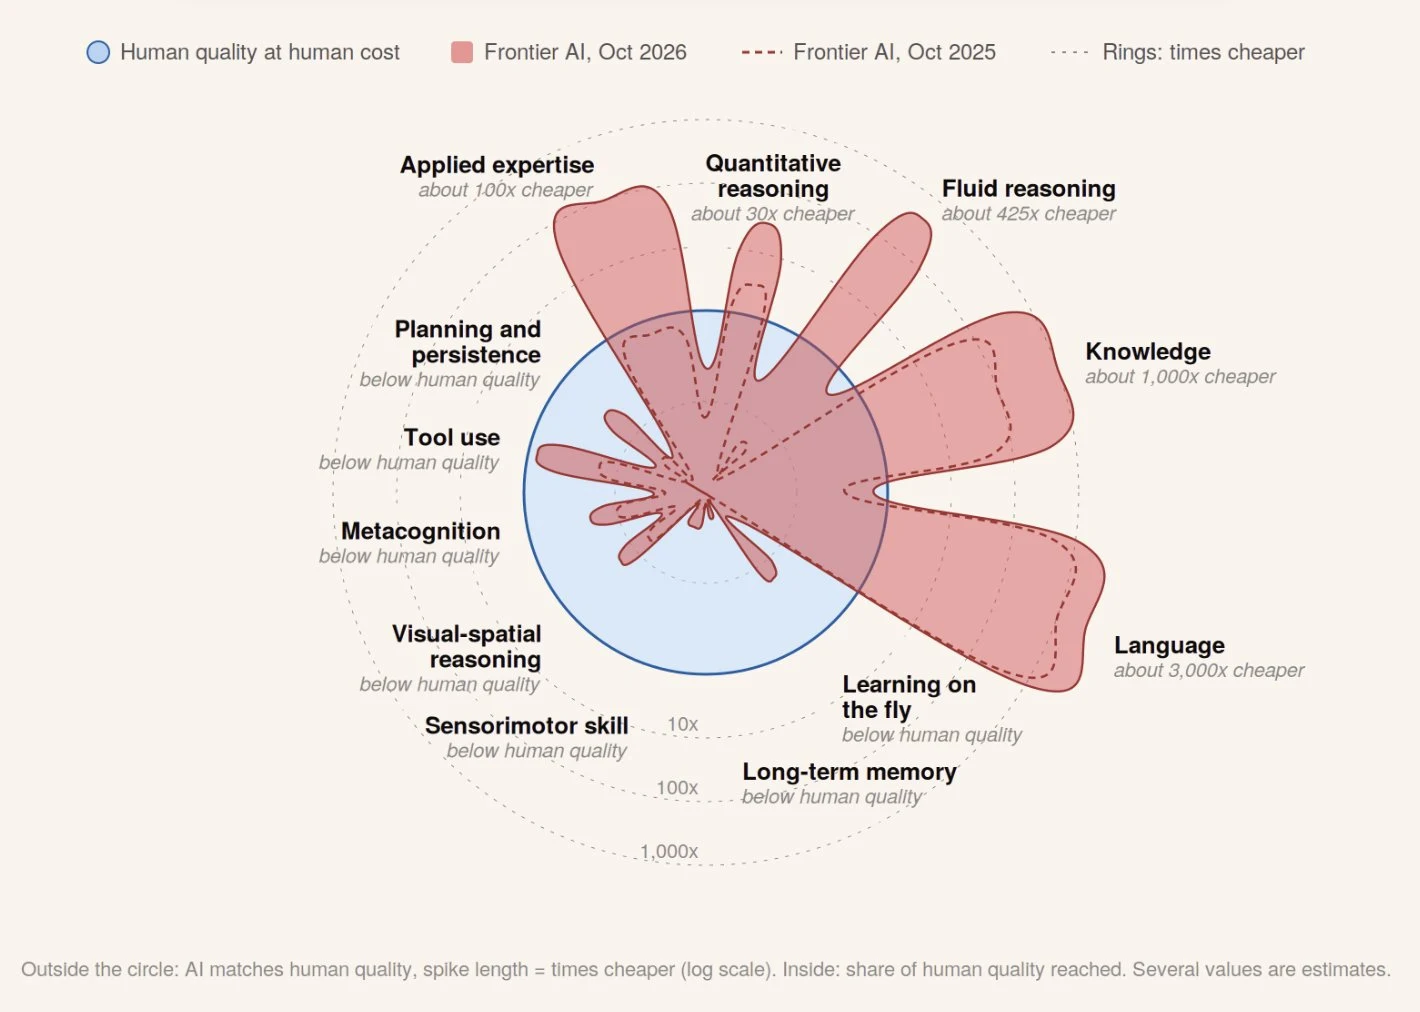
作者對這個現象的總結值得逐字看。主貼文列了四點觀察,完整可見的前三點是:AI got spikier, not rounder(變得更尖,而不是更圓);Maths, fluid reasoning, expert work: past human level(數學、流體推理、專業工作已過人類水準);There is almost no middle ground. Once a capability crosses human level, it often quickly becomes 100x+ cheaper than a human(幾乎沒有中間地帶,一項能力跨過人類水準後,常常很快變得比人類便宜一百倍以上)。第四點從成本說起,在 X 的顯示長度限制處截斷,這裡不做引伸。三點都屬於作者主張,圖的註腳也自承是判斷式換算,引用時當方向看,不當測量值看。
「幾乎沒有中間地帶」是整組圖最值得記住的一句。它講的與品質排名無關,而是經濟結構:同一批模型,在圈內那側還需要人類盯著、校正、補上記憶;在圈外那側以倍數計價,最極端的語言約是人類的三千分之一。對正在決定把哪些工作交給 AI 的人,這條線比任何總分都實用。
這組圖有一段常被轉述漏掉的後續。主貼文發出後約 1 小時 46 分(台北晚間 8 時 59 分),有讀者指出圖的形式有問題,作者的回覆沒有辯護:Actually fair criticism, I was primed by past jagged visualisations. Should look more something like this now(確實是合理的批評,我先入為主受了過往鋸齒狀視覺化的影響,現在的樣子應該更接近這樣),並附上修正版。
修正的細節比結論有意思。原圖是雷達圖,12 項能力等角分布,連成一個封閉多邊形。這種畫法有個副作用:多邊形的邊會讓人以為相鄰兩項能力之間存在連續的過渡地帶,凹陷處看起來像某種中間狀態。修正版改成楔形圖,每項能力是獨立的扇形,高度仍代表相對人類的位置,寬度代表能力廣度,彼此不再連線;能力版的 1.5 倍與 2 倍參考圈、成本版的 10 倍到 1,000 倍對數環都保留,兩張圖的數值與圖例也沒有換。實質定義沒有變,註腳用語跟著形式換:Spike 改成 Wedge、Radii 改成 Heights(judgement-based conversions of eval results,依評測結果所做的判斷式換算)。數值內容沒有變,變的是形式背後的假設。
作者當天改圖這件事,本身就是閱讀這類地圖的正確姿勢:它們是會被修訂的判斷,還不是定稿的測量。
Jagged frontier(鋸齒狀前沿)這個說法有明確的學術源頭。哈佛商學院等機構的研究者與波士頓顧問公司合作,設計 18 項落在 AI 能力界線內的顧問任務與 1 項刻意選在界線外的複雜任務,讓 758 名知識工作者隨機分到不用 AI、用 GPT-4、用 GPT-4 加提示工程教學三組。界線內的任務,用 AI 的人平均多完成 12.2%、快 25.1%,產出品質顯著較好;界線外那項任務,用 AI 的人給出正確解的機率低了 19%。這份預先註冊的實場實驗在 2026 年 3 月刊於 Organization Science,由 Dell’Acqua 等九位作者署名。
論文與 Dada 的圖共用一個概念,尺度不同。實驗測的是特定工具(GPT-4,其中一組加上提示工程教學)在特定任務組上的表現,界內界外的差異發生在同一個工作流程裡;Dada 的圖把同樣的直覺放大到 12 項認知能力、一年跨度與成本結構,代價是換算過程變成作者判斷。兩者並讀得到的結論比較健康:鋸齒效應本身有實驗證據,12 根尖角的精確長度則沒有。
實驗還補上圖表講不到的一塊:界線會移動,而且移動方向對使用者不一定友善。實驗當時的受試者在界內拿到紅利、在界外吃虧;Dada 的圖顯示 2026 年 10 月已經有五項能力跨到圈外,等於界線整片往外推。對讀者的實際意義是,實驗時還在界外、用了反而更容易出錯的那類任務,現在可能已經翻到界內,反向也成立,把實驗當時的經驗直接搬到今天用,兩個方向都可能出錯。
經濟學家 Robin Hanson 在同日晚間 11 時 20 分(台北時間)引用這組圖,給出收斂的解讀:A continuation of this trend leads to AIs that automate some, but far from all, tasks now done by humans. Which keeps us in a familiar economic world(這個趨勢延續下去,會得到自動化部分、而且遠非全部現有人類任務的 AI,經濟於是留在我們熟悉的世界)。這個讀法與成本圖互相印證:跨過人類水準的能力會被自動化、價格崩落;沒跨過的仍由人類執行。兩者長期並存,一次性全面取代的劇本在這組證據裡找不到支撐。
Dada 的背景讓這組圖多一層參考價值。visionaries.vc 團隊頁列她的職稱為 General Partner,投資重心是企業服務與 AI 驅動的商業模型,過往投資組合包含 Personio、Parloa、Orbem 等公司,她曾任職的歐洲早期創投 La Famiglia 在 2024 年併入 General Catalyst;她同時掛名 Langdock 共同執行長,該公司做的是給全公司用的 AI 平台,涵蓋對話、工作流與代理。換句話說,畫圖的人每天的功課就是判斷哪些 AI 能力已經能拿去做生意,這張圖是她把這類判斷攤開給外界看。
換算方式出於作者判斷,證據等級還不到測試分數。能力圖的註腳明寫半徑(修正版為高度)為依評測結果所做的判斷式換算,成本圖的註腳明寫部分數值為估計,兩張圖都未附評測清單與換算式。圖適合看方向與分組,不適合做精確比較或寫進採購文件。
圖上沒有模型名。前沿 AI 以 2026 年 10 月與 2025 年 10 月兩個時點呈現,未指名型號,回答不了該買哪一家這類問題;採購判斷仍要回到各家的評測與定價頁。
圖會改版。從發布到修正不到兩小時,楔形版已經是第二版,後續若有修訂,以作者的 X 帳號為準。要引用的人,引分組(哪五項跨過、哪七項還在圈內)比引倍數穩。
對一般讀者,這組圖最實用的位置是當任務形狀的檢查表。把一段會議記錄整理成摘要、查一個法規條文、把中文新聞翻成英文,這類工作本質是單次的推理、知識查找與語言轉換,多半已落在斷層的自動化那側,值得認真考慮交出去;接手一個為期三個月的專案、要記得住每個客戶說過什麼、要在自己沒發現的錯誤釀成問題前攔下來,這類工作需要跨週期記住前情、自己檢查自己、按長期計畫推進,它還在人類這側,AI 至多是加速器。想往落地再走一步,單一模型的對照可以看 Jev 模型怎麼把鋸齒性變成產品設計與 TypeSafe 整理的九種失敗模式;測量端可以對照 Anthropic 把研發速度做成三項對外指標的做法;供給爆炸與使用量之間的落差,則可以回看 NBER 的 AI 應用供給研究。能力地圖會一直有人畫,讀圖的紀律比記住哪一格更耐用。