TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

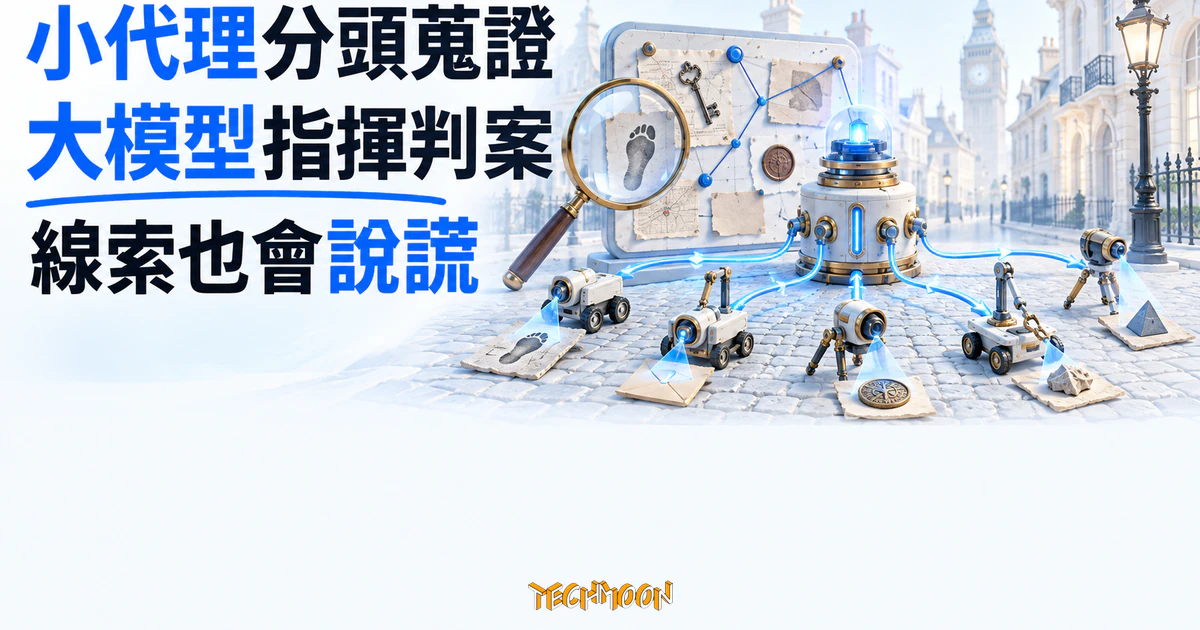
LMGame 團隊用一款可重播的福爾摩斯偵探遊戲測 AI 分工:GPT-6 Astra 指揮 12 個 Jev 代理辦案,100 案解 96 案、每案 0.58 美元;但證據誠實時免費的計數規則就解 97 案,栽贓案裡規則全垮只剩大模型撐住 93 案。原始逐案紀錄公開可重算,重跑前要注意授權與模型銜接兩個缺口。
用 AI 摘要這篇文章:
一個大型推理模型單打獨鬥,和一堆便宜的小代理一起辦案,哪一種會先抓到兇手?LMGame 團隊把這個問題做成一款可以逐案重播的福爾摩斯偵探遊戲 The Irregulars,並在專案部落格與 GitHub 公開完整基準結果:GPT-6 Astra 坐鎮貝克街 221B 負責推理與指揮,12 個 Jev 代理在城裡跑腿蒐證,100 個標準案件解開 96 案,每案平均成本 0.582 美元。
不過同一張結果表裡藏著更有意思的對照:一個不花半毛錢、從指揮到跑腿全靠計數規則的偵探組合,同樣 100 案解開 97 案。兩種做法的真正差距,要到證據被刻意佈置成會說謊的栽贓案裡才翻轉過來。
時間軸可以從 GitHub 完整核對:程式倉庫 2026 年 9 月 30 日建立,兩批百案基準在 10 月 4 日執行,部落格文章 10 月 5 日首次發布,10 月 11 日還有一波修訂。這是本週新鮮出爐、而且每一個數字都能下載原始紀錄重算的結果。
每起案件發生在一座程式生成的維多利亞時代倫敦:100 個地址、10 名嫌犯,每個地址藏一條線索,可能是證人證詞、腳印、與案情無關的干擾,或是一句謊言。破案的定義很嚴格:在 12 小時的案例時鐘內,同時答對兇手、動機與藏身處三件事才算成立。案例時鐘是故事裡的模擬時間,與電腦實際執行的秒數分開計算,兩者在結果表各有一欄。
遊戲的關鍵設計是線索的分配方式:每個真實的關鍵事實預設出現在 2 個地址,每個謊言只有 1 份。換句話說,只要把全城的線索收集完,重複出現的就是真相,「數線索」這個笨方法在標準案裡天生有效。這是刻意安排:倉庫裡的規則文件明寫 redundancy 預設值為 2,啟動畫面還會預覽案件並標明它是否可用計數解開。
三種偵探輪流上場:Holmes 組合是 GPT-6 Astra 待在貝克街下達調查指令,12 個 Jev 代理分頭跑腿、當面向他報告;孤膽天才(The Lone Genius)是單一 GPT-6 Astra 自己搭馬車挨家查訪;無領袖群是 100 個 Jev 代理沒有指揮者,彼此在 2 公里喊話範圍內分享線索並投票,湊滿 30 票一致答案就結案。另外還有兩個手寫基線可以扮演任何角色:會分配地址的規則搜尋器,與挑最多重複答案的計數器,兩者零成本、每案跑不到 0.1 秒。
貝克街模式的分工細節照著原著走:Holmes 先簡報案情,接著由名叫 Wiggins 的代理人把任務分給一群男孩,男孩只做「下一步去哪、要不要跟蹤、什麼時候跑回來」這類小型在地決定,從不指控任何人,蒐到的線索要親自跑回前哨站報告,Holmes 再依報告重新派工,等證據收攏才給出最終答案。無領袖群那邊則內建了一套防謊機制,預設開啟:同一地址的證詞只算一次,被抓到講述自己不可能親見之事的代理會被周圍標記為說謊者,他之後的發言與選票都會被排除,旁聽的代理還會出聲反駁,讓不信任沿著喊話網路傳開。
跑腿用的 Jev 是 TypeSafe 推出的決策模型,專門回答選擇題、是非機率與評分這類固定格式的問題而不生成文字,先前的第一手介紹與挑選適用任務的 Use Case Map 教學都談過它的定位。這項實驗經 OpenRouter 的 System One 端點呼叫 jev-1.13。
標準案 100 案的戰績:Holmes 組合解開 96 案(95% 信賴區間 90 到 98),孤膽天才 57 案,無領袖 Jev 群 38 案,單打 Jev 只有 25 案;單打上場的計數規則拿到 61 案,高於孤膽天才。免費基線方面,規則版的貝克街指揮加規則代理群解開 97 案,是全表最高;把跑腿換成 Jev、指揮仍用計數規則,也有 95 案,每案成本 0.002 美元。
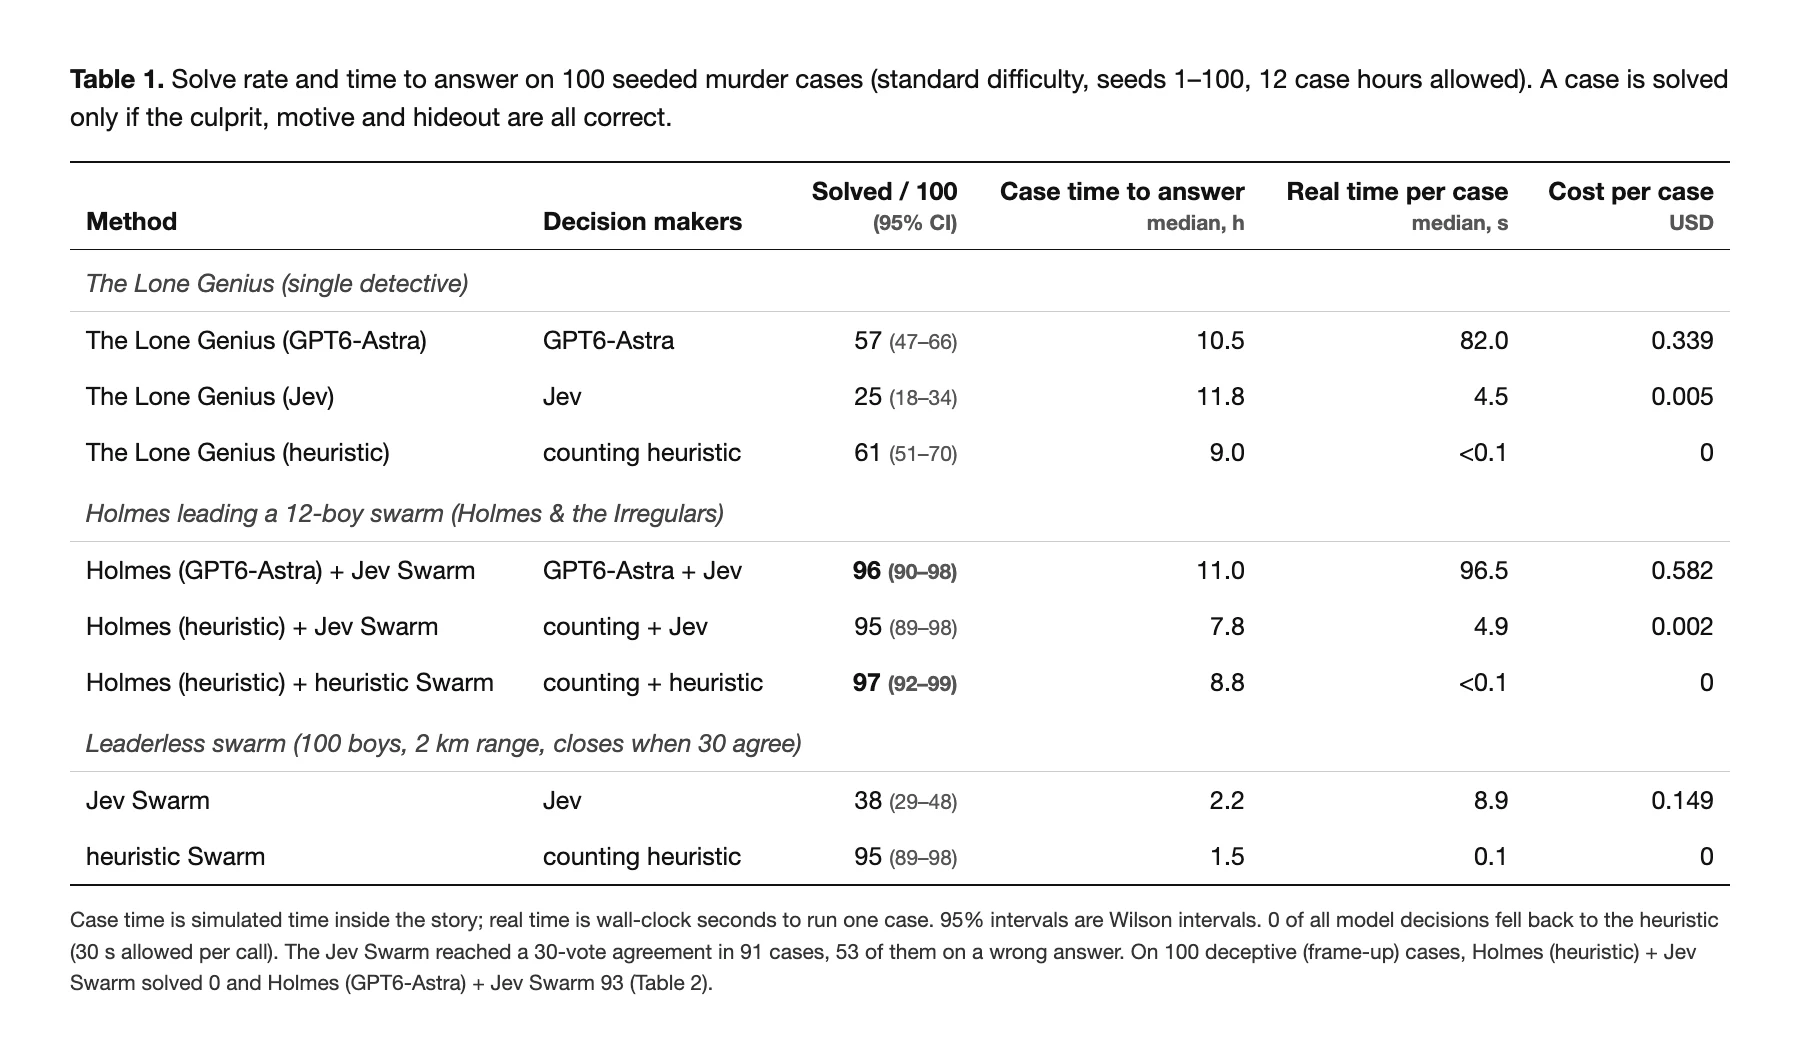
無領袖群的敗法值得細看。它是三種模型偵探裡最快的一個,半數案件在案例時鐘 2.2 小時內就結案,但 100 案裡有 91 案順利湊滿 30 票共識,其中 53 案答案是錯的。團隊的解讀是:少數代理誤讀線索後,喊話範圍內的鄰居跟著投下有把握的票,錯誤在有人查證之前就擴散開來。這是投票式代理群的典型風險:共識形成得快,與共識正確與否沒有關係。
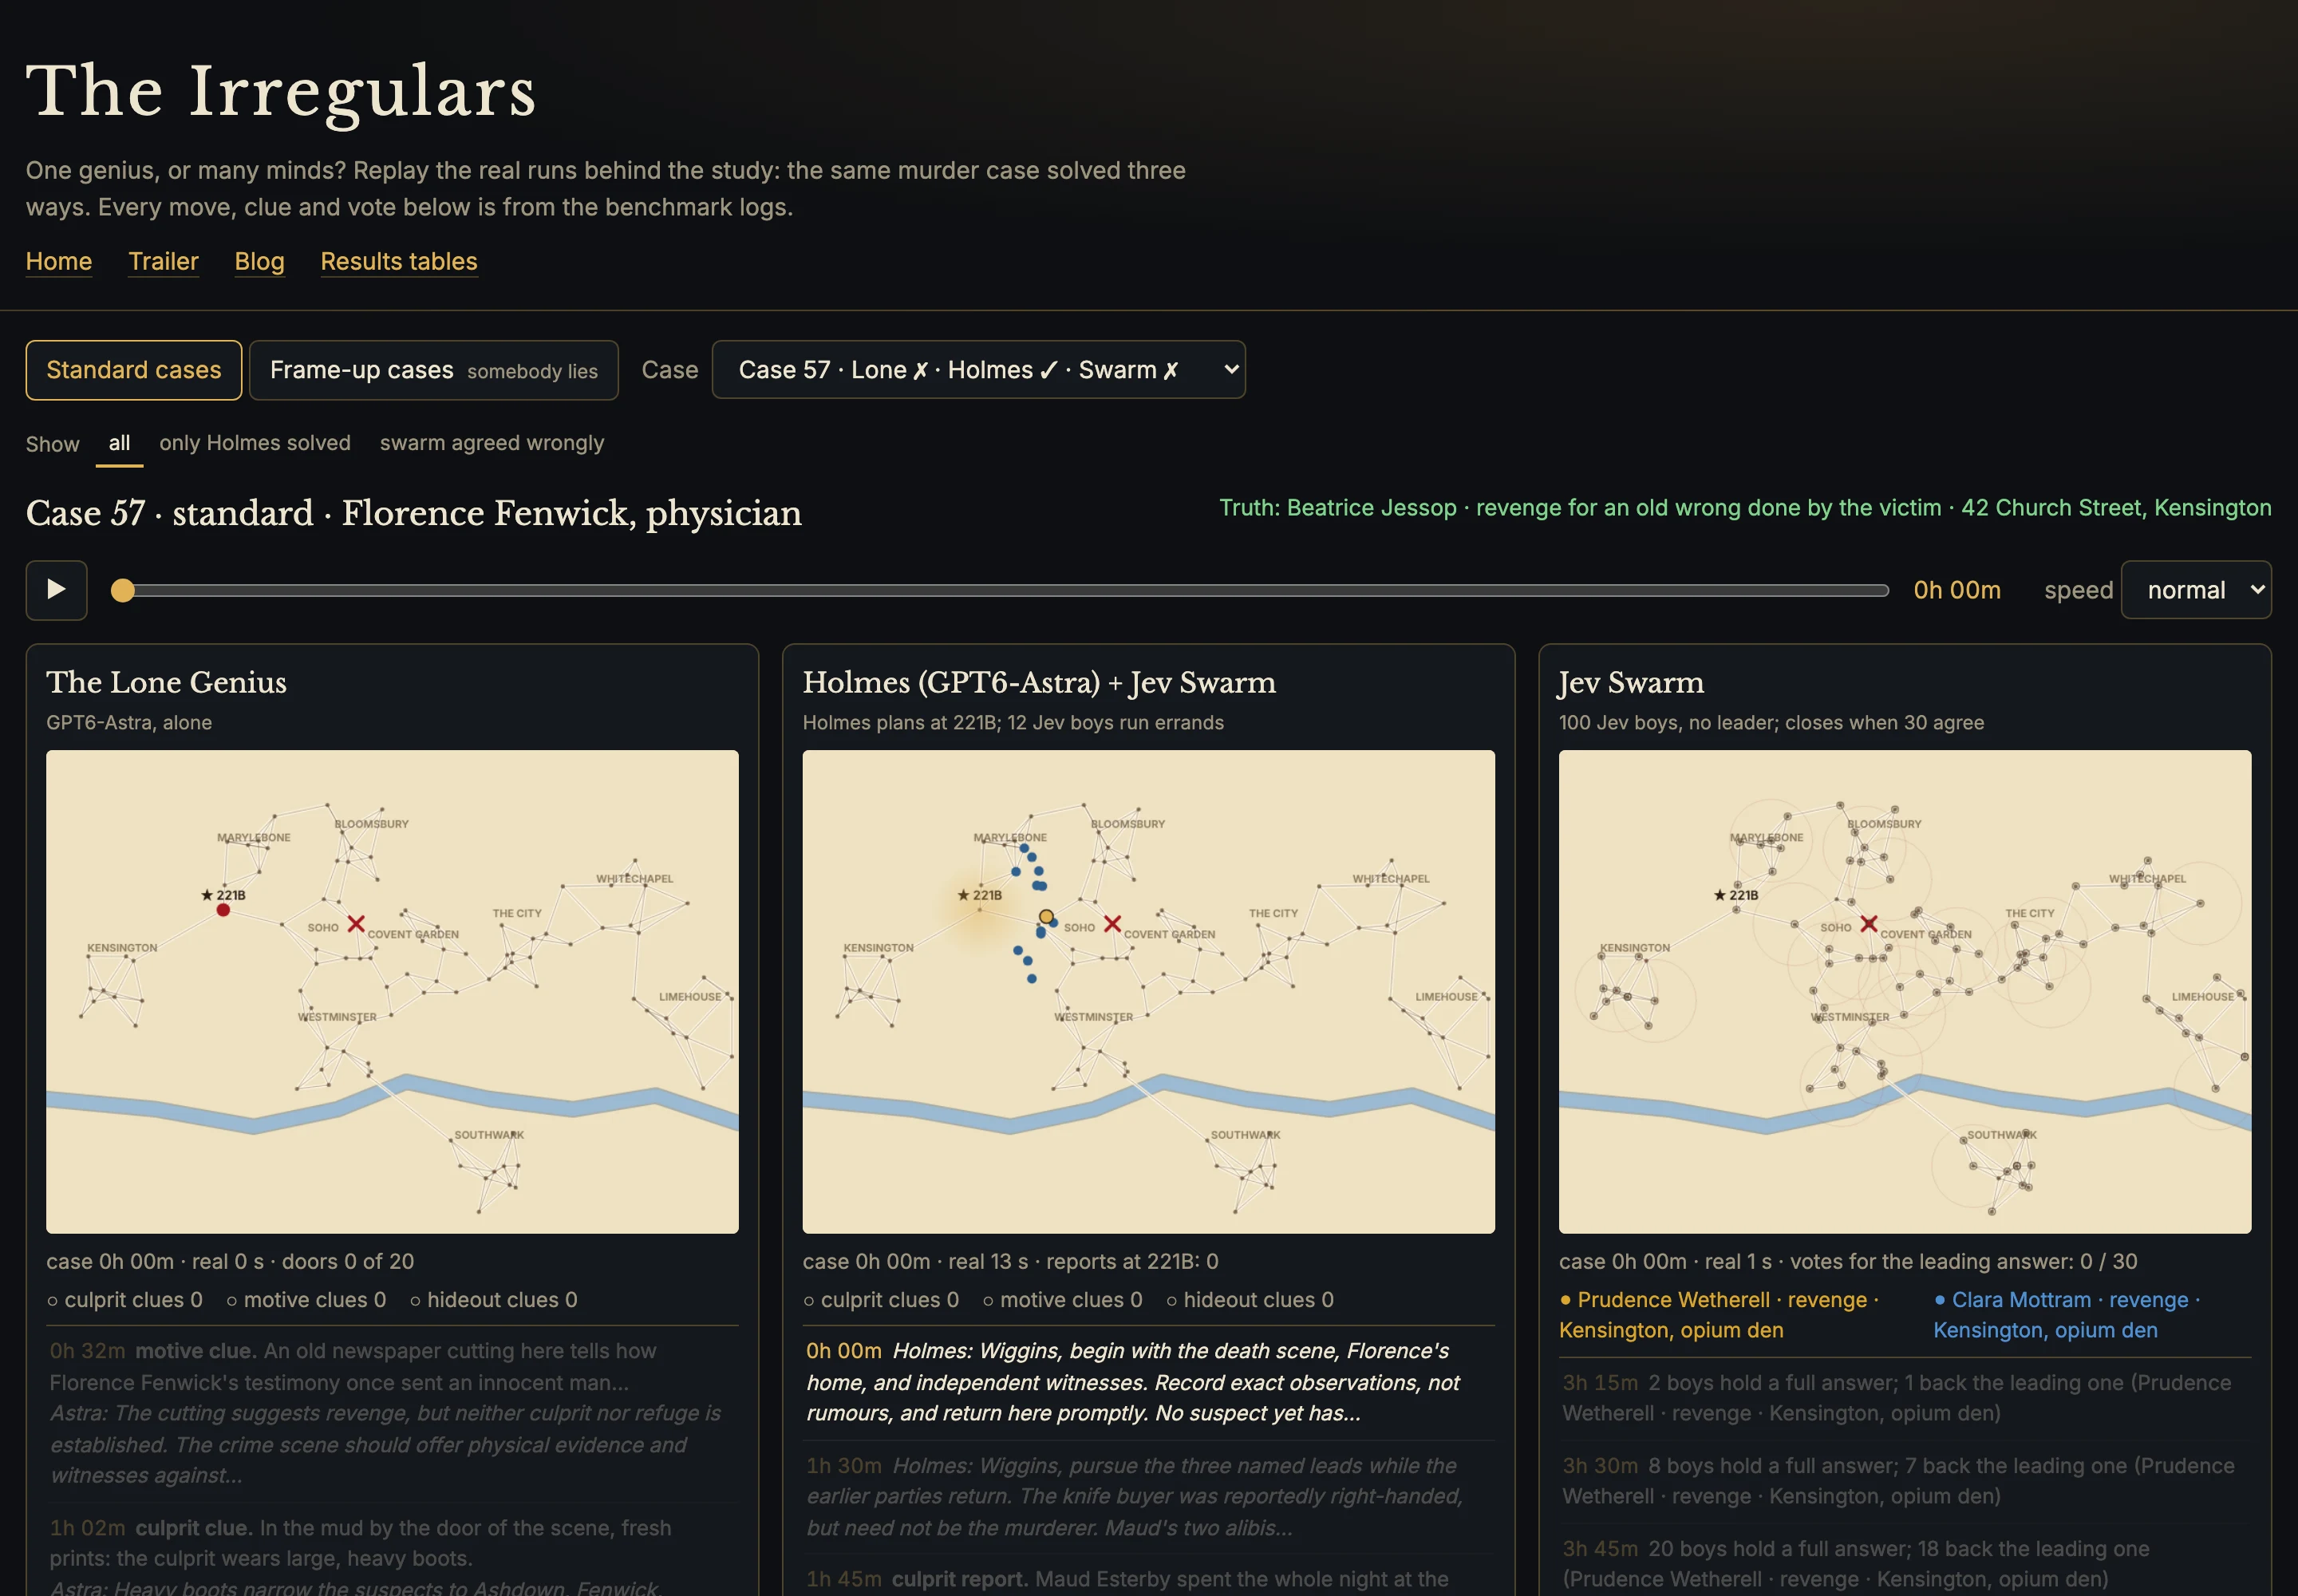
部落格用第 57 案把三種敗法攤在同一張地圖上。這是蘇活區的醫師命案:無領袖群把動機與藏身處都投對了,兇手卻指認成一位「只是穿了對的靴子」的無辜女子;孤膽天才早早把嫌犯收斂到五人,但能分辨五人的那條關鍵線索放在它始終沒走到的地址,最後只能用猜的;Holmes 組合則要求男孩「給精確的觀察,別給傳聞」,發現某個不在場證明可疑時派男孩回去再查一次,等腳印、兇器與動機指向同一個人才出手指控。
孤膽天才的失分結構也佐證了「輸在覆蓋」的讀法:一百案裡它的藏身處全對、兇手答對 83 案,動機只答對 68 案。看得懂手上的線索,卻常常沒走到持有決定性線索的那扇門。
這些數字的穩定性也經得起回看:團隊先跑過 20 案先導批次,Holmes 組合當時 19 比 20,百案重跑是 96 比 100;孤膽天才從 11 比 20 到 57 比 100;無領袖群從 11 比 20 到 38 比 100,排序完全沒變。模型決策每次給足 30 秒,兩批逐案紀錄裡退回規則代理的次數都是零,這點由紀錄檔的註記欄直接核對。
成本結構也藏在原始紀錄裡。孤膽天才每案平均約 18 次模型呼叫,Holmes 組合約 108 次,百人代理群約 1,123 次。標準案整批總花費 107.66 美元由文件直接載明,栽贓案批次加總同一份統計檔的成本欄是 134.60 美元。成本的估算基準是公開牌價:規則文件寫明 GPT-6 Astra 每步約 0.018 美元、Jev 每步約 0.00025 美元,換供應商或改用快取,金額就會不同。
標準案的有效性建立在一個前提上:線索不說謊。團隊另外設計了 100 個栽贓案(Holmesian 難度)專門拆這個前提:兇手花錢賄賂自己的僕人,讓他們對一名無辜者做出一致的偽證,假特徵每項有 2 份,真相只剩 1 份,現場另栽一個線索呼應故事。被收買的證人數量壓過誠實證人,單純計數就會把被栽贓的人指成兇手。全城只有兩名誠實證人目擊了賄賂本身。
結果是一面倒的斷層。Holmes 組合仍有 93 案;孤膽天才 59 案;無領袖 Jev 群 42 案,因為部分代理對證詞抱持懷疑,表現反而勝過所有只會計數的對手。而計數派全垮:計數規則當指揮配 Jev 跑腿,100 案全滅;全規則組合 1 案;計數群 1 案;Jev 行動配計數投票的混合群也是 1 案,單打上場的計數規則則只剩 4 案。
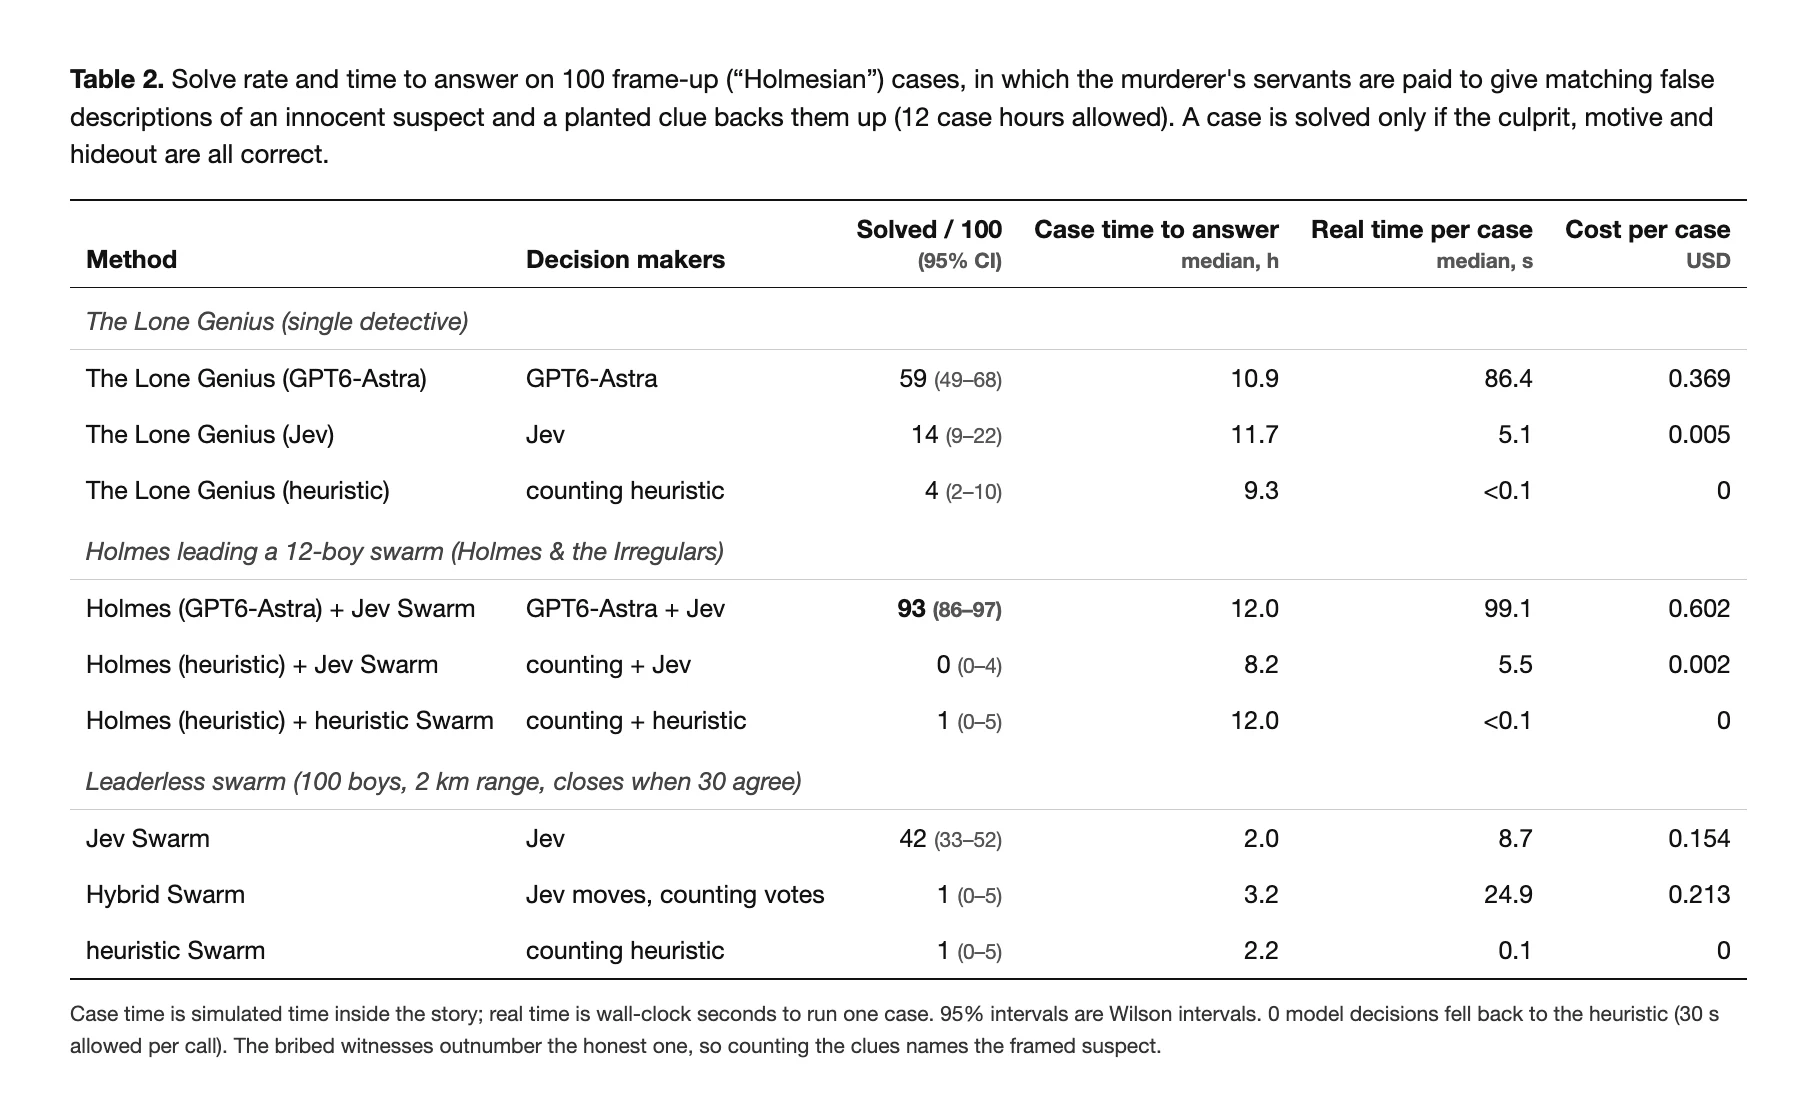
大模型在這裡做的事,團隊有一個具體例子:某個栽贓案裡 Holmes 寫下「Pargeter 的僕人同時提供他的不在場證明與不利於 Leopold 的證詞;乾燥的鼻煙盒顯示線索是栽的」。追問證據來自誰、對方有什麼理由這麼說,正是計數規則永遠做不到、也不可能在不知道騙局細節的前提下預先寫進程式的判斷。團隊的結論一句話:證據誠實時用規則,證據互相矛盾時才把強的推理者放到中心。
孤膽天才的 57 案看起來像是能力不足,團隊用一個對照實驗否掉了這個讀法:給它兩倍的時間(24 小時)與兩倍的造訪上限(40 次),解案數從 57 升到 91 案,而它在栽贓案拿到的 59 案也顯示它看得穿偽證。但它答題的案件時間中位數拉到 14.8 小時,超過 12 小時的破案期限,成本 0.60 美元與 Holmes 組合相當。團隊明寫:起作用的是額外的造訪機會,把時間加倍本身沒有幫助。
這也是整份研究最實用的一條設計規則:任務先拆開看,蒐證這種可以平行化的大量小決策交給便宜快速的代理;最後把證據組合成單一結論的那一步,才是難度所在。組合步驟簡單時,中心放一條規則就夠;組合步驟需要判斷誰在說謊時,中心值得換成大型推理模型。兩種模型的單步牌價差距也呼應這條規則:Jev 每步約 0.00025 美元,GPT-6 Astra 每步約 0.018 美元,差了七十多倍,把貴的那顆放在只做少量關鍵判斷的位置,錢才花得下去。團隊更進一步的主張是,遊戲裡遍地都是這類可拆解的推理謎題,所以遊戲正好適合拿來研究「能力換效率」的取捨,這也是整個倉庫存在的原因。
這份基準的可核對程度高於一般部落格宣稱。兩批百案結果以逐案 CSV 公開在倉庫的 docs 目錄,每列記錄一種偵探設定在一個種子上的解案、三項答案、時間、呼叫數與成本;從這兩份原始檔重算,每個設定的解案數都與表格數字一致,每案成本欄的均值也與表列的 0.582、0.339、0.149、0.602 全等。每次執行還會存下逐輪位置紀錄,專案網站的結果頁可以重播任一案裡每個代理的每一步,部落格的案例分析用的就是第 57 案。
想自己動手的人,進入門檻不高:Python 3 加一個 numpy 依賴就能啟動,規則模式完全不需要 API 金鑰。倉庫裡還有另外三款共用同一套啟動器的遊戲,包括魚群避敵、蜜蜂選巢與 CPU 除錯,CPU 除錯另有 10 月 8 日的百種子基準文件。不過重跑模型版之前,有三個缺口要自己處理。
頭一個缺口在授權。倉庫 652 個檔案裡找不到任何授權條款,全樹搜尋 LICENSE 與 COPYING 都是零命中。程式碼公開不等於可以自由沿用,商業或改作前需要先向團隊確認授權。
模型銜接也有斷點。README 指定的模型 ID typesafe/jev-1.13 在 OpenRouter 的模型目錄已經查不到,目錄裡只剩 9 月 25 日上架的 jev-router,照文件原名設定會直接失敗,想重現實驗得先改用現行模型並理解結果可能漂移。
研究性質的邊界同樣要標清楚:這是一份未經同儕審查的案例研究,只測了 GPT-6 Astra 配 Jev 一組模型,沒有跨模型的對照,成本同樣是牌價估算出來的推計值,不是實際帳單。
讀完這份基準帶得走的判斷很單純:先看任務的證據會不會說謊,再決定錢花在哪一層。蒐證覆蓋永遠可以外包給便宜的平行代理;判斷整合的難度,才決定中心那個位置要不要放一台會追問動機的大型推理模型。同一個讀法也適合拿來檢視其他代理框架的評測,例如先前用結構檢查與盲測偏好兩份榜單互相比對的 3JSBench,分開測量能力與偏好,永遠比單一總分誠實。