TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

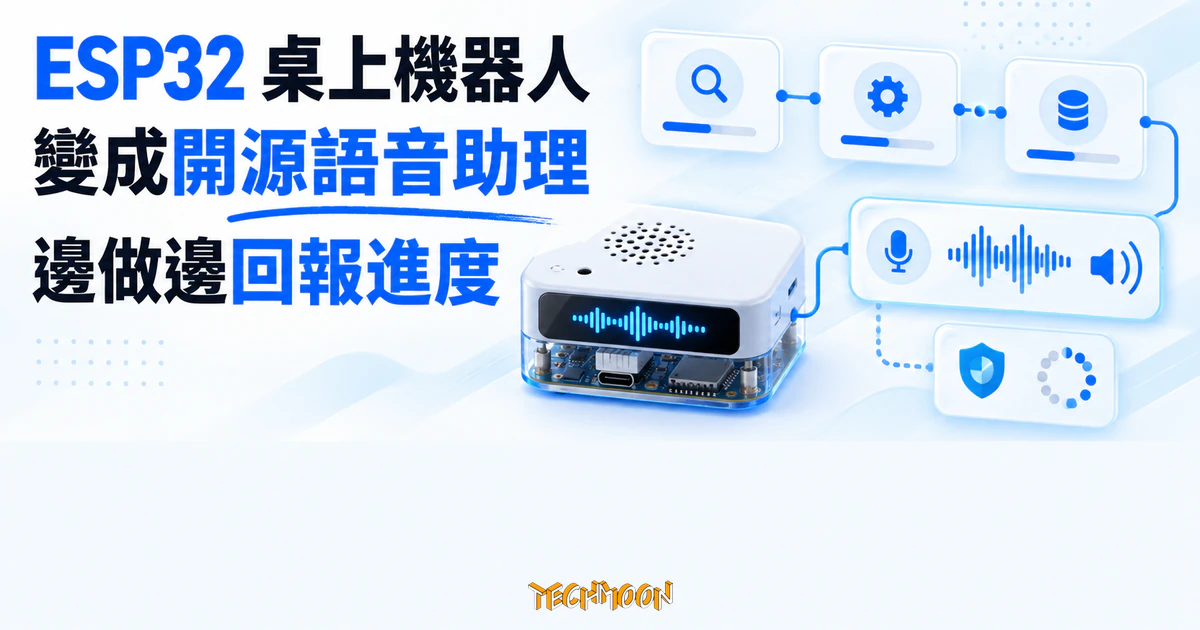
開發者 Vineeth Kalluru 把 ESP32-S3 桌上機器人接上開源代理 Hermes,做出會邊工作邊播報進度、執行高風險指令前先開口徵求同意的 JARVIS Desk Bot,以 MIT 授權公開。語音辨識與合成留在本機伺服器,代理模型與外部工具仍要網路,而且目前只支援英文語音。
用 AI 摘要這篇文章:
語音助理最讓人不安的時刻,是說完需求後迎來一大段安靜:它到底在做事,還是根本沒聽見?10 月 9 日,開發者 Vineeth Kalluru 在 X 上宣布把自己桌上的 ESP32 機器人 JARVIS Desk Bot 開源(MIT 授權)。這台貓耳圓臉的小機器人接上開源代理框架 Hermes 之後,代理查任務、搜網路、跑長工作的過程會變成聲音:悶住超過三秒會先應一聲,工具執行時播報正在做什麼,高風險指令會先開口徵求同意,丟到背景的工作做完會主動回報一句結果。
專案倉庫在 GitHub 帳號 dreamhunter02 名下(與 X 帳號 vineethkalluru 同一人,倉庫內的 commit 署名可以對上),建於 10 月 5 日,到 10 月 11 日累積 30 筆 commit、7 個星標,末筆修改停在宣布當天。作者在宣布文裡把動機寫得很直白:想要一台完全在地的語音代理放在桌上,但遇到兩個問題,Hermes 代理本來就不是為語音閘道設計的,而 ESP-Vocat 這款機器人開箱也不支援本機 AI 部署,於是他自己把中間的管線接了起來。
理解這個專案,先把三層各自的位置分清楚。
硬體端是一台 ESP32-S3 桌上機器人,跑 Espressif 的 ESP-Brookesia 人機介面框架裡的 chatbot 範例韌體。機器人只負責兩件事:在裝置上偵測喚醒詞 Jarvis,然後把你的話串流出去。喚醒與收掉對話各配一個提示音,聽到喚醒詞是上揚的一記,說 bye bye 之後是下墜的一聲,道別會等聲音播完才真正休眠。中間層是 xiaozhi-esp32-server,這套開源語音伺服器架在作者自己的機器上,用 Parakeet 做語音辨識、用 Kokoro 做語音合成,這兩段就是作者說的本機語音。最裡層才是 Hermes:Nous Research 的開源代理框架,同樣走 MIT 授權,自帶工具呼叫、技能系統與子代理委派,平常透過單一閘道同時掛著終端機與多個通訊軟體介面。
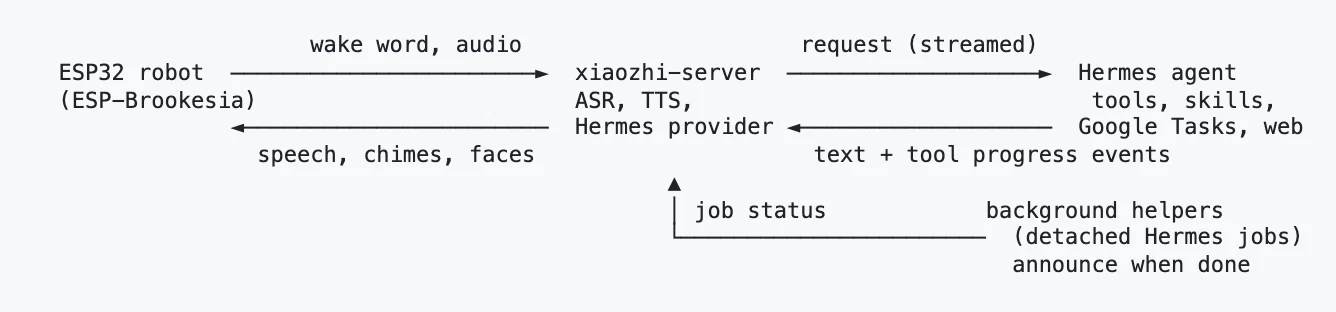
所以「本機」兩個字在這裡有明確的邊界。語音辨識與語音合成確實留在自家伺服器,但代理的大腦不在其中:倉庫隨附的設定範本把預設模型設成 DeepSeek V4.1 Flash,走 DeepInfra 的 API;Google Tasks 技能需要 OAuth 授權才能用。README 的需求表也寫明,模型端可以是任何支援工具呼叫的 OpenAI 相容供應商,換成自架推理端點技術上可行,只是作者自己量測用的組態在雲端。對照宣布文裡「完全在地」的想望,實際交付的是在地語音管線加大腦外接,這條界線值得先畫清楚。
台灣讀者對這條鏈路不陌生。TechMoon 先前介紹過 xiaozhi-esp32 韌體與自架伺服器的路線選擇,也實測過 Kokoro 文字轉語音與 Parakeet 語音轉文字;用 ESP32 板子搭配開源助理的先例,則可以回看 MimiClaw 把 OpenClaw 接上五美元硬體的做法。JARVIS Desk Bot 的位置是把同一塊硬體接到工具呼叫能力更完整的代理上,並補上中間缺的狀態回報層。
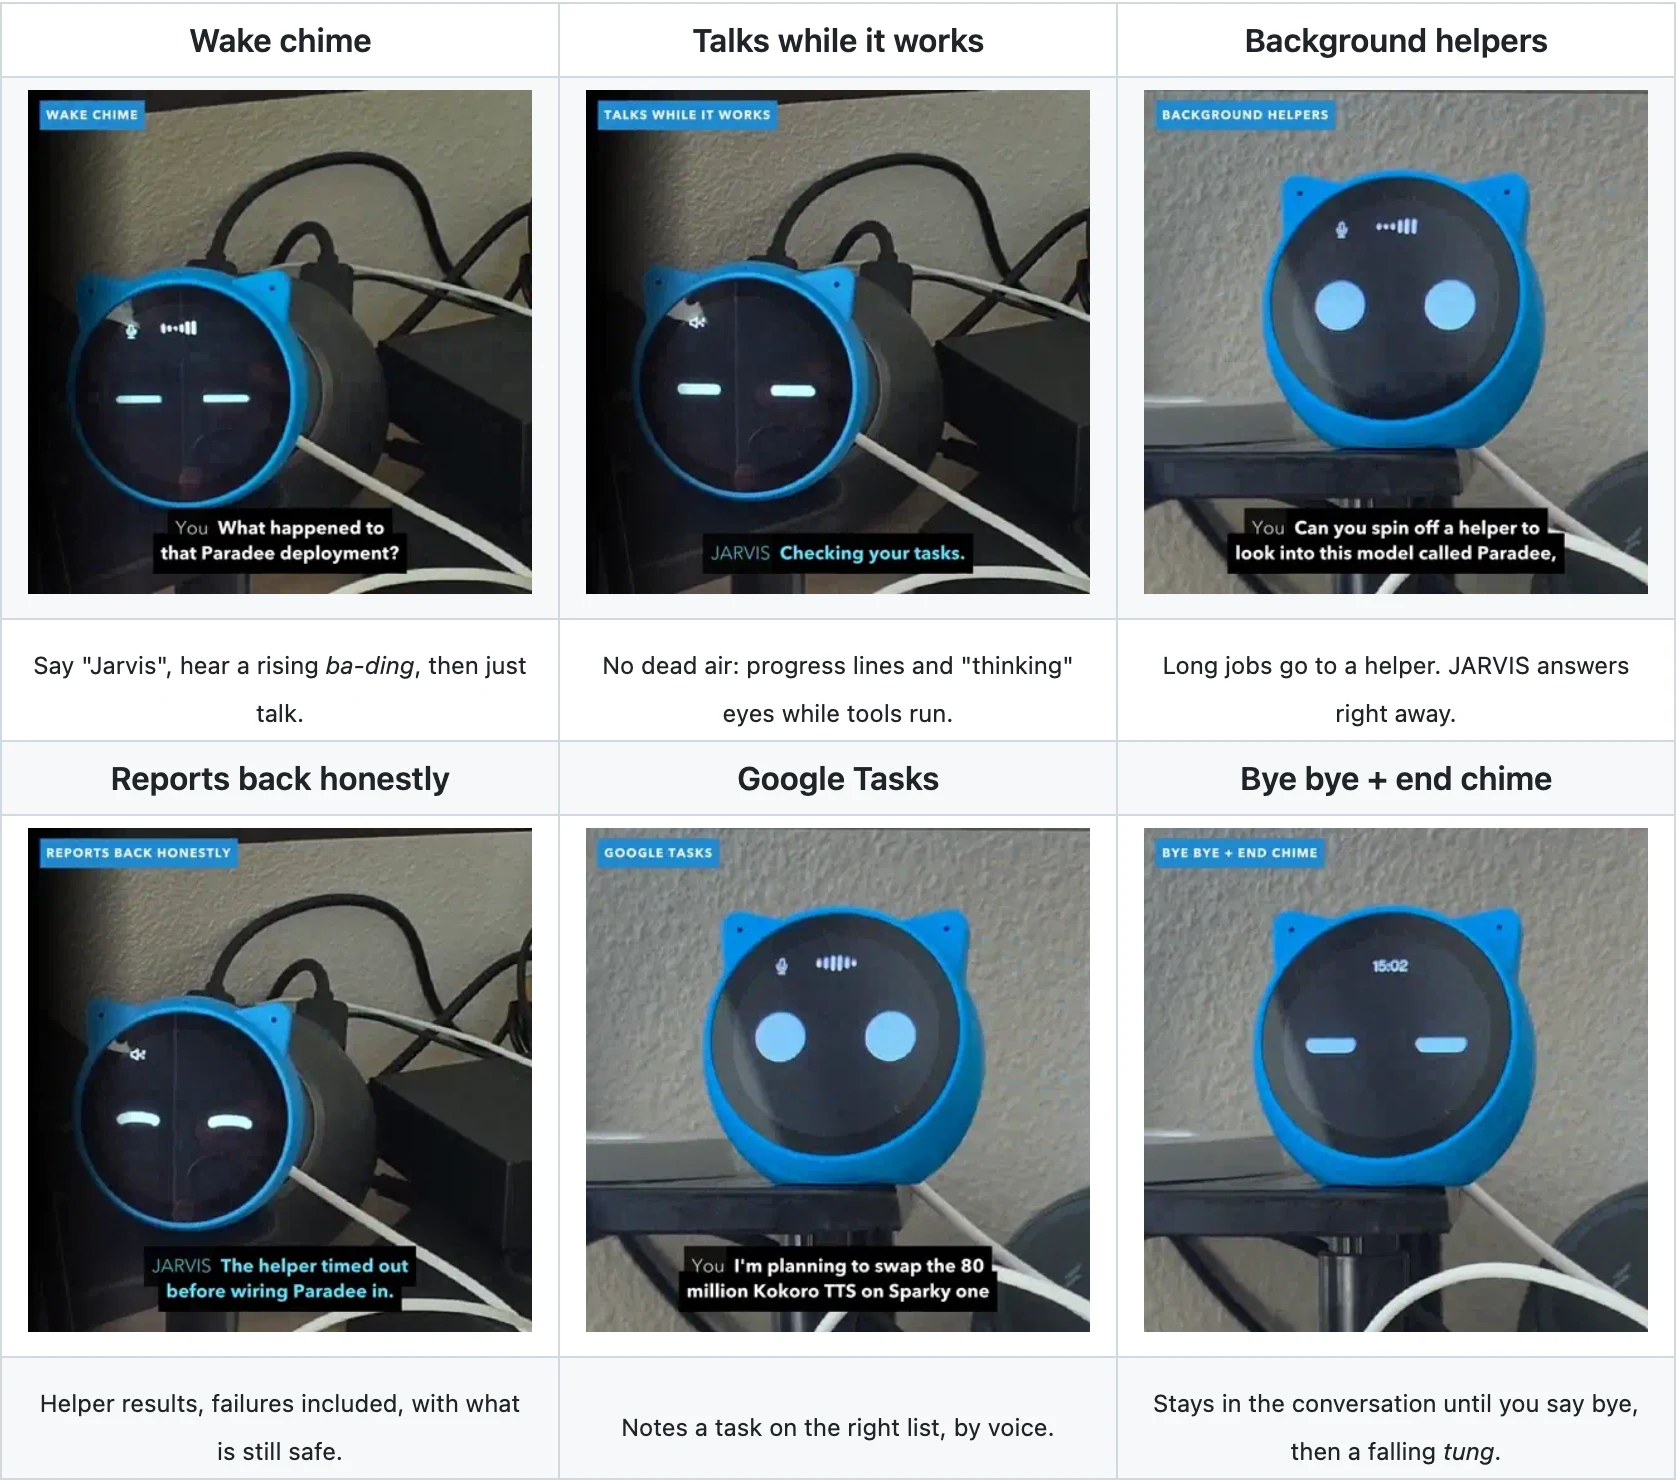
專案的核心差異化,是把代理的工作狀態變成聽得到的介面。
原本的問題出在伺服器端的沉默。xiaozhi 內建的供應器只會等最終答案,代理跑工具的 20 到 60 秒裡機器人一個字都不說。作者的解法是為 Hermes 寫了一個專用供應器,讀取 Hermes 串流裡本來就有的工具進度事件,轉成短句播報:三秒內沒有動靜先說一聲我去查,每一類工作配一句話,超過二十秒沒有語音就補一句還在處理。這些進度句不會被當成過去的答案塞回對話史,表情也維持在思考狀態,不會因為一句填充話就切換成說話臉。
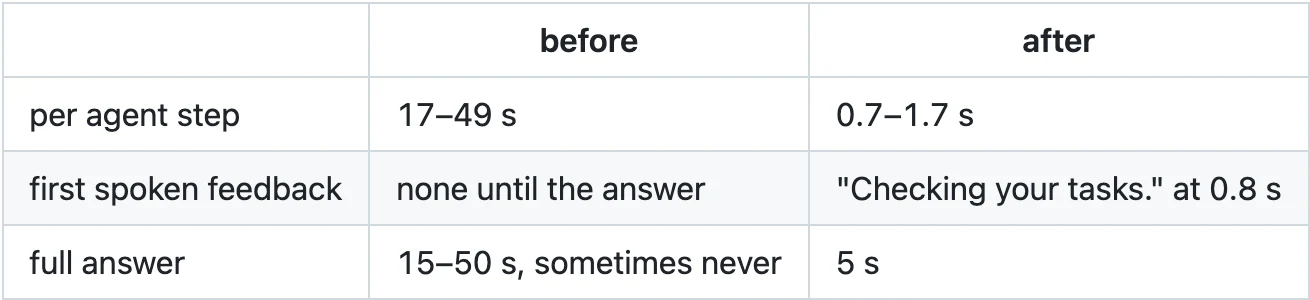
效果數字來自倉庫附的設計筆記,屬於作者自報的量測。以「我現在有哪些未完成的任務」這句話量測:每個代理步驟的耗時從 17 到 49 秒降到 0.7 到 1.7 秒,口語回饋從本來的完全沒有,變成 0.8 秒就聽到一句我去查看你的任務,完整答案從 15 到 50 秒(偶爾根本不來)縮到 5 秒。其中降幅最大的一段其實跟語音無關,是換模型:GLM 5.3 Flash 在 DeepInfra 上每步要 17 到 49 秒,一句 21 個 token 的問候要 17.9 秒還碰過 429,換成 DeepSeek V4.1 Flash 之後才落進秒級。
設計筆記裡還留著一條失敗紀錄,對選型很有參考價值。作者最早試過語音到語音模型(NVIDIA 的 Nemotron VoiceChat)當前端,把整個代理藏在單一工具後面:錄音乾淨時它會叫工具,換成機器人的遠場麥克風就多半不叫,只會回「我可以做,要我做嗎」,然後在每個 yes 之後再問一次,而執行環境沒有任何強制工具呼叫的手段。結論是回到語音辨識、會叫工具的語言模型、語音合成三段管線,對答案本來就要花幾秒到幾分鐘的代理來說更可靠。筆記裡連結的前身專案 hermes-voicechat,至 10 月 11 日已經連不上,這段演進只剩文字紀錄。
兩個功能把「風險」與「時間」也搬進了聲音通道。
風險這端,Hermes 的安全檢查扣住高風險指令時,會在串流裡發出等待同意的事件。專用供應器把這個事件轉成口語詢問,例如代理想執行把指令輸出直接接給直譯器這類高風險操作時,機器人會開口問一聲需要你的同意、要不要繼續,你的語音回答會被映射成三種等級(這次同意、本次對話都同意、拒絕)送回 Hermes 的同意端點,同一輪工作接著跑,聽不清楚就再問一次。設計筆記記載,沒有這層轉接之前,一次請求凍了六分鐘後靜靜收場,因為 Hermes 的同意等待上限是 300 秒,逾時即視為拒絕。
時間這端是背景幫手。說一聲「分出一個幫手去做某事」,主對話立刻得到回應,工作本身變成一次分離的 Hermes 執行:快工作交給幫手,上限十分鐘、六十步;部署或跑分這類會跑數小時的目標交給目標代理,也就是 Hermes 看板上一張以目標模式運作的卡片,在自己的工作階段裡跑,上限三十輪、四小時,卡住會回來問人。兩種工作每一步都留紀錄,做完透過指定的播報指令回報一句結果,失敗也照實說,連同當時還安全的部分結果一起交代。你隨時可以問現在有哪些在工作,也可以喊停。與日常最相關的整合是 Google Tasks 技能:用說的讀取、新增、更新、打勾任務,靠關鍵字自動分到個人清單或工作清單。
這套分工是被失敗逼出來的。早期的幫手十五個掛掉九個,每個都撞上四十輪的上限,過程中命令安全掃描還先擋掉了寫入自家目錄的 shell 重定向、複雜單行指令與 nohup,結尾只留下一個 session id。修法是把快慢工作拆成兩類、回報真實的中止原因,而不是把失敗吞掉。
鏈路上還有兩個不起眼但直接決定體驗的斷點,都在韌體與伺服器的縫隙裡。
一個縫隙是機器人自作主張睡覺。ESP-Brookesia 韌體有自己的計時器:喚醒後三十秒沒聽到說話就睡,一段話結束後十秒也睡,只在機器人自己發聲時暫停。代理工作做到一半,機器人就自己送出 goodbye 收掉對話。隨附的韌體補丁把兩個計時器都改成二十四小時,搭配伺服器端的靜默逾時設為零,對話只認結束語句。這個選擇有代價,而且作者在文件裡明說:機器人會一直聽,附近的會議或影片的聲音都會進到代理,開會前記得先說 bye bye。
另一個縫隙是英文根本分不了句。xiaozhi 原本的語音合成分句器只在問號、驚嘆號、分號、冒號與 CJK 標點斷句,英文整段會被押到回覆結束才開口。修改後句號加空白也能斷句,小數點如 3.5 不受影響,英文答案的開頭從此能搶先出聲。
中文使用者的現實限制要放在最前面:這套語音介面目前只支援英文。供應器會直接丟棄回覆裡的 CJK 文字,剩下的內容不夠就說一句「抱歉,我沒聽清楚」;隨附的人格規則範本 SOUL.md 有一條英文規則,而且必須單獨一行才有效,放在長行結尾會被模型忽略;語音合成用的是英文版的 Kokoro。想把中文語音接上同一套架構,這三處都是要自己動手的地方。
模型的選擇倒是完全開放,設計筆記另外提醒兩個行為陷阱:推理等級設太低,模型會先給一句承諾而不叫工具;工具使用強制設成自動時,某些模型家族不在涵蓋範圍內,要明確打開。
不過跟進前有個文件層面的小落差要知道:README 的需求表列 Nemotron 3.5 Super VL 當主模型、DeepSeek V4.1 Flash 當備援;倉庫隨附的設定範本卻是 DeepSeek 當預設、GLM-5.3-Flash 當備援、Nemotron 標註為測試過的替代方案。倒數第二筆 commit 的訊息提到主模型切換後的兩個修正,顯示兩份文件停在換模型前後的不同時點。實際採用時以設定範本為起點再自行調整,會比照著需求表抄穩妥。
整包修改以 MIT 授權公開,內容是三個既有開源專案的一組插入式修改:ESP-Brookesia 的韌體補丁、xiaozhi-esp32-server 的 Hermes 供應器與分句修改、Hermes 端的人格範本與三個技能(任務管理、任務提醒、背景工作)。人格與記憶都以範本形式提供,語音人格規則寫在 SOUL.md,關於使用者的事實寫在記憶檔,安裝文件還要求先用一條搜尋指令把所有標了「填入個人資訊」的位置找出來填完,再談啟動。安裝腳本是冪等的,每個改過的檔案都會留一份 .before-jarvis-desk-bot 備份。README 的示範片表格標明這些是機器人放在桌上的實錄,跳過的等待段都有標記,算是對觀看者的誠實交代。
上游的五個專案各自都活著:Hermes agent 到 10 月 11 日仍在更新;xiaozhi-esp32-server 約一萬一千個星標;ESP-Brookesia 與 ESP-SR 是 Espressif 的官方框架;Kokoro 是 Apache 授權的開源語音合成模型。JARVIS Desk Bot 本身是個新生專案,commit 全落在 10 月 5 日到 9 日,開著的 issue 一個都沒有(10 月 11 日快照),宣布影片是 28 秒的六頁動畫解說,末頁嵌了一張實拍照。星標這類動態數字會漂,回查以倉庫現況為準。
想動手的讀者,要先備齊四件事:ESP32-S3 機器人與可燒錄的環境(ESP-IDF 5.5)、一台 Linux 主機加 systemd 使用者工作階段、一個 Google 帳號做 Tasks 授權、以及一組模型的 API 金鑰。收穫也未必是那台機器人本身:設計筆記把每個修法都掛在一個量過的問題上,從模型延遲、安全掃描到遠場麥克風的失敗案例,對任何想把代理接上語音介面的人,都是一張現成的施工地圖。接下來可以觀察兩個訊號:中文語音與 CJK 處理會不會有人補上,以及 Hermes 端會不會把語音閘道收進官方功能。