TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

上海人工智慧實驗室開放 744B Agent 模型 Atria Dawn Preview,MIT 授權涵蓋權重,16 項官方評測拿 5 項最高分且集中在搜尋、工具與資安;API 相容 Claude Code 與 Codex,但只吃文字、自架 FP8 版要 756GB。
用 AI 摘要這篇文章:
9 月 15 日晚間(台北時間約 18:42),上海人工智慧實驗室把 744B 參數的 Agent 模型 Atria Dawn Preview 整套放上 Hugging Face:權重走 MIT 授權,模型卡、API 文件,加上一篇上百位作者、9 月 14 日提交 arXiv 的論文同步公開。名字裡的 Preview 說明了定位,這是下一代「Agent 基礎模型」的預覽版,訓練目標寫得很直白:把開放式問題推向「可執行、可驗證、可重現」的成果,而不是把回答寫得更漂亮。
官方評測的分數分布給了一個很好讀的訊號:16 項基準裡它拿下 5 項最高分,全部集中在深度搜尋、工具呼叫、自動化與資安;但在寫程式與文書交付那幾項,仍明顯輸給 Claude Opus 5 與 Qwen 3.8 Max。想嘗試的人有兩條現成的路:官方 API 直接相容 Claude Code 與 Codex 的介接格式,自架則要先備妥 756GB 起跳的儲存空間。另外有一個限制會直接影響使用方式:這個模型只吃文字。
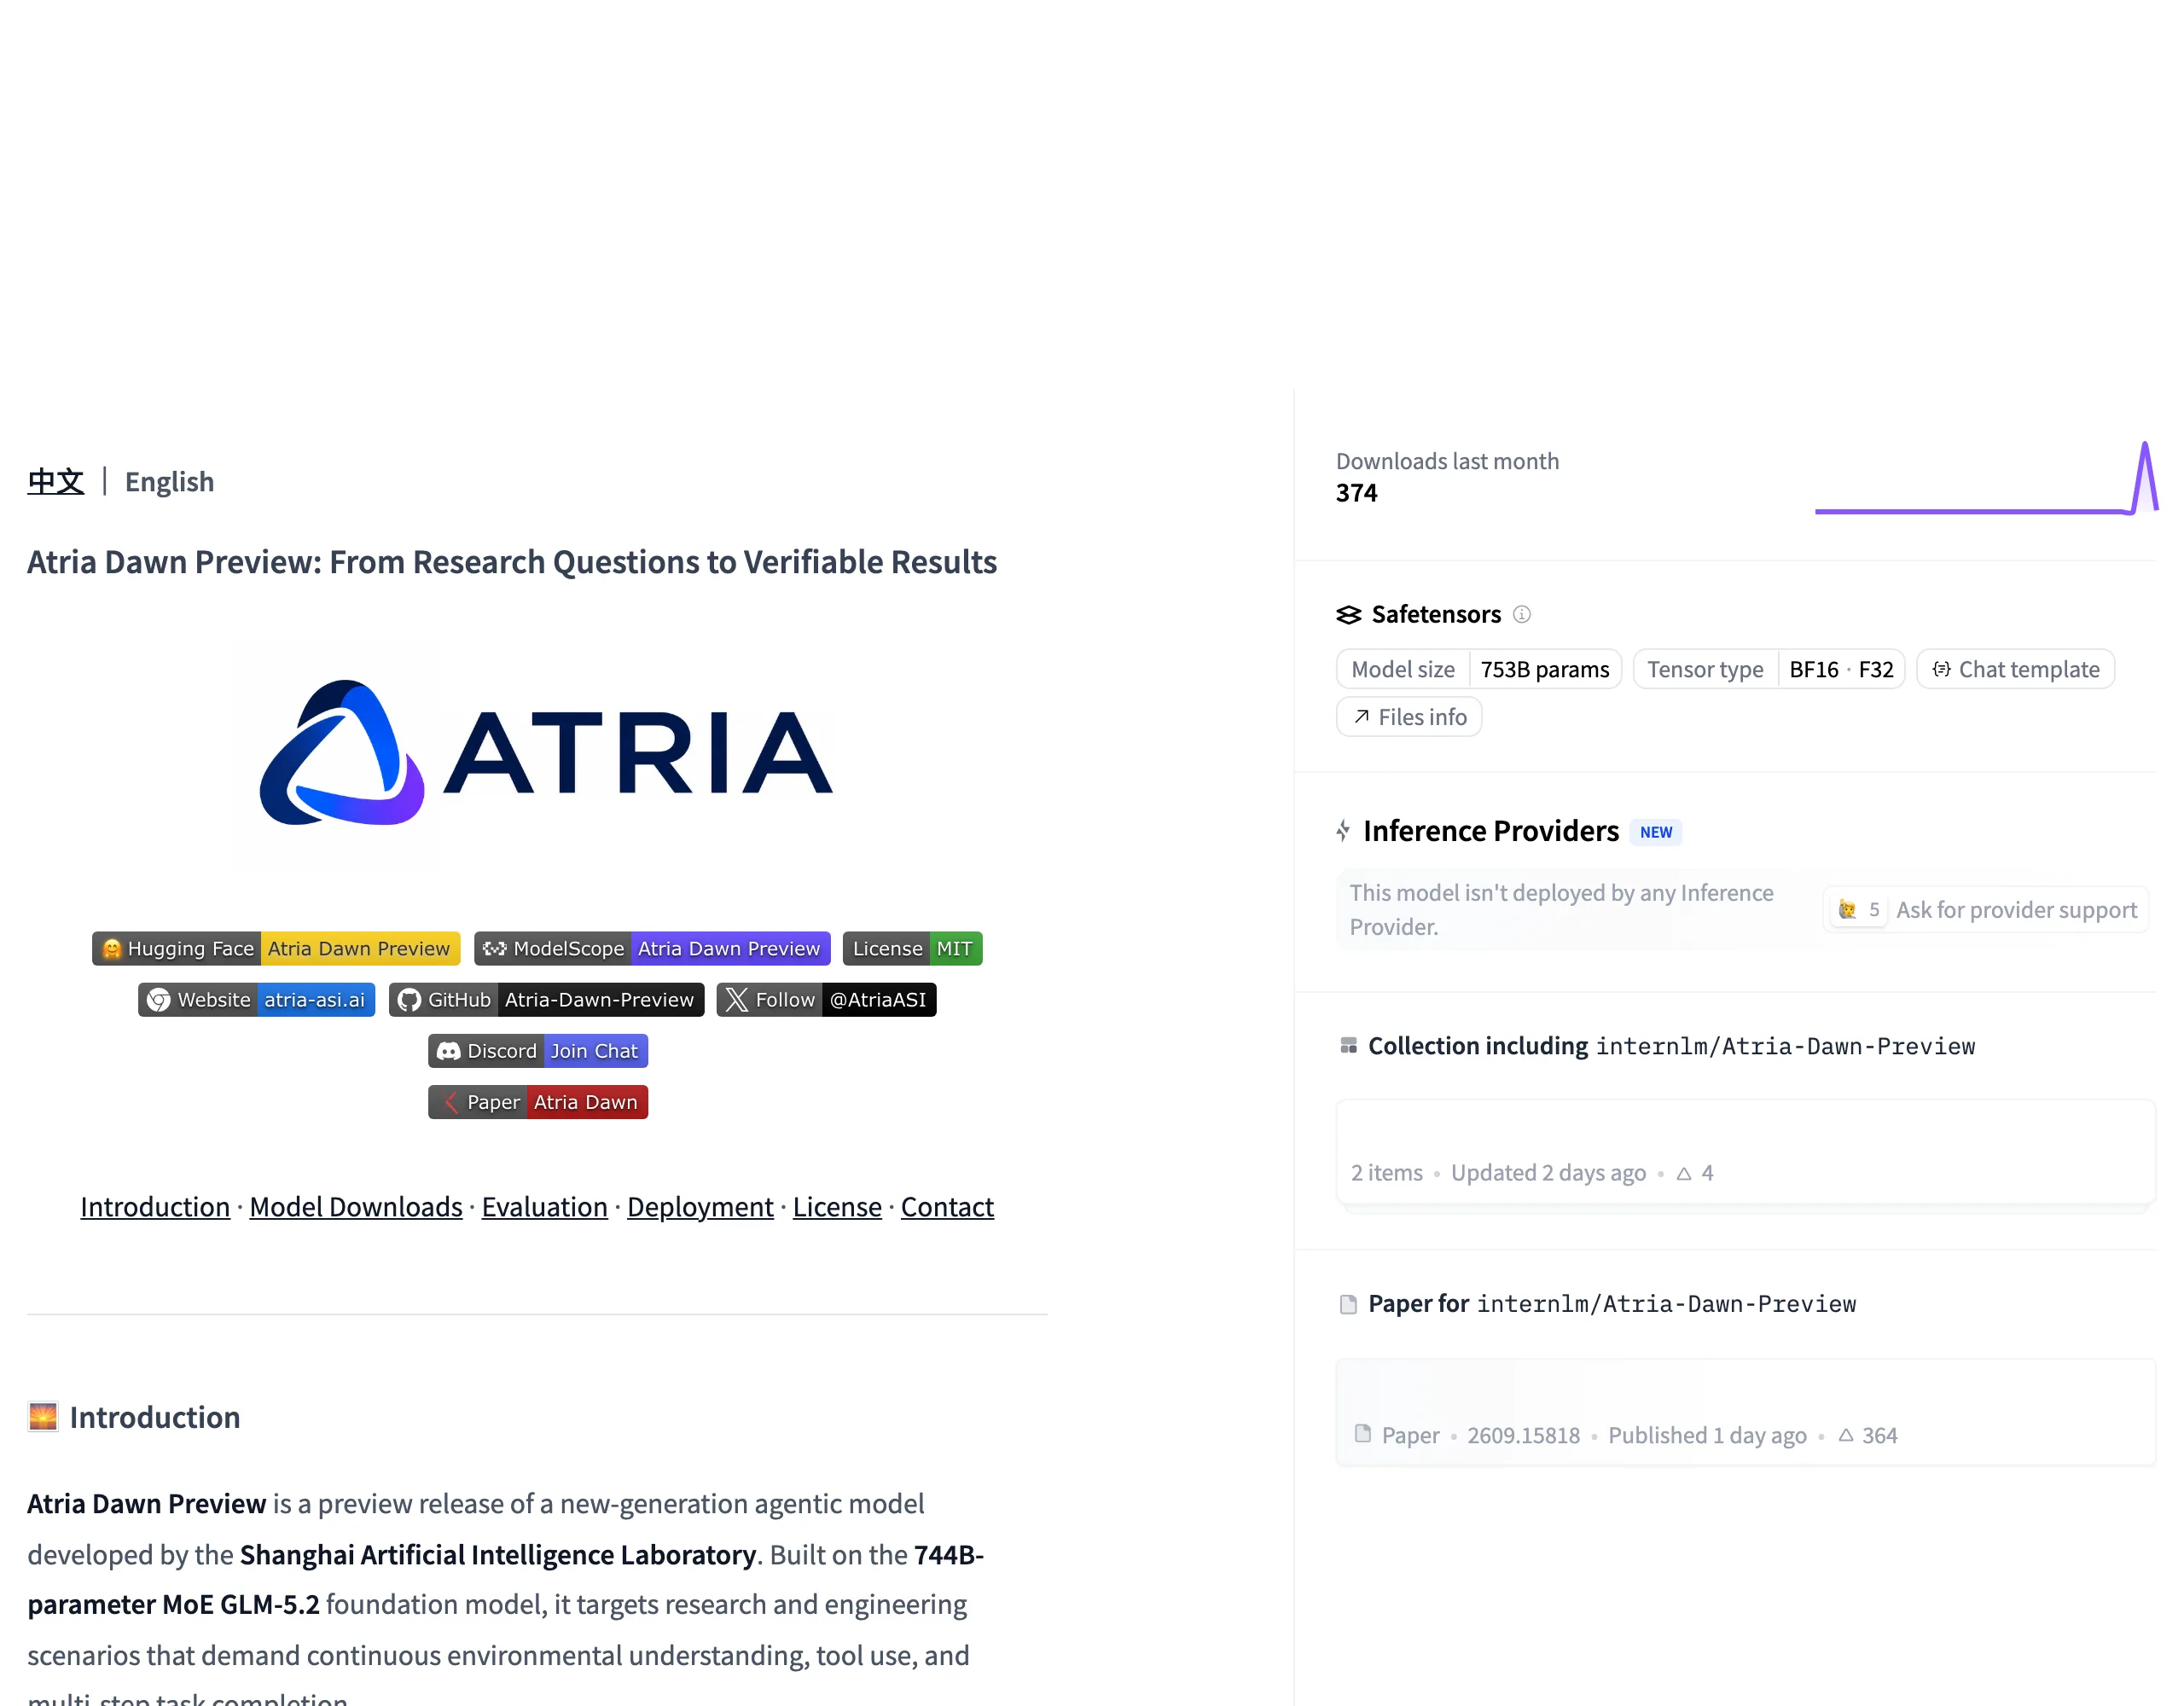
把時間軸排開:GitHub 上的 atria-asi/Atria-Dawn-Preview 倉庫建於 9 月 12 日,論文 9 月 14 日提交,權重 9 月 15 日推上 Hugging Face 與 ModelScope,前後三天。所謂全套開放,具體來說是兩份權重:原始的 BF16 版切成 353 個檔案、實際加總約 1506.7GB,FP8 量化版 177 個檔案、約 755.6GB。發布的帳號也值得記下:Hugging Face 掛在實驗室的 internlm 組織下,ModelScope 鏡像放在 Shanghai_AI_Laboratory 帳號,中國境內的 API 端點同樣設在實驗室體系的 discovery.intern-ai.org.cn,同一套東西三個出口。
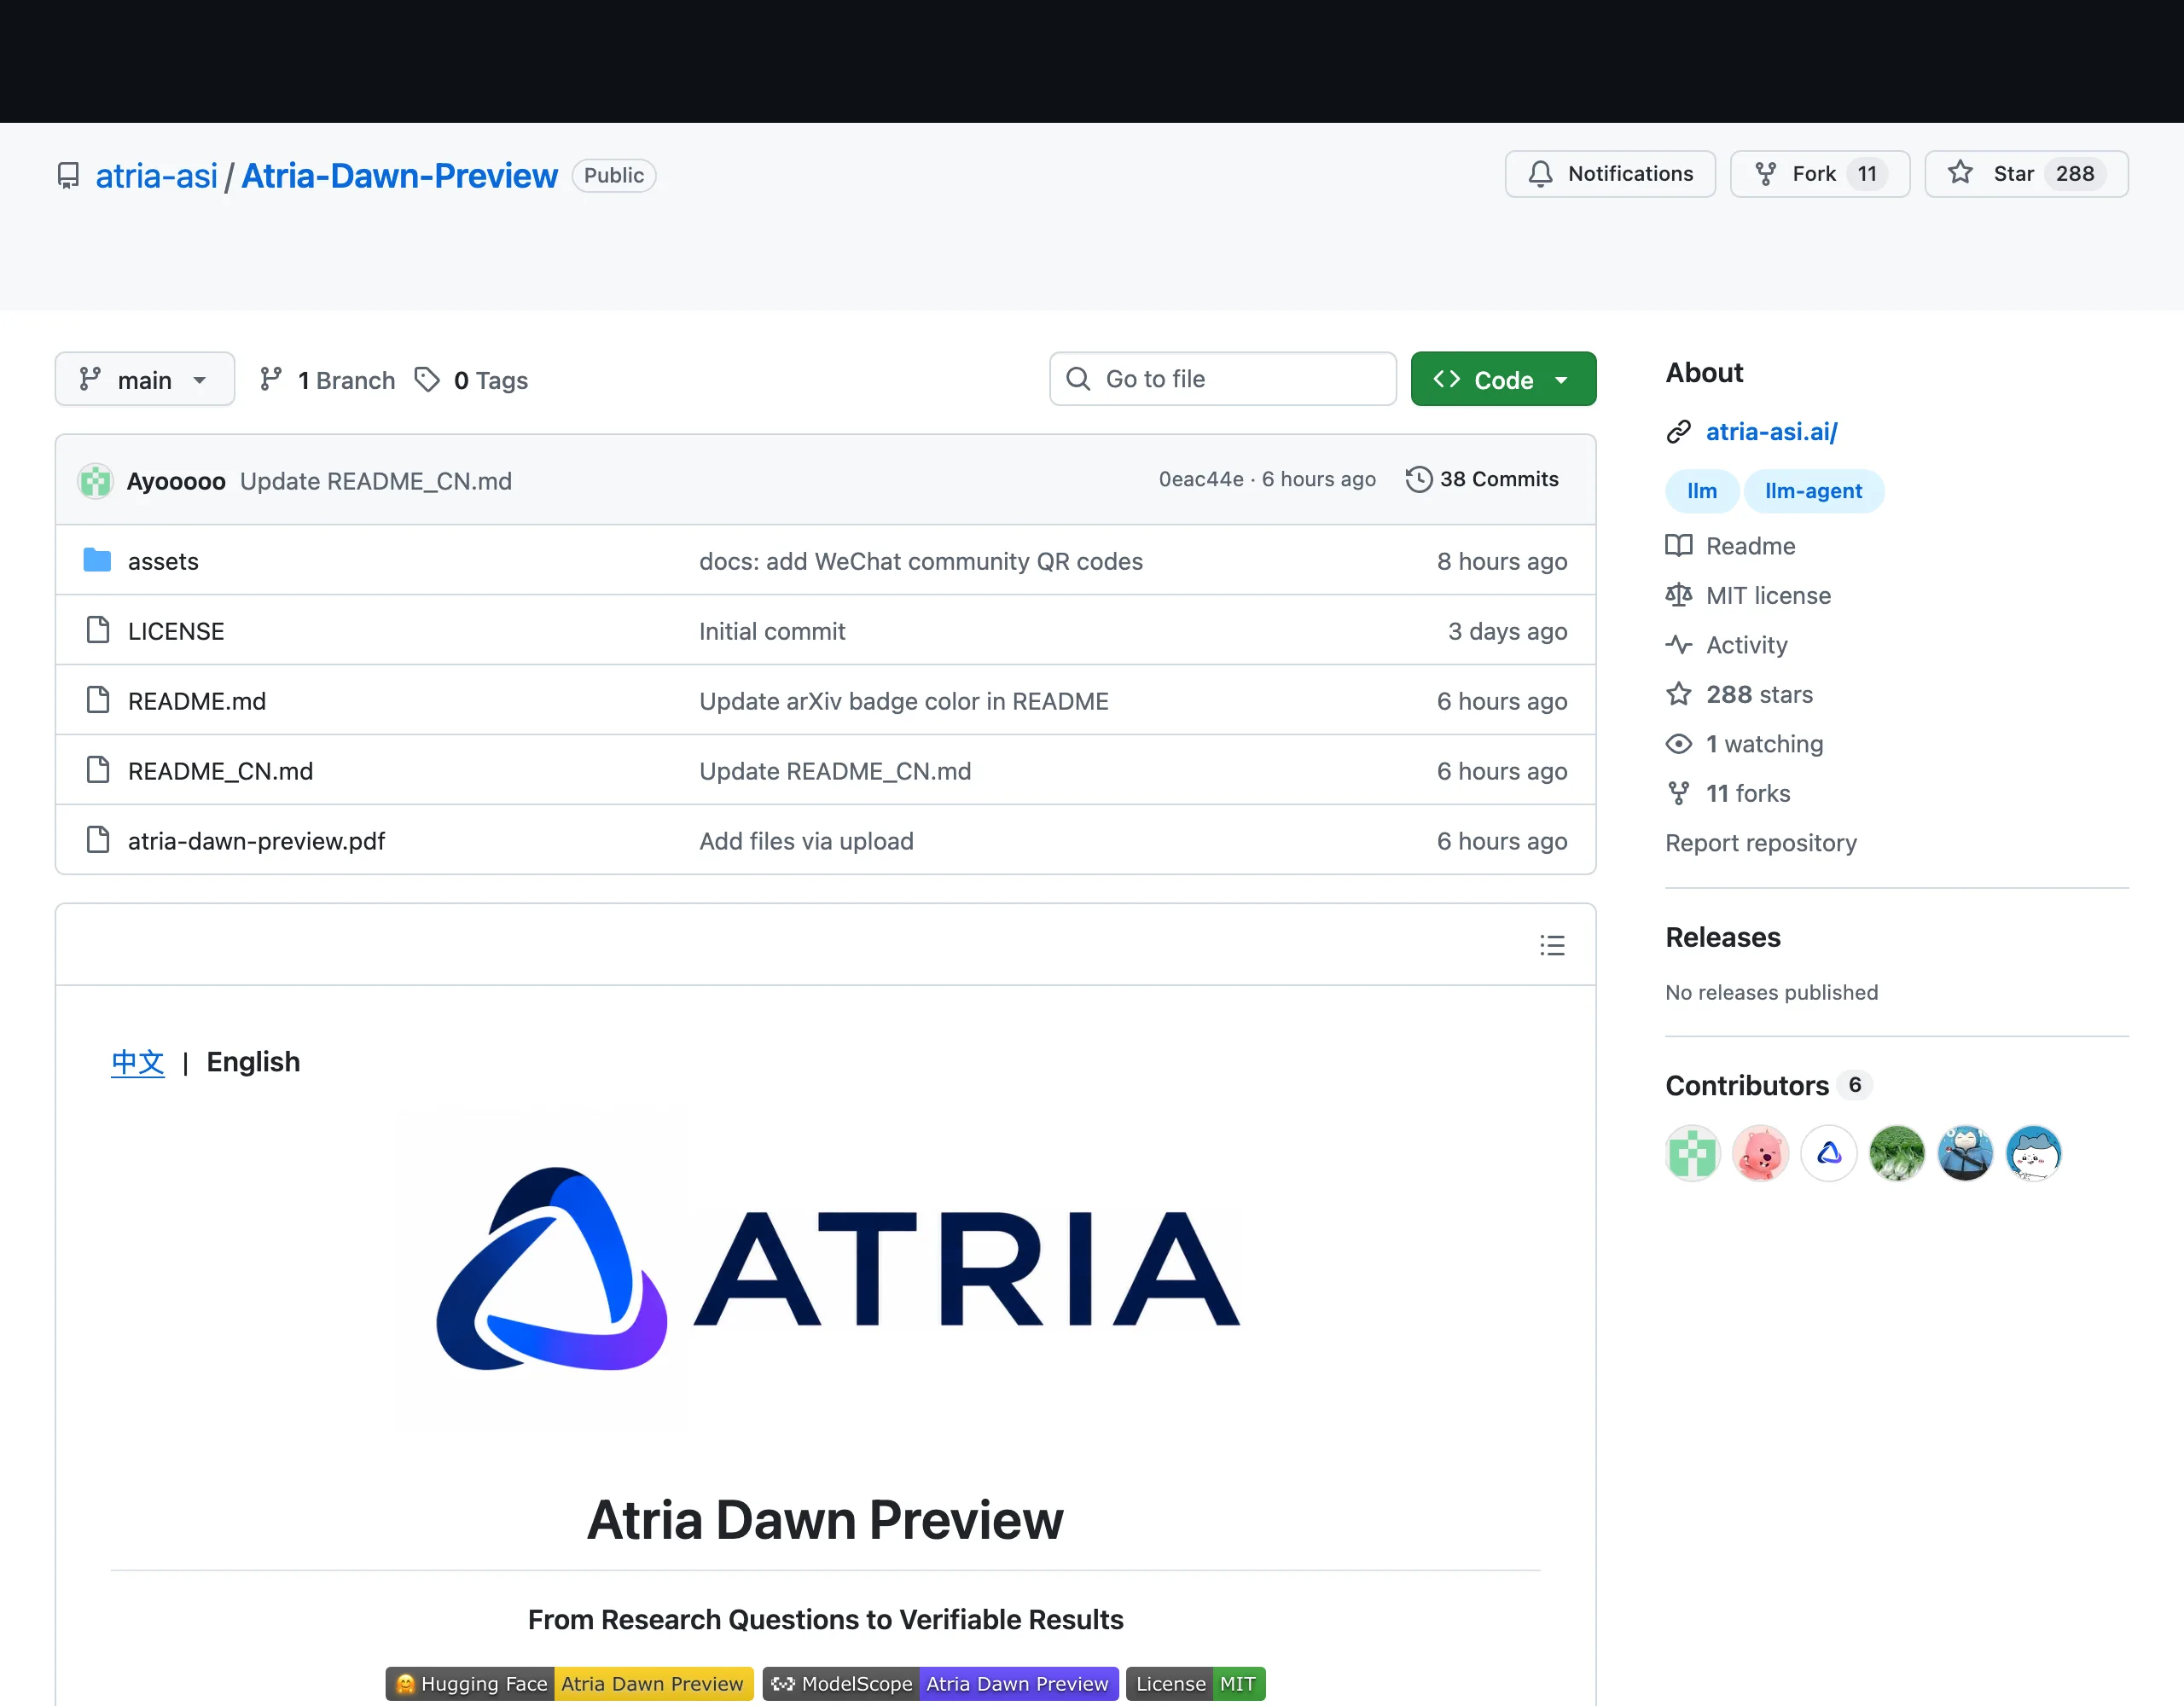
授權方面,模型卡明文寫著程式碼與模型權重都以 MIT 釋出,沒有商用附加條款,這點比多數「開放權重但授權自訂」的大模型乾淨。但 GitHub 倉庫本身值得看清楚:整個 repo 只有 9 個檔案,中英兩版 README、LICENSE、五張圖,外加一份 PDF,沒有任何推論程式碼;模型卡裡「如何在本地跑」的段落,目前還是註解掉的待補狀態。換句話說,這次開放的主角是權重與文件,想拿到一個 clone 下來就能跑的程式碼專案的人會撲空,本地部署要自己走 SGLang 或 vLLM 的官方支援路線。
底座的來源也值得一提。Atria Dawn Preview 建立在 GLM-5.2 之上,這是智譜(zai-org)釋出的 744B MoE 基礎模型,同樣走 MIT 授權,架構代號 glm_moe_dsa 兩邊一致。一家實驗室的 Agent 模型,長在另一家公司維護的開放基座上,在開放模型圈這已是常態分工,而選用哪個開放基座本身就是一種工程表態。從 config 檔看規格:256 個路由專家加 1 個共享專家、每個 token 活化 8 個專家、78 層、隱藏維度 6144,注意力採 MLA 加稀疏注意力索引器的組合;位置編碼原生支援到 1,048,576,但官方對外提供的是 256K 上下文,中間那段餘量目前沒有啟用。
744B 這個數字需要翻譯一下。它是 MoE(混合專家)架構,256 個專家不是每次全開,每個 token 只活化其中 8 個加 1 個共享專家,所以推理時的實際計算量遠低於「744B 全開」的直觀想像。但帳要分兩邊算:活化量影響的是速度,權重本身還是得整份放進儲存,756GB 的 FP8 版不會因為 MoE 而變小,這也是大型 MoE 開放模型共同的矛盾:跑起來比看起來便宜,搬回家還是很貴。
官方模型卡的評測表把它和 DeepSeek V4 Pro 0813、KIMI K3、Qwen 3.8 Max、GLM 5.3、GPT 5.6 sol、Claude Opus 5 放在同一張表裡。拿最高分的五項,全部是 agent 能力的考場:
| 基準 | Atria Dawn Preview | 該項最佳對手 | 考的是什麼 |
|---|---|---|---|
| DeepSearchQA | 96.0 | KIMI K3 95.9 | 深度搜尋 |
| BrowseComp | 92.5 | GPT 5.6 sol 92.2 | 網頁查找 |
| BFCL v4 | 77.0 | GLM 5.3 74.1 | 函式呼叫 |
| AutomationBench | 53.8 | Qwen 3.8 Max 49.7 | 辦公自動化 |
| CyberGym | 86.5 | GLM 5.3 84.5 | 資安攻防 |
敗點同樣整齊。SWE-bench Pro 拿 59.6,Claude Opus 5 是 74.7;Terminal-Bench 2.1 拿 78.3,Qwen 3.8 Max 是 89.3;文書交付類的 GDPval 拿 1583 對上 Opus 的 1768,JobBench 拿 50.3 對上 68.0,MLE-bench Lite 也以 86.2 小輸 GPT 5.6 sol 的 88.9。有幾項是差在最後一哩:SkillsBench 66.4 對 Qwen 的 66.7、Workspace-Bench 65.0 對 Opus 的 65.8,都在一分上下的距離;但也有輸得明的,多輪銀行工具對話的 τ³-Bench Banking 拿 41.2,Qwen 3.8 Max 是 55.2,差了十四分。整理成一句話:會找資料、會用工具、會驗資安,但終端裡的長工程任務、多輪嚴格工具對話與結構化文書交付,還是閉源前沿的場子。論文自己的措辭也停在「與前沿 agent 同級競爭」這個層次,沒有宣稱全面超越。要提醒的是,這 16 項分數全部是官方自報,目前還沒有獨立第三方的重測,排序參考價值大於絕對分數。
表裡還有一個耐人尋味的對照組:GLM 5.3。它是智譜自家更新的對話模型,等於 Atria 拿別人家的地基,跟地基原廠的新樓同場比價。函式呼叫與資安攻防兩項 Atria 領先(77.0 對 74.1、86.5 對 84.5),深度搜尋也以 96.0 對 94.7 勝出;但 Terminal-Bench 2.1 反過來輸了七分(78.3 對 85.4)。同一張表內的這組對比,大致就是把「Agent 訓練」疊在「通用基座」上會長出的形狀:工具與搜尋類能力被往上推了一把,工程類沒有跟著水漲船高。
這個模型真正值得記住的設計,是論文宣稱的訓練方法「Verifiable Experience Pipeline」。概念不複雜:訓練時把工具操作接到真實可執行的環境,任務成敗交給外部驗證,而不是讓模型自己評自己。模型卡對能力的四分法也跟這條軸對齊:搜尋(找證據、把問題變成實驗計畫)、創作(蓋軟體與資料視覺化)、交付(把文件與需求變成報告)、資安(在授權環境裡驗證漏洞與修復),四個維度全是「做出可以被檢查的東西」。對手上的 Agent 產品來說,這條路線把「模型講得頭頭是道」與「模型真的把事情做完」拆開來計分,後者才是 Agent 的本業。
論文裡另一個有意思的部分,是作者團隊把自己的研發過程當案例研究:他們分析了 769 筆任務紀錄與 56 位參與者的行為,發現在相近條件下評估已完成的任務時,約三分之一被評為「沒有 AI 協助就做不出來」;而分工樣貌是 agent 經常提出方法並動手修改,人類保留大多數最終決定,並靠判斷與回饋引導探索方向。這些數字出自論文作者自己的紀錄,讀的時候要打折扣,但方向值得放在心裡:agent 模型的價值正在從「執行單一任務」移向「參與整個專案」,而人的位置移向決定什麼值得做。
對讀者來說,這意味著看這類模型的指標要換檔。聊天基準的分數參考價值越來越低,該看的是可驗證成果類的基準,以及模型在失敗後有沒有修正行為的證據。DeepSeek V4.1-Flash 發表時多項代理任務基準拿下最佳,加上這次 Atria 的五項,搜尋與工具類考場正在變成開放與閉源模型交鋒的主戰場。
官方 API 文件走得相當務實:一個服務同時支援 Chat Completions、Anthropic Messages、OpenAI Responses 三種標準介面,等於 OpenAI SDK、Anthropic SDK 與各家 agent 工具大多能直接換 base_url 接上。model 欄位固定填 Atria-Dawn-Preview,區分大小寫;單次輸出上限 65,536 tokens,三個介面也不再設應用層的請求體大小上限;API 金鑰 atr_ 開頭,控制台用 Google 帳號登入後建立。寫程式接入時要注意回應結構不同:Chat Completions 的正文在 choices[0].message.content,Messages 在 content[0].text,Responses 在 output[0].content[0].text,流式時的增量欄位也各不相同,照著官方文件的路徑取值可以少走彎路。另外對話模板預設把推理強度設到最高,只有明確指定 high 才會降,計畫拿它跑大量自動化任務的人,延遲預期要先抓出來。
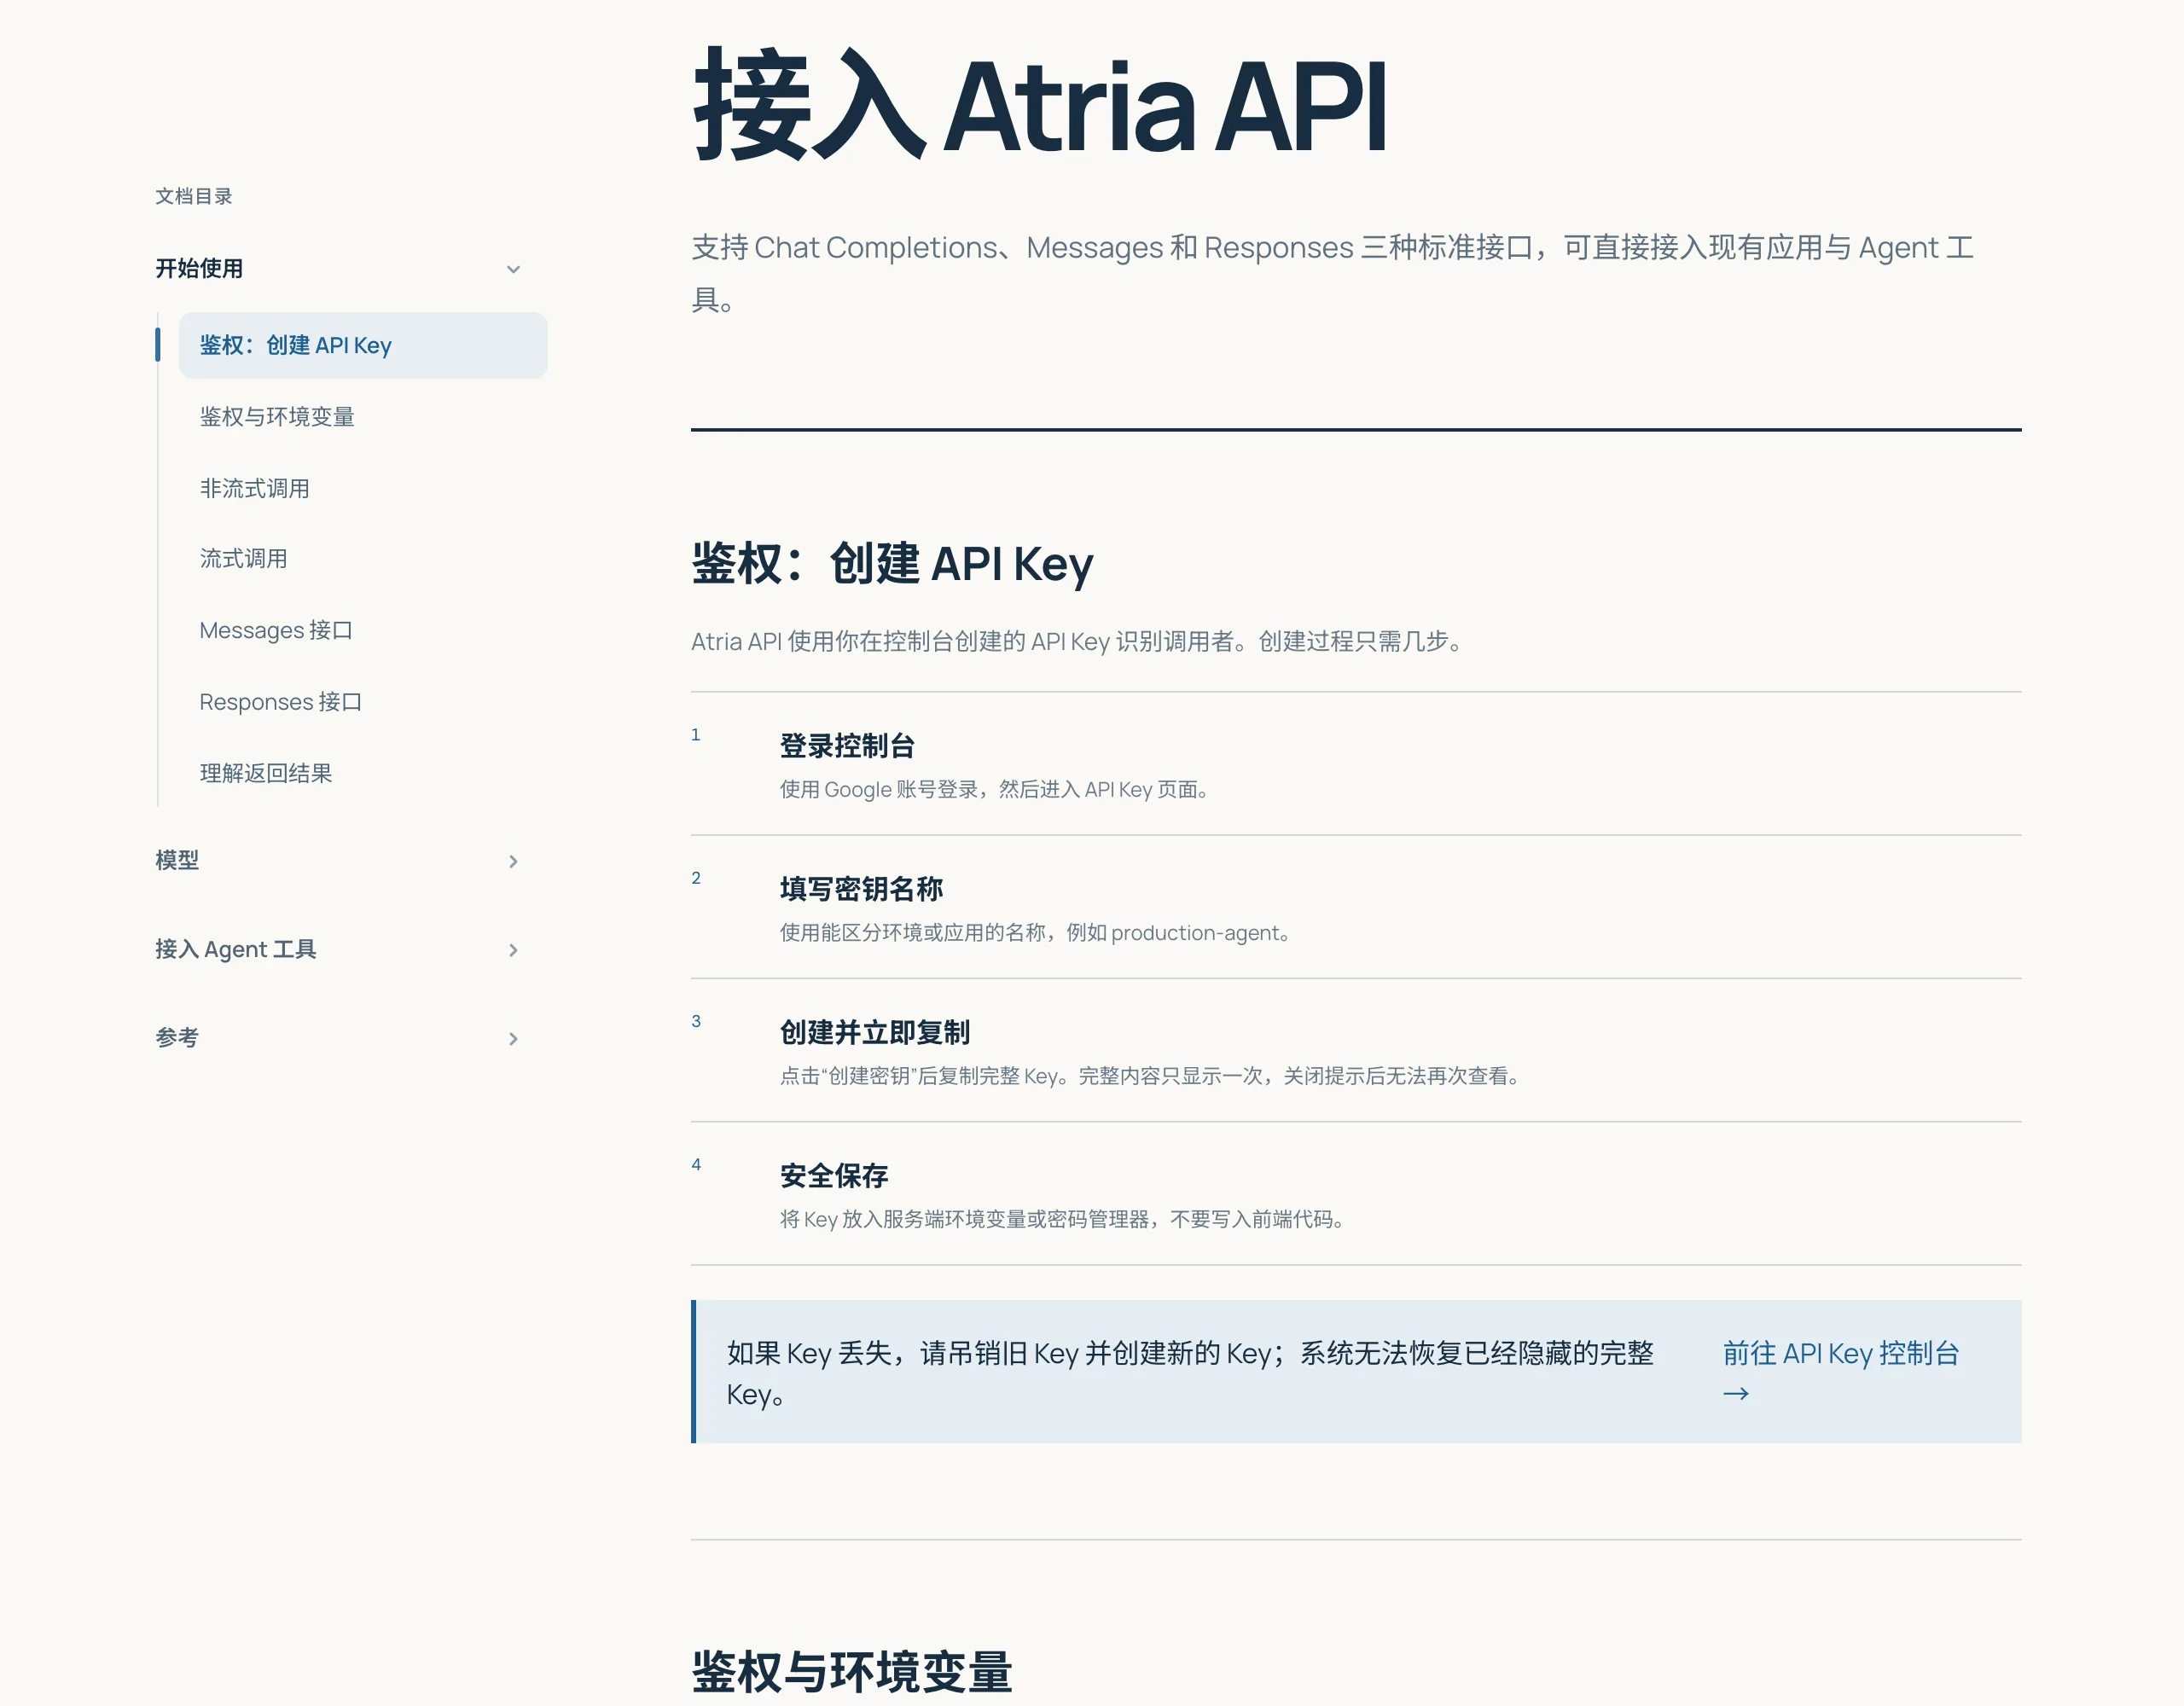
想花最短時間親自看一次輸出,流程是:用 Google 帳號登入控制台,到 API Key 頁面建一把金鑰。這裡有個要留意的細節,完整金鑰只在建立當下顯示一次,關掉就看不到,直接放進環境變數或密碼管理器,別貼進程式碼;弄丟了唯一的路是吊銷重發。有了金鑰之後,拿官方文件裡的 curl 範例換上自己的金鑰就能對話,串流與非串流各給了一份範例,先跑非串流版看清回應結構,再換串流版接進自己的介面,除錯負擔最小。
國際端點是 api.atria-asi.ai,中國境內另有 discovery.intern-ai.org.cn。定價沒有列在公開文件裡,成本敏感的接入得先向官方確認,這是目前唯一無法從文件回答的商業問題;想先掌握行情,可以先用TryAii 這類模型比價工具看看市場基準。真正的接入門檻則在輸入格式:這個模型不接受圖片與 PDF,端點會直接退回 400 錯誤,官方模型卡為此寫了整整兩節的用戶端解法。在 Codex 裡要建一份模型目錄檔,把 input_modalities 設成純文字(需要 Codex CLI 0.154.0 以上),讓用戶端在你貼圖時就先擋下來;在 Claude Code 裡則是掛一個 PreToolUse hook,攔掉 Read 工具讀取圖檔與 PDF 的請求。官方連完整的設定檔範例都給了,已經在用這兩套工具的人照抄就能上,但如果你日常工作需要模型直接看截圖或讀掃描文件,這條路現在走不通。
Codex 那份模型目錄檔還有兩個細節值得知道。一是 context_window 要照實填 256000,Codex 靠這個欄位估算提示詞預算、決定什麼時候自動壓縮對話,不填的話它會退回保守預設,等於白白放棄可用的上下文。二是這份檔案是整份取代、不是附加合併,沒列進去的模型都會退回預設詮釋資料,被當成可以看圖的模型;如果你平常在多個模型之間切換,記得把它們一起補進同一份檔案,純文字限制才會跟著生效。
本地部署的條件官方寫得明確:SGLang 要 v0.5.13.post1 以上、vLLM 要 v0.23.0 以上,部署指南直接連到 GLM-5.2 的官方食譜,畢竟底座相同。硬體帳則由權重本身決定:FP8 版 755.6GB 的下載量還只是起點,推理時的顯示卡記憶體與 KV cache 都還要另計,這已經超出個人工作站的範圍,比較合理的場景是研究機構或有意自建推理服務的團隊。一般開發者想評估它,走 API 是務實的路;同樣想用顯示卡換掉雲端費用的思維,可以參考我們先前聊過的 AgenticSeek 開源本地 AI 助手,那是另一個量級的玩法。
社群熱度供參考:截至 9 月 16 日,GitHub 倉庫 288 顆星、Hugging Face 下載 374 次、97 個讚。這些數字每天都會漂移,拿來判斷「有沒有人在認真用」還太早,拿來確認「東西真的在那裡、真的抓得到」剛好。
一是獨立評測缺席,16 項分數都是官方自報,搜尋與資安類基準的第三方複測尤其值得等。二是價格未知,公開文件沒有計費資訊,正式採用前這是第一個要問的問題。三是它叫 Preview,模型卡的本地部署段落還留著待補註解,介面、分數甚至授權頁的細節都可能在正式版調整,兩到四週後回頭看一次是合理的回查節奏。
至於要不要現在動手:如果你的工作流裡有大量深度搜尋、資安驗證或辦公自動化,而且已經在用 Claude Code 或 Codex,接上 API 跑一個真實任務的成本很低,值得親自看一次輸出品質;如果你的重心是終端裡的長工程任務,官方自己的分數已經說了,現階段留在原本的工具鏈是合理選擇。744B 與 MIT 是好故事,但換不換工作流,看的從來是手邊那個任務它做得好不好。