TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
ClearerVoice-Studio 是阿里巴巴語音實驗室開源的 AI 語音處理工具包,去噪、人聲分離、升頻一次包辦;實測在筆電 CPU 上就能跑得動,但主程式碼已凍結一年多、兩個 HuggingFace 演示雙雙掛掉,想用之前先看清維護現況。
用 AI 摘要這篇文章:
先講結論:ClearerVoice-Studio 值得裝,但你要知道拿到手的東西停在 2025 年 8 月。這套由阿里巴巴語音實驗室開源的語音處理工具包,核心功能到今天都裝得起來、跑得動,我在沒有獨立顯卡的 Apple Silicon 筆電上把去噪、分離幾種任務全部跑過一輪,處理速度都快過音檔本身的長度;但它的兩個官方線上 Demo 已經雙雙掛掉、主程式碼凍結超過一年、社群修好的程式碼堆在門口沒人收。一句話:跑自己的一次性清理任務很值得,要當成長期依賴的基礎建設,先看完整篇再決定。
它在 GitHub 上有 4,500 多顆星,採 Apache-2.0 授權,能做的事情圍繞著四類語音任務:把帶噪音的錄音變乾淨(語音增強)、把兩個人同時講話的音檔拆成兩軌(語音分離)、把低取樣率的語音拉到 48kHz(超解析),以及從混合音場裡指定抽出某個說話的人(目標說話人提取,其中一個子任務甚至支援用嘴唇影像或腦電訊號當線索)。
ClearerVoice-Studio 不是單一模型,而是三個部件的組合:ClearVoice 是推理入口,載入預訓練模型直接處理音檔;Train 是給研究者的微調訓練腳本;SpeechScore 則是一組語音品質評分指標(SNR、PESQ、STOI、DNSMOS 這類),官方自己的評測數字就是用它算出來的。三個部件共用一個 repo,各有一份說明文件。
先把幾個容易混淆的名詞用一句話講清楚。語音增強指的是把噪音壓掉、讓人聲變清楚,輸入輸出取樣率不變;語音分離是混合音檔裡同時有好幾個人講話,把它拆成每人一軌;超解析是升頻,把 16kHz 等級的語音內容補到 48kHz 的頻寬,救的是聽感細節而不是清晰度;目標說話人提取則是在混合音場裡指定「只要這個人」,線索可以是另一段參考語音、一段嘴唇影片,研究方向的子任務甚至支援用腦電訊號當條件。任務之間共用模型家族,所以訓練腳本目錄才會長出一整排子資料夾。
推理入口目前對應的預訓練模型如下:
| 任務 | 模型 | 權重大小 |
|---|---|---|
| 語音增強(16kHz) | FRCRN_SE_16K、MossFormerGAN_SE_16K | 161MB、136MB |
| 語音增強(48kHz 全頻段) | MossFormer2_SE_48K | 222MB |
| 語音分離(16kHz) | MossFormer2_SS_16K | 670MB |
| 語音超解析(升至 48kHz) | MossFormer2_SR_48K | 兩個權重檔合計約 440MB |
| 目標說話人提取(視聽融合) | AV_MossFormer2_TSE_16K | 約 735MB |
模型權重第一次執行時自動從 HuggingFace 下載,之後留在本機快取,也可以手動從 ModelScope 下載。支援的輸入格式涵蓋 WAV、FLAC、MP3、M4A、OGG、OPUS 等常見類型,單聲道與雙聲道、16 與 32 位元深度都吃,非 WAV 格式靠系統的 FFmpeg 轉檔。出身方面,README 自己署名是 Alibaba Group 智能計算研究院的語音實驗室,聯絡信箱是 alibaba-inc.com 網域,團隊也在 2025 年 6 月發過一篇說明整體設計的論文,論文裡的定位講得很直白:不像 SpeechBrain、ESPnet 那種什麼都包的大型平台,專注在語音增強、分離、超解析與多模態說話人提取這幾件互相關聯的任務上。
這套包裝的底層模型早在工具包出現前就已經在被大規模使用:ModelScope 上的 FRCRN 語音降噪模型頁面顯示約 692 萬次下載,MossFormer 語音分離模型約 271 萬次,截至 2026 年 10 月。凍結的是包裝與工程層,模型本身經過大量實戰。整個 repo 的提交紀錄也很有辨識度:超過三百次提交幾乎全來自兩位署名作者,是典型的實驗室內部專案形態,而不是開放社群共同維護的基金會型專案,這點先記著,下面談維護時會用到。
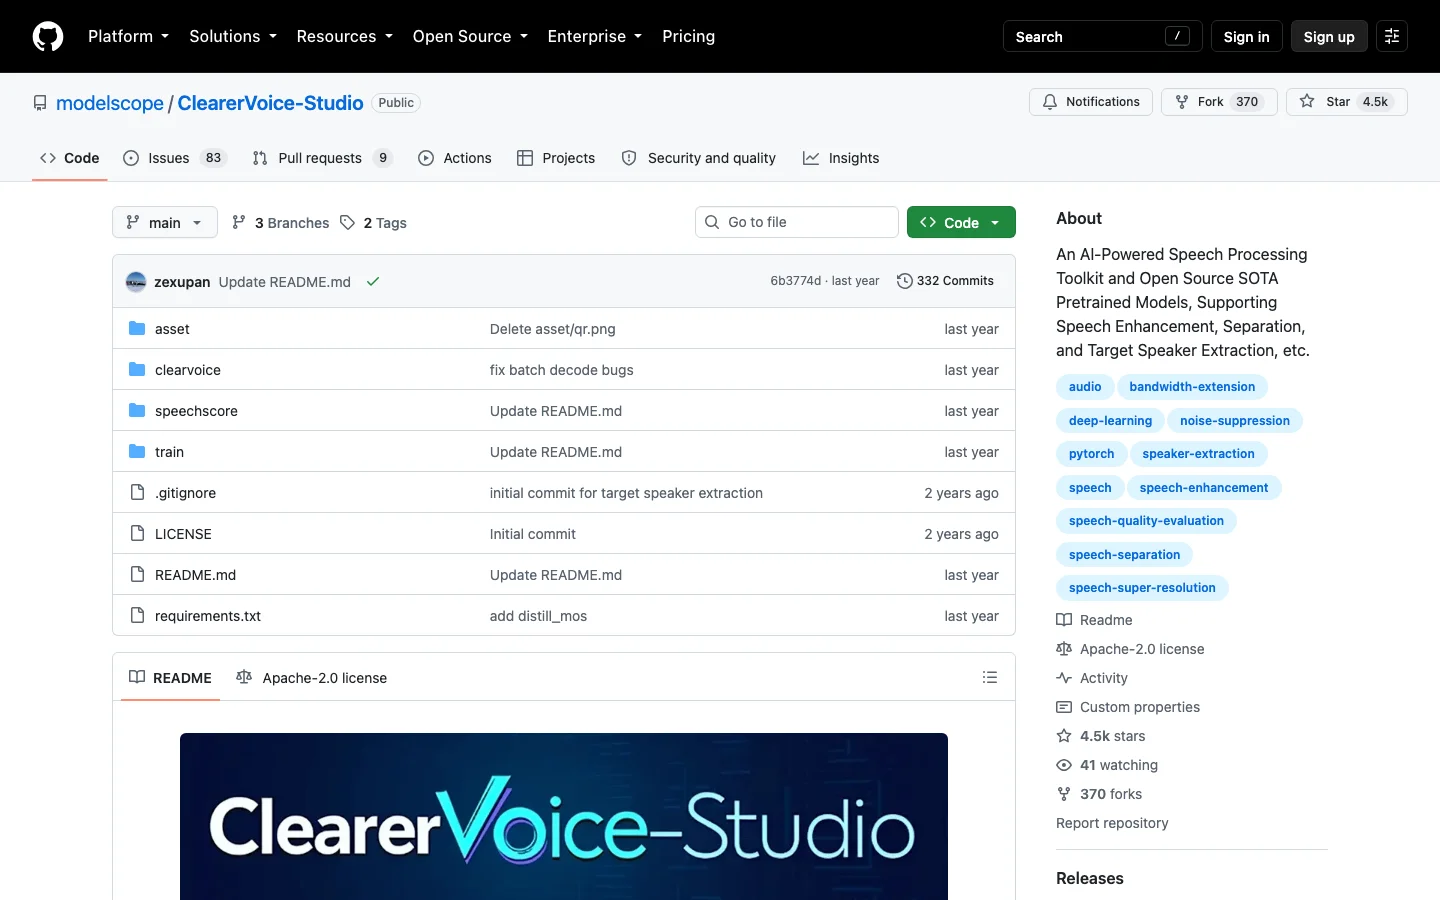
安裝只有一行:pip install clearvoice。我在 Python 3.11 的乾淨虛擬環境裡裝 0.1.2 版,連同 PyTorch 在內的全部相依套件一次成功,全程 56 秒,沒有碰到任何需要編譯器的環節。四種任務的實測結果如下(Apple Silicon 筆電、純 CPU、2026-10 實測):
| 任務 | 模型 | 輸入 | CPU 耗時 | 輸出 |
|---|---|---|---|---|
| 去噪 | FRCRN_SE_16K | 2.4 秒 WAV | 2.33 秒 | 同長度 16kHz 單聲道 |
| 去噪 | FRCRN_SE_16K | 18.5 秒 MP3 | 4.51 秒 | 同長度(內容仍為 MP3) |
| 增強 | MossFormer2_SE_48K | 25.6 秒、48kHz 陣列 | 1.89 秒 | 同長度 48kHz |
| 分離 | MossFormer2_SS_16K | 4.4 秒雙人混合 | 1.12 秒 | 兩軌各 4.4 秒 |
有兩個細節讓我確認處理是真的發生了,而不是原檔穿過去:輸入與輸出的波形相關係數是 0.954,差異訊號的振幅約是原始訊號的三成(能量比約 9%)。輸出檔的長度、取樣率、聲道數都與輸入一致,分離任務則照著混合音檔裡的人數輸出兩軌各自完整的音檔。音質聽起來變好多少,這我沒有立場替你判斷,能跟你保證的是處理真實發生、時間成本大概多少;官方評測表中 48kHz 增強模型在 VoiceBank+DEMAND 測試集的 PESQ 分數高於 Resemble Enhance 與 DeepFilterNet 兩個開源同行,那是官方統一模型跑出來的數字,僅供參考。
第一次跑的隱形成本是權重下載:我實測的 FRCRN 模型 161MB,下載連同載入花約 30 秒,之後全走本機快取,第二次起就是純推理時間。另外兩個大模型(超解析與視聽提取)的儲存庫裡還附了訓練狀態檔,首次下載量會比表列的權重數字更大。輸入也支援一整個資料夾或純文字清單檔,清單模式搭配 online_write=True 會邊處理邊寫檔,適合一次丟幾十個訪談錄音進去放著跑。
程式介面本身很省事,三行就能跑完一個檔案:
from clearvoice import ClearVoice

cv = ClearVoice(task='speech_enhancement', model_names=['FRCRN_SE_16K'])
output = cv(input_path='input.wav', online_write=False)
cv.write(output, output_path='output.wav')
task 從 speech_enhancement、speech_separation、target_speaker_extraction 三個值裡選,model_names 可以一次指定多個模型比對輸出,輸入可以是單檔、整個資料夾或清單檔。只吃 WAV 的話連 FFmpeg 都不用裝;MP3、M4A、OGG 之類的格式才需要系統裡有 FFmpeg,我餵 18.5 秒的 MP3 進去就是走這條路。
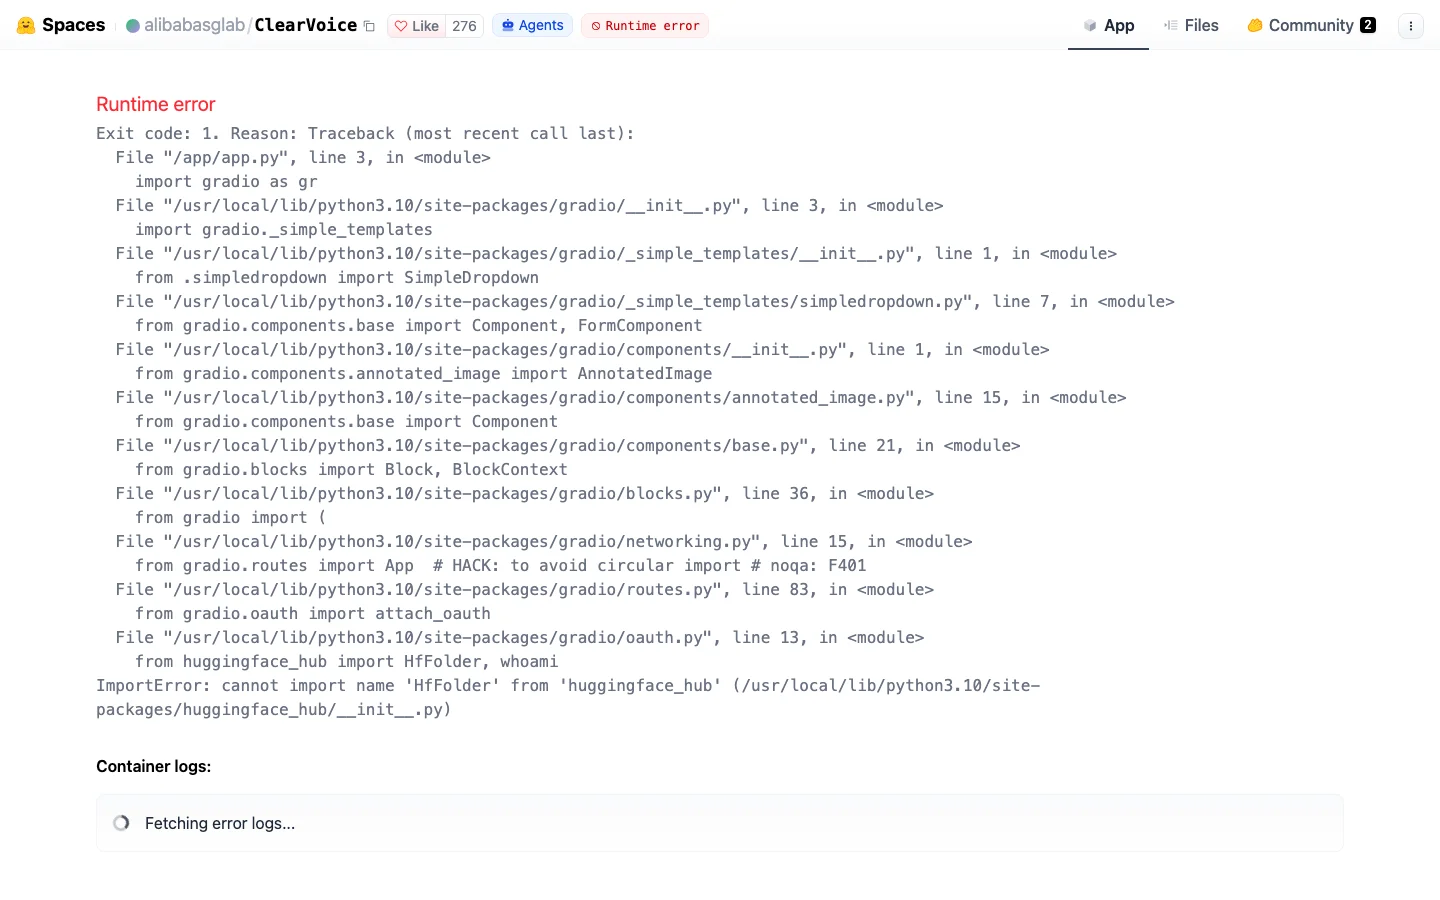
README 頂端掛了兩個 HuggingFace 展示連結,ClearVoice 與評分工具 SpeechScore 各一個,目前兩個都是 RuntimeError 狀態。ClearVoice 那個的死因頁面上看得一清二楚:示範環境釘住的 gradio 版本呼叫了新版 huggingface_hub 已經移除的 HfFolder,一連串 import 在開機階段就斷掉。這不是什麼深奧的模型問題,就是展示環境沒人跟著相依套件更新,放到爛掉了。兩個展示空間的最後更新時間分別停在 2025 年 7 月與 2024 年 11 月,對照主 repo 凍結在 2025 年 8 月,時間軸是完全一致的:整個專案的對外門面在同一個夏天之後就靜止了。
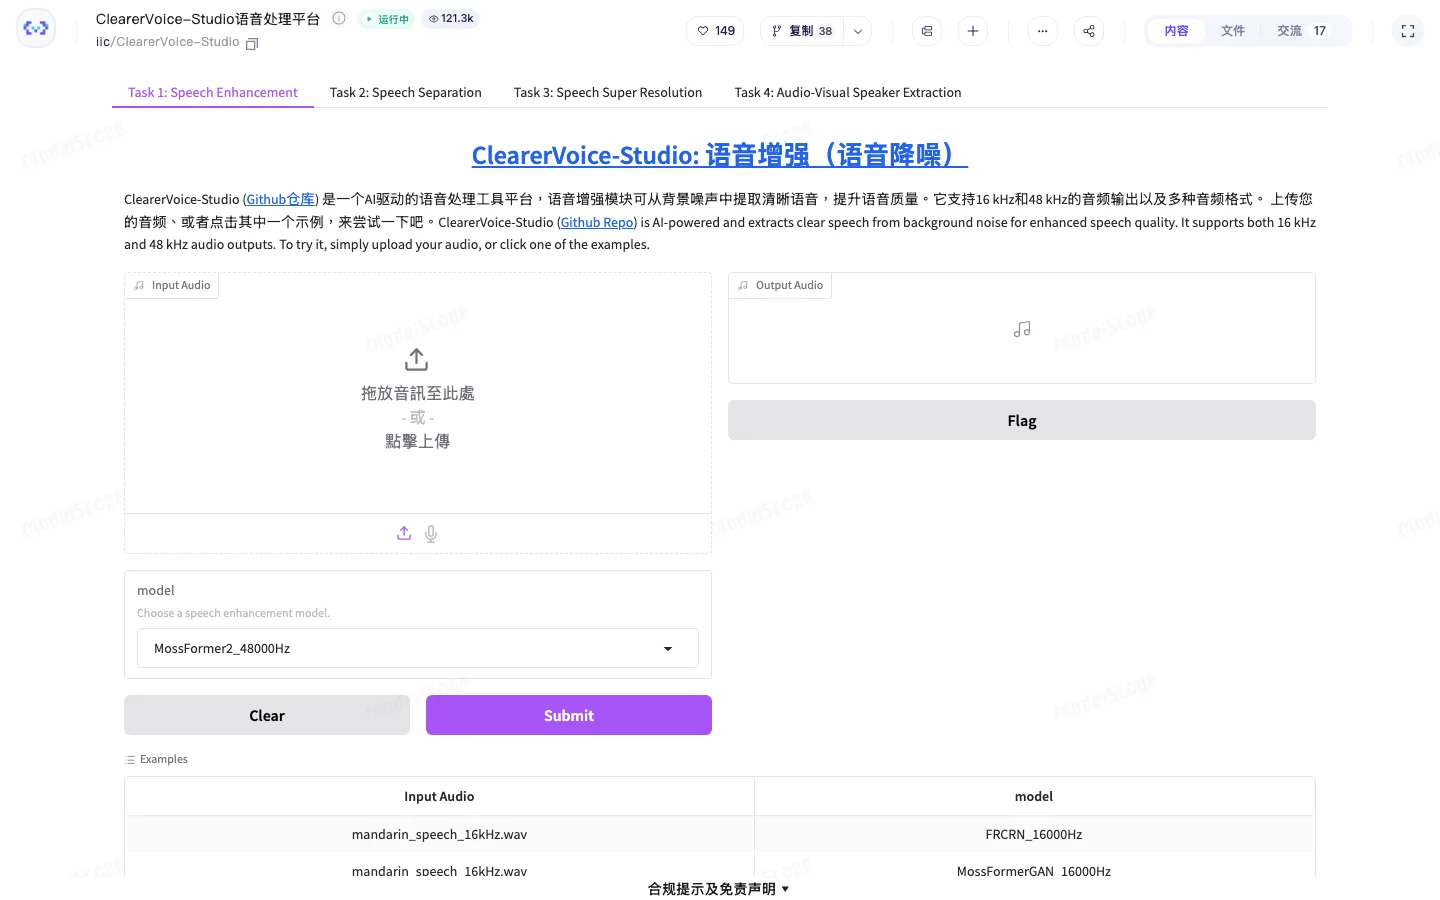
還能用的官方入口在 ModelScope:同一個服務的 ModelScope 版目前狀態是運行中,頁面顯示超過 12 萬次瀏覽,介面就是上傳音檔、選任務、聽結果,連帳號都不用註冊就能試。其實 README 在 2025 年 1 月的新聞欄就寫過「HuggingFace 的 GPU 額度有限,ModelScope 額度比較多」,現在的狀況只是這句話的極限版。
想找其他瀏覽器裡的方案,之前介紹過的 Chrome 人聲分離擴充功能 走的是本機運算路線,適合即時處理會議或通話聲;ClearerVoice 的強項則在批量檔案與可程式化,兩者其實互補。
判斷一套開源工具能不能長期依賴,星星數向來不作準,要緊的是有沒有人持續打掃。這裡的答案偏向沒有:主分支最後一次提交停在 2025 年 8 月 14 日,內容是更新 README;PyPI 上的 clearvoice 套件 0.1.2 版發布於 2025 年 7 月 11 日,之後再沒有新版本。README 頂端的 News 欄最後一條是 2025 年 6 月,還掛著「Upcoming: More tasks」的預告,至今沒有下文。
issue 追蹤區累積了 83 個未解項目,2026 年的新通報基本都沒有得到官方答覆。比較具體的例子:有人在今年 7 月仔細列出 MossFormer2_SE_48K 在 NumPy 介面處理超過 20 秒音檔時的三個程式錯誤,附上完整修補 diff,至今無人處理;我把 PyPI 出廠包解開對照,那三個出問題的程式碼位置在 0.1.2 版裡一字不差地都在。pull request 區同樣堆了 9 個等待合併的提交,最舊的一個(幫 FRCRN 加即時處理)從 2024 年 12 月排隊到現在;還有一個把相依套件放寬到 NumPy 2 相容的提交也躺滿三個月,這直接影響一般使用者:套件的版本約束目前釘著 numpy<2.0,在已經全面升上 NumPy 2 的環境裝它,得另外隔離一個環境。修好的程式碼就在門口,只是沒有人開門。
對使用者的實際意義:裝起來用的瞬間,你接受的是 2025 年 8 月的快照,問題只能靠 issue 區彼此幫忙或自己 fork。好處是快照本身能用、權重下載正常、模型在大規模場景被驗證過;壞處是下一個 Python 大版本、下一個相依套件的破壞性更新,都得自己扛。兩位主力作者的電子信箱就掛在 README 上,但從 issue 區的靜默看,別把答覆寄望在官方身上。
取樣率是自己扛的責任。 NumPy 陣列輸入的介面不會檢查你的音檔取樣率,官方範例的註解寫明 48kHz 模型就要先自己把陣列重取樣到 48000Hz 再餵進去。我實際對照過:把 16kHz 的陣列直接餵給 48kHz 模型,不會報錯,程式照樣跑完,只是它把 25.6 秒的聲音當成 8.5 秒的 48kHz 訊號在處理,時間軸整個錯掉。檔案路徑模式沒有這個問題,它會自己處理取樣率。
長音檔別走 NumPy 介面。 上面提到的那組三個錯誤,後果是超過 20 秒的陣列輸入會走進一段有問題的分段處理分支,通報者量到的現象包括 60 秒的輸入被墊成 66 秒的輸出,以及 192 秒的音檔在修復前直接讓 Python 行程被系統終結、連錯誤訊息都沒有。同一批錯誤不影響檔案路徑模式,所以我全部的實測都以檔案或正確重取樣的路徑為準。
Windows 使用者直接走 PyPI。 從 GitHub 下載 repo 再照 requirements.txt 安裝的路線,在 Windows 會卡在 pesq、pysptk 兩個需要微軟 C 編譯器的套件上,今年 2 月就有人反映,至今掛著。PyPI 的 clearvoice 套件 dependencies 沒有這兩項,安裝路線選對就沒事。
評分時記得官方但書。 README 自己記了一筆:用 48kHz 模型處理後,LLR 與 LSD 兩個指標出現異常,原因還在查。你要用 SpeechScore 替輸出打分數,這兩項先打個問號。
視訊與腦電任務沒有實測。 目標說話人提取的視聽融合模型需要影片檔當輸入(官方支援 AVI、MP4、MOV、WebM),訓練目錄裡的腦電子任務更屬於實驗室性質。這篇的實測範圍是純音檔的增強與分離,這兩塊我沒有跑,需要的人直接看 repo 對應子目錄的說明文件會比任何轉述可靠。
適合的情境很明確:手上有訪談、Podcast 素材或配音稿要清理,想用不用錢的方案在本機批次處理,不想把檔案傳到雲端服務;或者你在做語音相關的實驗,需要一組現成的預訓練模型當基準。清理完的錄音如果要變成文字稿,可以接著交給 本機就能跑的語音轉文字工具,或交給 線上的錄音轉文字服務;方向相反、要把乾淨文字唸成聲音的,之前寫過的 開源文字轉語音模型 與 自架的微軟語音服務 都在站上。
不適合的情境同樣明確:你需要的是圖形介面按到底(用 ModelScope 線上版就好)、你需要商業支援與維護承諾、或者你的產品要把它的長音檔 NumPy 路徑放進關鍵流程(那組已知的錯誤還躺著)。還有一種人要三思:環境已經全面升上 NumPy 2 的團隊,得多養一個隔離環境來伺候它的版本約束。
第一步很單純:pip install clearvoice,拿一段你自己的錄音跑上面那三行程式,聽完輸出再決定要不要把它留下來。它是那種「前人種好樹、後人自澆水」的工具,樹是真的能乘涼,澆水這件事,現在得自己來。