TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

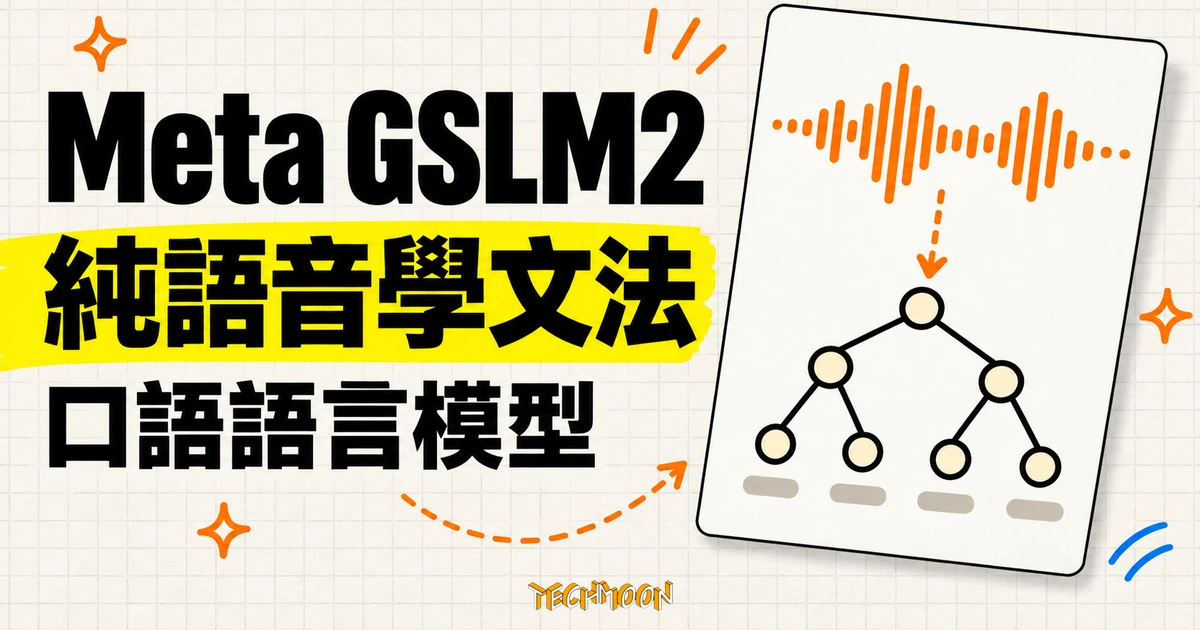
Meta 團隊在 arXiv 發表 GSLM2 口語語言模型框架,用 SpidR 2.0 編碼器與六條資料流聯合建模,把純語音模型追平文字模型所需的資料倍數從約一萬倍壓到約一百倍,文法基準 sBLIMP 甚至小勝文字模型。權重與程式碼已公開下載,採 CC BY-NC 4.0 禁止商業使用。
用 AI 摘要這篇文章:
Meta 在 11 月 4 日把 GSLM2 掛上官方研究頁,論文全文 10 月 31 日登上 arXiv,訓練程式碼與模型權重同步放進 GitHub。這套框架讓語言模型跳過語音轉文字的中介,直接從聲音學習語言結構,最大規模用到 600 萬小時對話音訊與 65 億參數。這篇論文真正證明的東西,比多數轉述講的更節制,也更有意思。
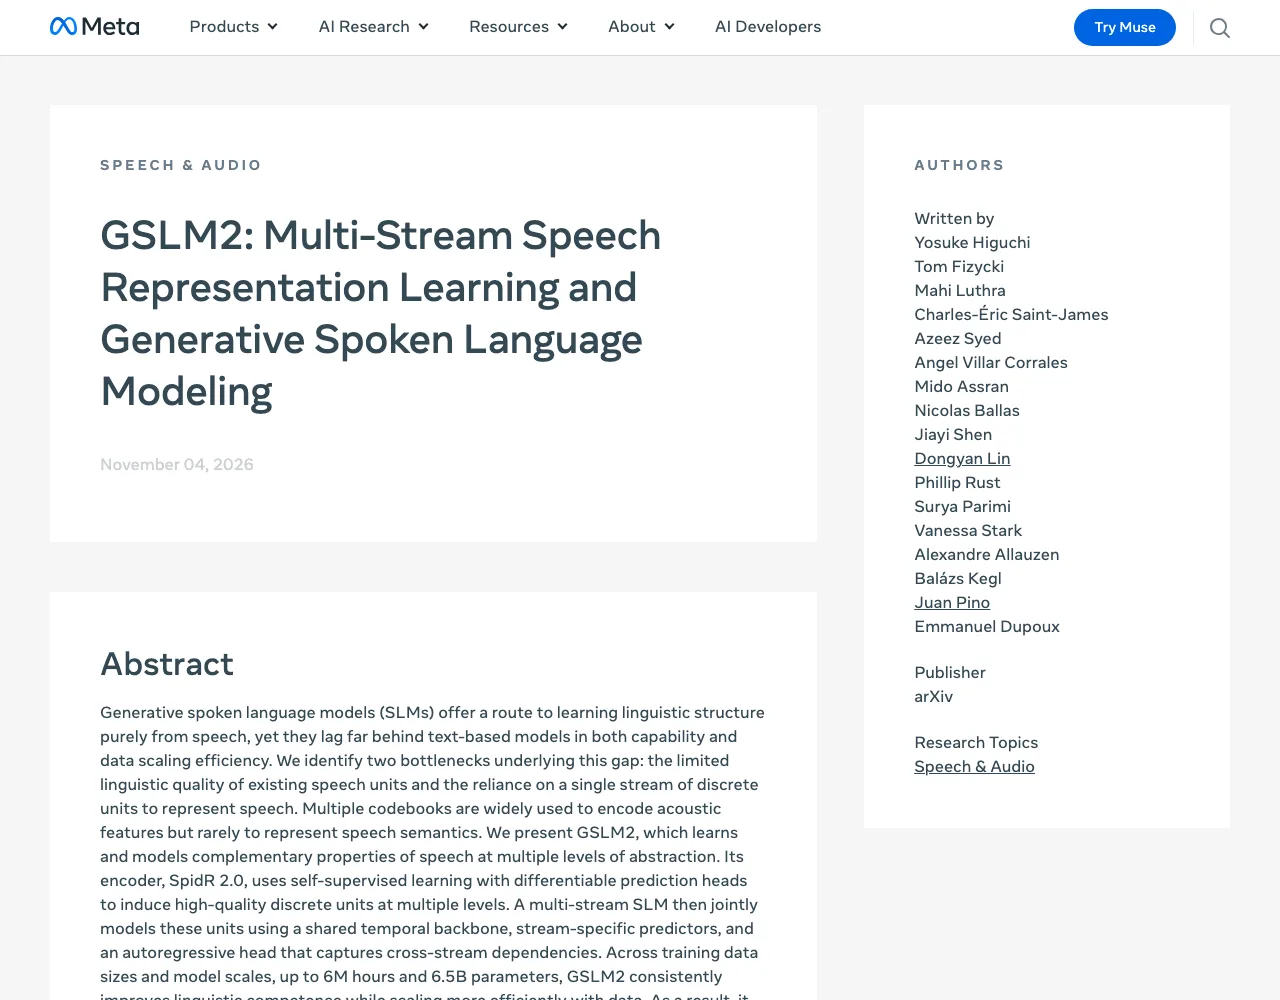
GSLM2 的標題數字「縮小兩個數量級」很容易被讀成「口語模型的分數追到只剩文字模型的百分之一差距」。對照論文的實驗章節,這句話的精確意思是:過去的純語音模型需要約一萬倍的資料量,才能追平同級文字模型的語言能力;換成 GSLM2 之後,這個倍數降到約一百倍。分數本身多數時候仍落在文字模型後面,但「要餵多少資料才追得上」這件事,困難度降了一百倍。
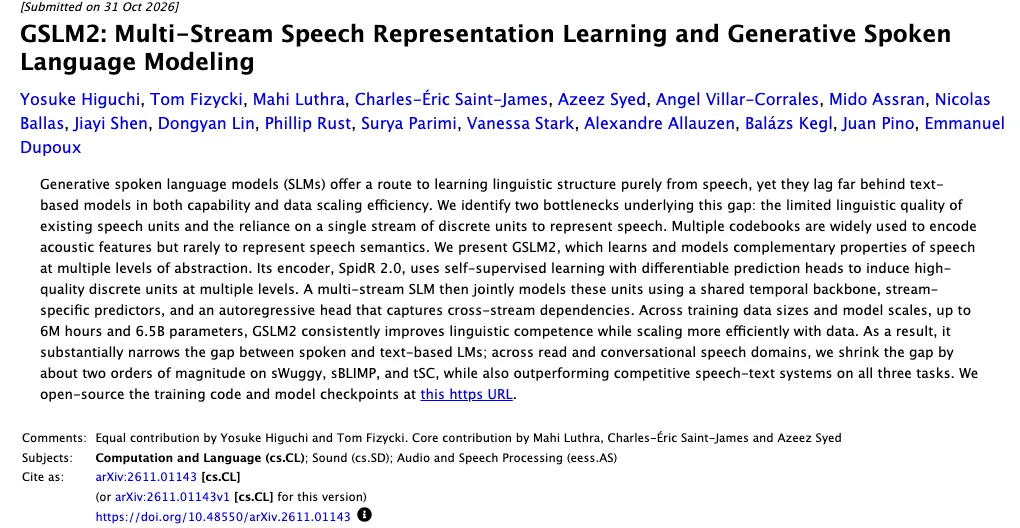
這個區別重要,因為它決定了純語音路線的定位。如果追平的是分數,這條路已經走完了;追平的是資料效率,它代表的是「以前根本不可行,現在變成昂貴但可行」。論文的用詞也站在這一邊:作者把這個現象稱為資料效率差距的縮小,並附上規模化指數佐證。在 GSLM2 自己身上,語意任務的指數 0.116 遠高於詞彙任務的 0.044,是各項能力裡持續加大規模回報最高的一項;平均指數文字模型仍以 0.073 領先 GSLM2 的 0.060。
這個實驗的對照組設計值得多看一眼。文字模型不是拿現成的大語言模型來比,而是用同一批聲音內容的 Libriheavy 轉錄稿,從零訓練參數量與訓練量都對齊的文字模型。也就是說,兩邊聽到的、讀到的內容相同,差的只有「從聲音學」還是「從文字學」這一件事。模型規模從 90M 一路拉到 6.5B 五個檔位,每個檔位都維持這種對齊,結論因此比常見的跨論文比較扎實。資料端的規模化也做得保守:600 萬小時語料按比例隨機切出 600、6K、60K、600K 小時子集,三種來源在每個子集裡的佔比固定,避免「資料變多」混進「資料變雜」的效果。
實驗同時涵蓋兩種聲音世界。朗讀語料 Libri-Light 是有聲書等級的乾淨單人語音,用來做階梯式的規模化對照;600 萬小時對話語料則是網路採集的真實交談,說話方式、口音與錄音品質都雜得多,最大模型與最強結果都出自這一端。論文強調的「朗讀與對話兩個領域都成立」,指的就是這種雙軌驗證,而不只挑對自己有利的乾淨語料。
純語音語言模型這條路線,源頭是 Meta 自己 2021 年的 GSLM 論文,之後社群累積出一個尷尬的共識:這類模型需要的訓練資料,可能是文字模型的一萬倍。論文開頭就點名落後的兩個結構性原因,兩者都指向「聲音怎麼變成離散符號」這一步。
一個問題出在離散語音單元的語言品質。聲音是連續波形,混著說話者音色、環境雜訊與語速變化,過去的做法是拿預訓練編碼器某一層的表示做 k-means 分群,切出來的離散單元經常混入與語意無關的聲學細節,模型把力氣花在學音色與氣音上。後續研究嘗試在預訓練過程中直接學離散目標,但論文的比較顯示兩種路線各有勝場,單元品質的問題始終沒有根本解法。另一個問題是單一資料流的資訊瓶頸。一條序列要同時承載發音細節與語意結構,兩種訊號互相干擾,模型容量被浪費在調解兩者上。音訊編碼領域其實早就用多組編碼簿分層還原聲音,但那些設計服務的是音質,很少拿來表達語意。
GSLM2 用兩個設計分別回應。編碼器 SpidR 2.0 用自監督學習加上可微分的預測頭,從多個神經網路層各取一組離散單元:淺層單元保留發音細節,深層單元收斂到接近音素與詞彙的語意表徵。論文的分層分析也驗證了這種分工,詞彙辨識與文法任務在淺層單元表現最好,語意任務受益於深層單元,而且每一層取出的單元都優於前一代編碼器。
語言模型端則不再依賴單一序列,而是六條資料流聯合建模:一條共享的時間骨幹網路追蹤整段對話的上下文,每條流有自己的預測器,再由一個自回歸預測頭捕捉跨流相依性。生成時六條流依照位元率由低到高的順序展開,取自編碼器的五到十層,確保語意概念先成形、發音細節後對齊。代價也寫得很明白,多流建模的訓練成本明顯高於單流,這點稍後攤開算。
成績單用的基準來自兩個出處:sWuggy 給模型聽真詞與假詞,看它偏好哪邊,測詞彙能力;sBLIMP 用只有一處文法差異的句子對,測文法判斷,兩者都出身自 ZeroSpeech 2021 挑戰賽;tSC 給故事開頭、選合理結尾,測語意連貫,出自 StoryCloze 的口語版。另有更難的故事變體 sSC,需要跨句子的情境理解。
先看與文字模型的對照。在 Libri-Light 朗讀語料的每個規模上,GSLM2 都穩定優於前一代單流模型,而且差距隨規模擴大。最搶眼的一項在文法基準 sBLIMP:300M 參數規模 GSLM2 拿到 67.2 分,小勝文字模型的 66.8;1.2B 規模 71.8 對 71.5,再次小勝。純從聲音學文法,在這個基準上已經站上同一水平。
| 模型 | 參數 | 訓練資料 | sWuggy 詞彙 | sBLIMP 文法 | tSC 語意 | sSC 故事語意 |
|---|---|---|---|---|---|---|
| 文字模型(對照組) | 1.2B | 60K 小時轉錄稿 | 83.8 | 71.5 | 89.2 | 54.6 |
| GSLM2 | 1.2B | 60K 小時語音 | 79.3 | 71.8 | 84.5 | 57.6 |
| GSLM2 | 6.5B | 600 萬小時對話語音 | 80.7 | 72.9 | 90.5 | 63.2 |
| Moshi(語音加文字) | 7B | 700 萬小時 | 72.6 | 58.8 | 83.0 | 60.8 |
| Align-SLM(語音加文字) | 7B | 4K 小時 | 77.9 | 62.3 | 86.8 | 61.1 |
表格數字取自論文 Table 3 與 Table 10,sSC 在 60K 小時規模的對照值以 Libri-Light 子集為基準。
表格裡的另一個訊號是參數效率:1.2B 的 GSLM2 在詞彙、文法、語意、故事語意四項指標全部勝過 7B 的 Moshi 純語音版;6.5B 版本則四項全勝 Moshi 語音加文字版與 Align-SLM。反過來的型態也值得看:倚重文字預訓練的系統在語意任務有優勢,但詞彙與文法的細部分辨普遍落後,GSLM2 則在四個面向都保持均衡。
生成品質的間接指標也支持同樣的方向。研究團隊讓模型續講語音、把續講內容轉成文字再算 perplexity:60K 小時規模的 GSLM2 是 189.1,前一代單流模型 259.4,文字模型 172.7,純語音模型第一次貼近文字模型的水位。更有意思的是語言模型評審給的整體分數,GSLM2 的 3.05 反而高於文字模型的 2.87,續講的口語被 LLM 評審認為更連貫。
誠實邊界是成績單的另一面。故事層級的語意基準 sSC 分數普遍接近隨機猜測水準;論文自建的深層語法測試 LT-Swap 中,詞形與句法一致的差距隨模型規模擴大而非縮小;多語言實驗用法語與德語在歐洲議會錄音的 VoxPopuli 語料上重跑,錄音環境比朗讀語料雜亂許多,文法分數 69.4 與 72.3,對照組文字模型是 95.0 與 88.9,差距仍然巨大。論文的限制章節也自陳:這套架構刻意不保留韻律等聲學性質,評測仰賴合成基準與間接生成指標,可能把語言模型的錯誤與合成、解碼、辨識環節的錯誤混在一起。論文還附了一頁生成式 AI 使用聲明,坦承基準建構用過翻譯、過濾與語音合成,評測也用 LLM 當自動評審,理論模型與概念框架則未使用。
多流設計不是免費的。論文附錄的運算量統計顯示,在 600 萬小時、65 億參數的最大規模,GSLM2 訓練需要 8.28×10²² FLOPs,對照的文字模型是 1.67×10²²,約五倍;推論端每秒音訊的運算量差距更大,約 8.5 倍。訓練設定表也記錄了這個規模用上 112 顆 GPU 的分散式訓練,上下文長度因六流並行而加倍到 4,096。
換句話說,GSLM2 的交易結構是拿算力換資料。文字資料的取得與處理成本已經很低,純語音路線即使資料效率改善一百倍,加上五倍的訓練成本,總帳是否值得,取決於你多在乎那些轉成文字就會消失的訊號:語氣、停頓、猶豫、情緒。這也是論文反覆鋪陳的動機,世界上大量語言缺乏完整書寫系統,而這些聲音裡的訊息在轉錄的瞬間就掉了。語音代理圈已經有人主張決策層不該只讀逐字稿,Tazo 的做法是讓代理直接聽原始音訊,GSLM2 等於把這個主張往模型層推了一層。
不過論文沒有承諾這條路很快通向產品。從研究模型到即時對話系統,中間還隔著延遲控制、事實性與工具呼叫等工程問題,這些缺口論文一個都沒有處理。對照產品端已經把語音層單獨拆出來計費的現況,例如 OpenAI 的 GPT-Live-1 API 用每分鐘計價把聽與說拆成獨立商品,研究模型與商用語音介面之間的距離仍然以年計。
GitHub 上的 model zoo 一次放了整個家族:90M 參數的 SpidR 2.0 編碼器、125M 到 1B 的單流與多流模型(Libri-Light 三個規模),以及最大的 600 萬小時對話版 7B 權重,全部掛在公開的下載連結上。編碼器的清單檔也足夠細:16kHz 取樣、20 毫秒間隔、12 層、8 組編碼簿各 256 個條目,權重檔 1.46GB 附 SHA-256 校驗值。
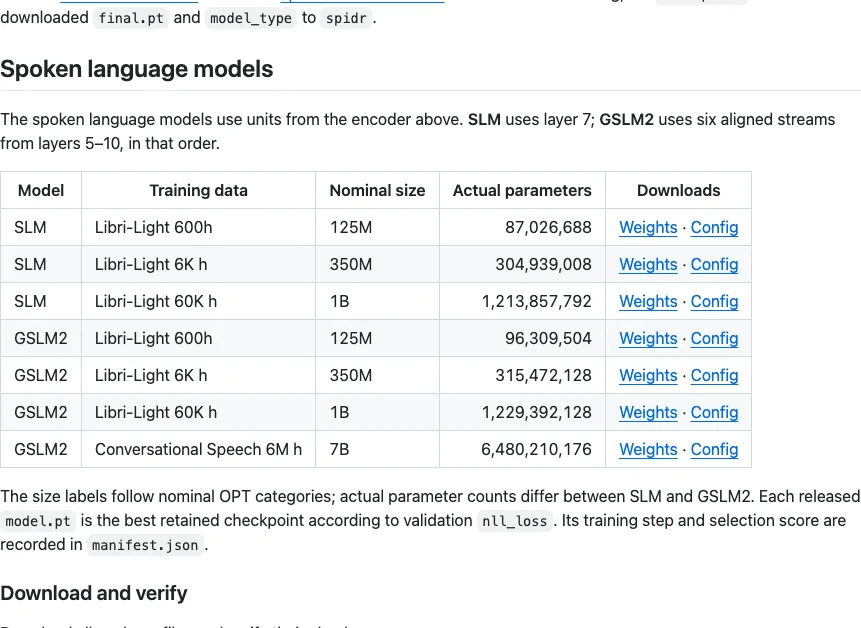
授權是取用前必須看清的一行字:程式碼與模型權重同一套 CC BY-NC 4.0,禁止商業使用。這不是開放原始碼倡議組織定義下的開源,想拿來做產品得另外談授權。重現訓練還有第二道牆:600 萬小時語料的組成是公開的 Emilia 語料加上兩家商用供應商的授權音訊,後者外界拿不到,所以最大模型的訓練結果無法完整重現,能重現的是 Libri-Light 規模的實驗。
環境門檻方面,repo 要求 Python 3.12 以上,編碼與合成走 PyTorch 2.13,但語言模型訓練與評測目前綁 fairseq2 0.7 搭配 PyTorch 2.9,原生 PyTorch 支援排在未來版本。想動手的研究者,從 Libri-Light 規模入門是唯一實際的路線。
語音研究與無文字語言保存團隊是最先受惠的一批:可下載的權重、可重現的 Libri-Light 實驗、明確的分層單元設計,都是接得上手的基礎。repo 也附了時長預測器與單元聲碼器的訓練程式,負責把模型的單元輸出合成回聲音;這次釋出沒有包含這兩個元件的檢查點,想聽模型續講的內容,得先照附帶流程把它們訓起來。同期開源的語音生成模型 ZONOS3-Mini 走的是聲音複製與語氣控制那一端,兩者相加,純語音研究的工具箱這個月厚了一截。
做語音代理產品的團隊則可以先等:禁商用授權、未處理的延遲與事實性問題,加上推論運算量是同級文字模型的八倍以上,這三件事任何一件都足以讓產品評估停在紙上。
後續值得回查的三個點:repo 的活躍度(最後推送停在 11 月 9 日)、arXiv 是否出現修訂版,以及論文是否現身審稿平台。GSLM2 把純語音路線從「資料需求大到不可行」推進到「貴但算得出帳」,至於帳能不能算進產品裡,下一次規模化或授權政策鬆動時才會知道。