TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

掛著 BabelDOC 名字的免費體驗,其實是沉浸式翻譯線上版的商業入口;GitHub 上開源的是 AGPL 授權翻譯引擎,官方明言命令列主要為除錯用。線上版計費已改 Token 制,以官方統計換算免費月額度約 68 到 106 頁,流傳的每月 1000 頁是過時文件。三條使用路線的額度數學、文件收集條款與自架代價一次分清楚。
用 AI 摘要這篇文章:
在網路上搜 BabelDOC,多數介紹文會告訴你這是一個開源 PDF 翻譯工具,免費、保留排版、每個月還送你 1000 頁額度。這些說法每一個都其來有自,但拼在一起會讓人走錯門。掛著 BabelDOC 這個名字的東西有三個:GitHub 上那個 AGPL 授權的翻譯引擎、沉浸式翻譯網站上的商業服務、以及把引擎包成完整介面的 PDFMathTranslate-next。免費的 1000 頁屬於商業服務的舊計費方式,現在已經換成 Token 額度制,換算回頁數大約只剩六十到一百頁出頭。想把英文論文變成繁中對照文件的人,在按下第一個下載按鈕之前,先分清楚自己要的是哪一層,比研究任何功能列表都重要。
BabelDOC 的 GitHub 倉庫(funstory-ai/BabelDOC)自述是一份 PDF 科學論文翻譯與雙語對照的函式庫,主要設計給其他程式嵌入使用。這個定位官方寫得一點都不含糊:README 的進階選項區塊開頭就聲明,這個命令列介面主要為除錯用途設計,終端使用者雖然可以直接拿它翻檔案,但官方不為此提供任何技術支援;Python API 段落更直接警告,BabelDOC 的所有 API 都應視為內部 API,任何直接使用都不受支援。換句話說,你從 GitHub 頁面看到的「開源工具」,本質上是一家公司開放出來的引擎零件,官方期望的兩個正確入口分別是沉浸式翻譯網站上的線上版,以及 PDFMathTranslate-next 這個自架發行版。
這家公司在 README 裡也不藏:倉庫由 funstory-ai 維護,線上服務頁面的頁尾寫著營運主體 Funstory.ai Limited(香港),也就是沉浸式翻譯這套瀏覽器擴充功能背後的同一家公司。開源引擎拿 AGPL-3.0 授權(授權條文全文可在大倉庫根目錄驗證),商業服務走訂閱制,兩者共用同一個名字但商業模式完全不同。截至 2026 年 9 月,這個倉庫有約 9,500 顆星、795 次 fork,PyPI 上累積發布了 186 個版本,最新版 0.6.4 在 2026 年 7 月釋出,issue 與合併請求的活動一直延續到 9 月中旬,是一個明確活著、持續有公司投入的專案,不是那種拿到星星就棄坑的展示品。
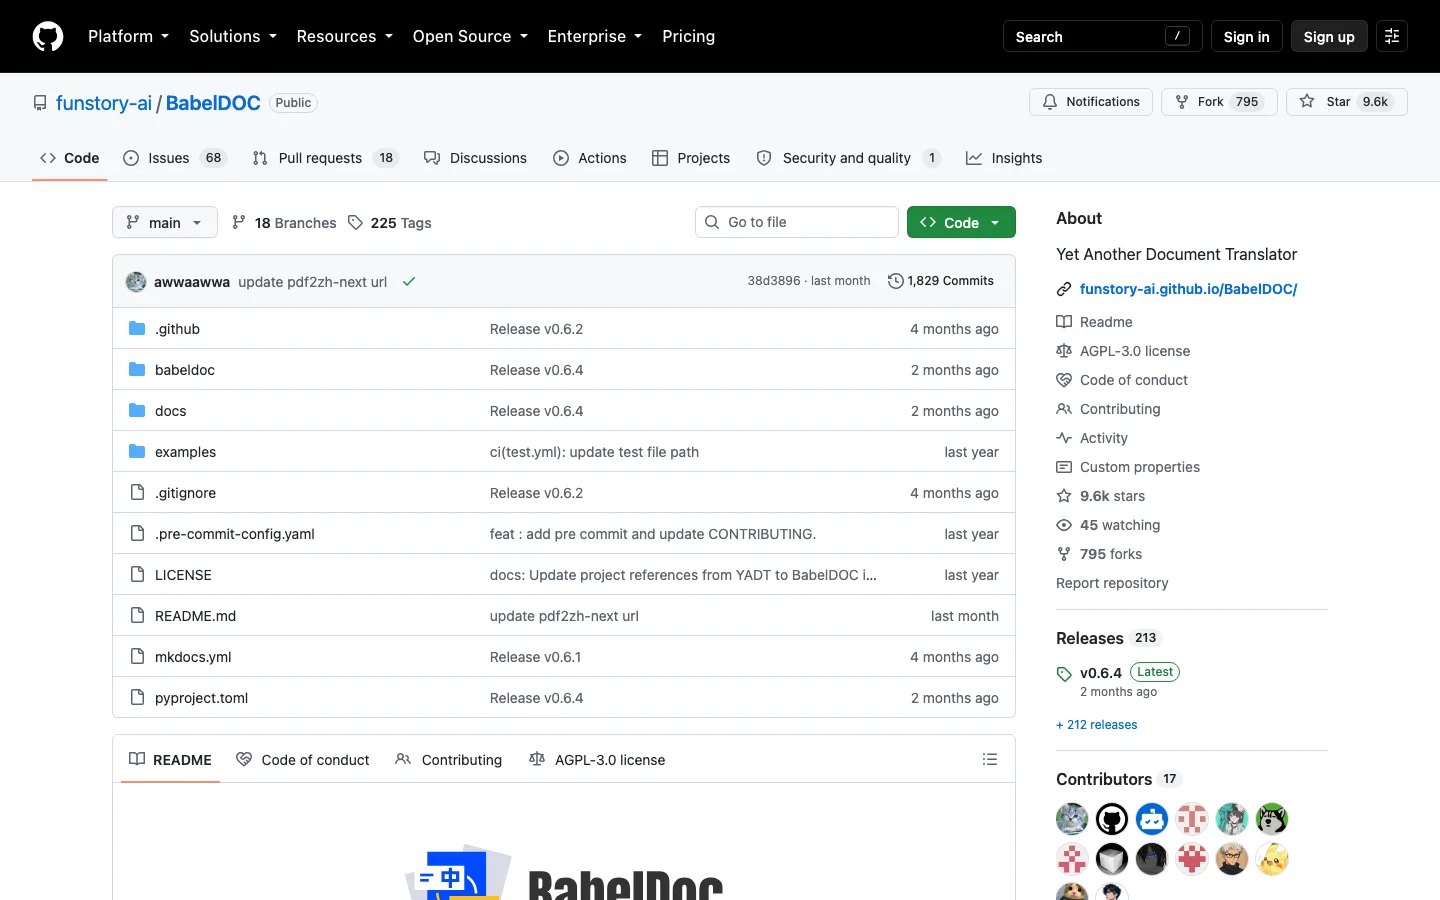
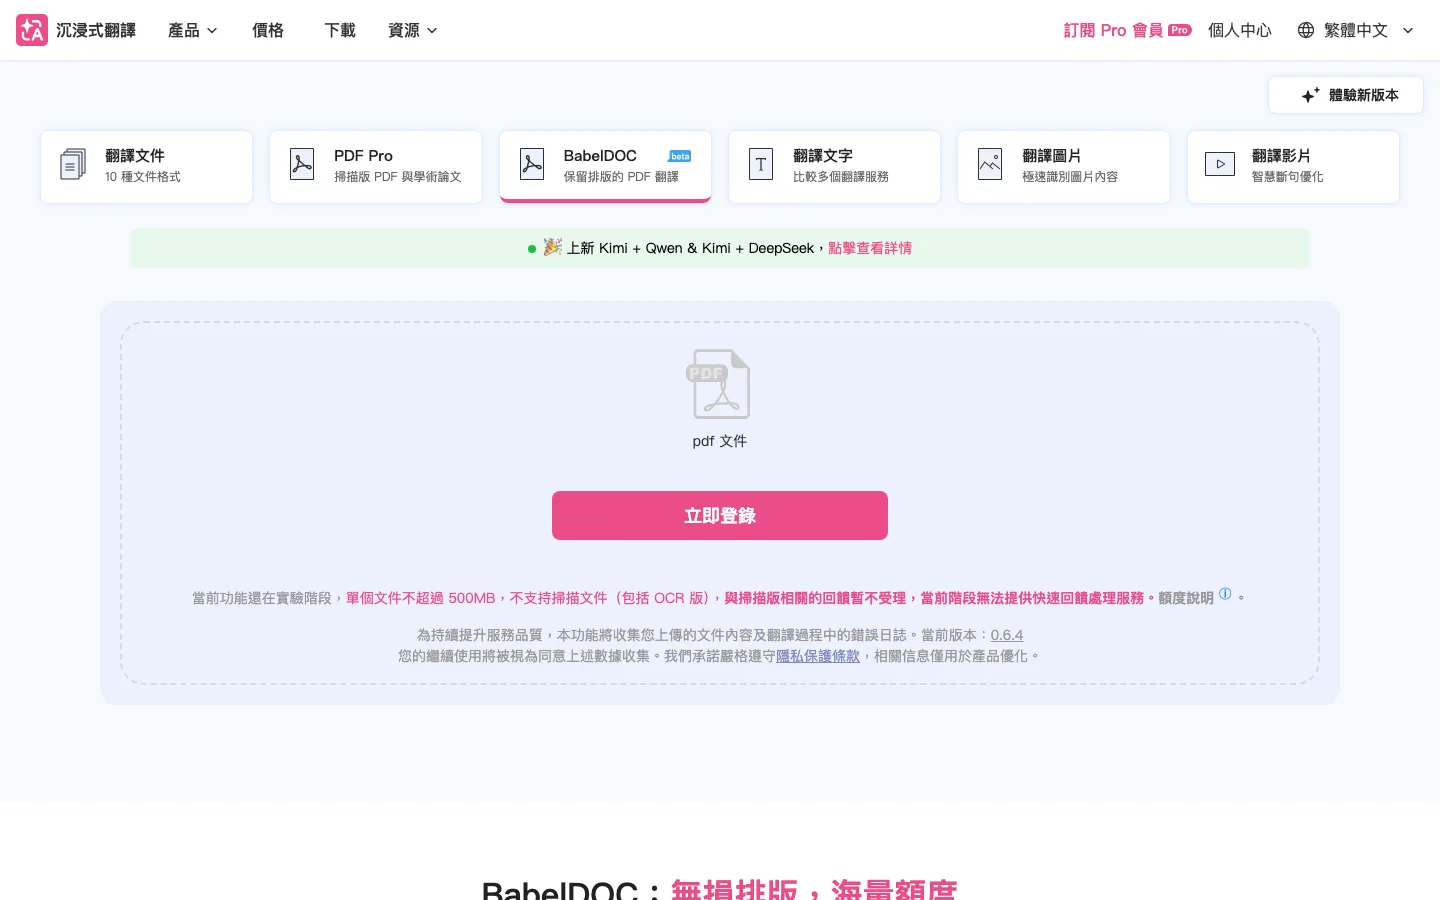
線上版的計費方式在說明頁寫得相當誠實,只是很少有人真的去算。目前的制度是按翻譯過程消耗的 Token 計費:所有人都能用的免費模型是 GLM-4-Flash-250414,每個月附贈 50 萬 Token;Pro 會員每月最高 2,000 萬、Max 會員最高 5,000 萬,計入會員通用額度,Pro 以上的模型清單多了 DeepSeek V4.1 Flash、Qwen3.5-Plus、Gemini-3-Flash 等選項。單次翻譯的頁數上限,免費帳號是 166 頁,Pro 會員放到 5,000 頁。
真正的關鍵在官方自己公布的統計:啟用自動術語提取時,平均每頁消耗約 7,382 個 Token;關閉時平均約 4,703 個。拿 50 萬除回去,免費月額度大致是 68 頁(開術語提取)到 106 頁(關 術語提取)的規模。對照 README 裡那句「線上版每月 1000 頁免費」,數字差了一個數量級,理由不難理解:頁數制是舊的計費方式,README 還沒改,線上服務已經換成 Token 制。網路上流傳的「每月免費 1000 頁」,就是這句過時文件的四處轉載。
還有兩個影響實際用量的規則值得記住。翻譯任務啟動時,系統按每頁 3,000 Token 預扣額度(啟用術語提取加倍為 6,000),完成後多退少補,翻譯失敗全額返還,所以一次丟大檔案不會莫名其妙把額度燒光。另外官方明說表格密集的 PDF 會消耗顯著更多的 Token,術語提取功能預設又是開啟的,想省額度的人可以自己衡量要不要關。
線上版的上傳介面下方有一行小字,值得每個人在丟檔案前完整讀一遍:為持續提升服務品質,本功能將收集您上傳的文件內容及翻譯過程中的錯誤日誌,您的繼續使用將被視為同意。這不是隱私政策裡的抽象條款,就貼在上傳按鈕旁邊,而且講的是文件內容本身,不是去識別化後的中繼資料。對照另一個規則更能看出邊界:翻譯記錄與相關檔案只免費保留 14 天,逾期可能因快取清理自動刪除且無法恢復。你的檔案進得去、它會讀、兩週後理論上會刪,這三件事合起來就是線上版的隱私形狀。
翻譯的架構層面,官方在常見問題裡花了一整節解釋為什麼線上版不支援自帶 API 金鑰:它採用後端翻譯架構,所有翻譯邏輯都在伺服器端執行,若開放自訂端點,使用者得把金鑰交給後端,還有伺服器暴露、併發能力不可控等一串風險。這個解釋技術上成立,但它同時劃清了一條線:想讓文件不出門、想用自己的模型,線上版從設計上就不打算提供,你只能走開源那條路。頁面本身也掛著 Google Tag Manager 與 Rewardful 的推薦系統腳本,這在商業服務裡是常態,只是與「開源工具」的想像有段距離。
把引擎抓到本機跑,是三條路裡最乾淨、也最需要動手的一條。實際在本機以 uv 工具安裝(uv tool install 或 uvx –from BabelDOC),一次帶進 84 個相依套件,安裝後 babeldoc –version 回報 0.6.4,與 GitHub 最新版和線上版介面標示的版本三方一致,安裝路徑本身沒有障礙。真正的門檻在後面:這個引擎目前只支援 OpenAI 相容的大模型 API,命令列參數就三個:模型名稱、API 端點、金鑰,預設模型是 gpt-4o-mini。翻譯的錢和流量都走你自己申請的金鑰,官方建議用相容性好的模型,也明言可以接 Ollama 這類本機模型,金鑰欄填任意值即可,等於離線環境也有解。
自架路線有幾個對學術翻譯很實際的設計。雙語對照有兩種輸出形態,預設是原文與譯文同一頁上下並排,也可以切成原譯交替的分頁模式,搭配閱讀器的雙頁顯示正好左右對照;純譯文與雙語兩種 PDF 都會輸出,不要哪個可以明確關掉。術語控制有兩層:自動術語提取預設開啟,翻譯前先把全文的關鍵詞整理成詞彙表再餵給模型,這也是前面提到額度消耗加倍的來源;你也可以自己準備 CSV 詞彙表,欄位是原文詞、譯文詞,甚至能限定某條術語只套用在特定目標語言,對前後一致性要求高的論文翻譯來說,這比事後手工校對省力得多。
第一次執行前還有一個容易漏掉的前提:版面分析模型、字型與文字映射表這些資產,會在你第一次跑的時候從 GitHub、HuggingFace 或 ModelScope 三個來源裡挑最快的下載,檔案都有 SHA3-256 驗證。公司網路或離線環境可以先產出離線資產包再搬進去,這部分官方文件寫得完整。版面分析本身是在本機跑的(ONNX 推理,macOS 會走 CoreML),翻譯文字才會送進你指定的模型端點,所以資料流向很單純:PDF 不出門,文字內容去你的模型那裡。
浮水印是另一個預設值陷阱。控制參數 watermark-output-mode 的預設值是 watermarked,輸出會蓋上平鋪浮水印,舊的 –no-watermark 參數已標記廢棄,要乾淨輸出得明確指定 no_watermark。對自己出錢跑自己金鑰的人來說,這個預設值值得知道。
如果讀完上一段覺得命令列不是你的工具,那官方給你的答案也很明確:PDFMathTranslate-next。這是 2025 年 12 月才建立的專案,同樣 AGPL-3.0 授權,把 BabelDOC 當引擎,提供網頁介面(Windows 另有免安裝執行檔)與 Docker 部署,翻譯服務支援 DeepSeek、DeepL、Ollama、OpenAI 等更多選擇,正好補上 BabelDOC 只吃 OpenAI 相容 API 的限制。BabelDOC 的 README 把它推薦給需要自架的使用者,PDFMathTranslate 的 Zotero 外掛生態(zotero-pdf2zh)也建立在它之上。以約 681 顆星的規模對比 BabelDOC 本體的 9,500 顆,它還年輕,但這是官方欽定的自架圖形介面路線,不是第三方湊合的包裝。
順帶一提 Zotero 使用者會關心的分流:沉浸式翻譯官方的 Zotero 外掛目前僅限 Pro 會員使用,自架 PDFMathTranslate 生態的外掛則沒有這個門檻。
回到翻譯品質的期望值管理。不少介紹文說 BabelDOC 精準處理公式與表格,對照官方文件,公式混排確實是它的主打能力,但表格是另一回事:命令列的表格翻譯參數還掛著實驗性標籤、預設關閉,完整的表格與線條支援、跨頁跨欄段落,全都還列在未完成的開發路線圖上。README 的已知問題也自列了四條:作者與參考文獻區塊可能被合併成一段、線條不支援、首字下沉不支援、過大的頁面會被跳過。
線上版的已知限制清單更長,挑幾條影響閱讀體驗的:部分公式段落可能重疊、譯文裡傾斜的文字會消失、作者資訊與目錄條目這類小段落可能識別不準、參考文獻區域預設不翻譯、掃描版與 OCR 版 PDF 不支援、不支援下劃線與圖表區域翻譯。手上的文件如果是掃描版,先走 OcrFlux 這類 PDF OCR 轉 Markdown 工具 把文字層救回來,再考慮翻譯會更實際。官方也明說電子書場景適合表格佔比低的,報紙雜誌不在適用範圍。速度方面,50 頁的文件官方說 1 到 5 分鐘、5,000 頁約 1 到 2 小時,這些是站方宣稱的數字,實際表現取決於文件複雜度與伺服器負載。
遇到問題時官方給的急救方案也值得先認識,免得翻壞了以為是自己的錯。如果譯文出現彩色色塊整塊變黑、整頁文字消失、或每個字中間多出空格,這時要開相容模式,代價是停用富文字翻譯、跳過字體子集化與清理步驟,輸出檔案會明顯變大。掃描版 PDF 則有一個明確標了臨時方案的出路:白底黑字的掃描檔可以在譯文下方墊白色矩形蓋住原文,但官方也警告,把這選項用在非掃描檔上可能丟內容,拿捏責任在使用者自己。導出 PDF 特別慢則是正常現象,最後階段的繪製指令清理本來就吃時間,等待就是了。
還有一個好消息:繁體中文(台灣)明確列在官方支援語言表內,而且屬於不依賴連字排版的完整支援等級,引擎原始碼的排版判定期也把 TW 代碼納入中日韓路徑。輸入端目前以英翻中為主要場景,其他語向官方自述尚未充分測試,拿它做中翻英或日翻中之前要有心理準備。

把三層拆開之後,選擇其實變簡單了。偶爾翻幾篇公開論文、不想架任何東西的人,線上版是最順的路,只要記得兩件事:免費額度換算下來約幾十到一百頁,以及上傳的文件內容會被收集,機密文件或未公開的研究手稿不該走這條路。想要完全掌控資料流向、有自己的模型金鑰或本機模型的人,直接跑 BabelDOC 引擎,付出的是命令列操作與額外參數的學習成本,記得調整浮水印預設值。想要圖形介面又要自架的人,裝 PDFMathTranslate-next,它是官方推薦的完整發行版,翻譯服務選擇也最多。
最後是授權提醒:AGPL-3.0 對一般個人使用完全友善,但它的傳染性條款對商業嵌入有實質影響,想把這個引擎接進自己對外提供的服務,先讓法務讀過授權條文再動工。如果你要的其實不是翻譯而是把 PDF 抽成可編輯的文字,PDF2MD 那類轉檔工具才是對口。至於那個流傳的「每月免費 1000 頁」,就讓它留在轉載文裡吧。