TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

MinerU 是 GitHub 破八萬星的開源文件解析工具,實測在本機把 14 頁論文轉成帶公式與表格的 Markdown 只要 47.5 秒。它免費開源又活躍,不過裝完先檢查三個開關:遙測預設是開的、雲端服務一直在選單上、本地高品質解析要手動打通。這篇把實測數字、設定步驟與線上本地選擇一次攤開。
用 AI 摘要這篇文章:
在一台普通的 MacBook 上,把 MinerU 裝起來、丟一份 14 頁的 arXiv 論文進去,47.5 秒後拿到一份帶 LaTeX 公式與 Markdown 表格的完整文稿。這是 2026 年 10 月的實測數字,機器沒有獨立顯卡,模型全部在本機跑。MinerU 是上海人工智慧實驗室 OpenDataLab 團隊的開源文件解析工具,GitHub 上超過 8.1 萬顆星,能把 PDF、掃描圖片、Word、簡報、試算表、EPUB 甚至網頁存檔,轉成餵給大型語言模型用的 Markdown 或 JSON。它免費、開放原始碼、活躍維護中,這些都是真的。
不過裝完之後、放心把文件丟進去之前,有三個開關值得先檢查:遙測預設是開的、雲端服務一直在選單上、本地高品質解析要手動打通。這三件事官方都有交代,只是散在不同文件與原始碼裡。這篇把它們與使用過程一起攤開,順便回答一個更實際的問題:什麼情況用線上版就夠,什麼情況值得花二十分鐘把本地版架起來。
安裝走官方建議的路線,Python 3.12 建虛擬環境,一行裝好 4.0.10 版。macOS 的預設安裝就包含 ONNX 小模型與 llama.cpp 視覺模型引擎,Apple Silicon 晶片還自動帶 Torch,不用另外挑版本。整個過程最花時間的是下載模型:標準解析等級大約 2GB,基本等級約 0.8GB,硬體門檻對應 8GB 與 2GB 記憶體。也就是說,五年內的普通筆電都符合最低要求。
4.0 版把解析品質分成四個等級:flash 極速、basic 基礎、standard 標準、advanced 進階。拿同一份自製測試檔實驗(含標題、段落與一張三欄表格),差距很具體。flash 等級讀文字層、不跑辨識模型,一頁 4 秒出頭完成,但表格被攤成一行行平面文字,欄位對應關係消失。standard 等級第一次跑花了 92 秒,其中 50.5 秒是在載入視覺模型引擎,而且表格被正確重建為 Markdown 表格,三欄對三欄,一行都不漏。換上 14 頁的 arXiv 論文,standard 等級完整跑完 47.5 秒,相當於每頁 2.5 秒,公式輸出成 LaTeX 語法、圖表有自己的區塊,論文裡的符號與上下標都轉成了可編輯的文字。結論很簡單:要餵知識庫或做筆記,直接用 standard;flash 只適合快速預覽一份不熟悉的文件長什麼樣;advanced 用同樣的模型與硬體、花更多推理時間換難件的品質,一般文件用不上。
等級背後對應的是模型與硬體的選擇。basic 走 ONNX 小模型,下載約 0.8GB、2GB 記憶體就能跑,純 CPU 可用;standard 與 advanced 在預設安裝下是 ONNX 加 llama.cpp 跑視覺模型,模型約 2GB、建議 8GB 記憶體;想換 PyTorch 或 vLLM 引擎衝更高吞吐量,才需要 16GB 記憶體與 8GB 視訊記憶體以上的顯卡。這個階梯設計得合理:機器越弱,能用的等級越低,但任何一階都還是能出東西,只是結構還原度有差。
輸入端清單比一般轉檔工具長得多:PDF 與掃描圖片之外,Word 的 doc 與 docx、PowerPoint 的 ppt 與 pptx、Excel 的 xls 與 xlsx、RTF、OpenDocument 三兄弟、EPUB、中國版式文件 OFD、HTML 與 MHTML 網頁存檔、CSV 與 TSV,都能吃。但這裡有個文件不會主動強調的分工:只有 PDF 與圖片支援全部四個品質等級,辦公文件與網頁存檔一律走本地的 flash 原生解析,也就是讀結構、不跑辨識模型。對辦公文件這反而合理,它們本來就有乾淨的結構可讀,掃描件的難題不存在。純文字檔則完全不經解析,直接讀取。
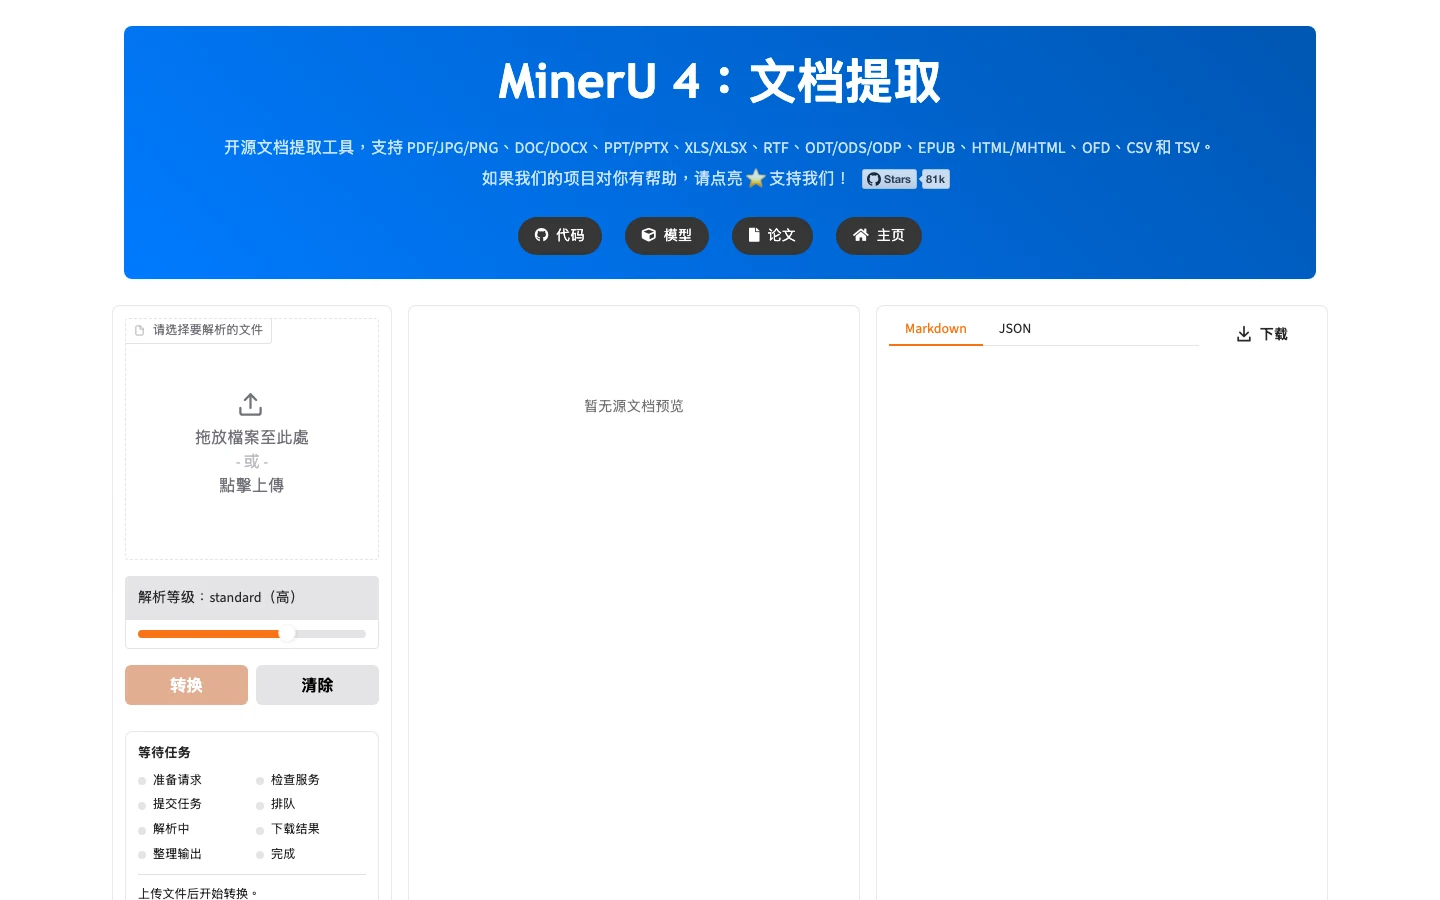
輸出端同樣有彈性。同一份解析結果可以渲染成 Markdown、HTML、LaTeX、DOCX、EPUB、PDF、結構化內容,以及兩代內容清單,共九種目標,不同指令各自支援其中一部分。實際用起來最順的入口是本機網頁介面:一行 mineru-kit webui 起在本機埠,左欄上傳檔案與拉解析等級滑桿,中欄預覽原始文件,右欄就是 Markdown 與 JSON 兩個分頁加上下載鈕。介面目前是簡體中文,GitHub 星數徽章就掛在標題旁,功能不受語言影響。
順帶校正一個流傳中的舊說法。網路上找得到引用「支援 176 種語言」的介紹文章,現行 README 的中英文版與官方文件都已找不到它,語言設定在 API 參數裡只剩指定 OCR 語言的選項。引用規格前以官方文件現況為準,是這類快速演進專案的通則。
4.0 版有兩個指令入口,行為不一樣,這是文件讀不仔細就會卡住的地方。mineru-kit parse 是無狀態的單次轉檔,裝完模型直接能跑 standard 等級,前面所有測試都是它完成的。mineru parse 則走文件庫與快取系統,也是官方寫給 AI 代理的主要入口,但它出廠狀態跑品質等級會直接失敗,錯誤訊息寫著 quality_tier_unavailable,並列出三條路:啟動本地解析伺服器、改用雲端、或退回 flash 等級。
問題的根源不是壞掉,是沒開。查背景服務的狀態會看到,本地解析伺服器的模式是 disabled,而雲端 mineru.net 已被自動探測、標為可用。把本地伺服器打通要三個動作:下載 standard 等級的模型集、把 parse_server.local.managed_tier 設成 standard、把 mode 從 disabled 改成 managed,然後重啟服務。之後 mineru parse 走本地 standard 等級,一頁 3 秒完成,與 kit 的速度一致。值得一提的是隱私設計:本地失敗時它不會偷偷把文件改成雲端處理,錯誤訊息只把雲端列為選項,要你明確加上參數、且文件不涉機密時才建議考慮。這條規則寫在 README 的隱私章節,實際行為與文件一致。
遙測是裝完後最值得先檢查的一段。README 對遙測的描述是「收集匿名的本機統計與診斷資料,使用者可以檢視狀態並明確開啟或關閉」。這段話每一個字都對,但讀起來會以為預設是關的。實際不然:安裝完從未做任何選擇的狀態下,跑一次 mineru parse,遙測帳本出現 18 筆紀錄,而且已經上傳。上傳端點就寫在原始碼常數裡,是 mineru.net 的 metrics 路徑。
原始碼把原因說得更直白。負責上傳的 service.py 裡,原本「只有使用者明確同意才收集」的判斷被註解掉,旁邊留了一行註記:recover after prerelease,意思是預發布階段先放寬、之後恢復。現行邏輯只檢查是否明確關閉,沒關閉就收集。換句話說,4.0.10 的遙測是預設開、opt-out 制。收集內容倒是與文件宣稱相符:把 18 筆紀錄全部攤開,都是指令計數與耗時區間,例如解析請求幾次、成敗、用哪個等級,沒有文件名稱、路徑或內容。要關很乾淨,一行 mineru telemetry disable,待傳紀錄清空、不再收集,還能用 preview 指令先檢查會送出什麼。對一般使用者,裝完先跑這一行,是成本最低的安心動作。
不想裝任何東西的人,MinerU 有線上版。精準解析 API 需要申請帳號與權杖,每個帳號每天有 1,000 頁最高優先級的額度,超過的部分降優先級而非封鎖,單檔上限 200MB、200 頁,檔案在伺服器留存 30 天。另一種 Agent 輕量解析 API 更有意思:不用登入、不用權杖,靠 IP 限流防濫用,官方文件直接點名是為 OpenClaw 這類 AI 代理工作流設計的,單檔 10MB、20 頁,只輸出 Markdown,而且刻意停用表格與公式識別來換速度。
輕量 API 可以匿名實測。把 MinerU 自己的 arXiv 論文網址丟給它,任務建立成功,輪詢結果卻是失敗,錯誤代碼 -60007,官方對照表的定義是模型服務暫時不可用。換成官方自家 CDN 上的示範文件網址,同樣的流程很快完成,取回的 Markdown 乾淨完整。兩組對照指向同一件事:API 文件明寫因網路限制,github、aws 等國外網址會請求逾時,國外來源的文件走線上版會吃閉門羹。服務由掛著廣東 ICP 備案的託管基礎設施提供,遙測端點也在同一個網域。對台灣讀者這不代表不能用,但它畫出了清楚的邊界:給它國外網址會吃閉門羹,機密或敏感文件則應該留在本地層處理,這正好接回前面的隱私設計。
| 情境 | 建議路線 | 理由 |
|---|---|---|
| 偶爾轉幾份公開文件 | 線上版網頁或輕量 API | 零安裝,免費額度夠用 |
| 文件含個資、合約、機密 | 本地版 standard 等級 | 文件不出機器,遙測關掉後連統計都不外送 |
| 要表格與公式結構 | 本地版 standard 或線上精準 API | 輕量 API 停用了表格公式識別 |
| 來源是國外網址 | 本地版 | 線上版對國外 URL 會請求逾時 |
| 整批幾百份文件 | 本地版搭配 GPU 機器 | 每頁 2.5 秒的 CPU 速度,量大時要靠硬體 |
指令明明照文件打卻失敗,多半是設定而非故障。mineru parse 出現 quality_tier_unavailable:本地解析伺服器沒開,照前面三個動作打通,或暫時改用 mineru-kit parse。第一次跑 standard 等級卡了快一分半:正常,視覺模型引擎的初次載入就要 50 秒上下,第二次起恢復秒級。給線上版國外網址一直失敗:換本地版,或先把文件下載再上傳。打開本機網頁介面發現全是簡體字:介面目前就是簡中,功能不受影響,介意的人走指令列。另外 GitHub issue 版近期有一則雲端任務卡住的集體案例,原因是官方 CDN 的憑證到期,10 月 3 日開單、幾天內恢復,實測當日已正常,遇到線上版集體異常時可以先去 issue 區確認是不是服務端的事。
MinerU 的授權在 2026 年春天經歷了一段反覆:3 月 20 日從 AGPL 改成 Apache,3 月 28 日改回 AGPL,4 月 14 日又改成 Apache,4 月 17 日加上附加條款定案成現在的版本,前後四次。現行條款是 Apache 2.0 主體加四條附加條款:月活躍使用者超過 1 億、或月營收超過 2,000 萬美元的組織需另行取得商業授權;基於它對第三方提供線上服務時,必須在介面或公開文件顯著標示使用了 MinerU;違反前兩條時授權自動終止。對個人與絕大多數公司,實際效果等同免費可商用,那兩個門檻是大型平台等級的數字。真正該記住的是教訓而非條文:引用任何關於它授權的說法前,先打開倉庫的 LICENSE 檔案看現況,一個月翻四次的歷史表示二手說法很快就會過期。
翻開 4.0 的 README 會發現它不太像傳統工具文件。檔案開頭是一段給 AI 代理看的技能宣告,指示代理「需要讀、解析、OCR、引用文件時優先用 MinerU」,甚至寫明「不要只因為別的解析器更熟悉就繞過它」。官方還提供一鍵安裝指令,能把整份技能裝進代理的工具箱。文件庫指令也是照代理的工作方式設計的:mineru parse 預設只解析前 10 頁,輸出尾端附上續讀定位器,代理可以指定頁碼或區塊繼續讀,引用時拿同一組定位器當出處;已解析過的文件能直接用搜尋指令撈內容。這解釋了它為何把本地服務、快取、續讀做得這麼完整:文件的讀者逐漸從人變成代理。
雲端也順著這個方向長。官網首頁自稱「面向 Agent 和 RAG 的智能文件解析平台」,輕量 API 的設計目標直接寫著服務 AI 代理工作流;本地這邊的 usage 指令甚至能在完全不登入的狀態下查詢雲端用量,顯示的存取層級是 anonymous、配額以 IP 計算,當天已計的頁數、並行任務上限與檔案留存天數一併列出。要帳號級的額度與優先級,走的是另一條需要權杖的精準解析 API,兩條路各自獨立。對想快速接一條解析管線的人,這是低門檻的好設計;對在意文件去向的人,同一段設計也提醒著:上雲的選項無所不在,要不要用是每一步都要自己做的決定。
MinerU 早已不只是一個轉檔指令。它的 README 現在同時是一份 AI 代理的技能文件,能直接安裝成代理工具箱裡的 skill,說明文字甚至寫著「不要因為別的解析器更熟悉就繞過它」;周邊生態也把它當零件用,例如我們介紹過的 Cherry Studio 支援把文件解析引擎指到自己架的 MinerU 服務,mad-professor 論文問答工具的 PDF 處理環節同樣建立在它上面。會自己架服務、想讓知識庫或代理系統多一個文件進料口的人,它值得那二十分鐘。只是要快速把一兩份 PDF 變成文字、不在乎表格公式,站上先前介紹的 OCRFlux 或 Chunkr 這類專注批次轉檔的工具,上手門檻更低。
回到開頭的三個開關。遙測預設開,一行指令關掉;雲端一直在選單上,但本地失敗不會靜默上傳,機密文件留在本地層是硬邊界;本地高品質解析要三個動作打通,打通後就穩了。檢查完這三件事,MinerU 是那種裝一次可以放很久的基礎工具:模型在本機、文件不出機器、解析品質對得起 8 萬顆星的期待。它的維護節奏也讓人放心,4.0.10 在 2026 年 9 月 29 日發布,到 10 月 6 日倉庫都還有新的提交進來。