TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Zerox OCR 用視覺模型把 PDF 與 Office 文件轉成 Markdown,MIT 開源、模型自選、支援結構化欄位抽取。實測本機拆頁管線完整可用,但母公司已轉型金融 AI、主分支停更逾一年,採用前需要鎖版本、fork 自養並避開外部網址輸入。
用 AI 摘要這篇文章:
我在這台 Mac 上把 Zerox OCR 裝起來跑過一輪:套件裝得動、本機的文件拆頁管線完整可跑,一頁 A4 的 PDF 從拆頁、方向偵測到聚合輸出,1.5 秒內走完。但同一輪測試也確認了另一件事:它 README 裡叫你去試的官方示範頁,現在打開是 404;開發它的公司 OmniAI 已經整個轉型做金融業的對話式 AI;原始碼主分支停在 2025 年 5 月,一年四個月沒有任何 commit;還有一個 2026 年 6 月就被通報的命令注入漏洞,到今天沒有人回應。
先把結論說完:Zerox OCR 是一套「能用,但已經沒有上游」的開源組件。想把它接進自己文件流程的人,要把它當成接手一套無人維護的程式碼來評估,而不是當成一個有人支援的產品。
Zerox OCR(GitHub 上叫 getomni-ai/zerox)做的事情可以用一句話講完:把 PDF、Word、投影片這類文件先在本機拆成一張張頁面圖,再把每一頁丟給視覺模型,換回 Markdown 回來。MIT 授權,Node 和 Python 兩種套件都發過,npm 上叫 zerox,PyPI 上叫 py-zerox。
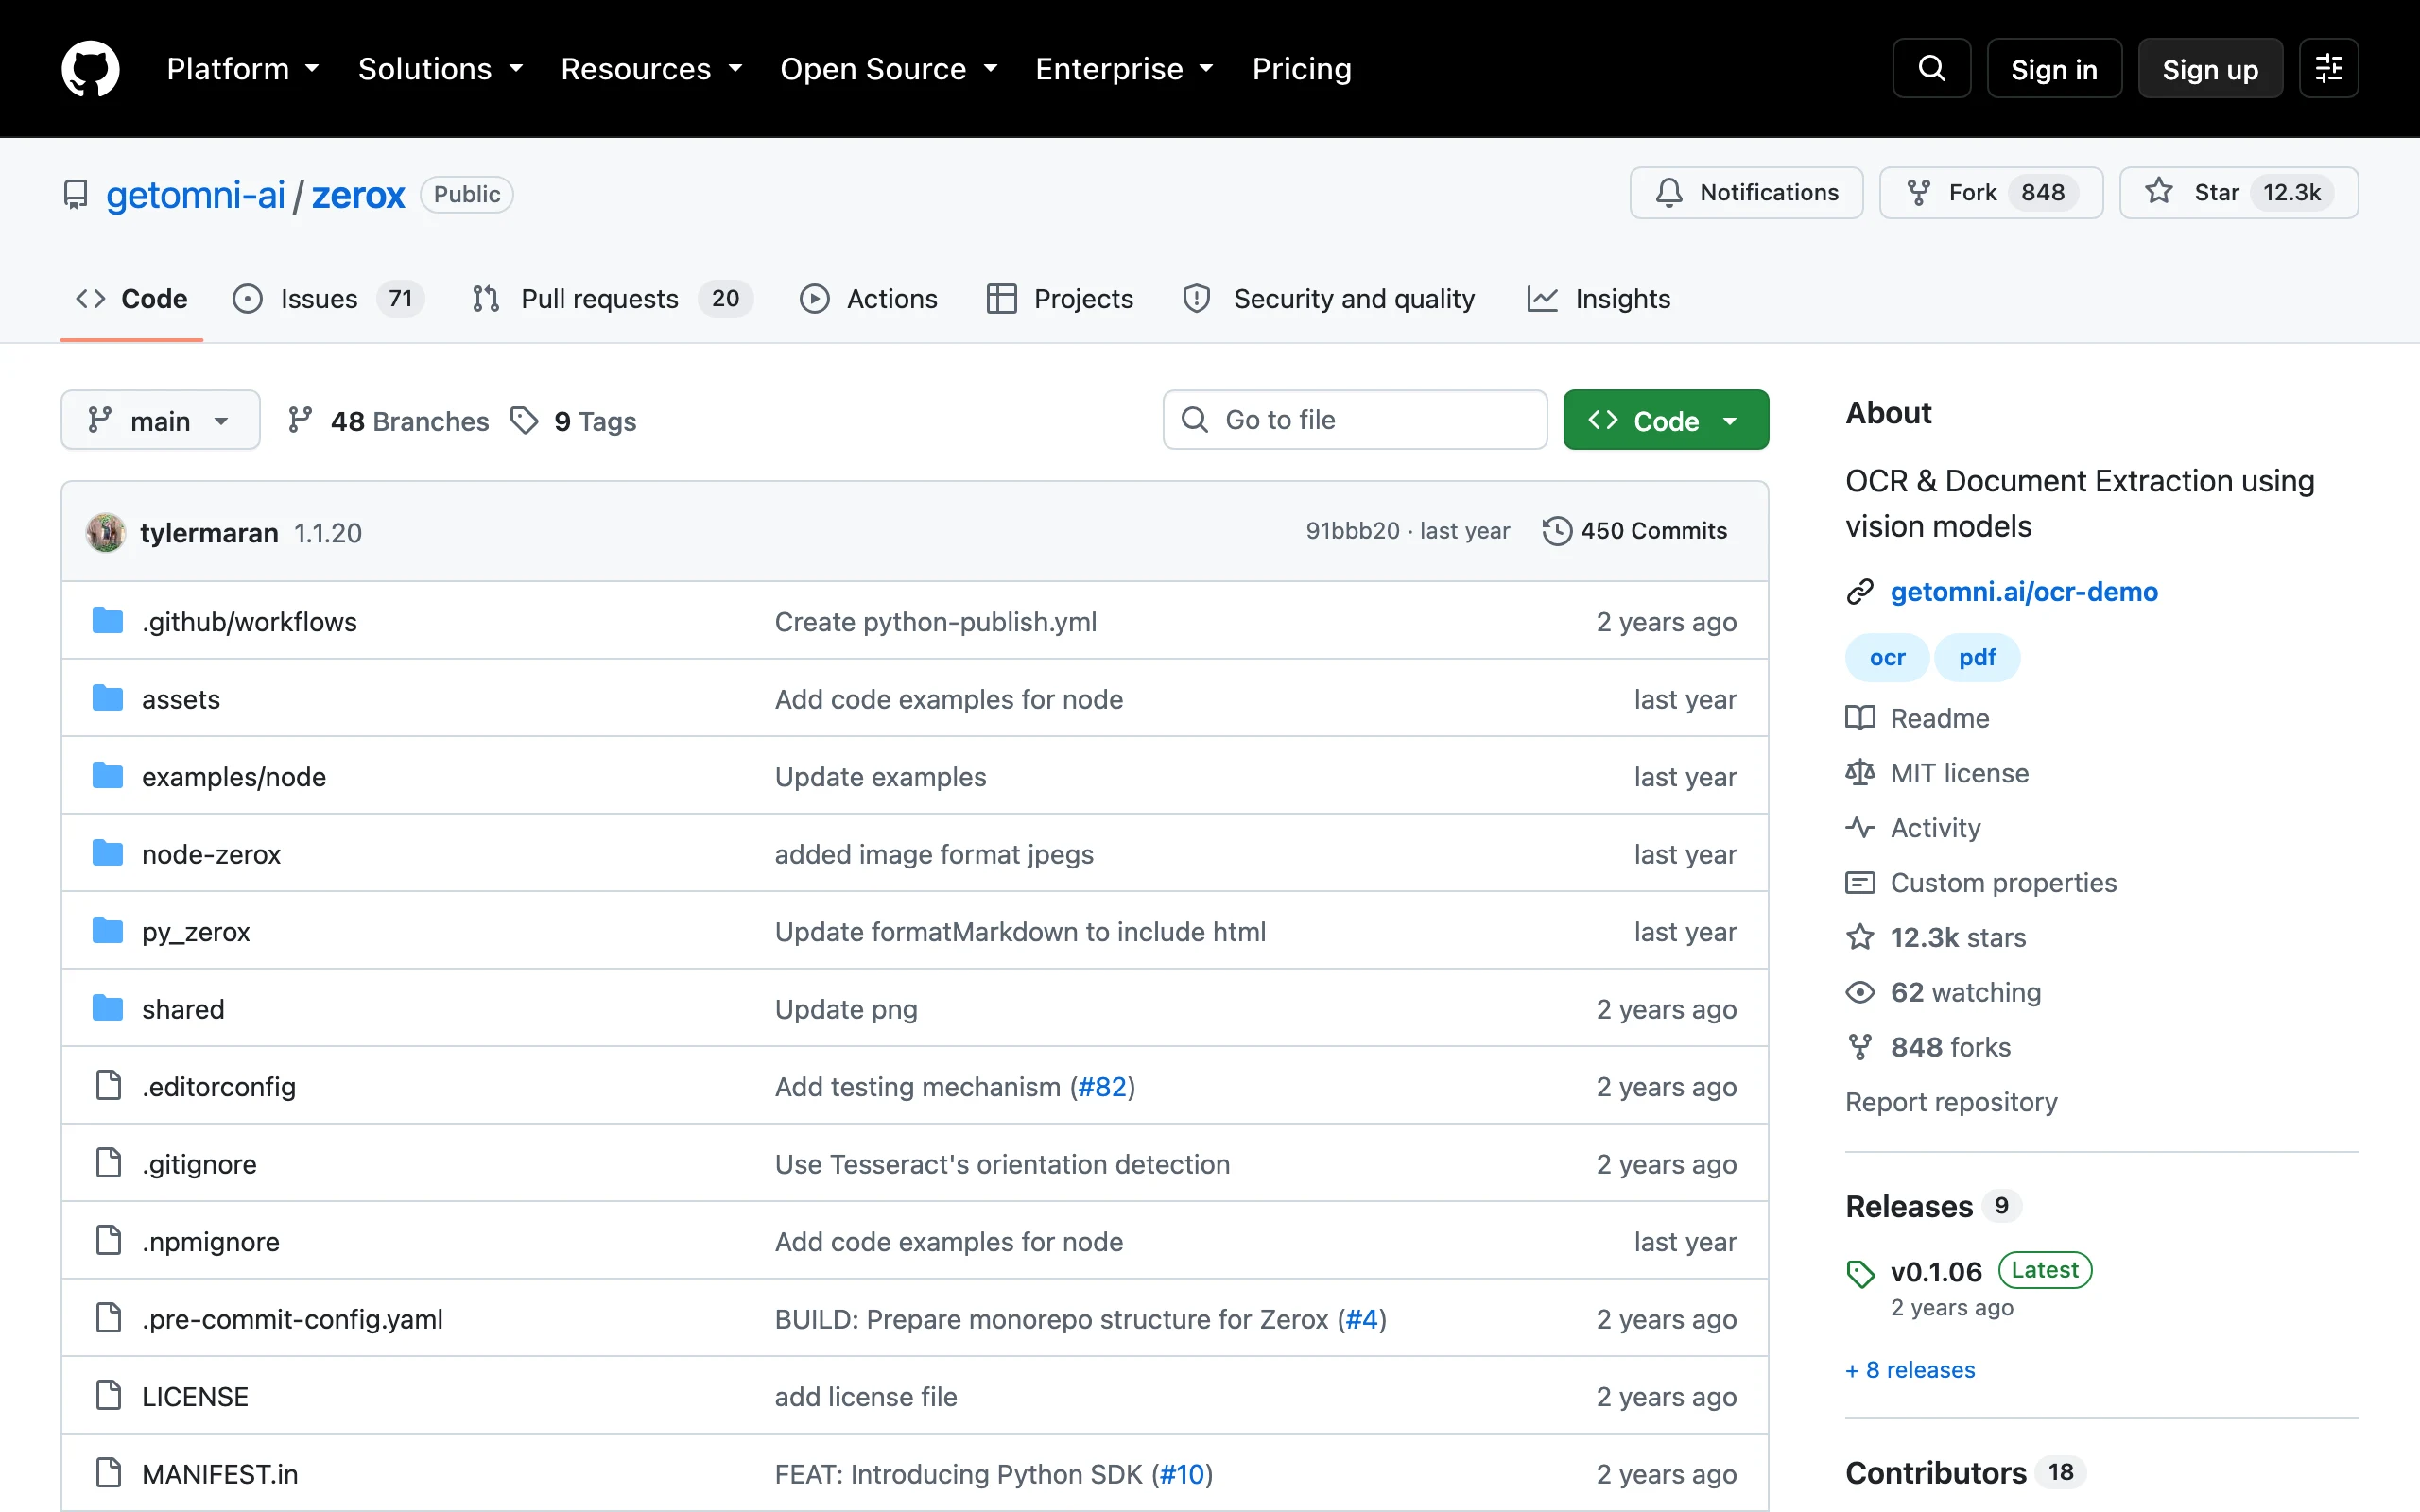
它的核心價值判斷我認為是對的:文件的版面本來就是給人「看」的,表格、圖表、多欄排版這些東西,傳統逐字辨識的 OCR 很難還原結構,而視覺模型天生就在讀版面。Zerox 把「拆頁」和「叫模型」這兩件雜事包好,讓你用十行程式碼把任何視覺模型接進文件處理流程,模型換掉邏輯不用改。
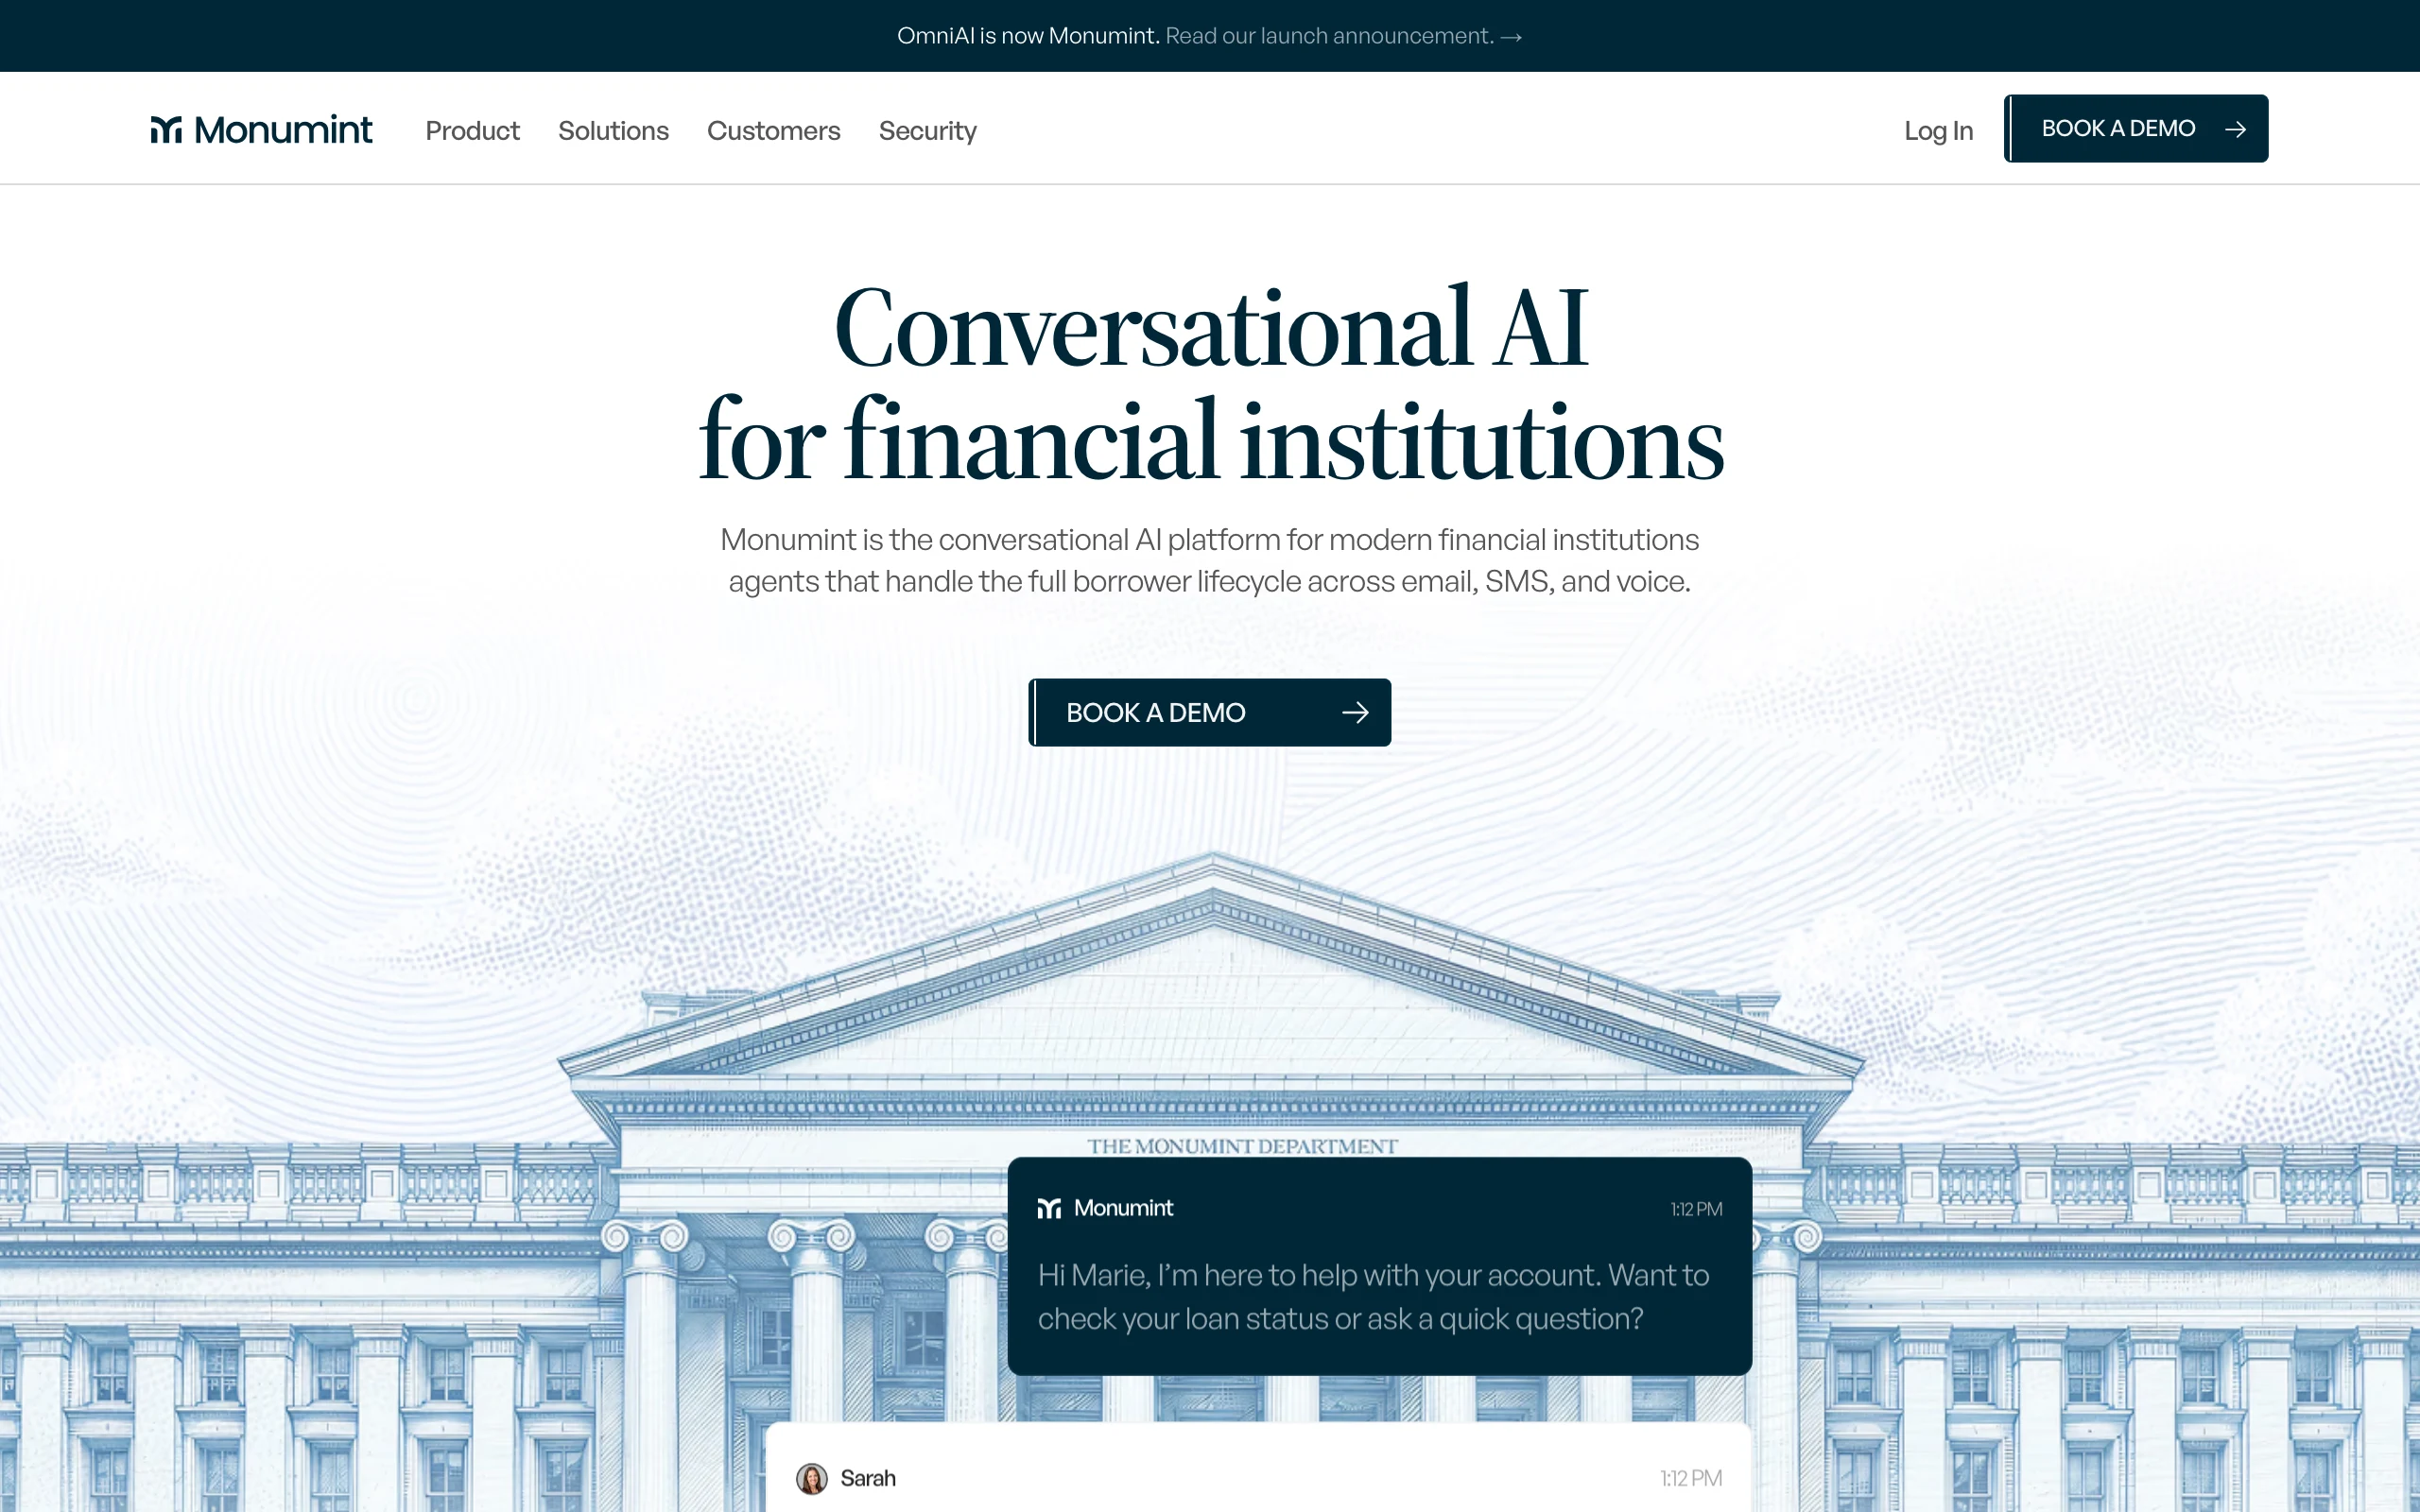
問題出在它背後的公司。Zerox 是 OmniAI 這家新創的開源門面,官方還經營過一個文件智慧平台與託管版服務。現在打開 getomni.ai,伺服器直接把你轉到 monumint.com,頁面上方的公告寫著「OmniAI is now Monumint」,產品定位變成「給金融機構的對話式 AI 平台」。文件這條產品線,公司已經用行動回答了去留。
我實際做的測試在這個層級:npm 安裝 1.1.20 版、讀完整份原始碼、用套件自己提供的 customModelFunction 擴充點把「叫模型」這一步換成固定回傳,跑完整條本機管線。真正的模型呼叫我沒有跑(那需要 API 金鑰,也會花錢),所以 OCR 的輸出品質不在這篇的實測範圍,這點先說清楚。
安裝這關要先過:它對系統的依賴比 npm 套件看起來重。npm install zerox 的安裝腳本會檢查四個系統套件,缺了就直接呼叫 brew 或 apt 自動安裝,清單包括 Ghostscript、GraphicsMagick、Poppler,以及整套 LibreOffice。在我的 Mac 上跑 PDF 拆頁,實際用到的是 GraphicsMagick 加 Ghostscript。這在個人機器上是方便,在正式環境或 CI 容器裡就是一件要事先規劃的事:你要嘛預裝,要嘛用 --ignore-scripts 安裝再自己處理依賴,不然部署腳本會在你沒同意的情況下裝一套辦公軟體。
管線本體倒是健康的。我拿倉庫自帶的樣本 PDF(單頁 A4 課本)跑全流程,暫存目錄裡確實出現了拆好的頁面圖,解析度 1448×2048、696KB 的 PNG,接著壓縮、方向偵測、聚合輸出全部走完,單頁全程 1.5 秒左右。這裡有個小發現:1.1.20 版輸出的 Markdown 檔名是一串 UUID,不是原始檔名,因為套件會先把輸入檔複製成隨機檔名再處理;README 上「輸出檔名等於原始檔名」的範例是舊版行為。批次處理的人要自己保留檔案對應關係。
最容易踩坑的行為藏在失敗處理:模型呼叫失敗時,預設行為是安靜吞掉。我把模型呼叫換成會失敗的函式跑一次,console 印出重試訊息後,那一頁的結果是空字串,整體呼叫不會拋錯,回傳的頁面物件帶著 ERROR 狀態,失敗數只記在 summary 統計欄位裡。換句話說,如果你的模型額度中途用完,跑完表面上是成功的,實際上可能有一半頁面是空的。用它排大批文件的話,跑完檢查 summary.ocr.failed 和每頁狀態是必做功課,或者直接把 errorMode 設成 THROW 讓它失敗就停。
拆開看,整條流程是四段:
資料流向要看清楚:拆頁、轉正、去白邊都發生在你的機器上,但文件內容最後是以整頁圖片的形式離開本機,送到你設定的模型供應商。OpenAI 路線的端點直接寫死在程式碼裡(api.openai.com),Azure、AWS Bedrock、Google Gemini 是另外三個內建選項。這是「前處理本地、理解在雲端」的架構,不是本機 AI。
兩個設計我覺得聰明:maintainFormat 會把前一頁的輸出當成下一頁的上下文,跨頁表格的欄位不會對不齊,代價是逐頁排隊、速度慢一半以上;customModelFunction 讓你把「叫模型」整步換成自己的函式,任何模型、任何代理、任何本地服務都接得上,這也是我這次能不花一毛錢跑完整條管線的原因。
另外兩個功能的歸屬要分清楚。結構化抽取(給一份 JSON Schema,直接抽出欄位而不是全文 Markdown)只在 Node 版有;README 開頭說支援 Anthropic 模型,但 Node 版的供應商清單裡其實沒有 Anthropic,想用 Claude 得繞道 AWS Bedrock,直連 Anthropic 是 Python 版靠 LiteLLM 才有的路。中文圈介紹文常把兩個版本的功能清單混在一起講,採用前建議對著自己要用的那個版本原始碼確認。
結構化抽取是 Node 版真正實用的差異化功能,值得多看一眼。場景是固定版型的文件,例如每張發票都要抽出「廠商、日期、總金額、稅額」四個欄位:你給一份 JSON Schema,設 extractOnly 就跳過全文 Markdown,直接回填欄位;extractPerPage 可以按頁抽,抽取用的模型也能和 OCR 分開設(例如拆頁用貴的、抽取用便宜的)。跑合約審閱、報銷單 Key-in 自動化這類管線,這個功能比「轉出漂亮的 Markdown」更接近真正的業務價值。
兩個版本的命運也不同步。Node 版凍在 2025 年 5 月的 v1.1.20,Python 版(py-zerox)更早就停了,PyPI 上最後一版 0.0.7 是 2024 年 10 月發的,依賴的 LiteLLM 介面這兩年變了不少,裝起來能不能跑要自己試。社群裡也留著一條 2026 年 3 月的 issue,明白列出 Python 版缺 errorMode、方向修正、邊緣裁切這些 Node 版功能,一樣沒有人接。
最反常的一個數字對比:這個專案在 GitHub 上有 12,264 顆星(截至 2026 年 9 月),npm 套件過去一個月的下載量是 2,155 次,星數是下載量的五倍多。對照組更殘酷:它的底層依賴 tesseract.js 同一週的下載量是 211 萬,兩者差了三個數量級以上。
這個落差不只代表「很多人按了星就走了」,它還意味著:你以為踩到坑會有一個社群和你一起扛,實際上活躍使用者可能比你想像的少很多。中文圈的介紹多半把它直接當成品完整的現成工具推薦,但它的官方示範頁(getomni.ai/ocr-demo)現在是 404,官方文件站(docs.getomni.ai/zerox)也是 404。網際網路檔案館的快照顯示,示範頁最後一次正常運作是 2026 年 1 月底,而且當時頁面標題已經換成「AI Agents for Lending」,公司那時就在收撤退的攤了。
時間線排開來看更清楚:
一個一年四個月沒有 commit 的專案,配上一份每個連結都在的 README,就是這篇標題說的樣品屋:外觀完好,水電已停。
我的解讀(這是編輯推論,不是官方說法):Zerox 本來是公司拿來展示「文件 AI 能力」的行銷前門,開源累積了星數和口碑,真正的營收預期在託管平台。當公司把方向整個轉到金融對話 AI,前門就沒有存在理由了,但 GitHub 倉庫留著不傷什麼,於是變成現在這個狀態:程式能用、帳號還在、人走了。這種「行銷開源」的宿命不只在這個專案上演,挑開源組件時看一眼「背後是誰、靠什麼活」永遠值得。
「沒人維護」聽起來抽象,落到底下來是三件具體的事,件件都有編號可查。
最重的一件是安全。2026 年 6 月,有研究員在 issue #206 通報:Zerox 處理 PDF 時會把檔案路徑直接串進 shell 命令列執行 pdfinfo 和 pdftoppm,而檔名裡的副檔名來自你傳入的網址。一個精心構造過的網址,可以讓伺服器在拆頁之前就執行別的指令。我對著原始碼確認過,對應的呼叫確實是字串插值進 shell 的寫法,通報屬實。修法不難(改成不經 shell 的呼叫方式),甚至已經有人提交了修復 PR,但它就停在那裡。對「只丟自己內部檔案」的個人用途,這個漏洞觸發條件不容易湊齊;但如果你打算做一個讓使用者丟網址上來的服務,這一條就是不能上線等級的風險。
另一個會咬人的地方是依賴老化。我在乾淨環境裝了一次並跑 npm audit:6 個依賴漏洞,其中 3 個高等級,包括 SheetJS 的已知漏洞(原型層級的攻擊面與拒絕服務兩類)、sharp 影像庫底層的幾個 CVE。這些都能自己升級解決,但 SheetJS 官方早已退出 npm,正規修法會動到套件結構,等於維護工作落在你身上。
日常最常碰到的是模型清單凍結。內建的模型選單停在 2025 年春天:GPT-4o、GPT-4.1、Claude 3、Gemini 1.5 和 2.0。好消息是 model 參數的型別是「列舉或任意字串」,直接傳新模型的名字就行,架構沒有被鎖死;壞消息是任何新模型都沒有上游幫你驗過,提示詞對新模型的效果要自己測。順帶一提,npm 套件的描述還寫著「用 gpt-4o-mini 做 OCR」,但程式碼的預設模型其實是 gpt-4o,這種文件與程式脫節的小地方,整個專案還有不少。
把 Zerox 放回同類工具裡看,它的位置很明確:比本地 OCR 聰明,比雲端文件服務便宜但費工。
和 RapidOCR 這類本地 OCR 引擎比,差異在「理解」和「成本」的交換。本地 OCR 不花 token、檔案不出門,但表格、多欄、圖表這類版面要自己寫後處理去救;Zerox 直接靠模型的版面理解輸出 Markdown,代價是每一頁都要付視覺模型的錢,而且文件內容會離開你的機器。官方 README 的範例數字是單頁發票消耗 25,543 個輸入 token(這是官方宣稱,不是我實測的),照這個量級,幾百頁的文件一批跑下來,帳單要先算過。
和專做 PDF 轉 Markdown 的工具比,例如 OCRFlux 或 pdf2md 這類開箱即用的方案,Zerox 給的不是「一個轉檔工具」,而是「一條你自己組裝的管線」:模型你挑、提示詞你改、抽取 schema 你定、失敗重試你自己寫。要的是彈性和成本控制,付出的是組裝和維運工。
如果看完以上你還是想用(我認為特定的團隊確實該用),三道自保線先把好:
適合接手的人:已經在用視覺模型 API、有固定的大量文件要轉 Markdown 或抽欄位、有工程人力維護一條自己的管線。不適合的人:想要開箱即用、期待遇到 bug 有人修、或者要處理不可信來源文件又沒有安全審查能力的團隊,這種情況下找一個活著的商業服務或改用本地方案都更合理。
環境需求:Node 18 以上(我在 Node 26 測的),PDF 流程需要 GraphicsMagick 和 Ghostscript,非 PDF 的 Office 格式需要 LibreOffice,Python 版(py-zerox)則需要 Poppler。macOS 上 brew install graphicsmagick ghostscript 就夠跑 PDF 和圖片。
npm install zeroximport { zerox } from "zerox";
const result = await zerox({
filePath: "./contract.pdf", // 本機路徑或網址都可以
credentials: { apiKey: process.env.OPENAI_API_KEY },
model: "gpt-4o-mini", // 任何模型名稱字串都可以
concurrency: 10, // 一次跑幾頁
errorMode: "THROW", // 建議改 THROW,別讓失敗安靜溜過
outputDir: "./out",
});
console.log(result.summary); // 跑完先看這裡金鑰透過環境變數帶入,四家供應商(OpenAI、Azure、Bedrock、Gemini)各吃自己的 credentials 欄位。想先不花錢驗證流程接得通,可以把 customModelFunction 換成固定回傳的函式,管線會完整跑一遍,只有「叫模型」是假的。
Zerox OCR 是免費的嗎?
套件本身 MIT 授權,免費。但每一頁文件都要呼叫視覺模型,那是 API 帳單。官方範例的單頁消耗約兩萬五千個輸入 token,大量使用前先用十頁樣本算一下自己的單頁成本。
可以用最新的模型嗎?
可以。model 參數接受任意字串,清單凍結只影響下拉選單裡的名字。但上游沒有用新模型測過,提示詞效果要自己驗證。
我的文件會被上傳到哪裡?
每一頁會轉成圖片,送到你設定的模型供應商端點。拆頁和轉正在本機,辨識在雲端。機密文件的場景,這條邊界要先過內部規範那一關。
跟 Tesseract 這類傳統 OCR 比,該選哪個?
免費、離線、隱私優先,選本地 OCR;要表格和版面結構、能接受付費和資料出機器,選 Zerox 這條路。兩者也常串著用,Zerox 自己就用 Tesseract 做頁面方向偵測。