TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

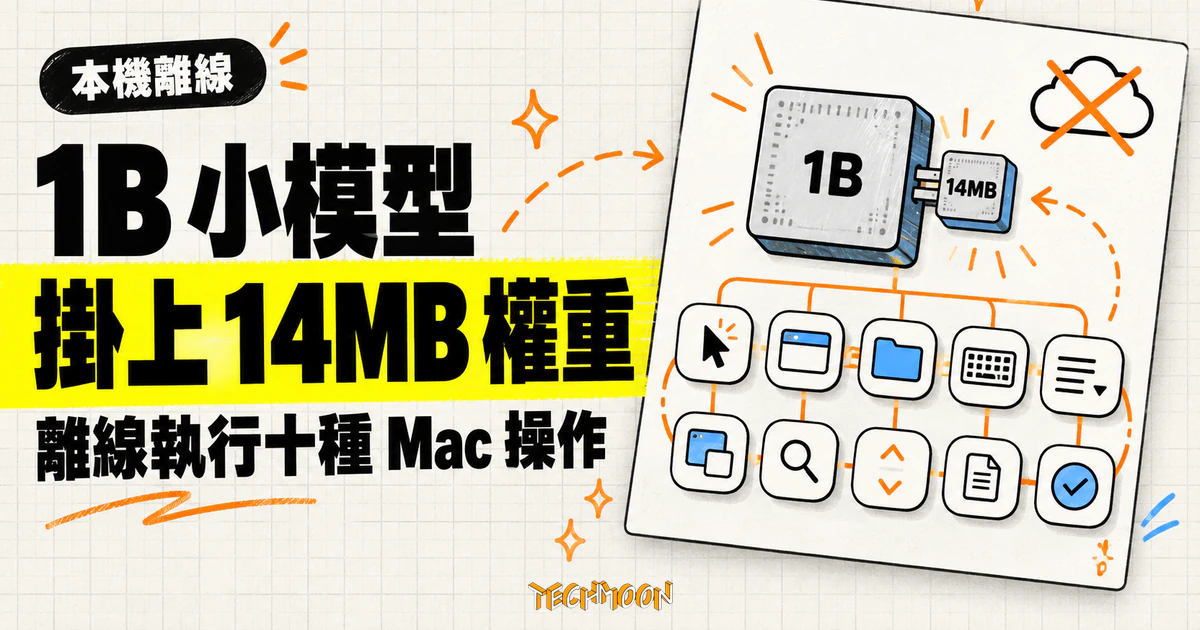
Fuel Labs 開源 HobbyLM-1B Computer Use:14MB LoRA 附加權重掛上自家 10.4 億參數 MoE 小模型,在 MacBook Air 用 Apple MLX 離線把英文指令變成十種固定 Mac 操作,從計算機、亮度、計時器到確認後寫入行事曆。0.26 秒是 262 個決策回放的中位數、實機均值 0.81 秒,13 倍提速橫跨框架與版本兩個變數;模型卡同時公布四輪封存測試 72% 完成率與兩條未達標的預註冊門檻,商用前還要看計算機元件的 BSL 授權邊界。
用 AI 摘要這篇文章:
想把「幫我開個資料夾」「設個七分鐘計時器」這種小事交給 AI,目前的主流答案是雲端代理:月付訂閱、指令送上伺服器、模型再看著螢幕截圖決定下一步。10 月 23 日傍晚到晚間(台北時間),自稱獨立 AI 研究室的 Fuel Labs 在 Hugging Face 發布了另一種答案:HobbyLM-1B Computer Use,一個總量約 10.4 億參數的小模型,掛上 14MB 的附加權重後,直接在 MacBook Air 上把英文指令變成 Mac 操作,全程不連網。宣布貼文裡最受矚目的一句話是:Wi-Fi 關掉,模型照樣從聯絡資訊裡找到人名、算出是哪個週日、照時區設好時間,問一次 y/n,就把行程加進行事曆。
同一段展示裡還有一串更日常的指令:「600 分給四個人」打開計算機算出 150、「螢幕太暗」調高亮度、「聲音太刺把它關小一點」降音量、「開深色模式」、「我需要記點東西」開備忘錄、「七分鐘煮蛋計時」、「抓個截圖」存到桌面。唯一的拒絕示範是問明天天氣,模型回「這件事我離線做不了」。
它不是第一個號稱會操作電腦的代理。Cursor 讓代理改完程式後自己操作電腦驗收,走的正是把整台機器交給模型的路線。HobbyLM-1B Computer Use 反其道而行:把模型能寫出的動作限死在十個,把基底模型的聰明程度降到最低需求,再把所有測試紀錄連模型一起公開。這份發布真正值得看的,是它把幾個行銷數字背後的量法全部攤開了。
整個系統分兩層。底層是 Fuel Labs 自家訓練的 HobbyLM-1B Instruct:稀疏混合專家架構(MoE),64 個專家裡每個 token 只啟用 8 個,總參數 1.037B、實際動用約 3 億;連 MMLU 都只拿 24.78 分、貼近四選一猜測值,是個不靠聰明取勝的小底盤。它在自家模型卡上有幾個很硬的條件:只吃 float32 精度(把路由器換成 bf16 會改變選中的專家)、上下文 4,096 token、透過 transformers 載入時要開 trust_remote_code。上層是一個 LoRA 附加權重(Low-Rank Adaptation,只訓練插在原模型上的小矩陣、不動原始權重),rank 16、覆蓋 83 個模組,MLX 版本佔 14MB。訓練時基底全部凍結,連專家路由器都不更新,損失只算在動作 token 上。
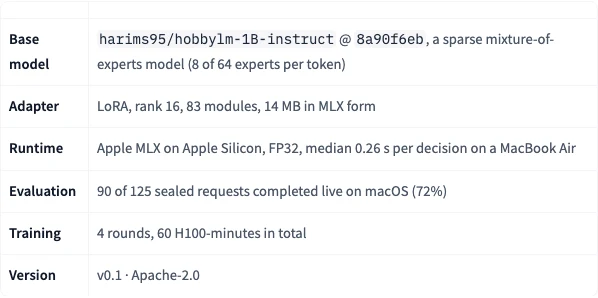
模型每一輪只做一件事:讀使用者的請求和 Mac 當下狀態(計算機顯示、前景 App、亮度、音量、外觀),然後從固定詞彙表裡寫出「下一個動作」。這份詞彙表在發布的原始碼裡逐字可查:開啟計算機、備忘錄、行事曆等六款 App;在計算機裡打字;亮度與音量五個按鍵;深色模式開關;打開下載、桌面、文件三個固定資料夾;設計時器;截圖;新增行事曆事件;結束(DONE)與拒答(UNKNOWN)。一次任務最多六步,模型寫 DONE 才算完成。
模型卡附了一段實錄,看得出每一秒花在哪裡。使用者說「600 分給四個人」,0.3 秒後模型寫下「開計算機」,系統回報「計算機已開啟」;再 0.3 秒寫下「輸入 600/4=」,系統回報「顯示從 0 變成 150」;再 0.2 秒寫 DONE,任務結束。算術是計算機算的,模型只負責決定按哪些鍵,這也是它敢用小模型的原因之一。
執行前還有一道閘:動作先經允許清單驗證,不在清單上就拒絕執行。會動到對外通訊的只有行事曆一項:事件會完整列出標題、日期、時間、時區與受邀者,使用者按了 y 才真正寫入,而且只有指令裡點名的人才會被邀請。若事件帶 email 地址,邀請函由使用者自己選的行事曆帳號發出,模型離線與否和這封信無關。時間的處理也有明確規則:指令沒指名時區時,用 Mac 自己的時區;指名了(例如 IST),就照指名的換算。
「whatsapp 某人說晚餐八點」「明天天氣如何」這類請求,模型的標準答案是 UNKNOWN,回一句「這件事我離線做不了」。範圍外的請求被當成一種要練習的技能在訓練,不是故障。
發布的測試紀錄顯示,這套能力是 10 月 20 日到 21 日兩天內分四輪練出來的。每輪都從基底模型出發,訓練素材是合成的「狀態加請求,配下一個正確動作」單步決策,總計 26,469 筆;每輪各用一張 NVIDIA H100,加起來正好 60 分鐘。
| 輪次 | 加入的能力 | 訓練樣本 | H100 分鐘 | 封存測試成績 |
|---|---|---|---|---|
| 1 | 計算機、亮度、音量、深色模式、App、資料夾、計時器、截圖、拒答 | 4,712 | 11.2 | 61 / 95 |
| 2 | 數字口語、語序變化、時長換算、約 660 筆近似拒答 | 6,280 | 10.7 | 67 / 95 |
| 3 | 行事曆事件 1,200 筆、拒答再平衡 | 7,568 | 23.8 | 80 / 107 |
| 4 | 行事曆 1,800 筆(email 逐字、日期口語、小時換分鐘) | 7,909 | 14.3 | 90 / 125 |
未訓練的基底模型在第一輪那套 95 題的封存測試上是 0 分,第四輪 90 分,中間每一輪的分數檔案都放在儲存庫的 validation 資料夾裡。要注意四輪用的是四份不同的測試題(95、95、107、125 題),分數不能直接橫比;模型卡另外把第三輪與第四輪放在同一份第四輪題目上重跑,才是同基準的比較。每輪的測試都是新寫的、訓練前用 sha256 指紋封存,出題者依官方說法是另一個模型 Grok,字集與測試題相似度超標的訓練樣本會被剔除,四輪分別剔掉 788、920、532、791 筆。用過的題目也沒有藏起來:退役題組放在 data 資料夾,email 換成 example.com 後隨模型一起發布。這些防洩題措施屬官方自述,但對應的檔案確實可自行對帳。模型卡署名 Hariharan 與 Prabhurajhan 兩位開發者,宣布貼文的作者還特別把實作功勞歸給搭檔 Hariharan。
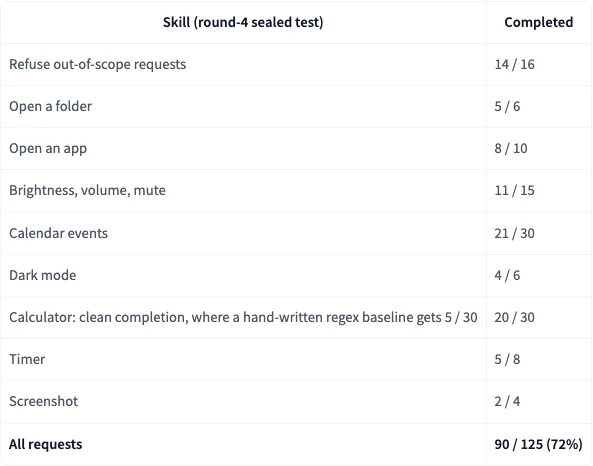
第四輪 125 題完成 90 題、約 72%,這是發布的頭條數字。但模型卡把沒過的門檻也寫在同一頁:事先登記的兩條及格線,凍結門檻要求每項技能各自達標(計算機 90%、拒答 80%、其餘 85%),結果只有拒答一項過關;擁有者自設的 75% 門檻也只有 App、資料夾、拒答三項越過。換句話說,團隊自己登記的目標一條都沒有全部達成,發布時照樣把測試 JSON 裡的兩個 false 原樣公開。逐項成績如下。
| 技能(第四輪封存測試) | 完成數 |
|---|---|
| 拒絕範圍外請求 | 14 / 16 |
| 開資料夾 | 5 / 6 |
| 開 App | 8 / 10 |
| 亮度、音量、靜音 | 11 / 15 |
| 行事曆事件 | 21 / 30 |
| 深色模式 | 4 / 6 |
| 計算機乾淨完成(正規表示式基線 5/30) | 20 / 30 |
| 計時器 | 5 / 8 |
| 螢幕截圖 | 2 / 4 |
截圖一半失敗、計時器 5/8、計算機 20/30,都是會讓日常使用卡住的成績。手寫正規表示式基線在計算機題組只拿 5/30,模型拿 20/30,模型確實學到了比字串比對更多的東西。但把第三輪和第四輪放在同一份測試上比較,總分 85 進步到 90 的同時,計算機從 22 退到 20、計時器從 6 退到 5,行事曆從 14 漲到 21。14MB 的容量裡,新技能是擠進來的,不是免費加上去的。
模型卡甚至標明了事後補算的界線:在模型輸出上外加程式碼交叉檢查後,行事曆可以補到 27/30,但這段檢查是第四輪跑完之後才寫的,頭條數字仍以模型單獨的 21/30 為準。交叉檢查的內容寫得很白:email 必須逐字來自原句、明講的上午下午優先、日期只從句子裡取、只邀請被點名的人。
宣布貼文裡的「3.4 秒進步到 0.26 秒、快 13 倍」,在模型卡的速度章節有完整的量測條件。0.26 秒是第四輪實測全部 262 個決策、逐一回放到發布版執行環境後的中位數,只計模型時間;九成決策在 0.72 秒內,最慢一個 6.9 秒。回放時沒有 App 在旁邊啟動,原始實測紀錄裡每個決策的平均是 0.81 秒。日常使用體感會落在哪個數字,取決於當下 Mac 在忙什麼。
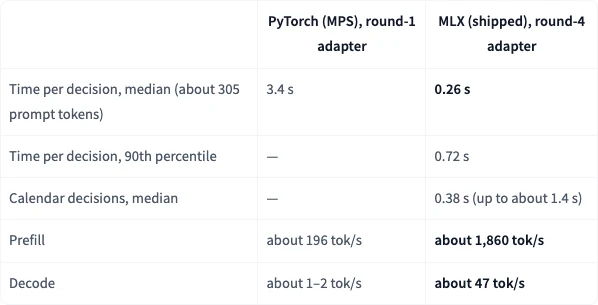
13 倍的分子分母則各自帶著一個變數:3.4 秒來自 PyTorch 執行第一輪附加權重,0.26 秒來自 MLX 執行第四輪附加權重。框架換了、版本也換了,兩個執行環境的決策一致率 203/203 是拿第一輪附加權重量測的。提速主要來自 KV 快取與 Apple MLX 執行環境。所謂提示階段是模型讀完請求與機器狀態的那一段,每秒約 1,857 token,是 PyTorch 的九倍多;生成階段是模型寫出動作的那一段,固定輸出 48 token 的量法下每秒約 47 token。
任務類型也會改變數字。行事曆決策要寫的內容長(平均輸出 9.8 個 token,其他動作只有 3 個),中位數落在 0.38 秒、最慢約 1.4 秒;非行事曆決策的中位數是 0.24 秒。
這些條件不代表數字灌水,回放與實測的每個決策輸出完全一致,而是代表比較前要先對齊口徑:拿別家代理的端對端完成時間跟 0.26 秒比,或拿雲端大模型的單步延遲跟 0.81 秒比,都不是同一道題。
授權分成三層,邊界比一般開源發布清楚。附加權重與全部程式碼是 Apache-2.0;基底模型保留自己的授權條款(Hugging Face 上標示同為 Apache-2.0);真正要注意的是計算機打字這一條路,它經過 Mediar 的 mcp-server-macos-use 元件,授權是 Business Source License 1.1:生產用途僅限非商業與教育,2028 年 4 月 9 日起自動轉為 MIT,在那之前商用需另向 Mediar 取得授權。其餘九個動作都是直接呼叫 macOS,不經過這個元件。
想實際跑它,條件是 Apple Silicon 的 Mac、macOS 14 以上、Python 3.10 到 3.13 與 Xcode 命令列工具。流程是四行指令:用 huggingface_hub 把整個儲存庫下載到本機、執行 setup.sh 建立固定版本的虛擬環境(它會抓基底模型、MLX 執行環境、建置上述 BSL 元件、編譯讀取亮度與計算機顯示的 Swift 小工具),然後跑 hobby_demo.py 進入展示。安裝腳本第一次執行時需要網路,完成之後才進入純離線。指令只支援英文,模型卡特別註明包含印度英語的口語用法;權限上 macOS 的輔助使用要在系統設定裡自己授予(程式啟動時會檢查),行事曆與聯絡資訊則預設關閉,要用環境變數明確打開並指定要寫入的行事曆。
截至 10 月 25 日,這個模型發布兩天,Hugging Face 上 25 個讚、下載 78 次,宣布貼文約 2.5 萬次觀看,都還很小。基底模型那一側倒是已經有完整生態:官方提供線上展示、GGUF 與 MLX 版本,GitHub 上還有搭配的 Windows App,但那些都屬於 HobbyLM-1B 聊天模型專案,不是這次電腦操作版本的一部分。它不做通用代理的事:不能操作任意網站、不能讀文件內容、沒有中文指令,範圍就到那十個動作。模型卡也直說不該用於安全、財務與醫療決策。
把它放回本機代理這條線上看,位置反而清楚:Coworker把整理檔案的桌面代理跑在使用者機器上,Skales把多代理轉向收在本機助理裡,macOS 上的語音聽寫工具 Input 0則把轉錄留在本機。HobbyLM-1B Computer Use 補上的是最薄的一層:固定動作的電腦操作,附完整的訓練與測試帳本,成本低到任何人都可重訓一次來驗證。對開發者,它是把「動作空間縮小換可靠度」這個設計攤在檯面上的樣本;對一般使用者,等它長出中文與更多動作之前,先看看就好。後續版本的分數與授權是否變動,以模型卡與 validation 資料夾的最新內容為準。