TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

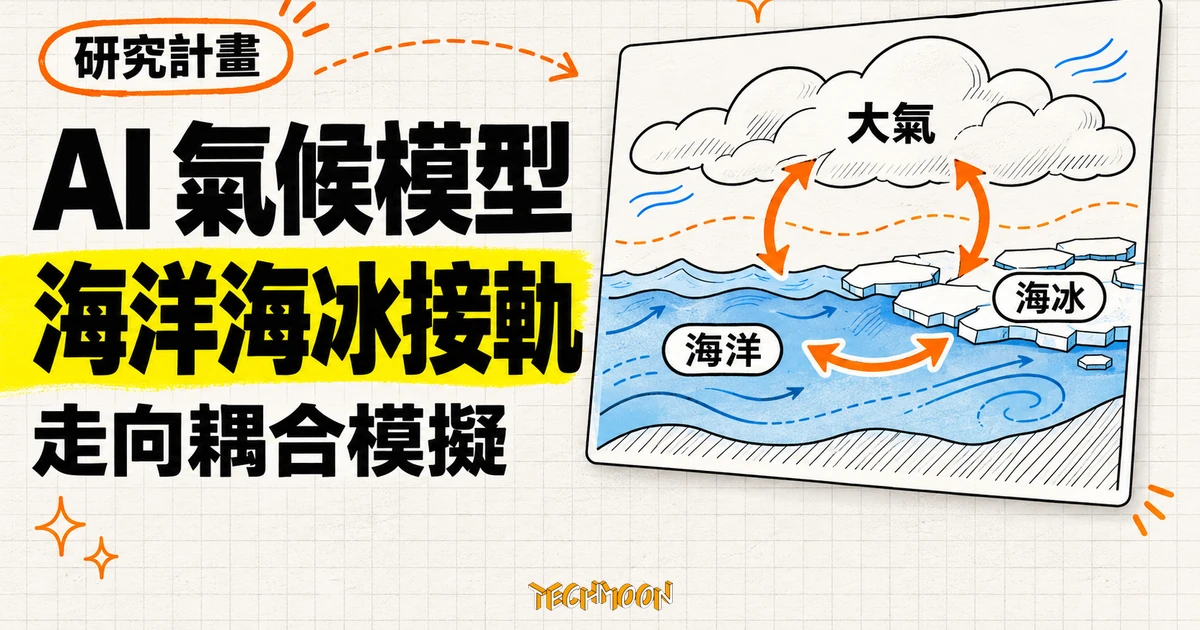
Ai2 於 2026 年 11 月 4 日宣布 NeuralGCM+ 研究計畫,獲 Google.org 三年資助與 Google Research 技術支援,要把原本視海洋與海冰為固定邊界的 AI 大氣模型,推向會互相影響的耦合模擬,並在訓練未見的暖化條件下驗證;8 分鐘模擬一年與快一百倍都是前作數字,成品尚未釋出。
用 AI 摘要這篇文章:
2026 年 11 月 4 日,Ai2(Allen Institute for AI)宣布啟動名為 NeuralGCM+ 的氣候模型研究計畫,合作角色分工明確:Google.org 提供為期三年、數百萬美元等級的資助,Google Research 提供技術支援,資助將用來擴編 Ai2 的氣候建模團隊。這則消息值得先把性質講清楚:它啟動的是一項研發,目前沒有可以下載的成品。NeuralGCM+ 要做的耦合系統此刻還不存在,公告給出的是三年內要走的路線與驗收標準。
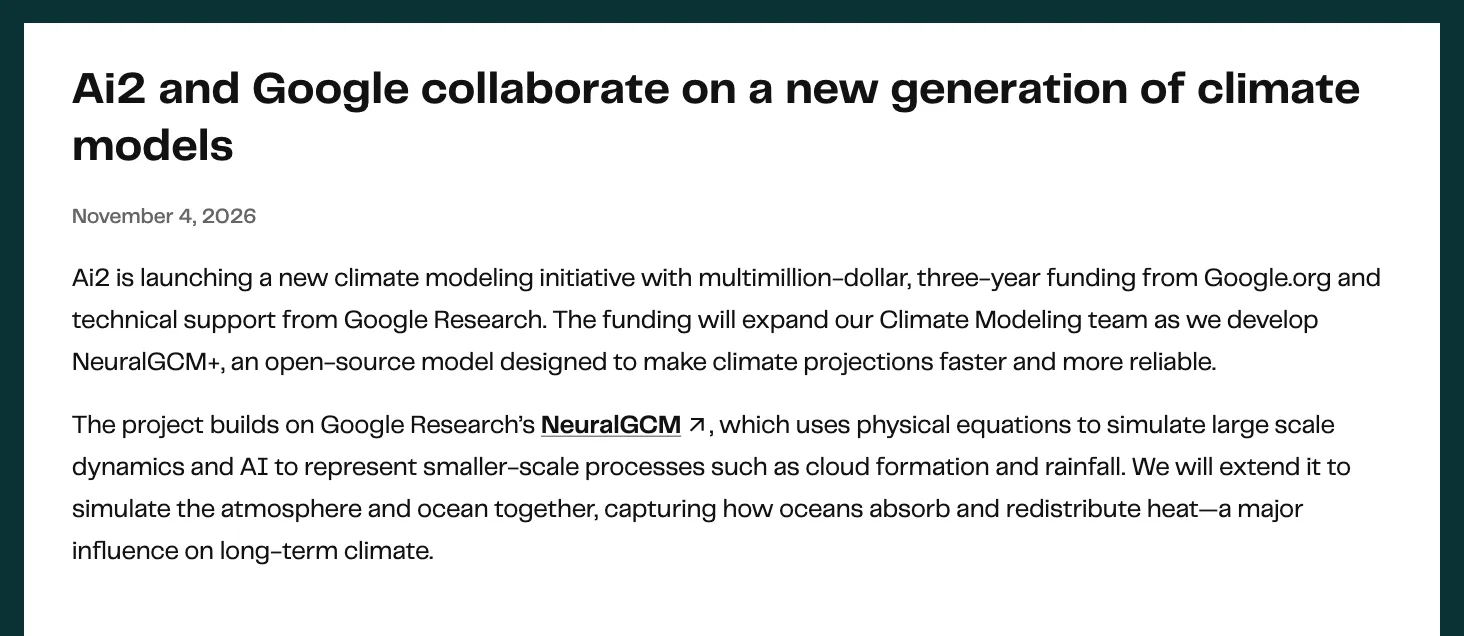
對關注 AI 走進科學建模的讀者,這條新聞的實體增量有兩個:把 AI 大氣模型從「海洋當固定背景」推進到「大氣、海洋、海冰互相影響」的耦合模擬,以及正面處理機器學習氣候模型最被質疑的一環,在訓練資料沒見過的更暖條件下,模型還能不能維持物理上合理的行為。至於常被引用的速度數字,8 分鐘模擬一年、快一百倍,全部屬於前作,而且各有明確的適用範圍,後面分開拆。
NeuralGCM 是 Google Research 於 2024 年 7 月發表在 Nature 的混合式大氣模型,與歐洲中期天氣預報中心(ECMWF)合作完成,以 JAX 撰寫,可以跑在 TPU 與 GPU 上。它的分工方式是物理方程負責大尺度的空氣流動,神經網路負責雲、雨這類小尺度過程,兩種方法在同一套模擬裡合作。
這個設計在傳統氣候科學裡其來有自。主流氣候模式早就把地球拆成大氣、海洋、海冰、陸面等組件,各自用物理方程積分,再在介面上交換熱、水與動量,這種組裝已經運作了數十年,代價是運算開銷大到只有大型研究中心跑得起,而且每多接一個組件,誤差與不穩定的來源就跟著多一層。NeuralGCM 等於是把這條生產線上「大氣」這個組件換成混合式引擎,其餘部分還沒接上;後面會提到的 EAMv3,則是美國能源部的傳統全球大氣模式。
關鍵在於它做長期氣候模擬時怎麼對待海洋。論文寫得很直接:延長模擬時,海面溫度與海冰濃度採用歷史觀測資料預先指定。換句話說,海洋是一張放好的照片,大氣在照片上演變,大氣再怎麼變化,海洋都不會回應。在天氣與季節的尺度上這樣做可以接受,因為海洋的變化相對慢;但氣候問題問的是幾十年的能量去向,海洋吸熱、儲熱、再把熱送回大氣,正是長期趨勢的主要推手之一。把這部分固定住,等於先固定住一個會左右長期趨勢的環節。
Ai2 的公告把這個落差列為核心工作:把 NeuralGCM 與一個海洋及海冰模型連接起來,讓大氣得到的熱與海洋送出的熱在同一套計算裡持續交換,目標是產生橫跨數十年仍然穩定的模擬。這是前後差異最清楚的一句話:海洋與海冰從輸入資料,變成系統裡會回應的一部分。
先看最常被引用的那組數字。在公開基準中,NeuralGCM 的大氣版本用單一台 TPU 約 8 分鐘,就能模擬全球一整年的大氣狀況。Google 官方部落格給過對照組:傳統模型 X-SHiELD 做同樣一年的模擬需要約 20 天,動用約 13,000 顆 CPU 組成的超級電腦,這組對照在 1.4 度解析度版本上差距超過 3,500 倍。
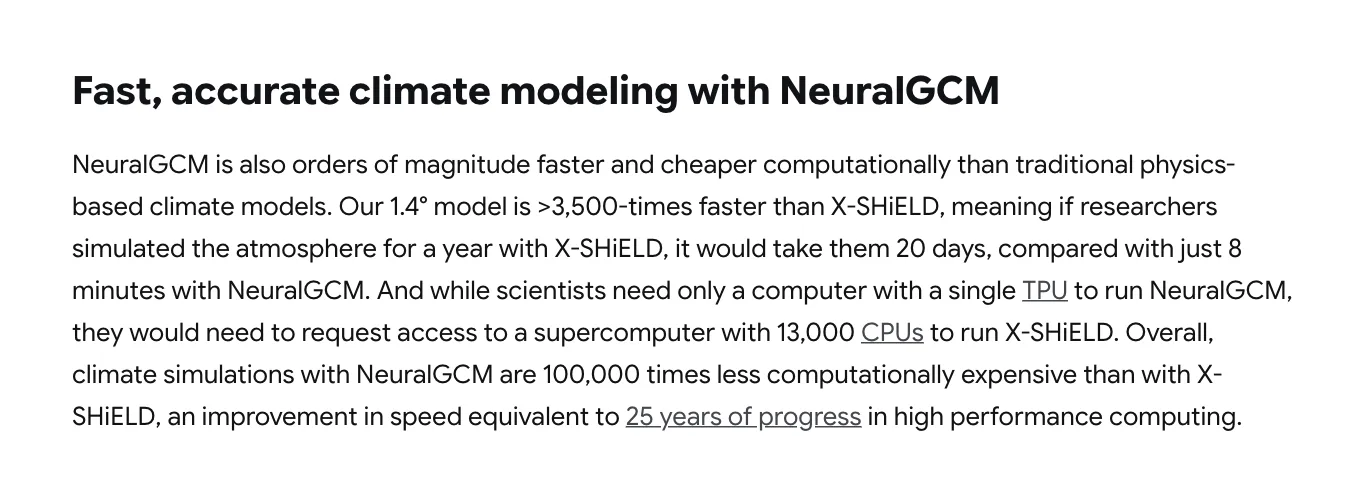
這組數字掛著三個限定詞:大氣、公開基準、單一 TPU。它量測的只有大氣模型,海洋與海冰不在其中。NeuralGCM+ 要做的耦合系統會加入新的計算與新的互動,速度必須重新量測,8 分鐘沒辦法直接平移到新計畫。
另一組常見數字是快一百倍,它屬於 Ai2 自家的另一條線 ACE2。這是一個 4.5 億參數的自迴歸模擬器,以 6 小時為一個時間步,水平解析度約一度,垂直分八層,論文描述的吞吐量約一天可模擬 1,500 年。在 2025 年一篇把 ACE2 用於海溫敏感性實驗的研究裡,ACE2 完成同樣實驗的速度,約是它所模仿的美國能源部傳統大氣模型 EAMv3 的一百倍,而原文的寫法很謹慎:在我們的設定與運算資源下。
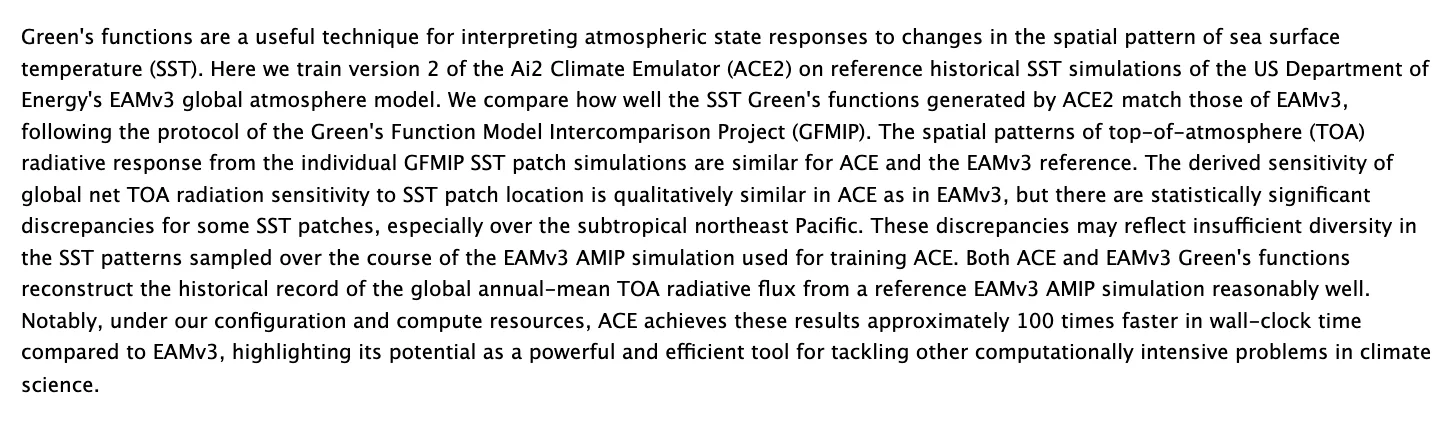
同一篇研究也給了但書,轉載新聞幾乎都略過:對部分海溫區塊,特別是副熱帶東北太平洋,ACE2 的回應與原模型存在統計上顯著的差異,作者推測原因是訓練資料裡海溫樣態的多樣性不夠。ACE2 的論文寫得更直接:模型對海面溫度與二氧化碳分開變化的敏感度,未完全符合物理。快是有條件的快,引用時把範圍拿掉,數字就變成另一個宣稱。
對兩條線的差異,Ai2 的公告也有交代,這段對理解新計畫有用:ACE 學的是大氣狀態整體怎麼演化,NeuralGCM 的學習則集中在垂直切片裡的局部過程,學習問題相對簡單,Ai2 認為這種設計或許有助於模型在氣候變暖時仍站得住。公告同時點出另一個限制:只靠歷史資料訓練的模型,對人類還沒經歷過的未來氣候,本來就難以做出可靠推估。這也說明了為什麼物理約束與暖化壓力測試被寫進交付項。
公告把 NeuralGCM+ 的開發列成三條互相銜接的路線,每一條都帶著可以回查的指標。最基礎的一條是大氣與海洋海冰的連接,指標是模擬過去 50 年時,區域溫度與降雨的誤差要低於傳統氣候模型。這個指標比全球平均更嚴:全球平均接近,可能剛好掩蓋某個地區偏乾或偏濕,區域誤差是對使用者的承諾。
暖化條件下的行為是另一個重點:加入更多既有物理約束,並測試模型能否重現訓練期間沒遇過的更暖氣候下的溫度與降雨變化,以傳統氣候模型的模擬當參照。這種拿傳統模型當驗收對照組的設計,與其他物理工程領域近期認真對待評測方法的走向一致,把 AI 成果放回物理世界驗收已經是跨領域的共同課題。Ai2 在公告裡對這點沒有打包票,原文承認:展示可靠的未來推估,仍是核心研究任務。對要拿模型做長期規劃的人,這句話比任何速度數字都重要。
可用性與開放也在交付清單上:在 NeuralGCM 既有的開源程式碼與可下載權重之上,釋出模型、建模框架與附帶文件的工作流程,讓外部研究者能訓練、改編與貢獻程式碼,並改善在常用 GPU 上的執行效率。Ai2 給的長期目標,是一個讓各氣候建模實驗室共同使用與改進的研究平台。把工作流程與文件列為交付項值得肯定:只給權重檔而缺少資料前處理與耦合設定,外部團隊很難重現結果,模擬科學的工程化向來把這層接線看得比模型本身更關鍵,近期實體模擬領域把生成到部署的整套流程打包的做法,也是同一個方向。Google.org 應用科學負責人 Alex Diaz 在公告裡的說法,呼應的是開放這條線:深厚的氣候科學專業加上對開放研究的共同承諾,讓 Ai2 有獨特條件把 NeuralGCM 延伸到下一個世代的長期氣候推估。
分工也畫得清楚:Google Research 繼續把 NeuralGCM 用在數週到數月的近期預測,例如接下來的夏天偏熱還是偏濕;Ai2 負責數年到數十年的氣候趨勢,公告點名的例子是美國西南部到本世紀中的降雨與水資源變化。同一個模型家族,兩條時間軸,追蹤時不要混在一起。據 GeekWire 報導,兩個團隊會共用訓練程式碼與資料,這也解釋了為什麼釋出訓練程式碼被排成計畫前段的工作:它同時是兩邊往前走的基礎設施。
今天的 NeuralGCM 能回答什麼,2024 年那篇 Nature 評論給過邊界:它可以預報到 15 天,並重現 40 年的歷史溫度趨勢。換句話說,短期預報與歷史重現是已經展示過的能力,數十年未來推估是 NeuralGCM+ 要補的那一段,兩者之間的落差,就是這次資助押注的位置。
公告之外,GeekWire 對 Ai2 氣候建模負責人 Oliver Watt-Meyer 的報導補了幾個官方文件沒有的細節,價值在於時程預期管理:資助規模報導為約 500 萬美元,外加約 180 萬美元的雲端運算額度;Ai2 氣候建模團隊現有 8 人,將新增 4 人;NeuralGCM 的訓練程式碼目前與 Google 內部系統綁定,釋出訓練程式碼預計在計畫啟動一年內,海洋模型的開發並行進行。這些數字與時程都以 GeekWire 的報導為準,官方公告沒有背書。
Watt-Meyer 對最難那一關的說法,比公告更直白:對沒見過的暖化條件做出可靠推估,可能花超過三年,他不確定一定會成功,並說這就是它作為研究計畫的原因。三年資助與三年後有成品,是兩回事。他想回答的問題也畫得很寬:理解未來 5 年到 50 年世界會怎麼變,是這類科學想支撐的決策視野。
這個團隊不是新面孔。GeekWire 整理的沿革顯示,Ai2 的氣候建模工作延續自 Paul Allen 約 2016 年在 Vulcan 資助的氣候模式計畫,2021 年移入 Ai2,ACE 系列模擬器是既有的進行中工作,NeuralGCM+ 是在這條線上往前接,全新出發的說法並不準確。
工程面有一個旁證值得記下:GeekWire 並報導,一個外部團隊已經把一個知名的海洋模型從 Fortran 移植到 NeuralGCM 使用的 JAX 語言,Ai2 因此不必自己重寫這一段;Watt-Meyer 自己用 AI 編碼代理協助移植實驗,並稱現在是科學運算的黃金時代。老牌 Fortran 科學程式碼的移植,近來反覆成為 AI 代理的試金石,59 分鐘把 Fortran 核心搬進 Rust 的案例只是其中之一。
脈絡上還有一層巧合:Watt-Meyer 正是 2024 年在 Nature 撰寫評論介紹 NeuralGCM 的人,那篇評論指出,把機器學習表示法與傳統大氣模型耦合的挑戰存在已久。兩年後他接手的計畫,剛好就把耦合與長期穩定性做成明確的交付項。
如果你的工作會用到長期氣候資訊,現在能動手的只有兩件事。既有的 NeuralGCM 程式碼與模型權重已經開放,ACE2 的權重也在 Hugging Face 上,可以先熟悉資料格式與輸入介面;接著把單位內的研究情境整理成固定測試,等 NeuralGCM+ 的成果公開時用同一組情境重跑,才有可比較的基準。應用面已有先例:GeekWire 點名保險與再保險業者已在用 ACE 系列模型評估風險,水資源規劃的例子是科羅拉多河流域的長期供需,報導裡出現的需求方還包括評估資料中心選址的團隊,冷卻、再生能源供應、極端天氣與海平面上升都在他們的問題清單上。這類應用共同的輸入,都是可靠且跑得動的長期氣候推估。
西太平洋與台灣周邊的區域適用性,答案只能等:模型對這些地區降雨的表現,要看公開測試有沒有涵蓋,官方文件對此還沒有任何承諾。
回查節點照影響力排:訓練程式碼釋出(GeekWire 稱計畫一年內)、首次大氣海洋海冰耦合模擬的公開展示、過去 50 年區域溫度降雨誤差的驗證結果、在比訓練更暖條件下的壓力測試。每走過一個,快速計算換來的結果能支撐的使用範圍就更清楚一層;在那之前,把 8 分鐘或一百倍直接折算到 NeuralGCM+ 身上,都是超出證據的說法。