TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

開源語音工具 VoiceStudio 把聲音複製、影片配音、聽寫與轉錄收進本機桌面工作台,預設引擎覆蓋 646 個語言標籤,星數在 10 月中兩天內增加約兩萬。免費能力邊界、模型授權分層、Intel Mac 限制與 Pro 定價一併整理。
用 AI 摘要這篇文章:
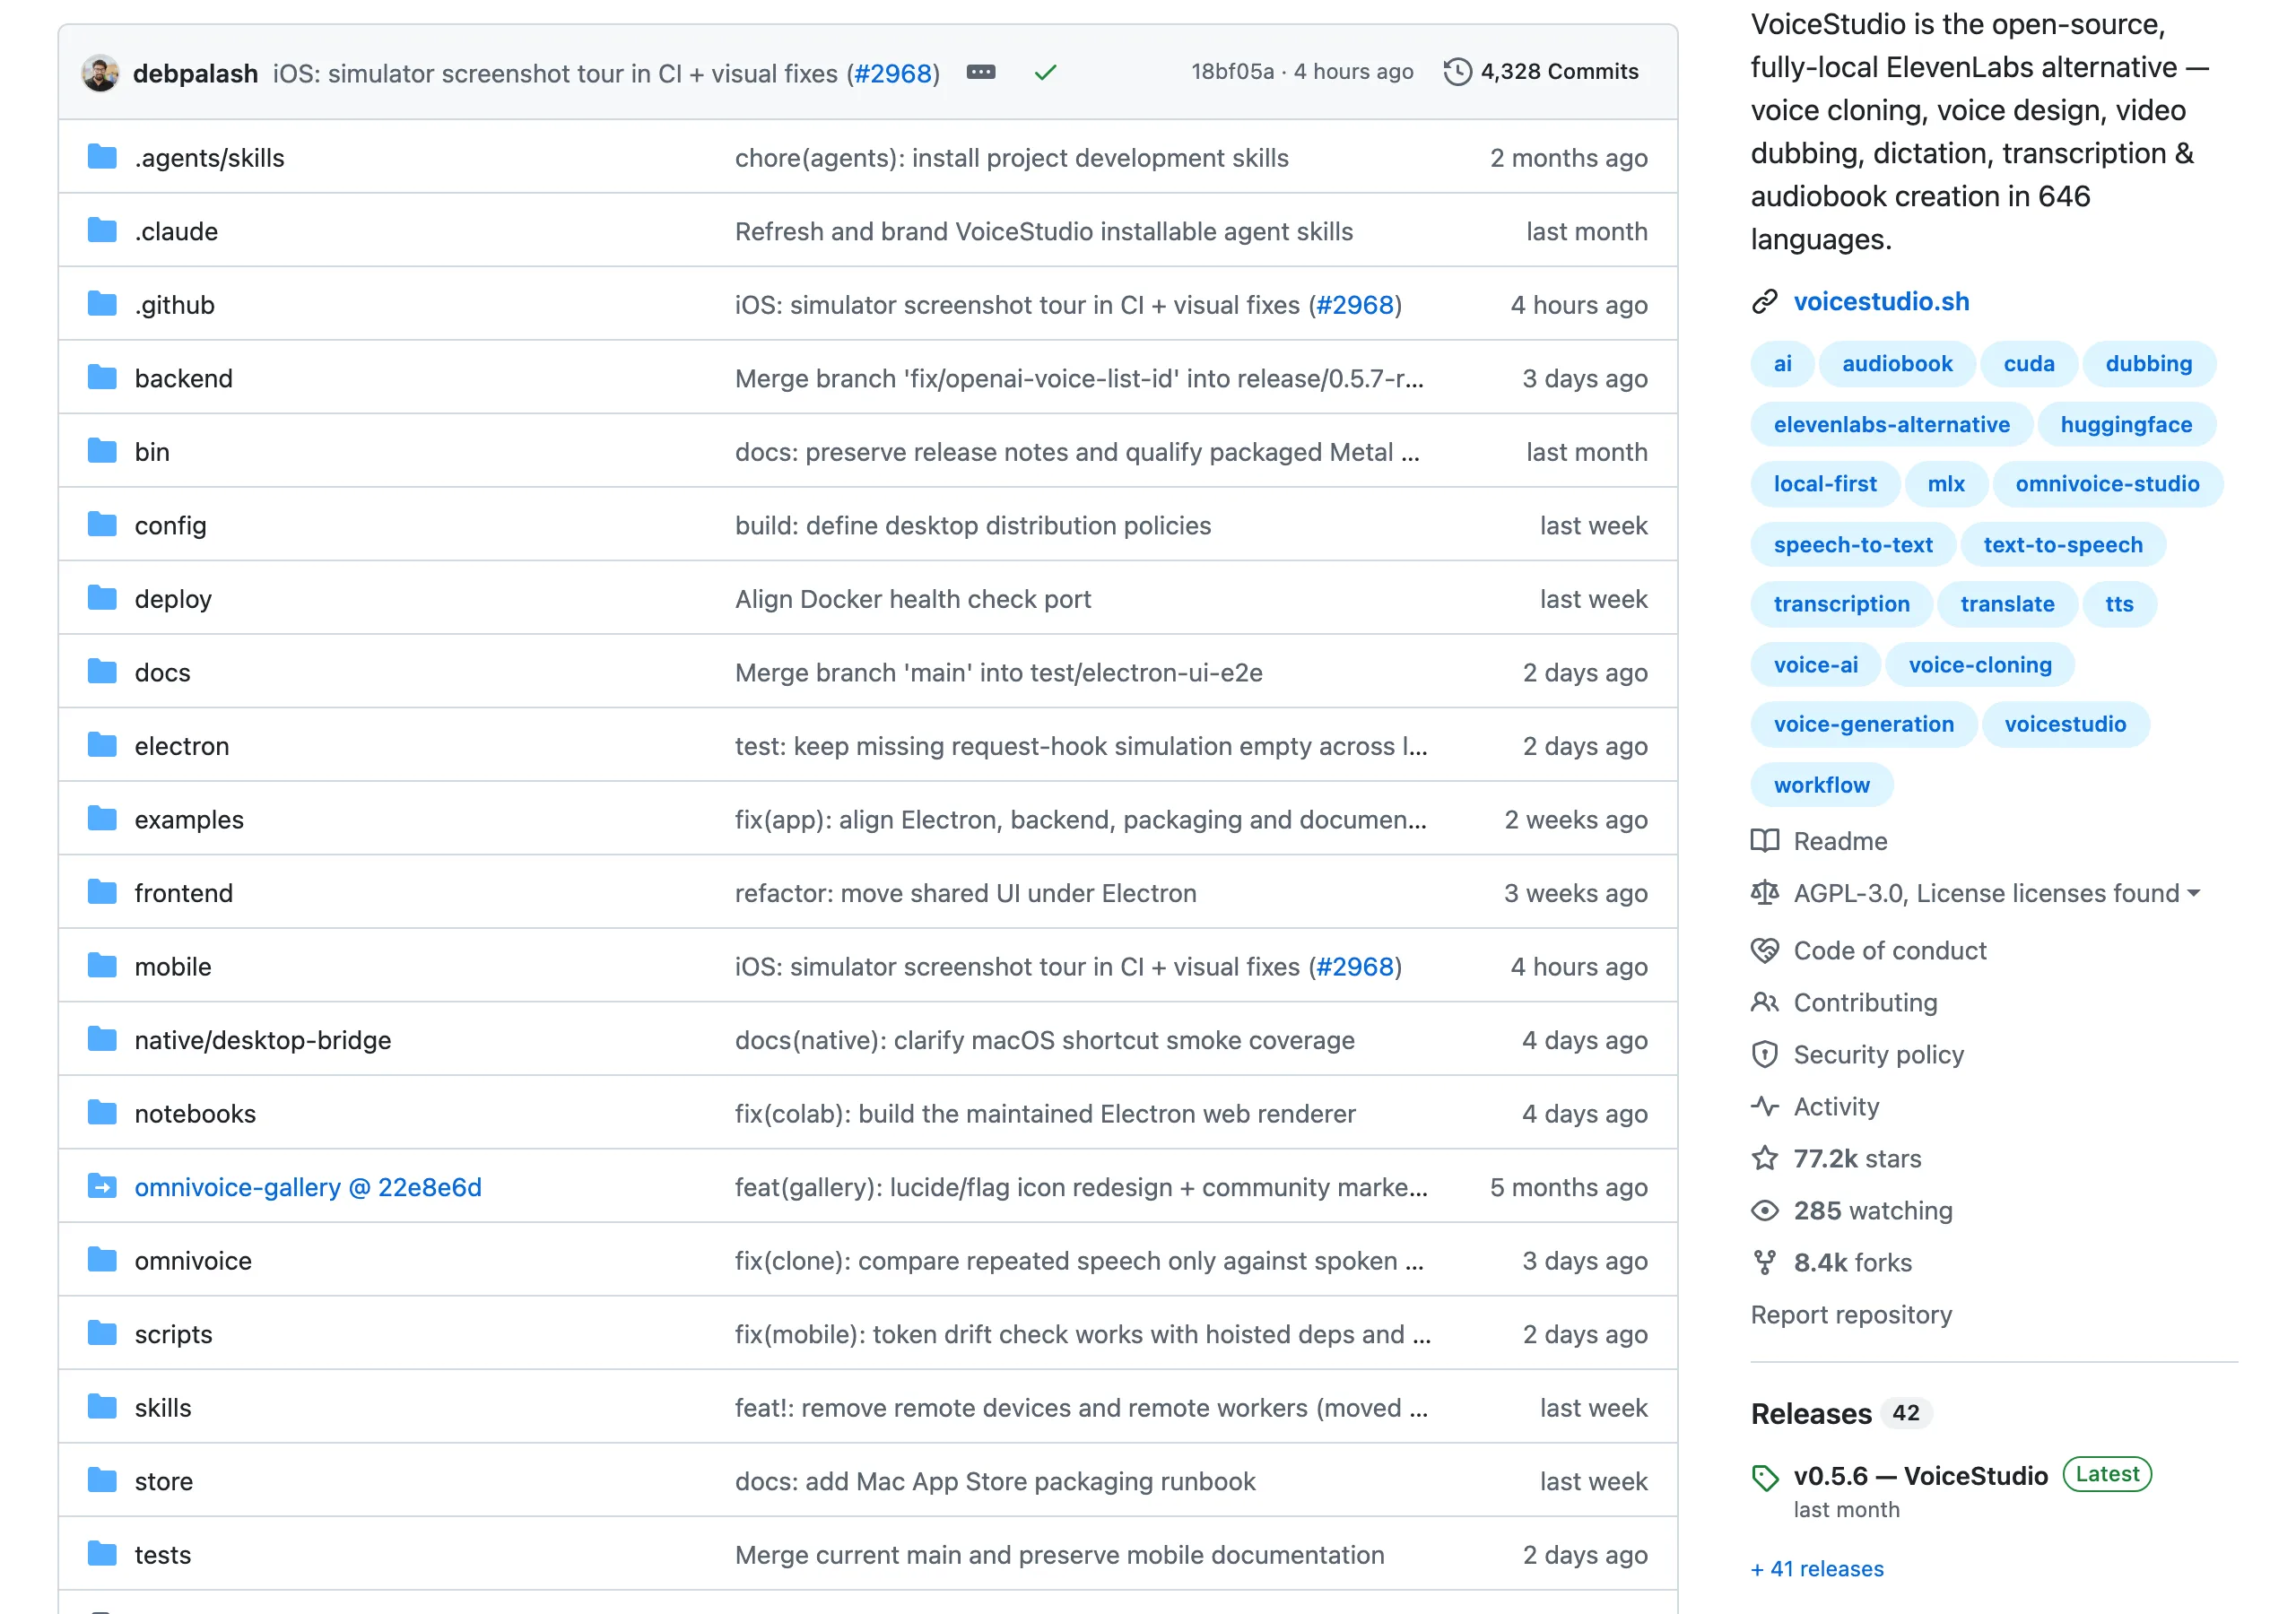
一款今年四月才出現在 GitHub 的開源語音工具,十月中的這個週末被推上了一波明顯的成長曲線。10 月 18 日下午,一則整理當月熱門 GitHub 專案的合集貼文把它排在第一位,介紹詞大意是聲音複製、影片配音與多語言轉錄都能在本機跑,當時標注的星數是 57K。官方網站自己的圖表在 9 月 30 日觀察時停在 50,000 顆星;到台北時間 10 月 20 日凌晨,GitHub API 顯示的數字已經是 77,145。一天多增加約兩萬顆星,這個儲存庫同時掛著趨勢排行平台 Trendshift 的第 28176 號徽章,維護者是一家登記名稱為 Yupcha Softwares Private Limited 的公司。
星數還有一個容易誤讀的小地方:官網圖表上的 50,000 是 9 月 30 日的靜態觀察值,同一頁的即時計數器在我載入時已顯示 77,152,兩個數字同頁並存。引用任何一個之前,先看它標注的觀察日期。
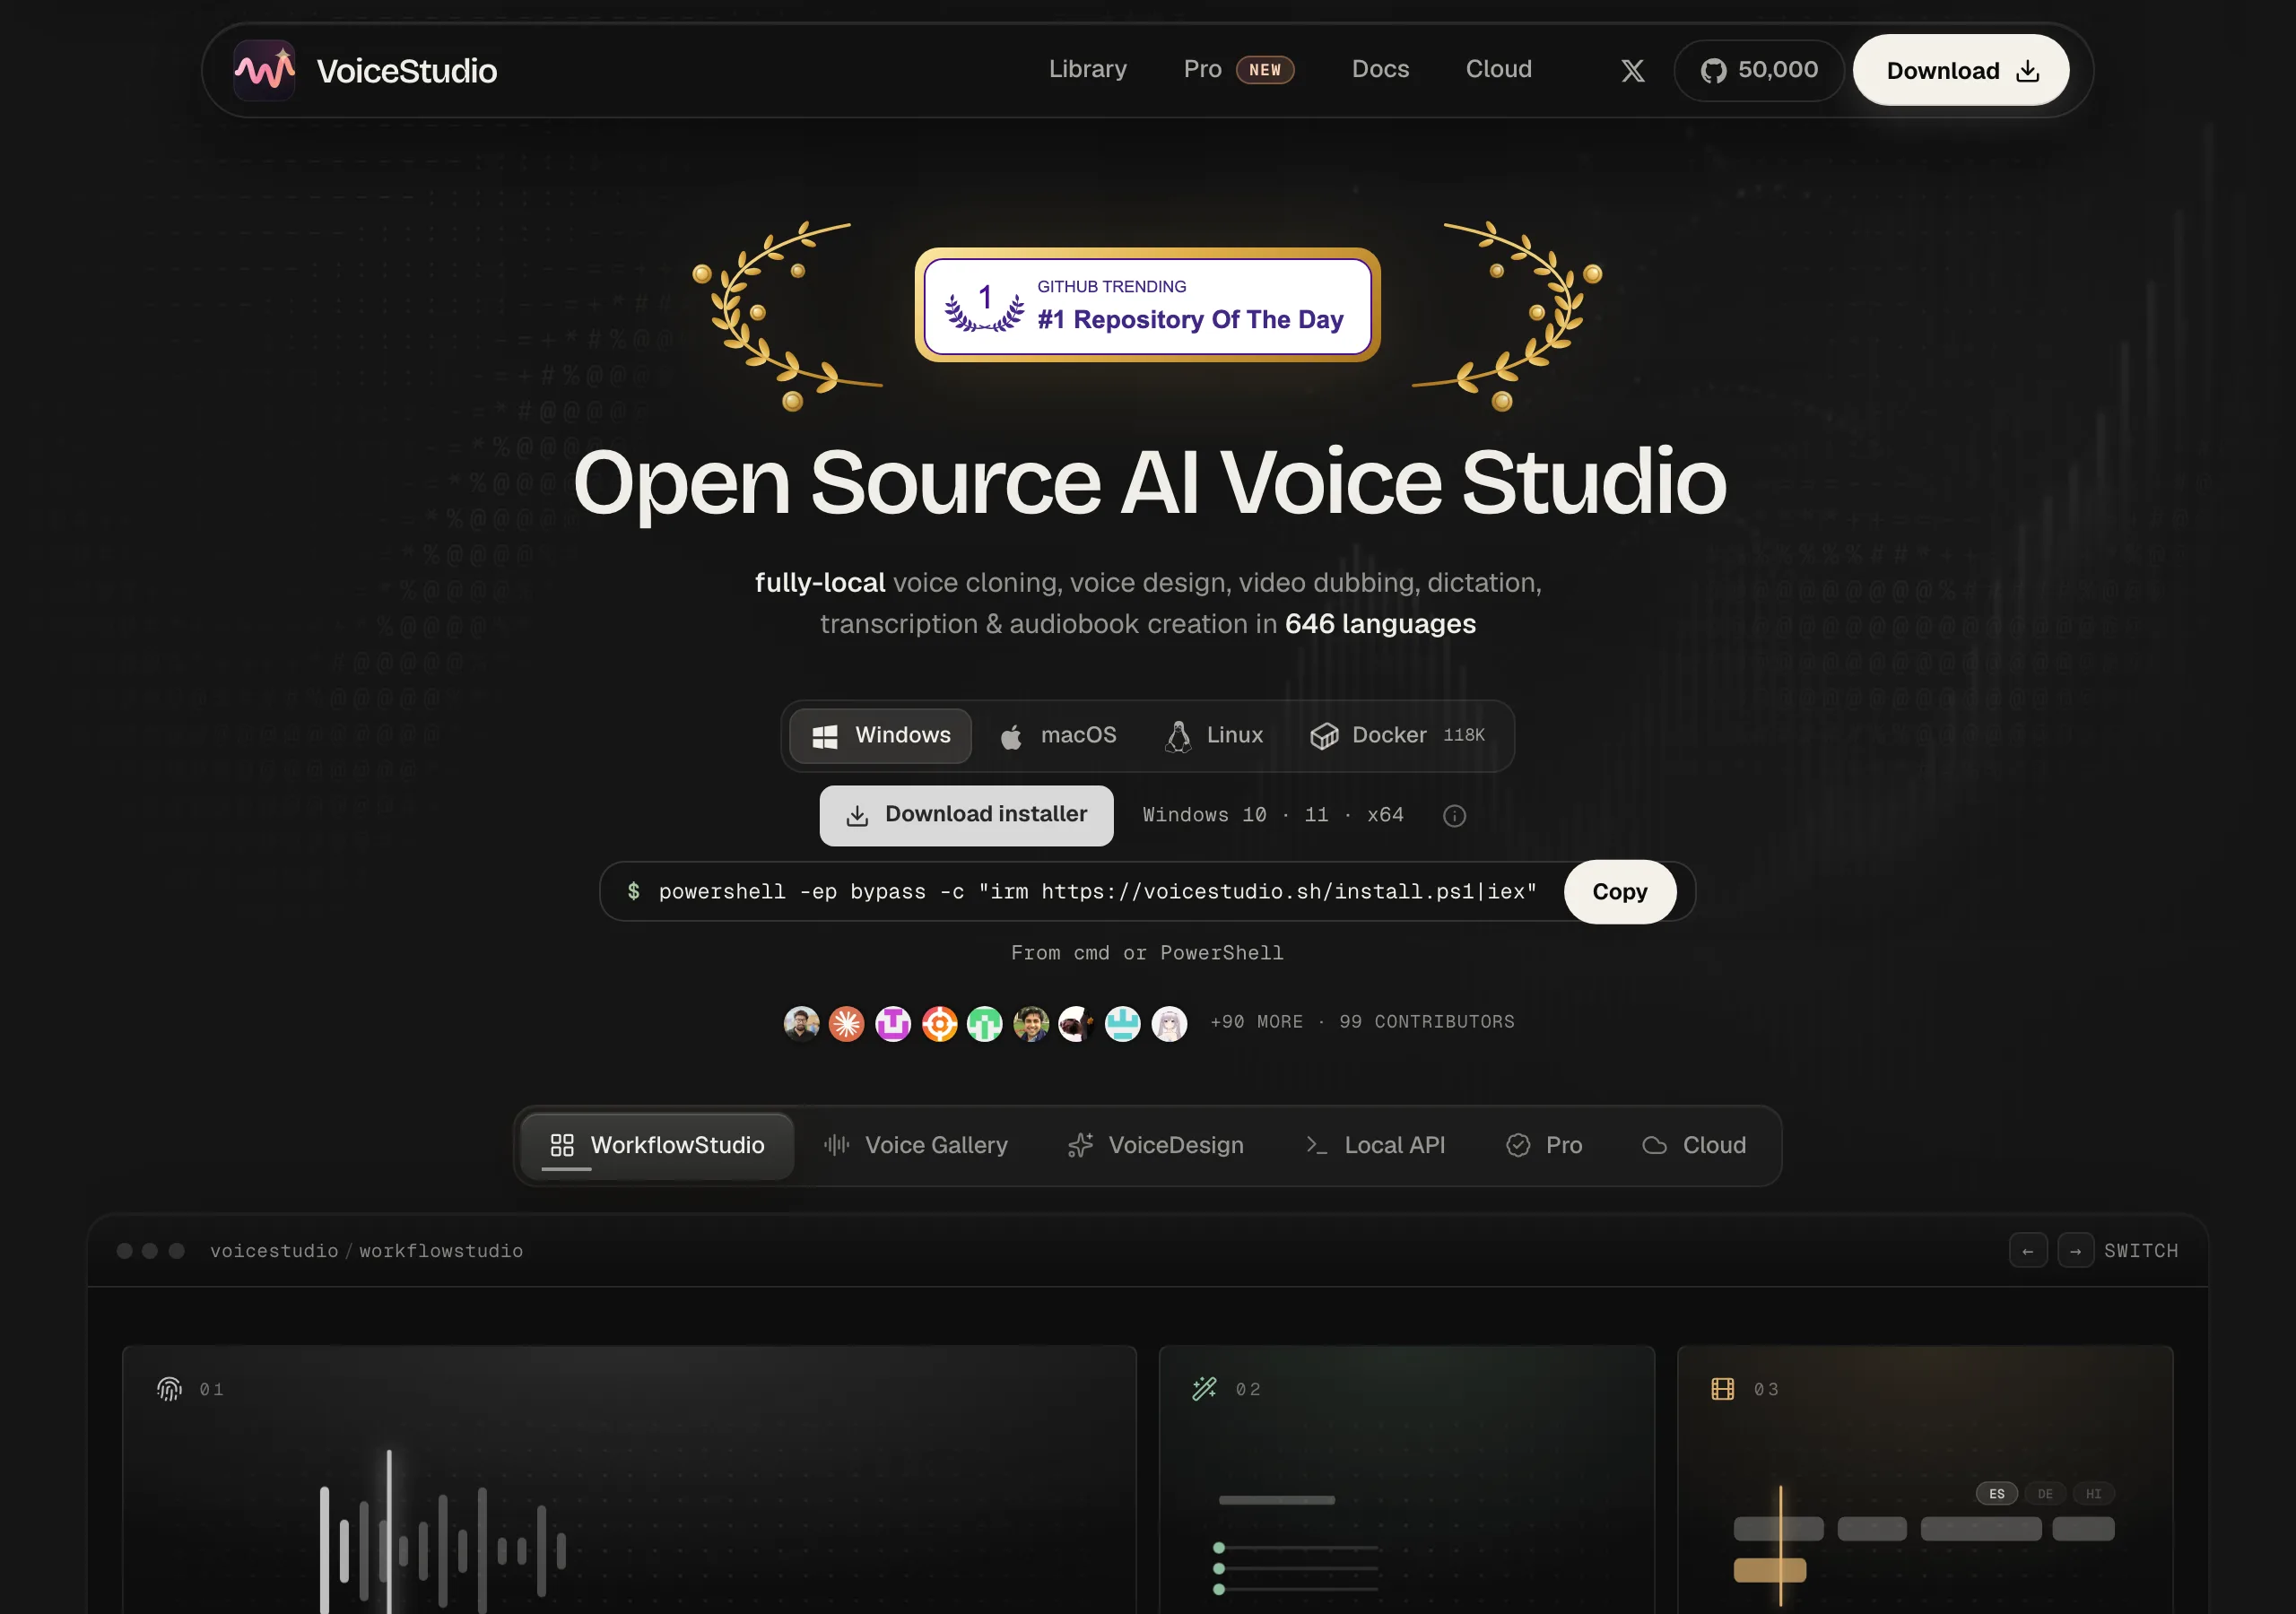
先把判決說清楚。如果你有 Apple Silicon 的 Mac、或一張 NVIDIA 顯示卡,想用自己的機器做聲音複製(拿一段參考錄音生成相似語音)、影片配音、聽寫或轉錄,它值得下載來試:免費、AGPL 開源、介面有原生繁中,模型預設都在自己機器上跑。但兩種人先別急著投入:拿 Intel Mac 的人,本機運算這條路已經被切斷,只剩介面要靠遠端後端;以及打算做商業交付的人,免費的只有應用程式這一層,預設模型的權重授權禁止商業使用,而且官方自己的盤點裡,五十幾個模型沒有一個的商用輸出權限被確認過。下面把這幾個邊界逐一攤開。
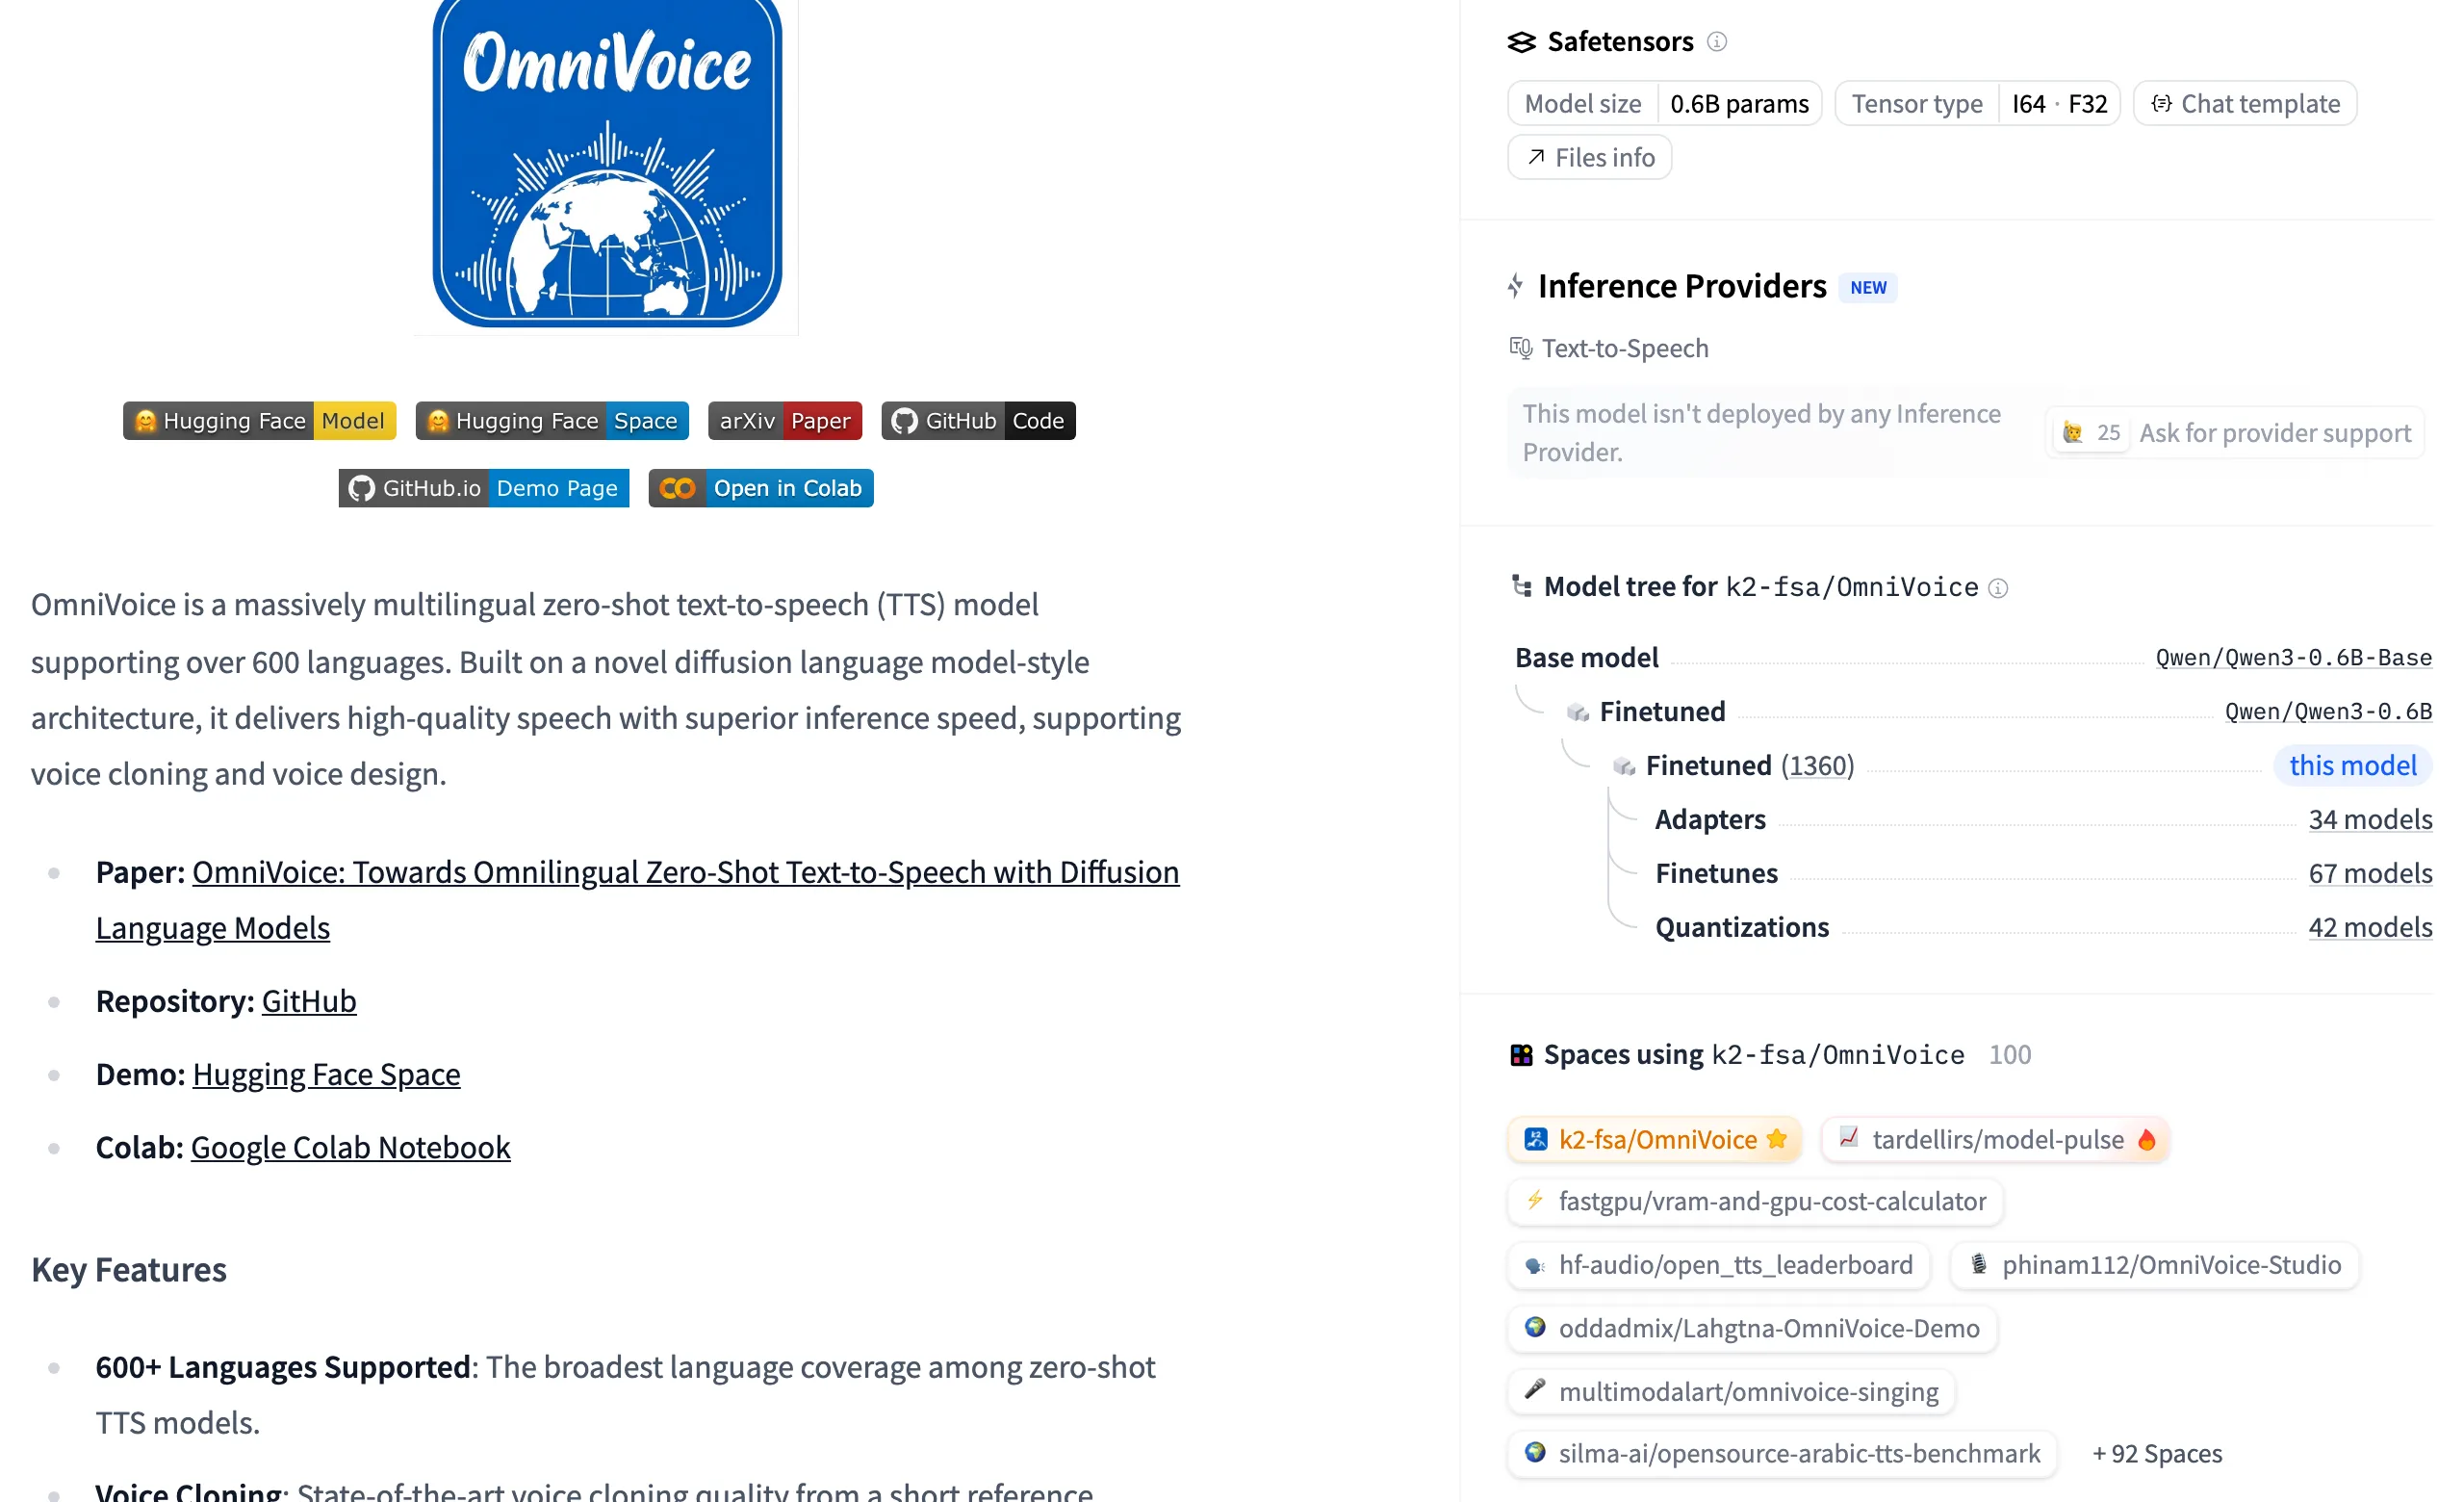
646 這個數字是真的,但要知道它在數什麼。語音生成(把文字念出來的 TTS)的預設引擎叫 OmniVoice,是 Hugging Face 上 k2-fsa 團隊發布的模型。它的模型卡最上方的語言欄位,逐行列出 646 個語言標籤,我用程式逐一計數核對過,數量分毫不差:這不是四捨五入出來的行銷數字,而是可以逐行核對的清單。這份清單包含中文(zh)、粵語(yue)、閩南語(nan),但沒有台灣繁體或香港變體的分欄,中文就是一個代碼。模型卡正文自己用的字眼是「超過 600 種語言」,VoiceStudio 的 README 和官網首頁則把 646 直接拿來當整個專案的介紹詞。
那 646 個標籤的組成也值得看一眼:清單裡有粵語與閩南語的獨立代碼,中文只分配到一個代碼,沒有再分繁簡或地區。對台灣使用者來說,閩南語入列是少見的亮點,但標籤存在不等於每個語言的品質一致,模型卡沒有附各語言的品質評比,零樣本多語模型的實際表現,通常跟那個語言在訓練材料裡的分量高度相關。
所以 646 是預設語音生成引擎的覆蓋範圍,代表「用預設引擎念一段文字時可選的語言標籤數」。其他功能各有各的清單:轉錄(把錄音變文字)預設走 WhisperX,另列九個選項;語音生成除了預設引擎還有十六個備選,從 CosyVoice 3、IndexTTS 2.5 到 VoxCPM2 都在內。換一個引擎,語言支援、需要的顯示卡記憶體、授權條件全部跟著換。想做多語配音的人,正確的讀法是先選定工作(生成或轉錄),再查那個引擎的語言表,而不是拿 646 直接回推每個功能都通。
對中文使用者有幾個直接相關的細節。即時聽寫走的 sherpa-onnx 引擎,模型清單登記的是中英雙語的串流辨識模型;轉錄側從 Whisper 的 tiny 到 large-v3 齊備,還有中英雙語的 Paraformer 與 FunASR 陣營的 SenseVoice 可以選。模型清單裡另有說話者分離與人聲分離模型,做訪談或多人群聊的轉錄時用得上。預設引擎也有 GGUF 量化變體,模型卡載明它的底座是 Qwen3-0.6B、參數量 0.6B,換句話說覆蓋 646 個語言標籤並不需要一個巨無霸模型,但各引擎對中文的繁簡處理與標點行為,仍然要實測才知道。
官方對照表也誠實呈現了這個落差:網站上與 ElevenLabs 的比較表寫著開源版與 Pro 版 646 語言、雲端版 645 語言,競品付費方案 74 語言。數字是官方單方整理的(表上標明各列取自雙方公開頁面、2026 年 9 月 30 日核對),但至少把雲端版比本機版少一個語言這種細節都寫出來了。
授權要拆三層看,這是整個專案最值得肯定、也最容易誤讀的地方。最上面是應用程式本體,AGPL-3.0,授權說明文件明文寫著包含商業與內部使用;中間是預設引擎的 Python 套件,上游作者以 Apache 2.0 釋出;最下面是模型權重,模型卡寫明因訓練資料(例如 Emilia 資料集)的限制,預訓練權重採 CC-BY-NC,非商業授權。再往下還有一層:這個模型的音訊分詞器(把聲音切成模型能處理的單位的組件)另有 Boson Higgs Audio 2 與 Meta Llama 3 的社群條款。
最容易踩空的點在這裡:買付費方案不會買到模型權利。官網 Pro 方案賣 99 美元一年或 299 美元買斷(一人、三台裝置、七天退款),買的是額外功能與閉源嵌入的商業授權,授權說明白紙黑字寫著「付費應用程式授權不授予模型、聲音或生成輸出的權利」。App 層允許商用與模型層禁止商用,兩句話同時成立,就看你要做的是哪一層的事。
專案還維護一份模型授權盤點檔(後端設定裡的 model_licenses.json,最近一次盤點日 2026 年 10 月 3 日),把 57 個可下載模型的授權狀態逐一登記。我逐欄統計過:57 個模型的商用旗標全部是 false,商用輸出權限全部標 unknown,組件盤點封閉度全部標 incomplete。但授權說明文件解釋了:false 旗標包含「尚未覆核」的成分,不代表每個模型都禁商用;實際被覆核為非商用的只有 4 個(含預設的 OmniVoice),其餘 53 個是還沒查。換句話說,想拿任何一個模型做商業輸出,截至盤點日都沒有現成答案,要自己去看上游條款。未發佈的 0.5.7 版還為此加了授權對話盒:非商用授權的模型要先用戶明確接受一次條款才能開始用,接受的是條款本身,不會反過來授予任何商用權利。
打包發佈的細節裡還有兩處會影響商業判斷。它內建的影音處理套件(PyAV 15.1.0 的安裝輪)連同 FFmpeg 與 x264/x265 編碼器一起打包,授權說明附了一份輪子稽核檔,並標注這些二進位檔的轉散布要求尚未解完。商業模式除了 Pro 與未來的雲端版,還包括官網申請制的付費贊助版位與 GitHub Sponsors 等管道;外部貢獻者要簽貢獻者授權協議,程式碼授權給維護公司。免費與付費的界線倒是寫得很死:食譜、資料夾監看與聲音複製維持免費,Pro 頁只列 Pro 多出來的功能。
還有一條與授權無關但同樣硬的紅線:聲音本人同意。README 的提醒很短,要複製某個人的聲音,必須先取得本人同意,這是模型授權之外、任何商業授權都替代不了的前提。練習用自己的聲音最省事,拿配音員或同事的錄音之前,先把生成內容的用途談清楚。自己錄的參考音最乾淨;配音員的聲音通常是職業資產,授權範圍該寫進合約,不是口頭答應就好。
硬體支援不是一張模糊的建議表,四種處境有四種明確答案。
Apple Silicon 的 Mac 走在最順的那條路上:全部運算走 Metal 加速,近版還在底下用了 MLX 架構。有個設計取捨要知道:它一次只跑一個生成,因為 Mac 的統一記憶體讓語音生成與轉錄模型搶同一池記憶體,16GB 的機器上應用程式會主動把一邊卸載騰位子給另一邊,記憶體越大、配音時換檔的次數越少。
換到 NVIDIA 顯示卡,待遇又不一樣:fp16 精度與 torch.compile 預設開啟,16GB 以上的顯示卡記憶體可以同時跑三到四個生成,10GB 以下則刻意排成序列,因為兩個工作同時塞爆記憶體正是他們修過的當機類型。
沒有獨立顯示卡的電腦也沒有被排除:安裝時改裝小號的 CPU 版 PyTorch(約需 5GB 磁碟空間),能跑,但文件自述速度大約是 Apple Silicon 的兩倍慢,建議搭配小而快的引擎與短參考錄音。模型下載另外有提醒:目標磁碟要保留模型大小再加 10GB 的空間。
效能文件裡還有一個值得停下來看的工程細節。在 Apple Silicon 上,預設引擎跑在一個子程序隔離版裡:卡死的生成工作可以被整個硬殺、釋放掉佔住的資源,下一個請求自動重生一個乾淨的工作程序。會長出這個設計,是因為 Python 沒辦法中斷底層的模型呼叫,卡住的工作會一直占著資源直到自己結束,後面所有生成排隊等它,文件直接附了兩個歷史議題編號當教訓。CUDA、ROCm 與 CPU 機器仍走內建式引擎,換取比較低的呼叫開銷。
文件把可調的旋鈕也寫得比多數同類專案透明。GPU 併發數自動按空餘記憶體估算,每 5GB 配一個工作、上限四個,Apple Silicon 與 CPU 固定一個;Mac 的統一記憶體在空餘低於 6GB 時,會先把語音生成模型整個釋放,讓轉錄模型上場,下一次生成再重新載入;生成逾時的預算也不是死數字,文字超過 1200 字之後每 40 字自動加一秒。文件同時警告 10GB 以下的顯示卡別手動調高併發,因為兩個工作同時塞爆記憶體,正是自動估算要防止的當機類型。
Windows on ARM 是另一個邊緣地帶,而且兩處口徑有時間差:首頁寫得直白,沒有原生建置,x64 安裝檔靠 Windows 自帶的模擬層跑,官方自己也沒測過;未發佈的 0.5.7 更新日誌則列了實驗性的 ARM64 原生安裝檔。拿 ARM 筆電的人可以等這條路成熟再進場。
至於 Apple Silicon 的加速底層,從 v0.3.21 起改用 MLX 架構;AMD 的 ROCm 與 Intel 的 XPU 也在支援清單上,只是文件著墨少得多,實際體驗大概只能靠社群回報。
Intel Mac 拿到的是最硬的答案:不支援本機後端,套用的原文就寫著「app UI only」。原因在於 PyTorch 已經停止產出 Intel Mac 的安裝輪,Python 環境根本裝不起來(對應的議題編號 #889)。官方仍提供 Intel 版的 DMG 下載,但那個版本只能當介面,連到另一台機器上的遠端後端才能做事,新版首次安裝時會在下載依賴前先停下來說明這件事。手邊只有 Intel Mac 的人,等於要把運算搬到別台機器或自架後端,這條路對多數人已經不划算。
安裝入口有兩種:macOS 與 Linux 一行指令裝最新 Electron 版,Windows 用 PowerShell 一行指令;不想跑腳本的人直接下載 dmg、exe、AppImage 或 deb。安裝腳本會保留既有的設定、專案與模型,而且只認 Electron 版的套件,不會退回已封存的 Tauri 版。要從原始碼自己建置的人,則需要 Git、Node.js 22 以上、Bun 與 Rust 工具鏈,門檻明顯高一截。
它的隱私立場寫得比多數同類工具細。遙測用 PostHog,明確設計成同意制:用戶不主動打開就不送任何東西;同意之後也只記錄固定的畫面名稱與動作標籤(聲音複製、設計、配音、轉錄),原始的自動擷取、頁面自動上報與錄影功能全部停用,錯誤回報會先把憑證、路徑、檔名與用戶自訂內容清掉才送出。要知道的但書是端點位置:事件送到美國的 PostHog 服務,這在隱私文件裡寫得很明白。
設定裡的隱私頁把三個開關收在同一處:隱浮水印、遙測同意與生成歷史的保留期限(可以設成不限期)。要清點自己曝險面的人,從這一頁開始最快。
錯誤回報在送出前會把憑證、家目錄路徑、檔名與用戶自訂內容先清掉;原始例外的自動擷取、DOM 自動擷取、自動頁面瀏覽與工作階段錄影則全部維持停用。翻譯功能的名目也照實標:後端狀態不明時不宣稱離線運作,介面上的自由翻譯選項其實連的是本機的 Argos 分支,不是某個雲端服務。
合成音訊那邊有一條多數人沒預期到的設計:當後端回報 AudioSeal 可用時,合成產物會走隱浮水印標記路徑,文件用了一個很強的說法,沒有任何產生器能繞過 mark_synthetic 這個標記函式。也就是說它主動在生成音檔裡留下可偵測的合成來源痕跡,這對防冒用是加分,對想把痕跡洗掉的人則是明說了沒有開關。
「本機」之外的真實連外還有三處。模型檔案本身要連網下載,這是第一次使用的必經步驟。配音裡的翻譯目前走本機方案,未發佈的 0.5.7 更新日誌則列出了 Google Cloud Translation 與 Amazon Translate 兩個要自行設定的雲端選項。轉錄清單裡另有一個「OpenAI 相容」選項,接的是自行架設的伺服器,文件還特別標了警告符號。隱私文件的用詞也很節制:後端狀態不明時,不宣稱離線運作。要處理未公開素材的人,這三處設定值得逐一檢查。
它自我定位為「全本機的 ElevenLabs 替代品」,這句話在儲存庫簡介裡就寫著。實際分界可以照官方對照表走一遍:開源版免費、跑自己的機器、音檔留在本機;Pro 版一樣跑本機、音檔一樣不出門,買的是附加功能與商業授權;雲端版還在候補名單階段,以點數計費(從 6 美元起),音檔要上傳。競品那側是雲端服務、閉源、帳號制。也就是說,同名產品有三種資料命運,免費那種反而是最私密的那種。
免費與訂閱的另一層差別在使用節奏:雲端服務按月或按點數付費,本機方案的帳單則是硬體、電費與自己的時間。雲端版還在候補名單階段也值得等後再評,早期雲端服務的計價與資料政策常在正式開放前調整,等待名單本身不代表任何承諾。
下載量側面反映了需求規模:官網下載統計分三個通道:GitHub releases 約 59.6 萬、Docker Hub 103,171 以上、GHCR 40,443 以上(2026 年 9 月 30 日快照)。如果你要的只是單一環節,本站先前覆蓋過幾條更輕的路線:純本機聽寫有 FluidVoice 的免費方案;開源影片翻譯配音的自架流水線有 Linly-Dubbing 與 VideoLingo 可比;只想試聲音複製這個概念,AnyVoice 的線上工具三分鐘就能上手。VoiceStudio 的差異化在把這些環節收進同一個工作台,代價是要自己養模型與硬體。工作台的收納範圍還在長:批次佇列、可重複使用的食譜與資料夾監看(丟檔案進去自動開工)都收在免費範圍內。
順帶一提,它模型清單裡的 Kokoro-82M,本站先前實測過它的線上版,想先聽引擎味道的人可以從那條連結找到樣本;ElevenLabs 那側的變化則可以參考 Studio 4.0 的時間軸。
時間軸有助於校準期待。儲存庫 2026 年 4 月 9 日建立,7 月 12 日發布 v0.3.21 起,十週內連發十二個版本,其中 8 月 14 日的 v0.5.0 把專案從舊名 OmniVoice Studio 更名為 VoiceStudio,9 月 17 日的 v0.5.3 把桌面介面整個換成 Electron(舊 Tauri 殼在同一版宣告退役)。最新已發布的穩定版是 9 月 23 日的 v0.5.6:能讓 Claude Code、Cursor、Codex CLI 與 OpenAI Agents SDK 透過 MCP 協議接進來操作語音功能,加了用存好的聲音接 Twilio 電話的選項(預設關閉),有聲書長章節在 8GB 顯示卡上跑得完而且斷電不毀檔。舊 Tauri 版的更新器裝不了 Electron,遷移前要先手動備份資料目錄。主分支的更新日誌已經寫到 0.5.7(日期標 10 月 17 日),手機伴隨 App 的預覽也在準備中,但截至查證時該版的 release 頁還沒發布,急著嘗鮮的人以 release 頁實際出現的版本為準。
幾個已經進主分支、還沒進穩定版的方向看得出路線圖。手機伴隨 App 的預覽(iOS 與 Android,QR 碼配對後能在手機上聽寫、配音與複製聲音,目前要自己從原始碼建置)寫在未發佈的更新日誌裡;同一份日誌還列了對話式的助理,能挑工作流程、開唯讀的計畫模式,確認後再自動執行操作;遠端的 MCP 客戶端也能走 PIN 碼把關的區域網路分享連進來,分享功能一關就斷線。容器化路徑已經收斂到官方的 GHCR 映像(含 ROCm 版本),Linux 的 AppImage 改用靜態執行環境,不再依賴系統裝的 libfuse2。介面本身內建 21 種語言,繁體中文在清單裡,俄語、泰語、越南語也都齊,介面本地化的覆蓋比多數開源專案認真。
工程紀律也反映在他們怎麼防效能退化。CI 裡掛的不是計時測試,而是操作次數預算:串流合成每個句子段落只能呼叫一次引擎生成、快取段落的重新混音必須是零次合成呼叫、多目標語言的翻譯要走批次渲染。要放寬任何一個預算,得在同一個拉取請求裡改掉期望值並寫下理由,不許為了讓測試過關而默默放水。對一個成立半年的專案來說,這套自我約束並不常見。
兩個現階段的提醒。其一,安裝檔未簽章或僅臨時簽章、也未經 Apple 公證,Windows 與 macOS 都會跳信任警告,這是開發者在版說明裡自己寫的現狀,不是下載到假檔。其二,別拿「快」當下載理由:官方效能榜單的表格目前是空的,維護者自己標注「尚無已驗證的量測列」,所有速度描述都停留在文件層的定性說法。它十週十二版、議題與修復都在推進的迭代節奏,比大多數同類開源專案誠實得多,但這終究是一個半年大的年輕專案,工作流程建立在它上面的人,要有跟著版本遷移的心理準備。
回查的落點也簡單:硬體與 Intel Mac 的邊界看安裝文件,商用可行性看那份模型授權盤點檔的更新日期,版本狀態看 release 頁。這三處任何一處變動,上面的判斷就該跟著重算。模型盤點檔每個月都可能更新,商用判斷的有效期跟著盤點日期走。