TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

OpenAI 於 10 月 30 日向已核可研究客戶推出 GPT-6 Rosalind Research:模型與 GPT-6 Astra 共用同一組權重、沒有額外訓練,改變的是存取資格、回答邊界與治理要求,API 輸入與輸出單價都漲為 5.5 研究版的三倍,也比旗艦 Astra 貴五成。三項生命科學測試分數的讀法、安全評估的分類與未達門檻項目,以及兩週 Admin Preview、人工覆核與資料保留分開核定的部署條件,是判斷這次更新值不值得跟的關鍵。
用 AI 摘要這篇文章:
OpenAI 在 2026 年 10 月 30 日把生命科學研究模型 Rosalind 推進到 GPT-6 世代,對象是通過核可的研究組織。這次更新最容易被寫錯的地方,值得在開頭就講清楚:模型本身沒有換,GPT-6 Rosalind 與旗艦模型 GPT-6 Astra 共用同一組權重,官方在系統卡附錄裡明說沒有追加訓練資料,也沒有做額外的後訓練。真正被更新的是包在模型外面的東西:誰能申請、哪些問題可以問、模型回答的邊界,以及 API 帳單,輸入與輸出單價都是前一版的三倍。
時間軸可以對齊。系統卡附錄 10 月 30 日發布在 OpenAI 的 Deployment Safety Hub,同日 API changelog 上架模型名稱 gpt-6-rosalind;上一代 GPT-Rosalind-5.5 的系統卡發布於 6 月 3 日,9 月 8 日在 API 一般可用,10 月 5 日起計費。Rosalind 家族的定位在 5.5 與 6 兩代系統卡裡都寫得很明白:給生物學、藥物發現與轉譯醫學的前沿推理模型,用較少的生醫問答拒絕,換取受控管道下的研究存取。
只使用 ChatGPT 一般聊天分頁的讀者,要先知道一件事:GPT-6 Rosalind Research 不出現在 Chat 分頁,它在 Work 與 Codex 開放,API 要另外申請核可。下面把官方文件攤開來讀:同權重的前提、三項測試分數的讀法、放寬邊界的量化代價、風險分類停在 High 的依據,以及核可與治理的完整條件。
系統卡附錄的模型資料與訓練一節寫得直接:GPT-Rosalind-6 使用與 GPT-6 Astra 相同的權重,這次發布沒有增加訓練資料,也沒有執行額外的後訓練,底層模型的訓練細節要看 Astra 的系統卡。所以「OpenAI 重訓了一個生醫專用模型」這個說法,可以確定是誤讀。
那行為差異從哪裡來?官方的設計描述是:Rosalind 對合法的進階生物研究,比一般對外開放的 ChatGPT 模型更有用,支援包含部分雙重用途主題的生命科學工作流程,而這些主題 GPT-6 Astra 在一般存取下可能會拒絕;模型仍然拒絕會實質推進生物武器化的請求,並保留其他安全主題的拒絕行為。資安方向甚至收得更緊:在繼承 Astra 標準資安防護(包含即時阻擋)之外,再加上更保守的資安拒答邊界。
文件裡有一處值得攤開的張力。附錄一處說本次沒有做額外後訓練,防護章節卻寫著「我們仍會調整模型,讓它拒絕或安全回應會實質推進嚴重生物武器化的請求,這項訓練與分類器及離線緩解措施的訓練分開進行,以降低防護之間的相關性」。兩段並列出現在同一份文件裡,官方沒有進一步解釋如何調和。對使用者的實際影響有限:行為差異出自官方所描述的部署控制與模型層安全防護安排,選型時不需要假設背後另有一套生醫訓練資料。
官方在三項生命科學基準上比較新舊兩版,方法值得先看。GPT-Rosalind-5.5 的分數是用相同基準版本、相同題目重跑出來的,因此與它當年發布時的數字不同;計分方式是先把每題內多個回應的分數平均,再讓每個題目等權。這種安排排除了把不同考卷差異當成模型差異的空間。
化學那項是 MedChemBench v7,測化學結構判讀、構效關係與藥物效力毒性預測,兩版比較同樣 99 題,每個推理預算下每題最多 9 個受評回應。最高受測預算下,平均規準分數 GPT-6 Rosalind 是 49.6%,5.5 是 28.9%。規準分數的意思是按題目要求評分,它衡量的是模型在這類結構與活性推理題上照評分規則拿到的分數,不能換算成任何新藥研發或真實實驗的成功率。
基因體與量化生物那項是 GeneBench Pro v13,測代理規劃並執行生物資料量化分析的能力,129 題,每個模型在每個推理預算下各生 7 個回應,用來估計單次嘗試的成功率。最高預算下是 37.7% 對 16.7%。官方特別註明這個評測使用了不同於正式產品的專門配置,所以這個比例不能直接當成一般產品介面裡每次任務的表現。
第三項 LifeSciBench Gold 的題目來自實際在做研究的生命科學家,官方排除了 6 個被標記可能有題目或環境問題的個案,兩版在其餘 94 題上比較,每個推理預算下每題最多 8 個受評回應。最高預算下平均分數 61.3% 對 44.0%。
三個百分比的分母、評分方式與評分對象都不同:規準分數、單次成功估計、平均分數。把它們平均成一個「生命科學成功率」是錯的,官方文件也沒有提供這種數字。對研究團隊來說,這組分數的用途是訊號:同類任務值得用自己的資料、自己的成果標準重跑一次比較,而不是把 49.6% 或 61.3% 直接引用進計畫書或採購案。
「回答空間更寬」在這份文件裡不是形容詞,防護評估表把它量化了。這張表量的是模型加上防護之後,回應通過安全評分器的比例,越高越好,三個模型並列:
| 評估類別 | GPT-Rosalind-6 | GPT-Rosalind-5.5 | GPT-6 Astra |
|---|---|---|---|
| 生物安全(嚴重) | 98.1% | 88.6% | 99.8% |
| 生物安全(敏感) | 79.0% | 18.3% | 99.8% |
| 生物安全(特定序列) | 83.8% | 50.0% | 95.6% |
| 雙重用途 | 84.6% | 69.0% | 97.8% |
| 化學濫用(嚴重) | 100.0% | 59.1% | 100.0% |
| 良性題合規率 | 100.0% | 97.7% | 91.6% |
讀法可以分成三層。嚴重生物武器化相關的安全通過率維持高檔:98.1%,比 5.5 的 88.6% 高,略低於 Astra 的 99.8%。良性題的合規率是 100%,高於 Astra 的 91.6%,這一欄就是「更寬」的直接收益:一般版有接近一成的良性生醫題無法完全配合,可能拒答,也可能附帶但書,Rosalind-6 在這組題目則全部完全配合。代價則集中在敏感類:79.0%,比 Astra 的 99.8% 低了超過 20 個百分點,特定序列與雙重用途兩欄則分別低了 11.8 與 13.2 個百分點。
OpenAI 在表前說明,因為這是受控存取的部署,主要採計的是嚴重生物安全那一欄;其餘欄位的分數是回應通過所設定安全評分器的比例,一個回應未通過代表被該標準標記,不必然等於完全不安全。這是官方的採計立場,採購端可以有自己的風險偏好,但三個模型的數字都攤在同一張表上,各自的交換看得見。
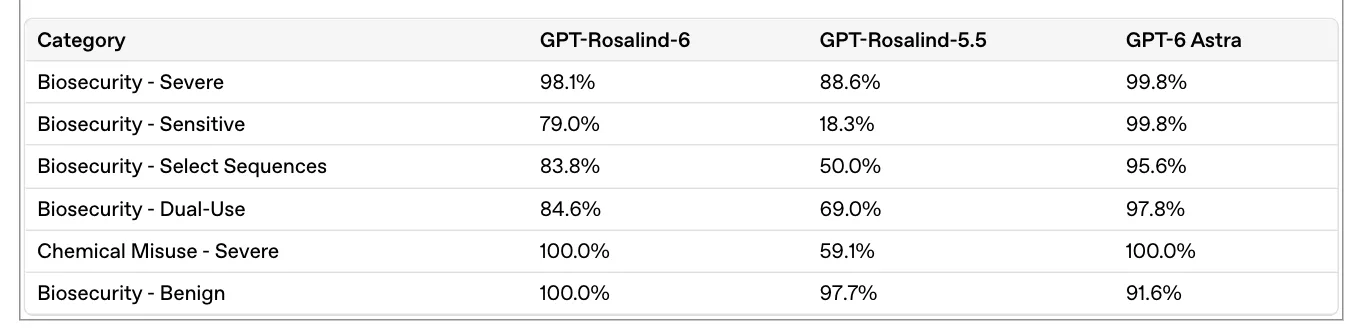
另一個誠實面是:這些評測是故意出得難的。官方寫明題目圍繞既有模型還給不出理想回應的案例建立,評測與評分方式持續更新,所以分數不能直接與舊系統卡對照。這張表支持的是「邊界被調到哪裡」的判斷,若拿它推出「這版比上一版更安全或更危險」的單向結論,就超出它能承載的範圍。
OpenAI 用自家的 Preparedness 框架給這次發布定位:生物與化學領域列為 High 能力,未達 Critical 門檻;資安沿用 Astra 的評估列為 Critical;AI 自我改善低於 High。
High 的判定基礎是四項測驗。把拒答調整算進去之後(把拒答視為答對,估計安全訓練可能蓋住的能力),四項中三項超過門檻:實驗室程序除錯 TroubleshootingBench 是 59.0% 對門檻 36.4%,生物風險知識調整後的共識分數是 85.0% 對門檻 80%,多選病毒學除錯是 59.9% 對門檻 31%;未達標的是 ProtocolQA 開放作答,42.0% 對門檻 54%。觀察分數與 5.5 相比大多走高,唯一退步的是生物風險知識,78.3% 對 79.2%,差距在一個百分點內。
Critical 的四項評測全數未達門檻:AAV 衣殼包裝預測的 Spearman 相關是 0.529,門檻 0.600;SHP2 蛋白功能預測的平均 R 平方是 0.38,門檻 0.60;冠狀病毒 ACE2 細胞進入評估的綜合分數是 0.42,門檻 0.75;噬菌體與質體共同演化預測的負對數概似是 13.41,門檻要求 9.40 以下,這項越低越好。與 5.5 相比各有漲跌,官方的總結是混合結果。門檻本身是專家判斷下的初步估計,會隨評測精煉而調整。
蛋白質設計類評測的意義可以對照外部進展。蛋白結構與功能預測是這波生醫 AI 的主戰場,先前介紹過 Claude 設計蠍毒毒素結合蛋白的研究,模型在設計端的成績與這裡的預測端評測,屬於同一條能力曲線的兩端。Rosalind-6 在這幾項離 Critical 門檻還有距離,這也是官方把它放在 High 而非 Critical 的直接證據。
資安維持 Critical 的依據主要來自 Astra 的評估,附錄補了一個回歸測試:把九個已知歷史越獄攻擊在十個固定的 ExploitBench 任務上重放,關閉即時阻擋以量測模型本身行為,七個攻擊的平均任務成功率是 14.3%,Astra 是 15.7%,兩個攻擊因全部嘗試都以錯誤或超出回合限制結束而被排除。
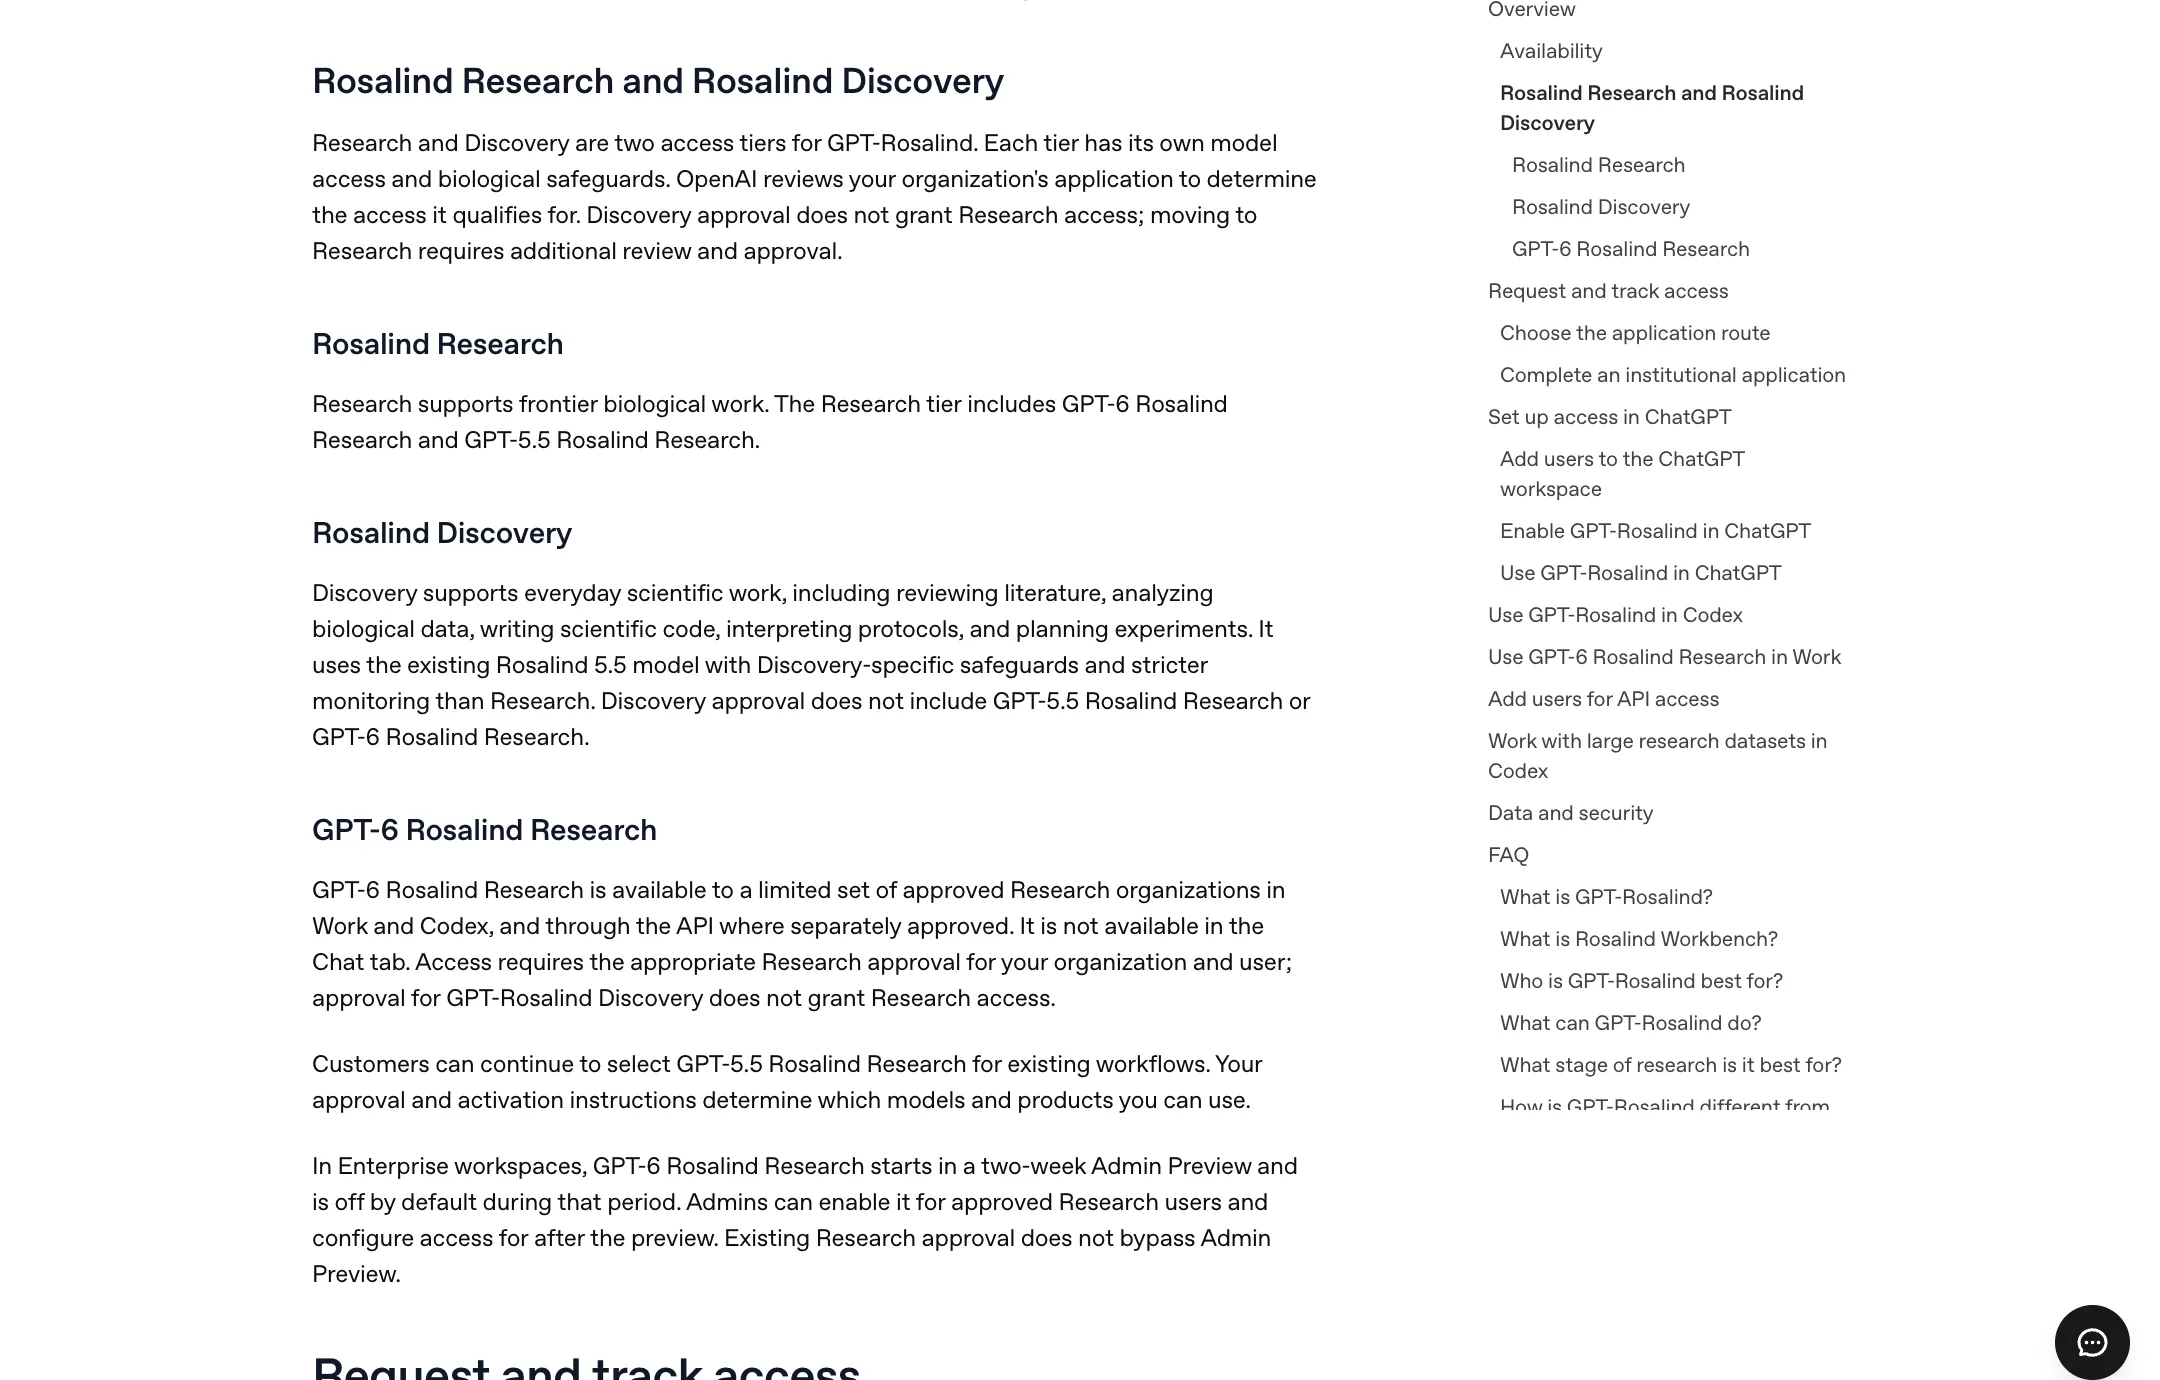
Rosalind 的存取資格分成 Research 與 Discovery 兩種,對應不同的模型與防護。Discovery 面向日常科學工作,例如文獻整理、生物資料分析、寫科學程式碼與規劃實驗,使用 Rosalind 5.5 模型,加上專屬防護與比 Research 更嚴的監控;Discovery 的核可不包含任何一版 Rosalind Research,要轉到 Research 需要另外的審查與核定。Research 層同時提供 GPT-6 與 5.5 兩版,既有客戶可以繼續選 5.5。
介面範圍要對準:GPT-6 Rosalind Research 開放給有限數量的已核可 Research 組織,在 Work 與 Codex 使用,API 需另行核可,Chat 分頁不提供。已經有 Research 資格的使用者如果發現模型不在清單裡,第一步是回頭確認組織核可、啟用狀態與模型權限都完成,避免重複送件。
申請流程本身有幾個容易漏看的細節。送件人不必是工作區擁有者或管理員,但必須是有權代表組織的已驗證成員;通過審查後,還要由已驗證的擁有者或管理員完成另外的最終核定、接受條款並確認定價,啟用才算完成。說明中心特別提醒,通過驗證或接受條款本身還不代表模型已經可用。申請進度可以用送件帳號查詢,機構與學術計畫兩條路的狀態頁不同。
在 Codex 裡,生命科學研究外掛把這些工作流程接到科學工具、資料庫與資料來源;處理大型資料集時,官方建議的做法是把原始檔留在本地目錄、資料庫或核可的儲存系統,讓模型針對研究問題做聚焦的工具呼叫分析,而不是把整批原始資料塞進對話內容,這對習慣把檔案直接貼進聊天的團隊是個要調整的使用習慣。
組織端的審查看四件事:正當的生命科學或相關任務、可信用途、適當的研究與營運治理、安全控制存取的能力。非政府申請者會加做企業驗證與合規篩查,確認申請者真實且可歸責;政府端另有指定實體的途徑,限於生物安全、生物保全、公衛整備與生物防禦等用途。官方同時講明,這次發布不擴大既有資格範圍,美國大學實驗室的學術補助計畫維持原條件。
組織過了還沒完。核可的企業客戶必須把存取限於有正當需要的授權使用者,落實最小權限、到職訓練與內部風險控制。Enterprise 工作區裡,GPT-6 Rosalind Research 先進入為期兩週的 Admin Preview,這段期間預設關閉,管理員可以為已核可的 Research 使用者開啟,並設定預覽結束後的存取安排;既有的 Research 核可不會繞過 Admin Preview。
工作區的權限設定同樣有層次。使用自訂角色的 Enterprise 與 Edu 工作區,由擁有者建立角色並指派給已核可使用者,角色裡要開啟生命科學與對應的技能和 Codex 權限;官方建議把預設成員角色的 Rosalind 模型控制維持關閉,只替自訂角色開啟,沒有拿到其他角色的使用者就繼承關閉的預設值。管理員可以在支援的範圍內更新既有角色,但不能建立或指派自訂角色;角色變更最長要五分鐘才生效,急著驗證權限的團隊要把它算進時程。換句話說,從組織核可到研究者真的能用,中間還有使用者授權與工作區開關兩道門。
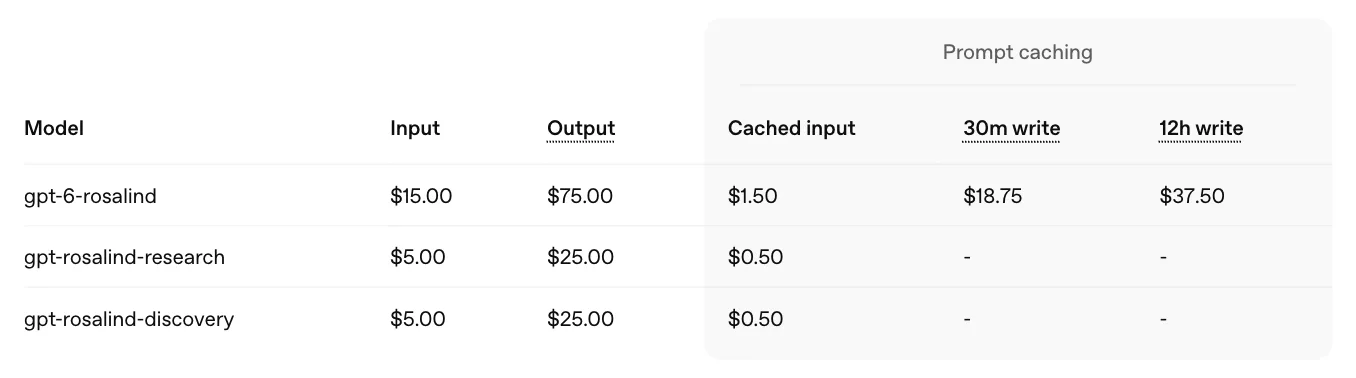
價格寫在 API 定價頁的生醫模型區:gpt-6-rosalind 每百萬 token 輸入 15 美元、輸出 75 美元、快取輸入 1.5 美元;gpt-rosalind-research(5.5 版)維持輸入 5 美元、輸出 25 美元、快取輸入 0.5 美元;Discovery 版同樣是 5 與 25 美元。輸入與輸出單價正好都是前一版的三倍;對照同一張定價頁上的旗艦 gpt-6-astra 標準價 10 與 50 美元,這組同權重的生醫版還比旗艦貴五成。以 5.5 在 9 月 8 日一般可用、10 月 5 日開始計費的節奏看,新舊兩版會在定價表上並存,已在 5.5 上的工作流程沒有被迫遷移的壓力。
三倍價格對應的義務也寫進了條件裡。客戶要在模型輸出用於實驗、發表或有重大影響的決策之前,安排合格人員覆核;要維持與高能力生醫模型相稱的安全控制,包含身分與存取管理、管理者控制、最小權限,以及在人員不再有正當需要時移除存取的程序。模型存取與資料保留安排是分開核定的兩件事,拿到 Rosalind 核可本身不會自動啟用強化隱私或零資料保留,說明中心對此寫得明白,採購端應該把資料處理條件當成獨立的核對項目。
OpenAI 也保留了部署後的手段:監看、調查,以及對不當使用限制或撤銷存取,訊號包含自動安全分類器與帳號或組織層指標。這些條款合起來,描出了這次更新實際的商業形態:買方付三倍單價,拿到的是同一組權重、放寬的生醫問答邊界,以及一整套把責任分配講清楚的使用條件。
地區供應沒有被提及。官方文件沒有說明台灣或在台團隊的申請有任何限制或通道差異,申請以組織為單位,走機構協議或美國大學的學術計畫兩條路,審核時長與通過率也沒有公布。
資料落地要另行確認。定價頁載明 2026 年 3 月 5 日之後發布且支援資料落地(data residency)的模型,區域處理端點要加收一成費用;定價頁未列出適用資料落地的模型清單(官方另以 Your data 指南記載),gpt-6-rosalind 是否適用,要向帳號團隊或該指南確認。
Admin Preview 的細節也有限。兩週預覽從哪個時點起算、預覽結束後的存取設定有哪些選項,說明中心只給了原則性描述,實際操作要等各工作區收到啟用指示才會清楚。
最後是數字的時效。價格、測試分數與存取條件都屬於會變動的資訊,之後要引用這些數字做預算或採購決策,回到 OpenAI 定價頁與說明中心再確認一次,比引用任何轉述都可靠。
對研究團隊與觀察者,這次更新的訊號比單一產品大:前沿實驗室開始把「誰能問什麼問題」做成有明確規格、明確價格與明確責任分配的產品線。台灣的生醫團隊眼前要判斷的其實很具體:自己的任務是否落在 Astra 一般存取會拒答、而 Rosalind 系列會好好回答的那一塊。若是,再衡量三倍價差換到的能力進步,治理包的條件才開始有意義;若否,續用 5.5 或再觀望都合理。這條產品線會不會往下延伸到更小的團隊,取決於這一輪受控部署累積的安全紀錄,以及自動化科學工廠這類替代路線給出的性價比壓力。