TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Google 與 Eedi 在 10 月 29 日公布英國十校、1,179 名學生的課堂隨機對照試驗:AI 輔導在平台改錯、跨題遷移與期中小測追平真人教師,外部施測的 Star Maths 卻連真人一對一都沒贏過標準補救。94.7% 草稿批准率量的是材料品質,附錄與整學年追蹤試驗都還沒定案。
用 AI 摘要這篇文章:
Google 的 LearnLM 團隊與英國數學學習平台 Eedi,在 10 月 29 日(台北時間同日 17:00)公布擴大版課堂隨機對照試驗的技術報告。這種試驗把參與者隨機分到不同支援方式再比較結果,在教育科技領域仍然少見;這次涵蓋十所英國公立中學、1,179 名 12 到 15 歲的學生與四種支援方式,追蹤十週課堂活動。結果可以先一句話講完:在平台內的改錯與跨題遷移,AI 輔導追平真人教師、明顯勝過標準補救,期中小測也較高;到了外部獨立施測的 Star Maths 標準化測驗,兩個 AI 組與標準補救的差距落在 -0.01 到 +0.02 個標準差,區間都跨過零。更值得停下來看的數字在真人組:一對一真人輔導同樣沒有贏過標準補救,點估計是 -0.09 個標準差。
先把這則新聞的範圍畫清楚。這是一份研究發布,不是產品功能更新:一般 Gemini 用戶的介面、額度與行為都沒有改變。需要認真讀它的是要判讀 AI 教育證據的人,包含學校行政、教育科技採購,以及關心孩子數學學習的家長。從設計就可以畫出適用邊界:研究評的是「真人逐則把關的 AI 輔導」這套課堂流程,回答不了把老師拿掉會怎樣。
參與的十所學校都是 Eedi 的既有使用學校:英格蘭六所、北愛爾蘭兩所、威爾斯與蘇格蘭各一所,共 58 個數學班。學生在同一班內隨機分進四組:Eedi 原本的標準補救(專家設計的提示與影片)、專家教師線上一對一、帶題目脈絡的 AI 輔導,以及再加上個人學習脈絡的 AI 輔導。試驗期間每人維持原組,每週在原本的數學課使用平台約 30 到 50 分鐘;加上一週假期與期末施測,全程共 12 個日曆週。設計與分析計畫預先註冊在 AEARCTR-0018079,分析採貝氏架構,並經獨立倫理委員會審查,家長與學生可隨時退出。
Eedi 的流程本身也值得認識,因為四組都在同一套流程裡運作。平台先用診斷題找出學生背後可能的錯誤概念;答錯並接受支援後,學生再獨立作答另一道同主題、換過數字或細節的題目,避免只是重答剛剛看過的題目。也就是說,無論拿到的是提示、真人還是 AI,學生最後都要自己再算一遍,測量的是這一遍的表現。
兩個 AI 組的每一則回覆草稿,都先由真人教育者批准、要求重生成或改寫,才會送到學生眼前。58 位數學教育者輪流上陣:一部分時間親自一對一輔導,一部分時間監督 AI 草稿。這個細節決定了結論能推到哪裡:報告量的是有人把關的 AI 輔導在真實課堂的表現,不是學生單獨面對聊天機器人的效果。
最靠近眼前的測量看理解本身:答錯診斷題、接受支援後,再答同主題的另一題。標準補救組答對率 43.4%,兩個 AI 組分別是 56.9% 與 56.5%,真人組 57.7%。報告給出的事後機率超過 99.9%,三種輔導都優於標準補救,而 AI 與真人之間沒有明顯差距。
再往上一層看近遷移,也就是前一單元的支援能不能幫到下一個單元的新題:標準補救 50.5%,AI 兩組 58.4% 與 58.3%,真人 59.1%。期中小測這一層,各班老師施測八題、涵蓋前四週課程:標準補救 59.6%、真人 61.8%、AI 題目脈絡組 62.1%、AI 個人脈絡組 63.5%,個人脈絡組勝過標準補救的信度 97.1%。到這裡的圖像相當一致:有輔導比沒輔導好,AI 輔導貼著真人走。
分層測量是這份報告在方法上的核心。改錯量的是眼前的理解,遷移量的是能不能帶著走,Star Maths 量的則是跨學期的廣域程度;前一層的優勢不會自動兌現成後一層,這正是接下來轉折的由來。
學生端的行為也留下紀錄。教師或 AI 主動開啟對話時,學生回覆的比例在各組都落在 76% 到 77% 之間;回覆之後,AI 輔導組有 85.4% 到 85.6% 的對話,學生真的動手算數學,而不是只等答案。這對「AI 會不會養出依賴」的擔憂是一個初步的參考點,不過它量的是對話行為,不等於長期學習習慣。
Star Maths 是英國學校常用、用來跨學期追蹤的獨立標準化測驗,由外部單位施測與計分,基準點在 2 到 3 月、期末在 6 到 7 月。標準差在這裡的用處,是把各組差距放到同一個尺度上比較。與標準補救相比,AI 題目脈絡組的效果是 -0.01 個標準差(95% 信賴區間 -0.15 到 +0.14),AI 個人脈絡組 +0.02(-0.12 到 +0.16),兩個區間都跨過零。真人一對一組是 -0.09(-0.25 到 +0.07);報告估計它遜於標準補救的機率 87.1%,遜於 AI 個人脈絡組的機率 94.4%。
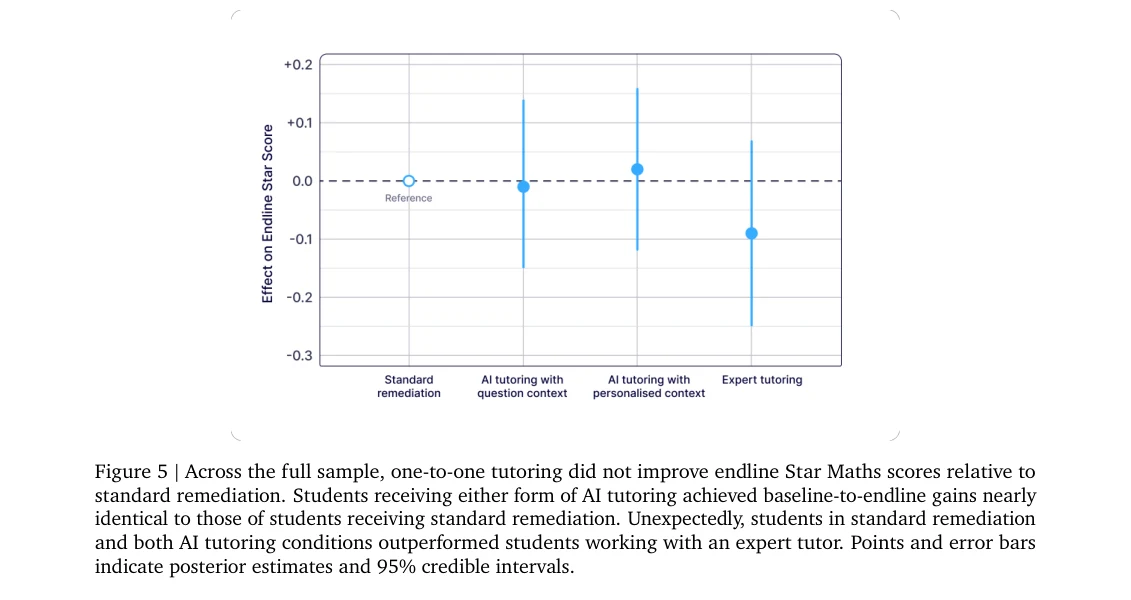
這個結果有兩個意外:AI 沒有整體優勢,真人組反而落到後面。報告作者也把它與「一對一輔導通常能提高標準化測驗成績」的既有研究並列,明言看來牴觸、需要進一步解釋。對讀者的直接含義是:拿這份研究宣稱「AI 教學已經追上真人」,或反過來說「AI 教學無效」,都只挑了對自己有利的那一層測量。
報告的探索性分析指向覆蓋範圍這個機制。十週內完成的學習單元中位數,兩個 AI 組各是 99 個,真人組 77 個,標準補救組 132 個;接觸到的不同數學概念分別是 57、48 與 72 個。多輪對話把一個錯誤聊得深,也就把時間花掉了,Google 部落格版的換算是每個使用時段平均解題約 14 題對 19 題。模型另估計,控制組別後,完成的學習單元數每增加一個標準差,期末 Star Maths 約提高 0.09 個標準差(區間 +0.03 到 +0.16)。要注意這些屬於作者標示的探索性分析:指出可能的方向,還不是已證明的因果。
性別的探索性發現同樣改變整體數字的讀法。標準補救組裡,男生在 Star Maths 領先女生 0.31 個標準差;三種輔導都把這個差距縮小甚至反轉,輔導對女孩較有利,接受輔導的男孩則相對落後。樣本有 66.1% 是男生,因為最大的參與學校是男校,男孩的結果對各組平均值的影響被放大。這組數字同樣不足以拿來為個別學生分派不同的工具。
時程本身也是變數。Eedi 平台曾有一份獨立的兩年叢集隨機試驗:六個月時點的標準化測驗效果同樣小而不確定,明確的整體進步到約一到一年半才穩定出現,全程相對於未使用平台的學生約多出四個月的進步。十週測不出廣域優勢,在這套平台有前例可循。
看批准率之前,分母要先分清楚。模型總共生成了 114,935 份草稿,但學生只要再傳新訊息,舊草稿就會被取代,教師實際作過決定的是 94,385 份,其中 89,406 份、94.7% 原樣批准。對照去年五所學校的探索性試驗(批准率 74.4%),草稿需要修正的勝算下降約 5.87 倍。Google 部落格把這段寫成「從 76% 到 95%」,並稱教學品質提高近 25%,是同一組數字的四捨五入版;文中「超過 1,100 名學生」也是 1,179 的約略寫法,引用時值得對回技術報告的原文。
批准率不能當作學生學會多少的指標。它量的是教師在即時監督時多常願意原樣放行,屬於材料品質與監督行為的訊號。安全面的數字更具體:回頭稽核全部草稿,數學錯誤少於每千則三則,與專家教師相當;要看完整對話才能發現的情境錯誤,AI 佔訊息的 0.24%,真人 0.18%;把錯誤答案說成正確的比例,AI 0.16%,真人 0.15%。整個語料只有 6 份草稿被標記,比例不到 0.01%,去年是 0.14%;這 6 份全數沒有送到學生面前(5 份在即時審查中被替換、1 份被學生的新訊息取代),其中 2 份屬語氣疑慮。AI 在 98.8% 的對話裡不直接給答案,真人組是 96.3%。另外要記得,這份研究由 Gemini 的開發方與 Eedi 平台方合作完成,這些稽核屬於作者自查流程,附錄發布之前無法外部重驗。
把關的教師端則有一組小樣本的期末訪談(八位)。六位特別提到能同時支持更多學生、又維持教學品質;七位表示同時盯著多段即時對話仍然吃力;幾乎全部都說,審 AI 草稿的經驗回頭滋養了自己親自輔導時的解釋方式。報記錄下的教師共識是:人類教師仍然不可或缺,特別是在診斷學生錯誤概念這一步。
試驗期間模型跟著版本更換:Gemini 3.1 Pro 用到 4 月 21 日,之後換 3 Flash 到 5 月 21 日,再換 3.5 Flash 到試驗結束。也就是說,結果屬於一套持續演進的系統,沒辦法抽出其中某個型號,把全部成果算成它的單獨能力。
個人脈絡組的實作也不如設計完整。每段對話開始時,平台都會先讓 Gemini 寫一份不給學生看的教學計畫,之後每則提示都帶著這份計畫運作;題目脈絡組拿到的已是診斷題、選項、正確解法與教師寫的錯誤概念說明,個人脈絡組再加上學習歷史摘要。問題在於,平台原本要把先前的對話摘要一併提供給模型,但一個平台錯誤讓摘要無法跨工作階段保存,模型實際拿到的是過去表現、速度與常見錯誤,不含先前對話內容。結果是教學計畫更常引用學生的學習歷史,卻沒有轉成額外的學習優勢;學生等待回覆的中位數反而從 16 秒增加到 19 秒,真人組則是 24 秒。要回答「個人化有沒有用」,這次的誠實答案是:這種實作方式、在這段期間,沒有。
同日公告還有義大利研究,常被與英國試驗並排,但兩者證據層次不同。義大利部分為期一年、31 所學校、1,600 名教師(代表超過 24,500 名 13 到 18 歲學生),與慈幼會學校體系及羅馬的宗座慈幼大學合作;方法是蒐集課堂活動與教師自報:用 Gemini 共同備課時,自報教學創作感從 30% 到 79%,講課式授課減少 38%,學生自報投入從 77% 到 84%,由活動設計本身帶動投入的比例從 23.2% 到 52.2%。這些是接受度與教法改變的線索,不是隨機分組量出來的學習成效,參與人數再多也不會自動變成對照試驗。公告裡連到的 CNOS-FAP 執行報告,涵蓋的又是範圍更大的整體計畫,與 31 校子研究的口徑不同,數字同樣不能搬來搬去。
附錄還沒發布。報告正文多處引用附錄 A 到 H 的細節,附錄本體不在這份 22 頁文件裡,官方在最後一頁說明還需要時間整理,之後會另行公布。覆蓋範圍與性別分析也都標示為探索性質,要等附錄與完整模型設定出來才能重驗。Google 另表示正在規劃橫跨整個學年的追蹤試驗,並擴充測量指標;這幾件事任何一件落地,前述結論的強度都值得回頭校準。
對照 TechMoon 先前介紹過的 Gemini Teacher 這類把 Gemini 放進練習情境的第三方工具,或 Google 自家 Gemini Notebook 的互動式學習總覽,再到試算表 Gemini 填表新增的每格來源引用,產品線一直在往「AI 陪讀可查證」的方向推。這次的不同點在於,Google 直接用隨機對照試驗檢驗學習成效,而不是只展示功能。
若要在學校脈絡參考這份研究,比較穩的做法是把平台內改錯、跨題遷移與廣域評量分開設定目標與期程,把真人把關留在流程裡,並且以學期以上的尺度衡量累積效果;這是從分層測量結果推得的建議,不是報告的官方結論。家長與一般用戶不需要因此調整任何設定,這份研究不改變任何產品行為,它改變的是「AI 輔導有效嗎」這個問題的答案結構:有效到哪一層、還沒證明到哪一層,現在都有數字可以指認。