TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

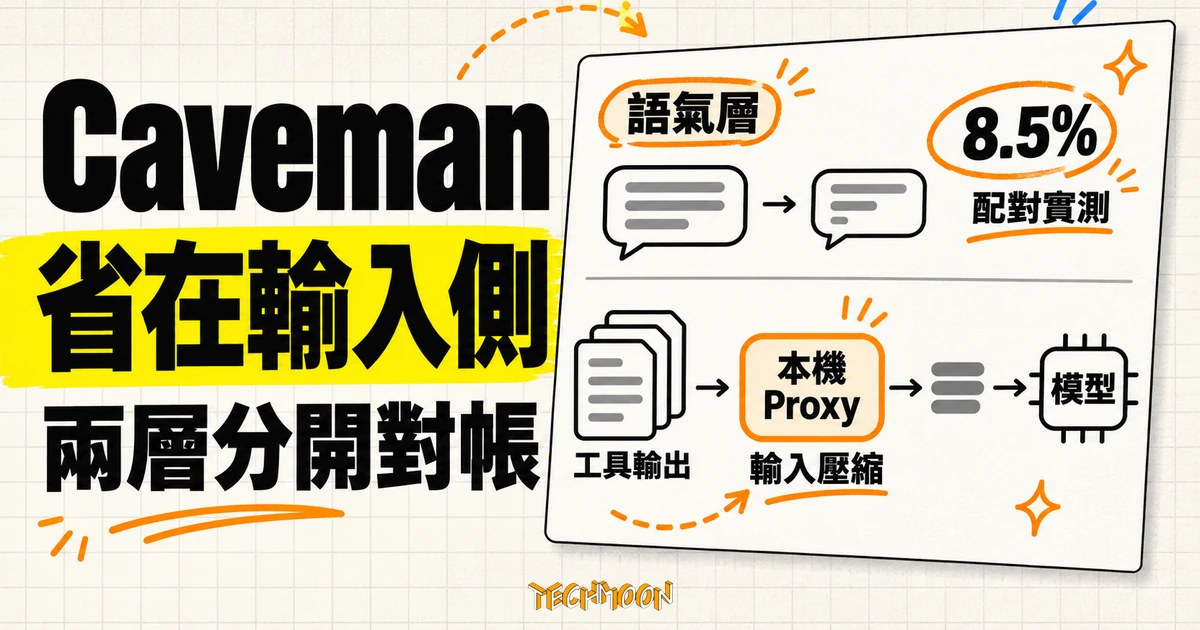
開源 token 壓縮工具 Caveman 的 v4.1.0 維護版為本機 Proxy 補上三道柵欄:壓縮前先擋含憑證的檔案、還原儲存區改為 14 與 30 天過期制、forward_headers 設定錯位直接拒絕啟動;對帳線則顯示語氣技能層被第三方實測壓回 8.5%,真正的節省承諾落在輸入側。
用 AI 摘要這篇文章:
開源 token 壓縮工具 Caveman 在 2026 年 11 月 8 日釋出 v4.1.0 維護版。這個七個月長到 12.1 萬顆星、分支數達 7,100 的專案,這次改動看似平淡:憑證阻擋、還原儲存區自動清理、一項破壞性設定變更。真正值得停下來看的,藏在官方文件裡的另一條線:過去一年這個工具的省 token 承諾,被拆成「語氣技能層」與「本機 Proxy 輸入層」兩半,各自經歷了一輪殘酷對帳。行銷期的 65% 節省假設已被官方自己撤回;JetBrains 的配對實測把語氣層壓回 8.5%;跑滿 300 輪的外部對照發現總帳單只多了 0.06%。剩下的錢在哪裡?官方把籌碼全押在輸入側,而 v4.1.0 補的正是這一層的柵欄。
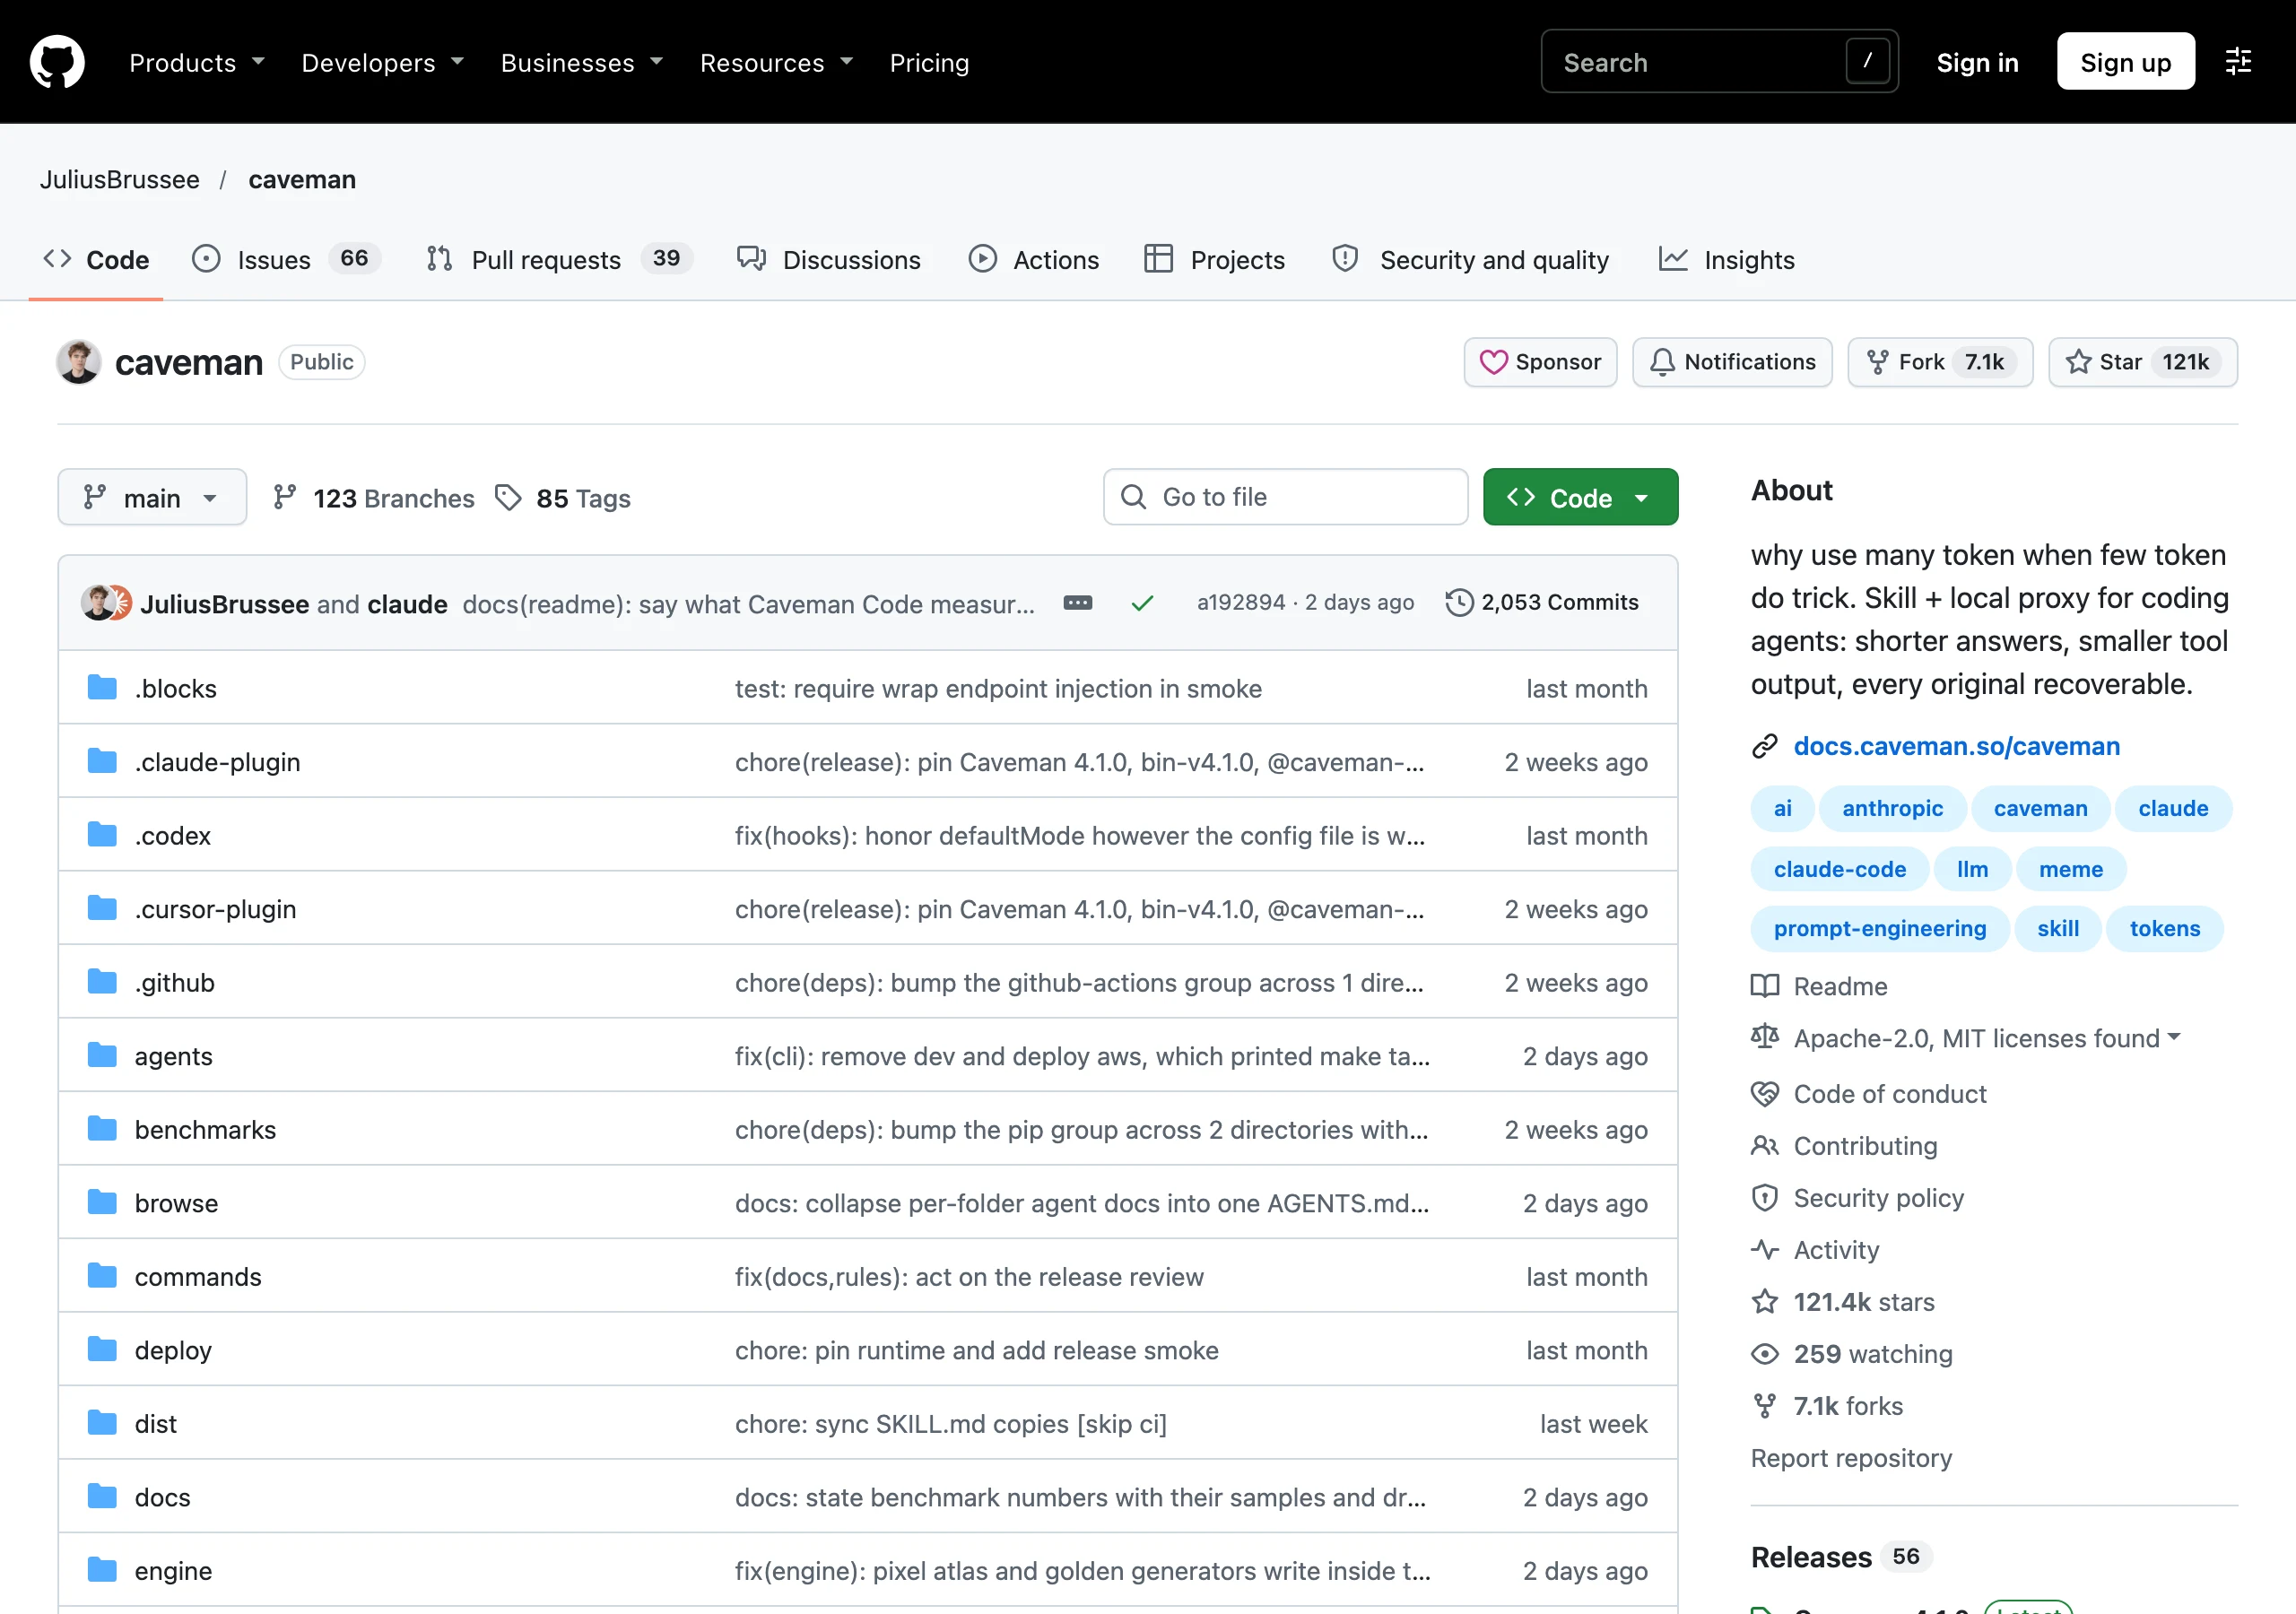
先對帳最響亮的那個數字。Caveman 早期的統計報表對外顯示節省比例時,套用了一個固定的 65% 輸出佔比假設。專案文件現在的白紙黑字寫得直白:當時沒有任何已提交、經審查的原始結果支撐這個數字,現在的報表已經不再顯示數字節省後綴,歷史欄位保留但不轉換為「已驗證節省」。
接手驗證的是 JetBrains。2026 年 7 月,JetBrains 團隊用 SkillsBench 的 86 項任務對 Claude Code 做配對 A/B:一組原生、一組強制啟用 Caveman 技能,模型用 claude-sonnet-5、低推理強度。結果直接寫在開頭導語:宣稱省 65%,實測省 8.5%。而且這 8.5% 還是「強制啟用下的上限值」,平常情境只會更低。品質面沒有顯著差異(符號檢定 p=0.82),但方向值得留意:技能組平均任務分 0.311,基準組 0.326,差距不顯著、卻是往低的方向偏。
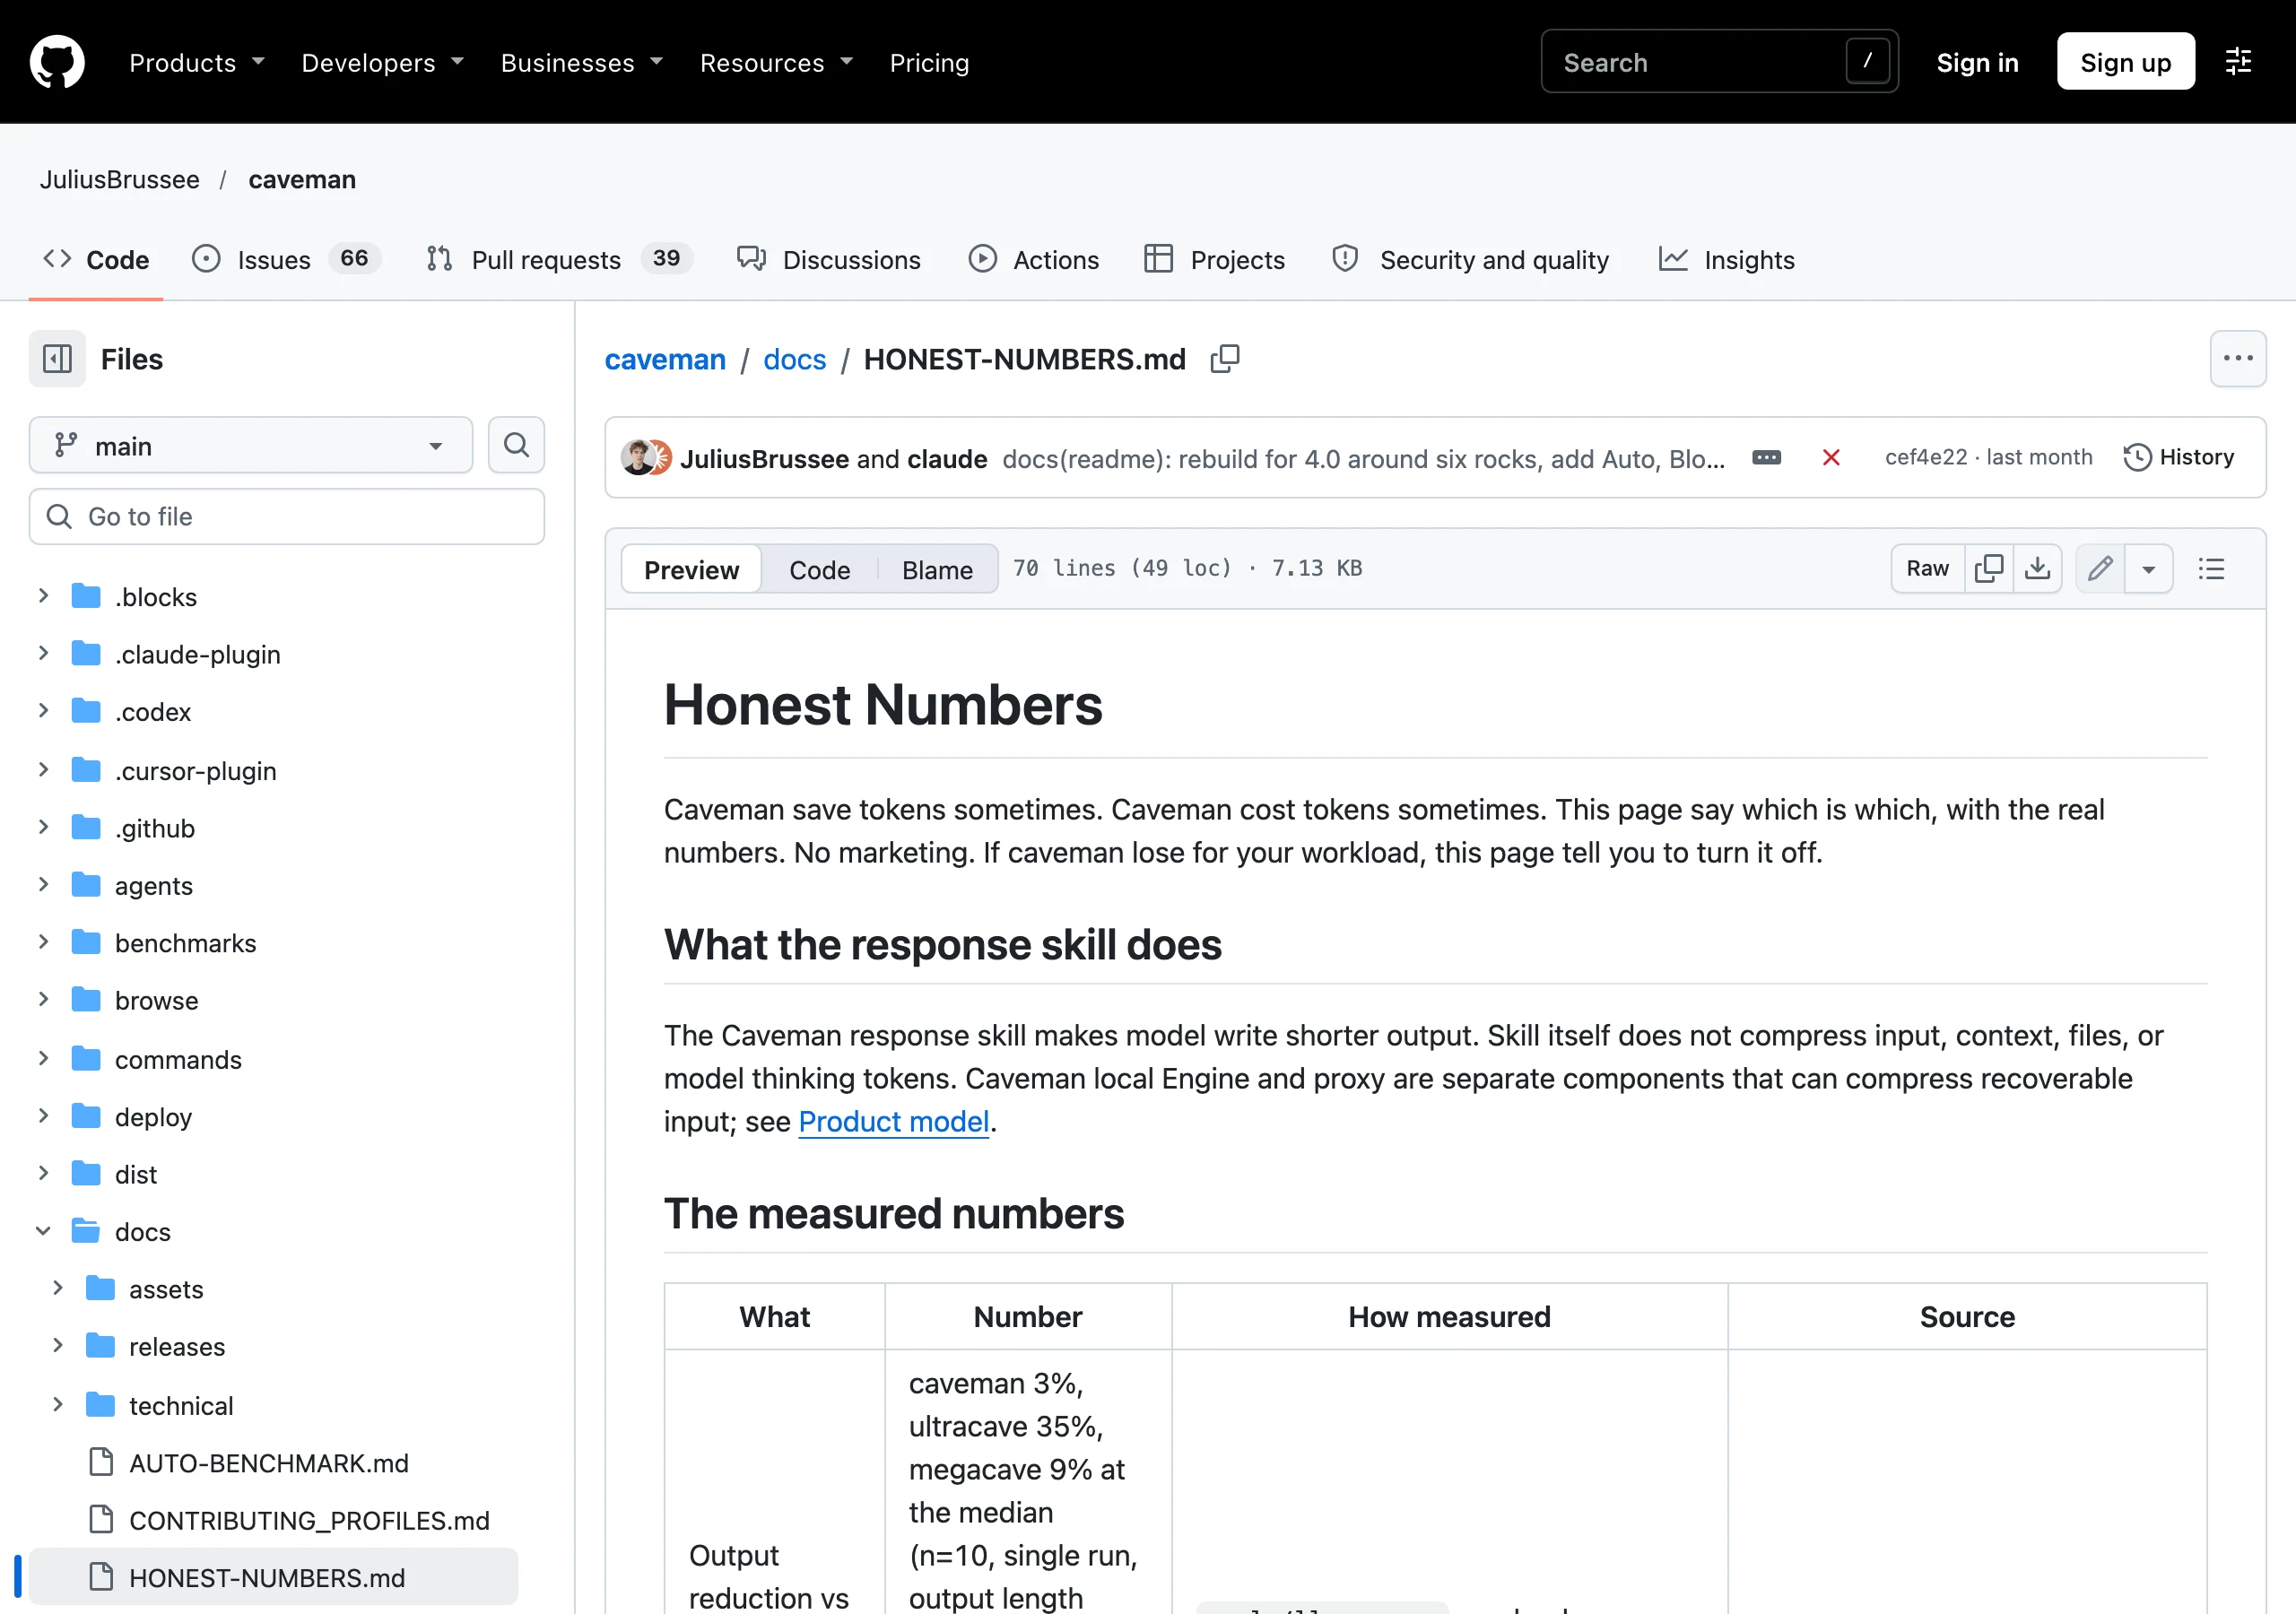
官方倉庫對這篇實測的態度是正面收錄,連同一群「外部 A/B」一起放進名為 Honest Numbers 的文件頁。這頁文件的開頭就寫明立場:Caveman 有時省 token,有時花 token,這頁告訴你哪種是哪種,如果你的工作負載屬於虧損區,這頁會叫你關掉它。
為什麼一個把回覆壓到電報體的工具,實測只省得動 8.5%?外部對照給出了殘酷的算術。LemonCrow 實驗室跑的是每臂 300 輪的對照:帳單輸出確實少了 44.1%,但總成本反而多了 0.06%,因為每次執行快取脈絡得多注入 1,532 個 token 的規則文字。另一位開發者翻了 662 個 Claude Code 工作階段的紀錄:輸出只佔全部 token 的 0.3%,技能的淨效果落在正負 0.2% 之間。結論收斂成一句話:代理工作的帳單大頭是輸入與快取重讀,一條只改說話風格的規則碰不到它。
官方文件收集的失敗案例裡還有兩個更尖銳的。有人回報簡短的程式問答情境淨虧:固定的規則開銷超過輸出縮減,帳單不降反升。另一個 Cursor 對照更極端,某輪 A/B 顯示開了技能反而燒掉 4.3M token、關掉只要 1M,牆鐘時間還多一倍;那次執行事後無法重現,官方據此下的結論很謹慎:規則重注入、重試與快取計費方式確實可能吞掉全部節省,遇到淨虧就該關掉。順帶一提,LemonCrow 那組 300 輪對照量的是 Caveman 3 改寫規則前的版本,官方把它歸在「證明取向、而非今日檔案」的證據區。
還有兩個邊界條件會直接讓語氣層歸零。按請求計費的服務(例如 GitHub Copilot 的點數制)裡,短回覆仍然是同一次請求,省無可省。而官方文件自己列出的中位數排行還有個反直覺細節:最激進的 /megacave 模式實測只縮 9%,排在 /ultracave 的 35% 後面。這組數字是 10 個樣本、單輪執行、量的是 3.1.0 版規則,官方註明至今沒有重跑過。技能對回覆樣板的壓縮本領倒是透明可查:同一段 React 重繪解釋,預設回覆 63 個 token,/caveman 模式 20 個、/ultracave 14 個、/megacave 13 個,用 tiktoken 的 o200k 詞表計數。樣板省得漂亮,只是樣板從來不是帳單的大宗。
真正給這條路定調的是學界。Adobe Research 團隊的 CAVEWOMAN 論文(arXiv 編號 2606.24083)用 8 個模型、5 個資料集、5 級壓縮強度做了雙通道實驗:壓縮模型回覆確實省,多數 API 模型省 1.4 到 2.4 倍、最佳 3 倍;但壓縮使用者提示詞是嚴格的雙輸,淨成本升到約 1.15 倍,最差資料集 1.8 倍、強壓縮下 2.7 倍,準確度同時崩潰。Caveman 據此把「絕不碰使用者的提示詞」寫進設計原則,這是有論文背書的取捨。
把語氣層的帳算完,官方現在的省錢主張全部落在本機 Proxy 這一半:代理呼叫工具回傳的測試日誌、JSON、CSV 與網頁內容,先在本機壓縮再送上游模型,每一份原始輸出留一份可還原的控制代碼。README 的基準是 6 個大型工具輸出的合成任務、18 組配對:工具輸出本身從 130,611 個 token 縮到 22,994,壓縮率 82.4%;但落到整個工作階段的輸入帳單,節省是 33.2%,18 次回答全部正確。
兩個數字要分開讀。82.4% 是壓縮器對工具輸出的本領,33.2% 才是你帳單上的差額,因為工作階段裡還有提示、注入的規則與其他脈絡不會被壓縮。這組數字量的是 2026 年 8 月的引擎與合成任務,官方也沒有把它包裝成品質等價宣稱:倉庫裡 fidelity 評估的腳本已經寫好,但至今沒有提交任何經審查的快照,所以品質面官方一個字都不敢掛保證。
另外兩個模組的數字附帶同款但書。Auto 自動選模型與推理強度,官方期中結果是 85 項任務、成本壓到 Opus 最高推理強度的 0.46 倍,但實測分差只有 0.5 分、落在正負 7 分的不確定區間內,官方自認這輪只跑了一半,且大部分節省來自對簡單提問自動降檔。Browse 網頁壓縮對 200 列資料表能把 15,704 個 token 縮到 121,代價寫在同一行:極小的表單反而膨脹 2.3 倍。
理解了錢在輸入側,v4.1.0 的三項變更就讀得出重量。
第一道是憑證阻擋。記憶檔壓縮工具 caveman-compress 現在會直接拒絕處理含真實憑證的檔案,私鑰區塊、雲端金鑰、模型 API token 都在攔截範圍。官方在 release notes 裡把理由說得毫不掩飾:壓縮過程會把檔案內容送往你的模型供應商,所以機密必須先搬進環境變數或金鑰管理工具。攔截觸發時錯誤訊息只報行號、不印機密本身,sk-… 這類佔位符則照常可壓。這項變更等於官方親口確認了壓縮鏈路的外送性質,也是自架團隊評估資料邊界時最該畫紅線的地方。
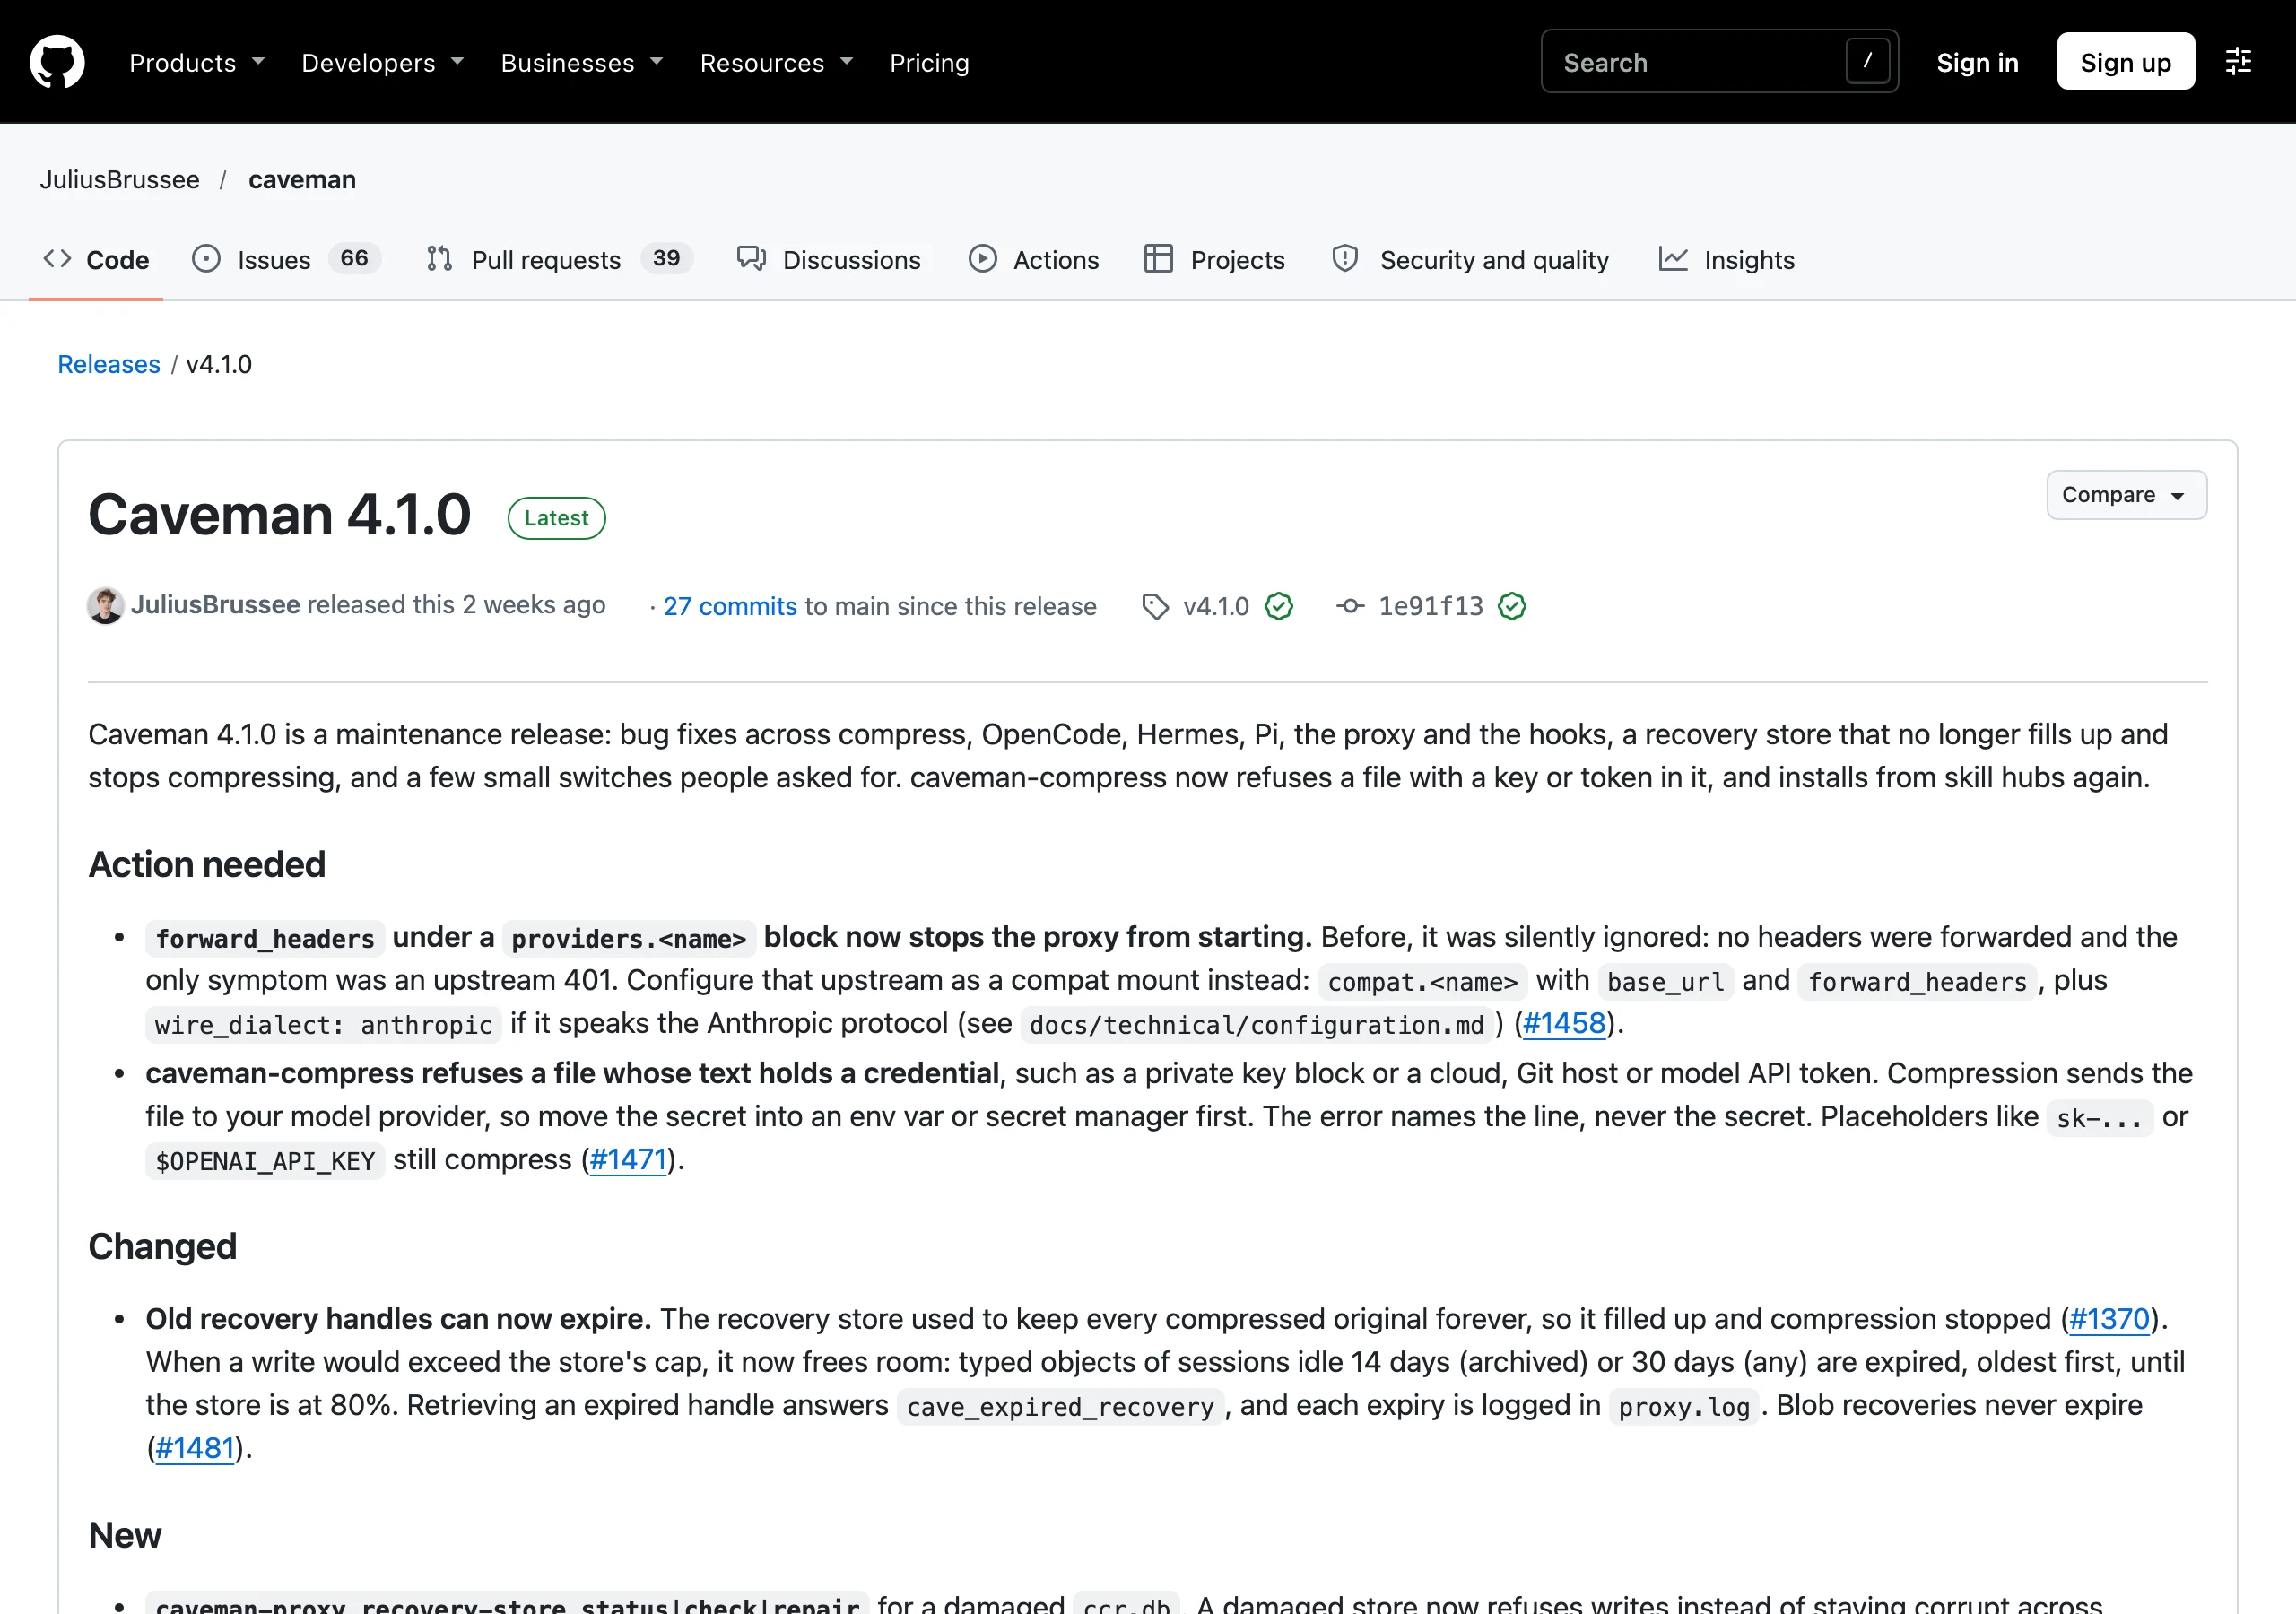
第二道是還原儲存區的保存期限。「每一份被壓縮的原始輸出都能還原」是這個工具的核心承諾,但舊版把所有歷史檔案永久保留,長期使用後儲存區爆滿、壓縮跟著停擺。新版改為自動過期:寫入將超過上限時,閒置 14 天的封存工作階段與閒置 30 天的一般物件先到期先清理,清到 80% 水位為止;讀取已過期的控制代碼會明確回報 cave_expired_recovery 狀態,每次清理都寫進 proxy.log,blob 類型的還原不在過期範圍。同一輪還補上了一套自癒工具:caveman-proxy recovery-store 的 status、check、repair 三個子指令,受損的儲存庫現在會拒絕寫入而不是帶著損壞跨版本升級,修復時只搬走雜湊還對得上的資料列。可還原的承諾從此帶上了保存期限與健康檢查,跑超過兩週的長任務要先知道這件事。
第三道是破壞性的設定變更。過去寫在 providers 區塊下的 forward_headers 會被系統靜默忽略,上游回 401 卻查無原因;新版直接讓 Proxy 拒絕啟動,要求改用 compat 掛載點設定 base_url 與 forward_headers,講 Anthropic 協定的上游還要加 wire_dialect 欄位。升級後 Proxy 起不來是預期行為,照錯誤訊息搬家即可。同一輪也修好了 Hermes 技能市集誤判安裝、OpenCode 2 外掛生成與 .env 類憑證檔案的拒絕邏輯。
倉庫首頁最顯眼的對照是官方自己跑的 Terminal-Bench 4:同模型對決,GPT-6.1 Sol 上 Caveman Code 每解一題 1.21 美元、Codex 是 1.52 美元,192 次執行中 90 次雙方都解出;Opus 5.5 上 180 次解出 97 題、Claude Code 是 177 次解出 83 題,每題成本 5.19 對 6.04 美元,95% 信賴區間 0.70 到 1.02 倍。換算成行銷語言就是比 Codex 便宜 21%、與 Claude Code 在噪音範圍內打平。
但官方在數字正下方自己標了口徑:量測用的是基準建置,基準設定全開;正式發行版把三項僅供基準使用的設定關掉。拿這組數字做採購決策前,先把這行但書一起帶走。
第三方最亮眼的移植是 Elasticsearch Labs:他們把 Caveman 模式重寫後套進 8 個連真實叢集的 MCP 情境,平均回應 token 省 63.6%、八個情境合計從 1,284 縮到 467 個 token。他們的發現句寫零技術準確度損失,同篇結語卻寫零資訊損失,後者被官方 README 逐字引用,嚴格說前者範圍窄一號。這是回應側的證據,與輸入側 Proxy 是兩件事。
授權結構比徽章複雜一號。整個倉庫現在是 Apache-2.0,但只從 3.0.0 起算;更早版本的授權是拆開的,技能與 CLI 走 MIT,引擎與 Proxy 走 Business Source License 1.1,商用舊版前要先看清這條線;Caveman Cloud 託管服務是分離的商業軟體,原始碼不在這個倉庫、開源授權不覆蓋;「Caveman」名稱與岩石標誌是創辦人保留的商標。自架、修改、商用分支都不受影響,想把商標印上自己產品的人要先停下來。
安裝形態一句話講完:終端機執行 npx @caveman-ai/cli@latest(Node 22.13 以上,找不到 Node 時安裝器會退回 Bun),精靈自動偵測已裝的代理工具,官方標示支援 30 種以上環境,沿用你現有的 API 金鑰或 Claude Pro/Max 登入,選配的 Auto 路由需要一個免費帳號。npm 上的 CLI 套件零依賴,2026 年 8 月才首次發布,比倉庫本身晚了四個月。
至於該不該掛,官方文件給的規則比任何評測都實用:挑一個你自己的任務,開關各跑一次,對照供應商計費頁的總額。變便宜就留著,變貴就為那個工作負載關掉。判斷順序也有講究:先看計費模式,按請求計費的訂閱直接跳過語氣層;按 token 計費再分兩段評估,語氣層看 8.5% 這個實測天花板決定值不值得裝,輸入側 Proxy 才是 33.2% 承諾的兌現位置,而且要記得那組數字來自合成任務。未定案的部分同樣別漏:Auto 的品質分差要等官方跑完全程、Say less 的樣本至今是 10 個沒重跑、規則本身的輸入成本官方承認未測。這條對帳線還沒到終點:Auto 只跑了半程、下一代版本也還沒現身,兩者的走向會決定 12 萬顆星背後的承諾最終能不能對上帳單。
如果你想在代理工作流裡再壓一層成本,省 token 的模型端選擇可以參考 Particle-1 省 token 程式代理模型的分析;各家代理訂閱的額度倍率與中文 token 實際成本,AI coding plan 比較有完整拆解;視覺端的 token 壓縮另有不同解法,TTR-Compressor 的做法值得一併認識。