TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

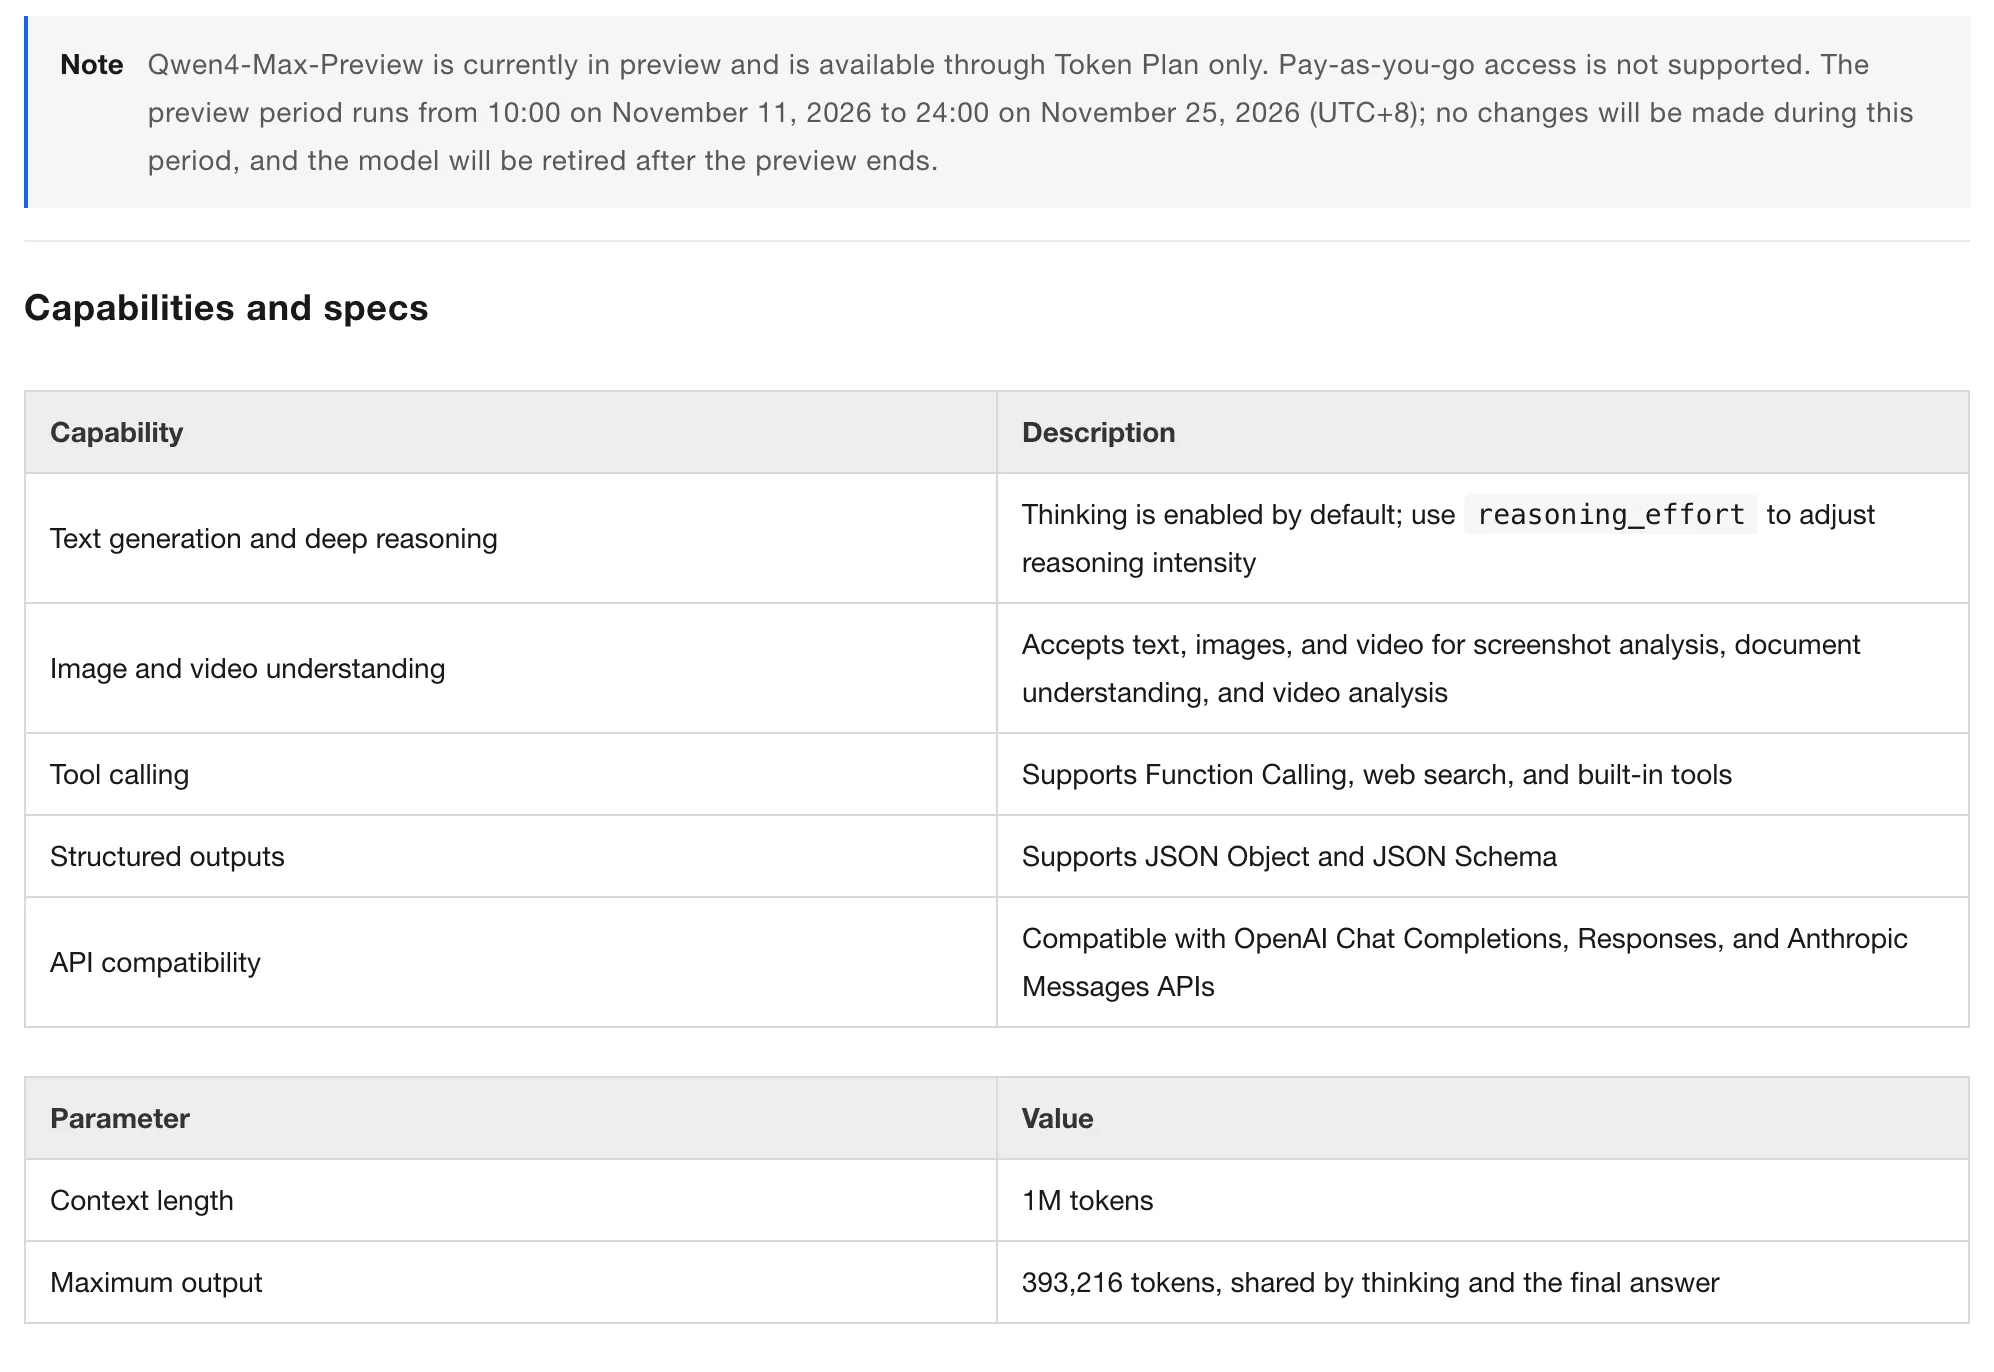
阿里雲把 Qwen4-Max-Preview 排進模型文件,11 月 11 日 10:00 至 11 月 25 日 24:00(UTC+8)限時開放,僅 Token Plan 訂閱專用金鑰可呼叫;1M 上下文、393,216 token 輸出上限由思考與答案共用,max_tokens 從這個模型起等同 max_completion_tokens,多輪對話要把思考放回 reasoning_content 欄位。9 月只存在於投影片的 Qwen4,第一次有了可呼叫的官方入口。
用 AI 摘要這篇文章:
Qwen4 終於有了可呼叫的官方入口。阿里雲 Model Studio 的模型文件在 11 月 11 日新增 qwen4-max-preview 條目,定位為 Qwen 家族的下一代旗艦多模態模型,限時預覽到 11 月 25 日 24:00(UTC+8)為止,期滿直接下線。距離雲棲大會投影片上的首度曝光,隔了七週又一天。
對開發者真正要緊的是三件事:入口只認 Token Plan 訂閱的專用金鑰,既有隨用隨付金鑰不能用;輸出額度的計算規則從這個模型起改變,思考與最終答案共用同一個上限,按舊習慣設定的程式可能提前截斷;預覽有明確下線日,接進工作流程的東西都要留退路。三件事都寫在官方文件裡,不是推測。
依據的是官方模型文件(2026 年 11 月 11 日版)與 Token Plan 說明頁,預覽的規則都寫在文件裡;跑分與 Credits 費率官方尚未公布。
9 月 22 日的雲棲大會上,Qwen4 還只存在於演講投影片:四個型號名稱加一句 Coming Soon,Hugging Face、GitHub 與百煉文件都找不到任何 Qwen4 條目。當時能寫的只有產品線曝光,沒有任何可測試的東西。
阿里雲模型文件在 11 月 11 日新增 qwen4-max-preview 的完整條目,預覽從當天上午 10 點(UTC+8)開始;一分鐘後 Qwen 官方 X 帳號貼出公告,開頭寫「Qwen4 is coming」,接著說 Qwen4-Max 已經在 Alibaba 的 Token Plan 上開放預覽,結尾喊開發者拿一個真實問題去測:「Put it to the test on a real problem. Show us what you build.」
官方口徑值得逐字看。X 公告說的是 Qwen4 is coming,等於承認整個世代還沒正式發表;投影片上的四條產品線,只有 Max 一條拿到可呼叫的入口,Flash、Plus 與 27B 仍然只有名字。同一則公告也點名 QwenWork、Qoder、Qwen APP 與 QwenStudio 四個產品有早期體驗入口,但各產品的資格條件與介面各自獨立,不能從 Token Plan 的規則推過去;沒有訂閱的讀者想先看看模型水準,這幾條路或許比 API 更快,細節要各自查。
檔期本身也是資訊。文件明寫預覽期間不做任何變更,換句話說,這兩週的觀察可以對到同一個固定版本,今天測的行為與下週測的是同一份模型;文件同時寫明預覽結束後模型將退役下線,不是轉正,也不是改名保留。
受影響最直接的兩群人:已經訂了 Token Plan 的開發者,拿到專用金鑰就能開始呼叫;想用同一批材料比較旗艦模型的團隊,則多了一個有期限的測試對象。
文件把取得條件寫得很死:qwen4-max-preview 僅透過 Token Plan 提供,隨用隨付不支援。Token Plan 的官方定義是阿里雲 Model Studio 的模型訂閱服務,以 Credits 計費,供相容的 AI 工具互動使用。換句話說,這不是把新模型加進既有 API 帳單,而是要先取得另一個訂閱身分,用量從按次計費換成訂閱額度。
訂閱本身有兩種版型。Personal 依級距訂閱,Team 依座位數訂閱且要先由管理員分配座位,兩種都有月付、季付與年付可選。Team 版的一個流程細節容易漏:管理員沒派座位之前,成員拿不到金鑰,採購後要多做這一步才算開通。
實際接線有三個要換掉的東西。金鑰:兩種版型都會取得一支專屬 API 金鑰,官方提醒金鑰只顯示一次,離開頁面就再也看不到,要當場存進安全的地方,交接文件只記錄用途與存放位置,不要為了排查問題把金鑰抄進聊天訊息。服務位置:專用 Base URL 是 token-plan.ap-southeast-1.maas.aliyuncs.com,掛在新加坡區域,模型 ID 設 qwen4-max-preview,完整路徑依採用的協定再對文件。工具:官方提供百煉 CLI 的快速接線指令,一行 bl auth login 帶上專用金鑰與專用服務位置,就能把訂閱接上手邊工具。
最容易踩的坑,是拿既有的隨用隨付金鑰只改模型名稱就送請求。金鑰身分與服務位置都沒換的情況下,請求根本不會走到這個預覽服務,錯誤訊息卻可能長得像模型問題。連不上時先對照訂閱方案、金鑰來源與服務位置這三項,比重送幾次請求有用。
Token Plan 的官方指南本身也值得看一眼:支援清單涵蓋 Qoder、Claude Code、Codex、Qwen Code、OpenClaw、Hermes Agent、OpenCode、QwenWork、Trae、DeepSeek Harness 與 WorkBuddy 共 11 種工具,從終端機開發助理到自架個人助理都有設定指南。把 Claude Code 與 OpenAI 的 Codex 放進自家訂閱的官方指南,等於阿里雲直接邀請對手陣營的開發工具接上 Qwen 模型;從清單看,這個訂閱瞄準的就是把 coding 工具換個模型後端的人。至於各級距的價格與 Credits 消耗率,兩份文件都沒有列,要以帳號內訂閱頁顯示的條件為準。
規格表列了兩個數字:上下文長度 1M tokens,最大輸出 393,216 tokens。這兩個數字回答的是不同問題。上下文是能一起放進任務的材料量,規格書、前幾輪討論與待處理檔案可以塞在同一個請求裡,讓模型帶著完整背景作答;輸出上限則是模型能寫出來的總量,而文件在這個數字後面加了一句關鍵話:由思考與最終答案共用。
共用的意思,是模型先在內部推理、再寫答案,兩段加總不能超過輸出上限。一個具體的出錯場景:原本的工作只交付一份短報告,團隊把輸出限制設得很緊,換到預設會思考的模型後,同樣的限制先被推理消耗,報告可能只寫到一半。此時把上限直接拉到最大不一定是對的解法,先分辨截斷來自額度、還是來自材料與指令本身,才知道該調參數還是調任務。
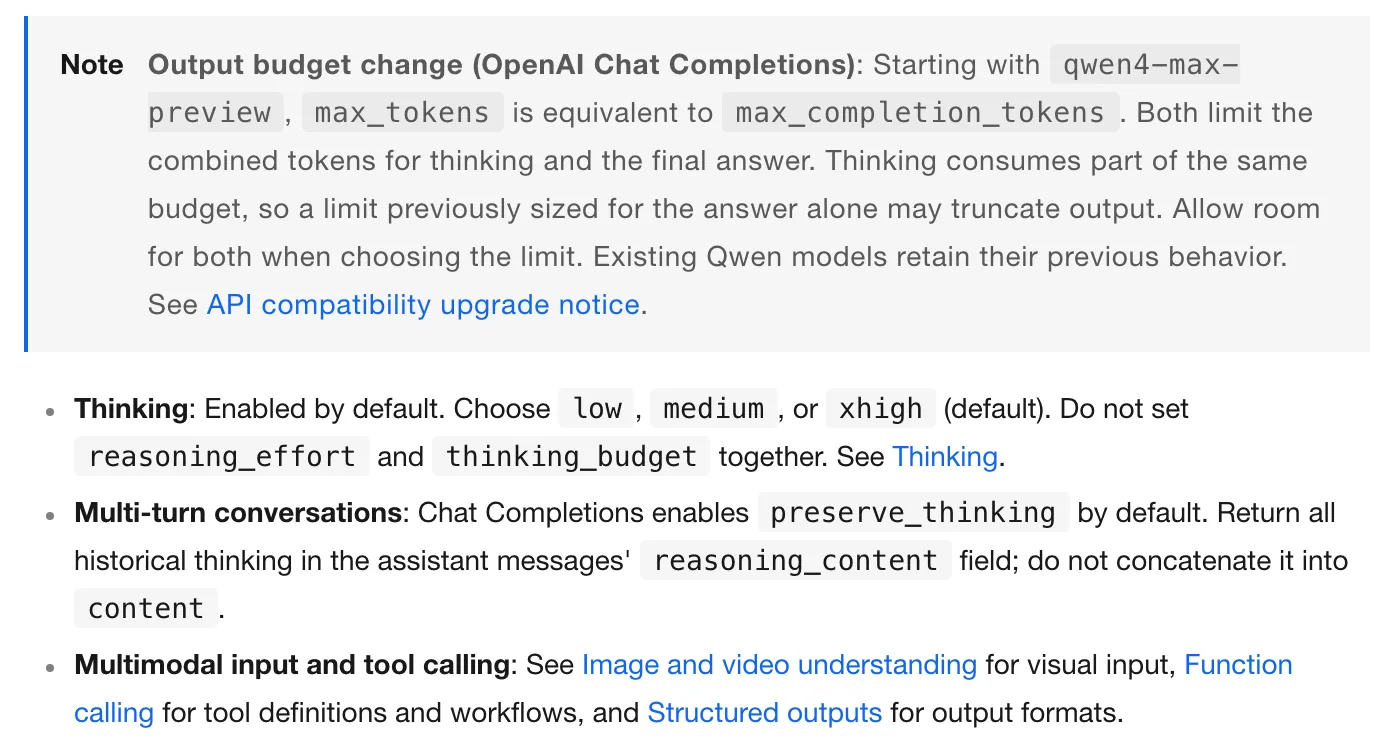
對 OpenAI Chat Completions 相容介面,文件明寫從 qwen4-max-preview 起,max_tokens 等同 max_completion_tokens,兩個參數都限制思考加答案的合計;思考會先吃掉一部分額度,原本只按答案長度設定的限制,換到這個模型就可能提前停筆。同一句話也畫了反方向的界線:既有 Qwen 模型保留原本行為,所以新語意不能反向套回舊模型,對照測試時兩邊的參數意義並不相同。
| 行為 | 既有 Qwen 模型 | qwen4-max-preview 起 |
|---|---|---|
| max_tokens 意義 | 依各模型原本口徑 | 等同 max_completion_tokens,思考與答案合計 |
| 思考 | 依各模型設定 | 預設開啟,reasoning_effort 調 low、medium、xhigh,預設落在三檔最高的 xhigh |
| 參數限制 | 依各模型文件 | reasoning_effort 與 thinking_budget 不可同時設定 |
| 多輪歷史思考 | 依介面慣例 | Chat Completions 預設開 preserve_thinking,思考放 reasoning_content 欄位 |
推理強度也值得先看清楚:可選值是 low、medium、xhigh,預設值就落在 xhigh,三個名字裡最高的一檔。這代表什麼都不設的第一次呼叫,走的是最強推理,思考消耗的輸出空間也最大;預算很緊的批次任務,送出前先降檔比事後補救容易。另外文件特別提醒,reasoning_effort 與 thinking_budget 這兩個控制不可同時設定,一起送會不合官方用法,等於兩套思考調節機制只能挑一套用。
還要把單位看清楚:token 是模型拆解文字的計量單位,與中文字數沒有固定換算,1M tokens 的上下文不是 1M 個中文字,材料放得下也不保證引用得對。長上下文的驗收標準要回到任務本身:模型有沒有找對條件、回答能不能對回原始材料,這兩題比任何容量數字都實在。
介面相容性是這次最省事的部分:OpenAI Chat Completions、Responses 與 Anthropic Messages 三種都支援,多數既有程式不用換協定。但多輪對話的歷史組裝有新規則。Chat Completions 預設開啟 preserve_thinking,文件要求把先前的思考內容放回助理訊息的 reasoning_content 欄位,不要拼進一般的 content。
這條規則對代理式工作流的影響比看起來大。代理收到工具執行結果後要繼續判斷,歷史訊息裡少一段思考或放錯欄位,同一個工具回覆就可能帶出不同的後續行動;把推理紀錄與對外回答混在同一個字串裡的舊寫法,在這個模型上等於交給它一份組裝方式錯誤的歷史。工具呼叫的分工也要記得:模型提出要呼叫哪個功能,執行與回傳結果仍是外部程式的責任,支援工具呼叫不代表工具失敗時模型能自行恢復。
能力邊界同樣照文件字面理解。條目寫的是圖片與影片理解,用途是截圖分析、文件理解與影片分析,全文沒有任何影片生成或圖片生成的承諾;把畫面交給模型分析,與要求模型生成一段新影片,是兩種不同的工作,前者有依據,後者沒有。工具呼叫涵蓋 Function Calling、網路搜尋與內建工具,結構化輸出支援 JSON Object 與 JSON Schema 兩種格式,這讓答案照指定欄位排列、下一個系統直接接手的流程有官方支撐;但欄位驗收看的仍然是內容對不對,日期欄位長得像日期,不等於它對到來源裡正確的日期。
預覽期有一個對比較工作有利的前提:文件明寫期間不做變更,所有觀察都能對到同一段服務版本。代價是期限寫死,11 月 25 日 24:00(UTC+8)之後模型下線,台灣讀者不需要換算時差。
排程上可以切成兩半。前半段處理接線:確認訂閱與金鑰來源、換上專用服務位置、按新語意重設輸出上限、調整多輪歷史的欄位組裝。後半段跑固定材料的對照:同一批需求文件、同一組螢幕截圖,分別交給現用模型與這個預覽,保留完整的請求、工具結果與最終交付,看差異出現在理解材料、選對工具,還是修正工具失敗之後。每天換題目容易累積展示片段,卻沉澱不了判斷。
驗收標準要對應實際產物。前端任務看功能與資料有沒有做對,文件任務看引用與結論能不能對回來源,多模態任務還要保留原始輸入,畫面細節可不可辨認、影片給了哪些片段,都會影響模型能回答什麼。文字更長或畫面更漂亮,不算是共同的驗收條件。
還沒訂閱的人多一層決策:為了兩週的預覽值不值得開一個訂閱。Token Plan 有月付、季付與年付三種週期,文件沒有公布各級距價格與 Credits 消耗率,無法事前算出測一輪要花多少額度;把月付當成最小試錯單位、測完再決定續不續,會比一開始就押長週期合理。已經在用 Qoder 或 Claude Code 並綁了 Token Plan 的人,這兩週等於多一個旗艦模型可以對照,沒有理由不測。
正式服務的接法則要反過來想:模型名稱應該放在可切換的設定裡,任務資料留在自己的系統,11 月 25 日之後隨時能退回原模型繼續跑。退回時記得重新檢查輸出上限與對話欄位,前面提到的參數語意是新模型才有的行為,複製回舊模型不會得到相同結果。把預覽名稱寫死在程式裡的團隊,屆時等著它們的是中斷,升級不會發生。
未確定的部分也要說清楚:預覽結束後有沒有正式版、叫什麼名字、用什麼方式取得,官方一個字都還沒提;模型跑分與 Credits 費率同樣未公布,截至 2026 年 11 月 13 日文件與公告都沒有給。這些空白等公告補,不宜用預覽文件推測。想跟進 Qwen 家族其他進展,可以對照先前整理的 Qwen-Image 2.1 開放權重生圖模型與 Qwen3.8-LiveTranslate 同傳模型。
預覽的價值從來不是永久使用權,而是在固定條件下拿到可比較的證據。兩週後入口關閉,能留下的只有你自己工作裡的測試紀錄,先把它們設計好,這段時間才花得值得。