TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

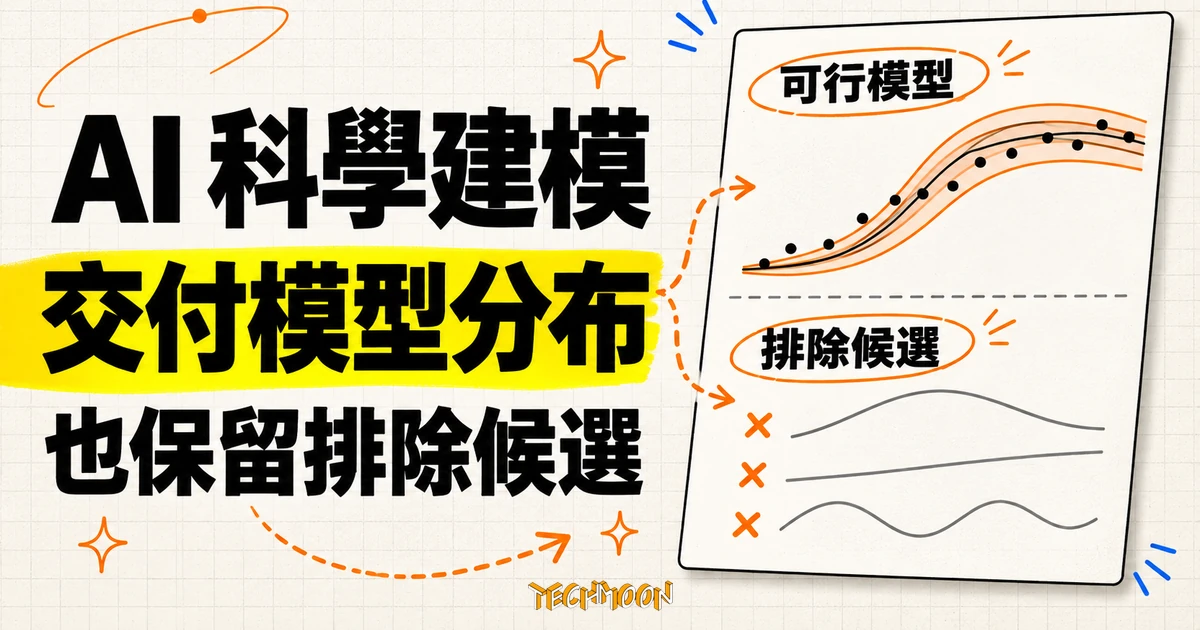
Anthropic 於 11 月 6 日刊出圖賓根三位研究者的客座文章,主張 AI 參與科學建模時,只交回最貼合資料的單一模型並不算完成工作。文章以 Hodgkin-Huxley 神經方程的歷史案例與模擬為基礎的推論說明:參數與模型的分布、被排除的候選、對新實驗的分歧預測,才是能換到理解的交付物。作者自承目前的 LLM 代理建模系統多半仍在重現已知模型。
用 AI 摘要這篇文章:
Anthropic 在 2026 年 11 月 6 日於官網研究專欄刊出客座文章《Teaching AI to build scientific models》,三位作者 Jakob Macke、Daniel Gedon、Stefan Wahl 任職於 ELLIS Institute Tübingen 與德國圖賓根大學,都是 Anthropic「AI for Science」補助計畫的獲補助研究者。這個計畫從 2025 年 5 月起提供免費 API 額度給聚焦生物與生命科學的研究團隊。Anthropic 對科學工作的投入還包括內部研究,Claude 分析冷凍電子顯微鏡資料的 vault 研究便出自其生物實驗室。
這篇觀點文章的核心主張可以濃縮成一句話:AI 幫你找出一條貼合資料的曲線,在整套建模工作裡只占一小段,接下來還該交付的是:哪些模型同樣行得通、哪些候選被排除、以及它們對新實驗的預測在哪裡分歧。對把 AI 用在資料分析與建模的人,這份清單比任何單一「最佳答案」都更有用,而 Anthropic 自己的科學用量報告 顯示,資料分析正是研究者把 AI 用得最重的一段。
先把性質講清楚:這是一篇觀點文章,談的是方法論主張,任何模型與工具的行為都不會因此改變。一般使用 Claude 或 ChatGPT 的人不需要調整設定;該換工作方式的,是用 AI 做建模與分析的研究者。
文章用神經科學的經典故事定調。1951 年,劍橋大學的電腦停機六個月,生理學家 Andrew Huxley 和 Alan Hodgkin 剛為一顆烏賊神經細胞的放電寫好一組方程,想驗證就只能把方程解出來跟測量結果比對。Huxley 於是改用手搖機械計算機,搖了三個多星期。
方程的基本結構有已知事實支撐:細胞膜與離子通道可以當成電路來處理。但其中一個變數必須取四次方,曲線才配得上資料。當時沒有人知道為什麼,只知道更簡單的形式表現不如它。兩人保守地提出假設:膜上也許要多個帶電粒子就位,通道才會打開。論文在 1952 年 8 月刊於《生理學雜誌》(Journal of Physiology),兩人於 1963 年獲得諾貝爾生理學或醫學獎。數十年後,鉀離子通道的結構解開,正是四個相同部位圍著中央孔洞,當年四次方的猜測方向正確,這組方程甚至協助預測了它從未擬合過的通道結構。
文章從這段歷史抽出的重點是:知道「四次方可行」價值有限,知道「更簡單的版本為什麼不行」才是理解。今天 AI 系統一個下午就可能找出一條擬合更好的方程,但把模型直接遞給你的 AI 給的是答案而非理解,原文寫得直接:”An AI system that merely hands you the model might give you an answer, but it does not give you understanding.” 文中也引了數學家 Richard Hamming 在 1962 年的名言:「計算的目的是洞見,不是數字。」
文章把科學建模拆成三個會反覆往返的步驟:建構模型(決定方程的形式與組成)、限制參數(用實際測量縮小參數範圍)、解讀模型(問這組方程對真實系統說了什麼)。參數對不上資料就回頭改結構,解讀出現矛盾就回頭檢查假設。AI 在三個步驟的介入程度差距很大:
| 步驟 | 工作內容 | AI 目前的位置 |
|---|---|---|
| 建構 | 決定模型的形式與組成 | LLM 代理兩年內快速出現,仍多在重現已知模型 |
| 限制參數 | 用測量縮小參數範圍 | 模擬推論(SBI)已實際應用於多個科學領域 |
| 解讀 | 問模型對真實系統的意義 | 最難交給 AI,評斷標準還在提案階段 |
參數這步的舊問題,文章用一桌餐費解釋:帳單總額 120 美元,你知道總額,卻反推不出每個人點了什麼,因為不同組合會得到同一張帳單。神經細胞模型也一樣,不同組合的通道參數可以產生近乎相同的電活動;交回一組配得最好的數字,等於把其他同樣可行的組合藏起來,而那些組合在新情境下可能給出不同預測。
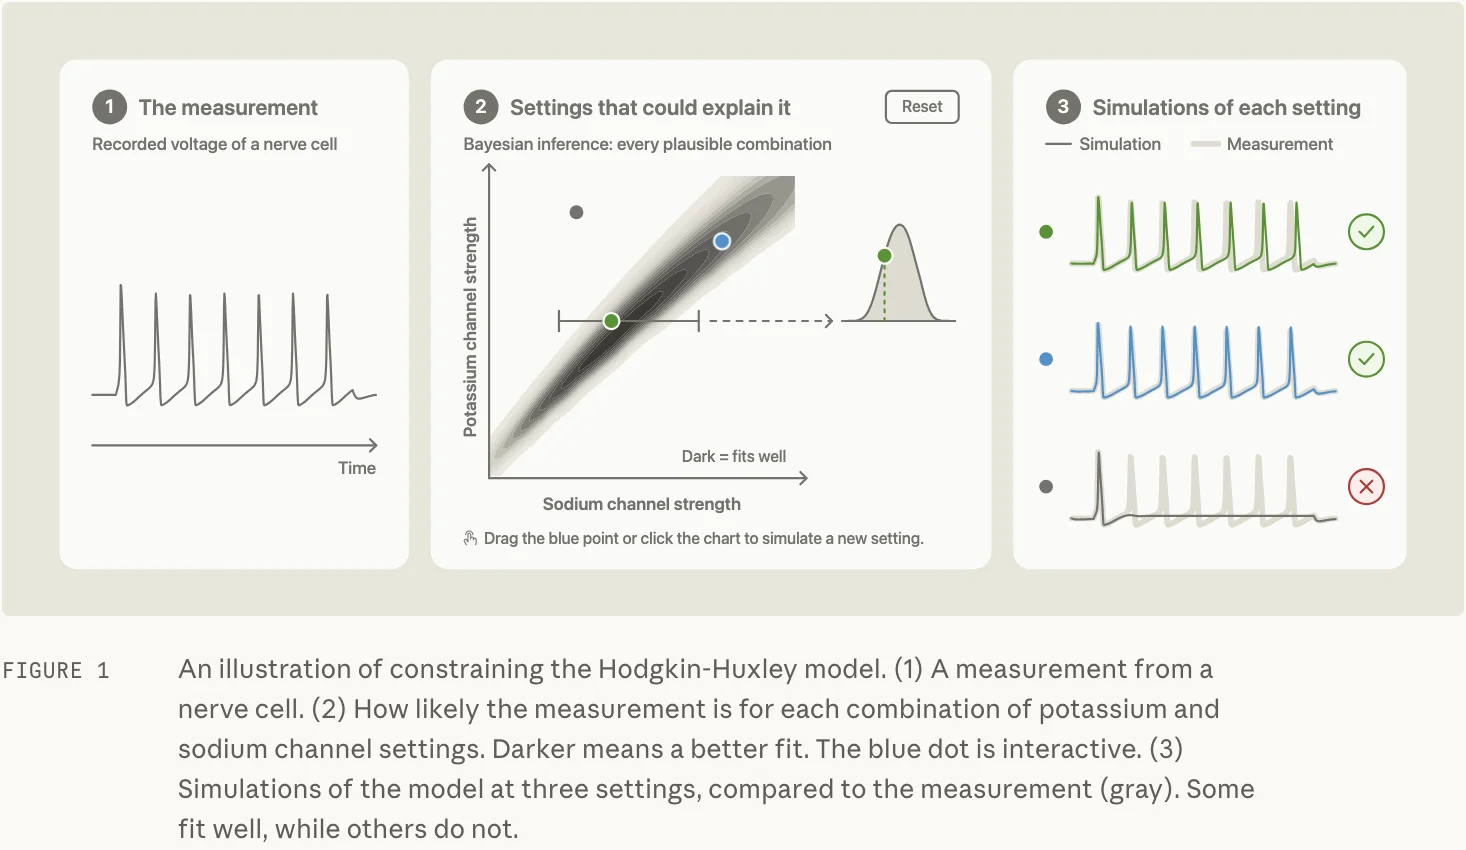
貝氏推論能把符合程度與先備知識一起考慮,交回參數的機率分布,但複雜模型往往算不出每組參數產生目前觀測的機率:數千個離子通道隨機開關,所有路徑無法逐一列舉。文章介紹的替代方案是模擬為基礎的推論(simulation-based inference,SBI):抽一組參數、跑一次模型、記錄輸出,然後重複,Hodgkin-Huxley 規模的模型大約要十萬次模擬,更大的系統要數百萬次;接著訓練神經網路,讓它學會看到某種輸出時,哪些參數組合比較可能產生它。這條路只有一個前提:模型要能往前跑,參數進去、資料出來。這種模型叫做模擬器,Huxley 手搖計算機的過程,本質上就是一個人在跑模擬器。
前置成本不低,模擬可能跑上數週,但訓練完成的網路對新資料只要幾秒就能推論。文章點出這已經改變某些工作的節奏:兩顆中子星相撞時,SBI 能快速算出碰撞在天空中的大致方位,快到望遠鏡來得及在訊號消失前指向它。同一套方法已用在宇宙學、結構生物學、地球物理,也回到神經細胞模型(包含 Hodgkin-Huxley 本身)。因為交回的是分布,研究者看得見哪些參數被資料釘死、哪裡有多種解釋並存、下一個實驗最該補在哪裡。
過去兩年出現多套 LLM 代理建模系統,文章註腳列出六篇論文。工作流程大致相同:研究者提供資料與自然語言描述,代理寫出候選模型的程式、執行、調參數、與觀測比較,再修改方程,循環到夠貼合為止。寫出模型形式這件事,過去被認為只有人類做得到。
文章的提醒是:同一批資料跑兩次代理,可能得到兩個不同、卻一樣貼合的模型,只交回其中一個,等於把另一條路藏起來。作者的建議是把建構當成參數限制來處理:要求 AI 交回整個可行模型的範圍。候選依資料支持程度加權,需要大量自由度才配得上資料的模型被打折,弱的淘汰,再在強的上面生成新變體。這個模型分布會說話:所有存活模型共享的特徵,比較可能是資料支持的;它們分歧的地方,就是證據薄弱、也最值得設計實驗的地方。
誠實的部分作者自己講清楚:這些系統至今多半在重現科學家已知的模型,對沒有已知答案的問題,有效的證據仍然稀少。他們預期系統會隨模型進步而進步,但文章沒有宣布任何自主科學發現。另一個該放進脈絡的事實是,註腳引用的模型分布方法裡,有一篇正是作者團隊自己的論文(Wahl et al. 2026,用機率框架處理 LLM 模型發現),而刊出這篇文章的 Anthropic 正是補助他們的機構。主張與立場之間的關係,讀者可以自己衡量。
擬合程度可以計分,有沒有帶來理解卻很難寫成最佳化目標,這是文章公認最難交給 AI 的一步。文中引述兩個評斷方向:看系統受擾動後的預測表現,或者繞過「AI 自己懂不懂」,改問它的產出有沒有讓人類研究者更懂問題。後者的例子是量子實驗設計:系統不交付單一實驗配置,而是寫一支能產生整族相關設計的短程式,物理學家可以直接從程式碼讀出設計原則,不必從一張複雜配置反推。
分布在解讀層的價值,文章給了具體理由:單一模型無法告訴你哪些部分被資料約束,人很容易把意義讀進其實沒被約束的部分。Hodgkin-Huxley 的四粒子假設之所以有分量,正因為更低次方的版本不行;兩人當年也記下更高次方可能配得稍好,但按文章引述的原話,「這點改進不值得換來額外的複雜度」。
介入預測是把分歧變成實驗的方法:問模型,把鈉通道全部堵住,或只堵一部分,結果會怎麼變。全體可行模型答案一致,結論就站得住;答案分歧,分歧本身就是下一個實驗的題目。
經典模型都很小巧,因為要人腦寫、人腦讀。文章預期 AI 接手更多工作後,尺度限制會開始鬆動,舉的例子是果蠅:全腦接線圖已經完成,文中示意圖渲染出 124,635 個細胞,而且已經有團隊在接線圖上建模,預測果蠅視覺系統的神經活動。這份接線圖先前也被接進遊戲讓果蠅腦操控 Doom 與 Beat Saber,同一份資料正在長出截然不同的用途。
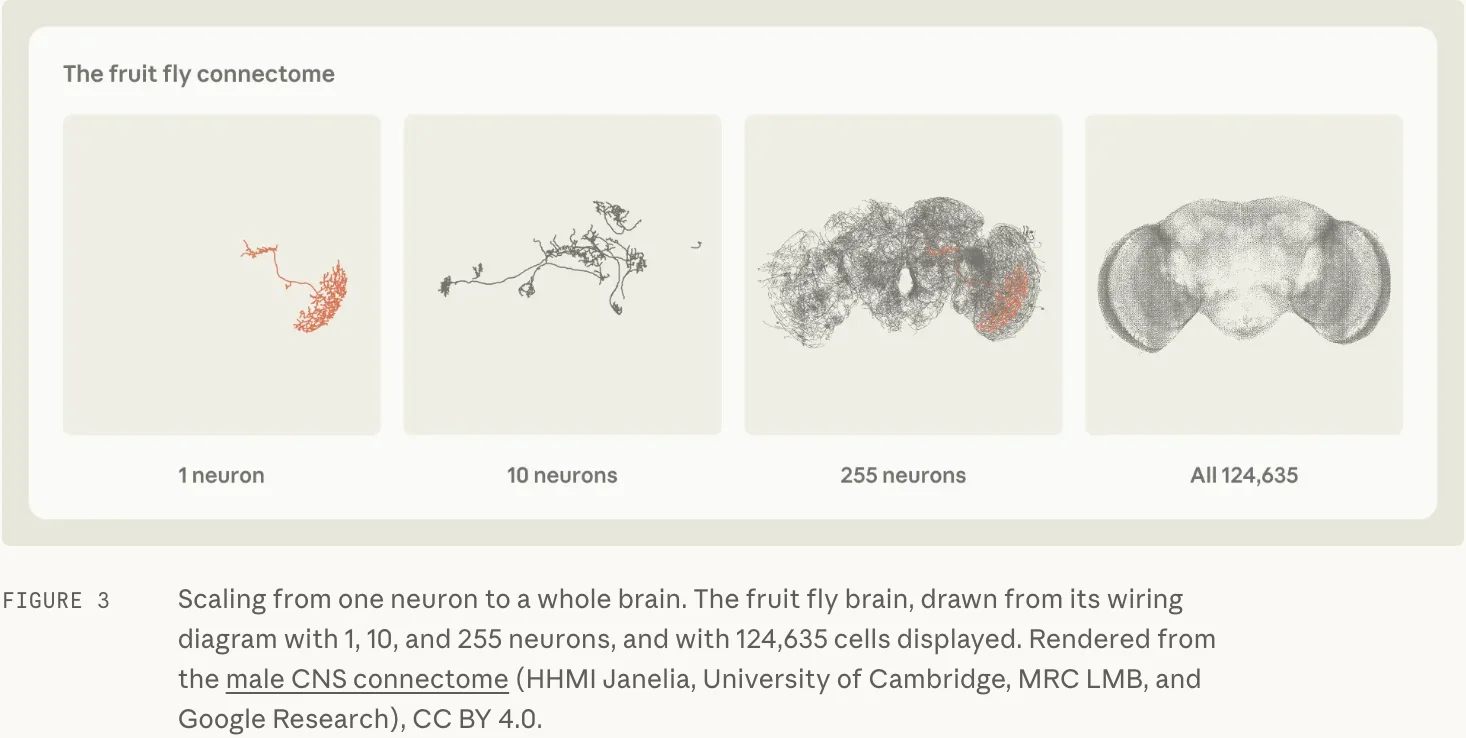
在那個尺度,文章說得直接:多數情況下不存在單一正確模型。統計學家 George Box 的名言被引進來:「所有模型都是錯的,但有些是有用的。」問題從「哪個模型是對的」變成「所有可行模型共享哪些性質、能推出哪些預測」。最有用的實驗,是能排除最多剩餘模型的實驗,即使它不見得是人類直覺上最有趣的那個。
這套工作方式其實已經存在。氣候科學本來就用不同假設的模型系集報告預測分布,AI 氣候模型的進展TechMoon 也持續追蹤;粒子物理學家在大型強子對撞機上找新粒子時,畫的是哪些理論版本被資料排除的地圖。文章做的事,是把這套已驗證的工作方式,提前搬進 AI 建模的交付標準裡。
這篇客座文章不會讓任何工具的行為改變。會因此調整的,是把 AI 用在建模與分析上的人的提問習慣。文章給的交付標準可以直接變成追問:除了這個最佳模型,還有哪些解釋同樣貼合資料?它們對新條件的預測在哪裡分歧?搜尋過程排除了哪些候選、理由是什麼?
放到一般資料分析也通。當多種解釋都能描述過去幾個月的銷售變化,直接採用最好看的那條曲線去規劃下一檔活動,風險就藏在被忽略的分歧裡;比較不同解釋在新條件下的預測差異,才知道還缺什麼證據。AI 能把搜尋範圍拉大,恰好也把「只看一條曲線」的代價放大了。
文章自己畫出的界線值得原樣保留。它沒有宣布新模型、新基準或理解分數,作者明說容易計分的是擬合程度,「是否帶來理解」連目標都還難定義。代理建模系統在沒有已知答案的問題上的有效性,作者自認證據稀少,這個空白要靠後續實證來填。保留多個候選也不代表窮舉了所有可能:可能模型的空間將近無窮,憑經驗提議少數幾個,難免漏掉同樣能解釋資料的版本。
保存期限也明確。文章對應 2026 年 11 月 6 日發布、同日晚間(UTC)修改的版本;當註腳裡的系統(包含作者團隊的後續工作)在沒有已知答案的問題上交出可重現的新預測,或 Anthropic 的 AI for Science 計畫公布下一波成果時,這套以分布為交付物的標準就值得重新檢視一次。
文章結尾回到 Huxley 的三個星期:那份苦工沒有人想回頭,但洞見就在過程裡。最後一句可以整句收下:科學模型給得出答案,給出洞見的是建構它的過程。