TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Anthropic 2026 年 11 月 5 日發布科研用量報告,分析 8 到 9 月共 207,049 筆 Claude 與 Claude Code 科研對話:資料分析與寫作合計占 Claude 用量過半,科學家問卷自評最重要的發想與資料收集反而用量最低,能力分數前 20% 的任務用量達時間占比的 2 到 4 倍;文內另整理三個加速情境的假設與但書。
用 AI 摘要這篇文章:
Anthropic 在 2026 年 11 月 5 日發布技術報告《AI for scientific discovery: How researchers use Claude》,把「科學家實際怎麼用 AI」這件事,用自家產品的真實用量量了出來。樣本是 2026 年 8 月 2 日到 9 月 30 日的 207,049 筆科研工作對話:128,914 筆來自 Claude 聊天與 Cowork 介面、78,135 筆來自 Claude Code,全部取自消費版方案。報告掛名 The Anthropic Institute,由 Hermle、Jones、Althoff 三位領銜的經濟學團隊執行,頁面在 11 月 6 日仍有最後修改。
一句話講完核心發現:科學家把 Claude 用在資料分析與寫作,用量緊跟著「AI 理論上做得到什麼」走;但配套問卷裡,他們把發想假說與收集資料評為對重要成果最關鍵的兩類,而這兩類恰是相對研究時間低用最明顯的段落。能力走到哪裡,用量就跟到哪裡,重要性沒有跟上。
這份報告值得科研圈看的原因,不在結論聳動,而在它把「該把 AI 放進研究流程的哪一段」這個每個團隊每天都在做的決定,變成一張可以對照的數字表。它與 Anthropic 先前釋出的科研案例(例如 Claude 參與解出 vault 蛋白顆粒結構)是不同性質的東西:那些證明 AI 做得到,這份量的是一般科學家平常真的拿它做什麼。
報告用的是隱私保護的分析基礎設施。一個語言模型先判斷對話是否屬於科學工作,另一個再依 SciNet 分類法(Alamos 與 Althoff 的 2026 年資料集)標上領域與任務;這套分類法涵蓋 34 個領域、318 個子領域、7,262 項任務。研究團隊只拿得到標籤,拿不到對話內容、資料集、假說或未發表的論文;結果只以彙總形式發布,人數過少的分類格會被隱去。
樣本邊界要先講清楚。母體是消費版方案的使用,API 與企業方案用量不在內;計算各領域全球研究者人數時,排除 Claude 尚未提供服務的國家;報告沒有做國別拆分。對台灣讀者來說,這份資料能當任務分布的參考座標,不能直接推論台灣科研圈的採用樣貌,這件事報告本身就沒有提供相對應的數字。
在這個母體裡,誰用量最大?以領域對話占比看,Claude 用量最大的三個領域是電腦科學 11.9%、工程 8.4%、醫學 7.7%,領域人數與用量占比的相關有 0.79;Claude Code 更極端,電腦科學一個領域就占 32.7%,而全球研究者裡電腦科學只占 4.3%。子領域裡最突出的是人工智慧與機器學習:研究者人數占 1.2%,卻占 Claude Code 對話量的 15.2%。數學、統計、電腦科學這類正式科學相對人數明顯超用;要在實驗室工作的化學等物理科學,以及多數時間在病人身邊的醫學,相對低用。計算生物學、計算語言學、計算神經科學這類帶「計算」二字的子領域,不管母學門屬於哪一邊,都名列最強的採用者。
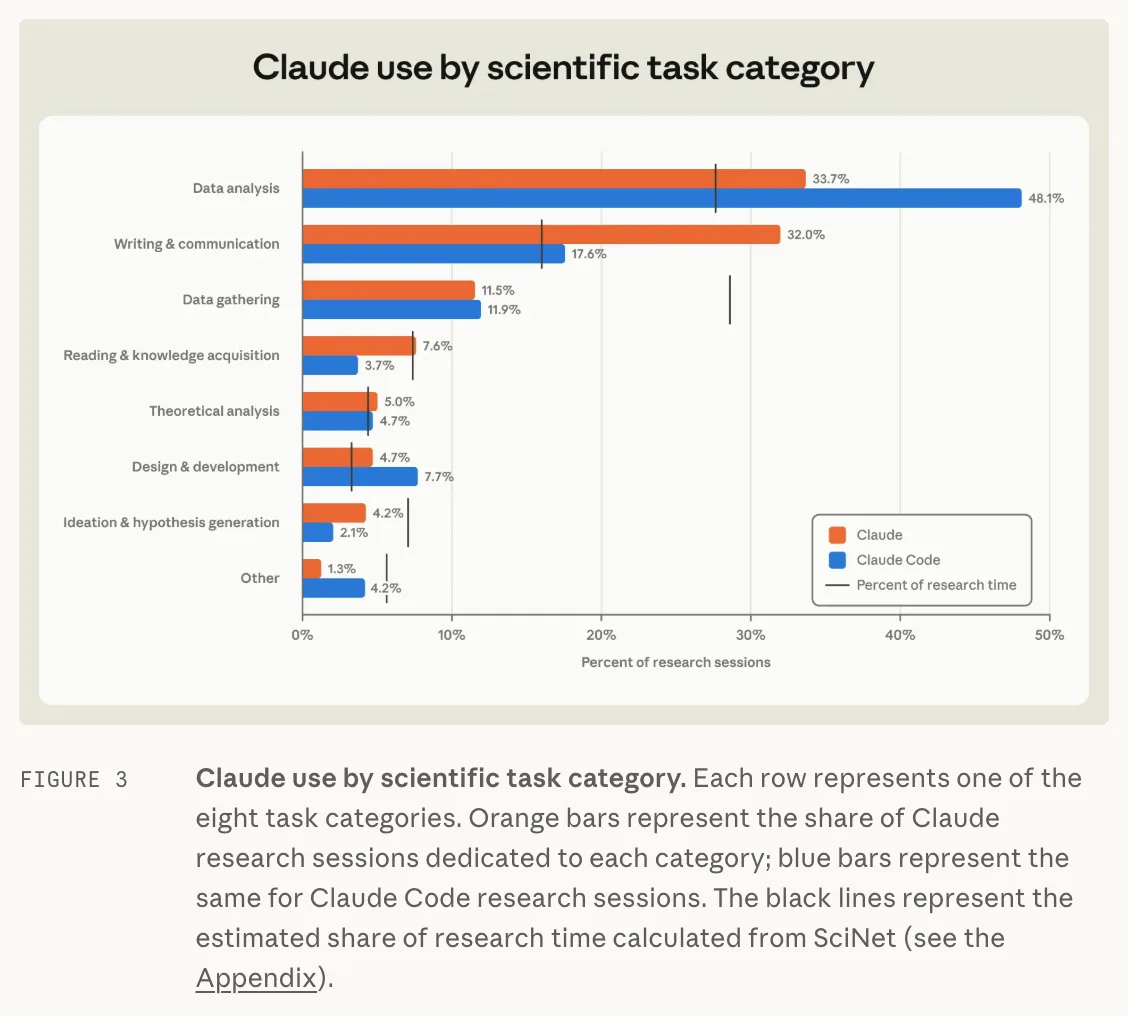
報告把科研任務分為八類:資料分析、寫作與溝通、資料收集、閱讀與知識獲取、理論分析、設計與開發、發想與假說生成,以及行政等其他。數字攤開,集中在非常少數的段落:在 Claude 上,資料分析占 33.7%、寫作與溝通占 32.0%,兩類合計超過六成五;在 Claude Code 上,資料分析一口氣占 48.1%,寫作與溝通也有 17.6%(取自報告圖 3)。對照研究者實際投入的時間占比(資料分析 27.6%、寫作與溝通 16.0%),資料分析在兩個介面都明顯超用,寫作與溝通的超用在 Claude 上尤其明顯。
| 任務類別 | Claude 對話占比 | Claude Code 對話占比 | 研究者時間占比 |
|---|---|---|---|
| 資料分析 | 33.7% | 48.1% | 27.6% |
| 寫作與溝通 | 32.0% | 17.6% | 16.0% |
| 資料收集 | 11.5% | 11.9% | 28.6% |
| 閱讀與知識獲取 | 7.6% | 3.7% | 內文未列 |
| 理論分析 | 5.0% | 4.7% | 內文未列 |
| 設計與開發 | 4.7% | 7.7% | 內文未列 |
| 發想與假說生成 | 4.2% | 2.1% | 7.1% |
| 其他(行政等) | 1.3% | 4.2% | 內文未列 |
落差最大的兩段同樣具體。資料收集占研究者時間的 28.6%,卻只占 Claude 對話的 11.5% 與 Claude Code 的 11.9%,其中臨床或生化樣本這類有實體障礙的收集工作低得尤其明顯;發想與假說生成占時間 7.1%,對話占比只剩 4.2% 與 2.1%。單一任務來看,草稿撰寫是兩個介面上最大的單一任務(Claude 18.6%、Claude Code 11.1%),Claude 接下來是文獻回顧 6.8% 與回覆審查意見 6.7%。AI 在科研工作流裡最忙的部分,是把已經做完的事情寫成字。
配套問卷調查了 528 位科學家,把任務分類(重要性評比涵蓋其中四類)拿去問「哪類對產出重要成果最關鍵」:發想排首位、資料收集其次。相對時間低用最明顯的兩類,恰好是科學家自評最重要的兩類。報告對這個缺口列出三種可能的解釋:資料收集很多是實體工作,AI 碰不到;發想可能是科學家想留給自己的判斷,或他們認為 AI 還不夠格;也可能發想常常織進其他任務裡,分類器抓不到、用量被低估。三種解釋報告都沒有排除,讀者不需要急著選邊。
報告接著回答「為什麼會長這樣」。團隊為 7,262 項任務裡的每一個步驟算出「理論 AI 能力分數」:讓語言模型對步驟兩兩比較「哪一個 AI 做得更好」,再用 Bradley-Terry 模型聚合,原理與棋手的 Elo 積分相同,贏一場比較加一點、輸一場減一點,最後把任務內步驟平均成任務分數。
結果是用量緊貼著能力走。能力分數前 20% 的任務(例如資料視覺化、套用統計檢定),用量約是時間占比的 2 倍(Claude)到 4 倍(Claude Code);後 20% 的任務(例如純化反應混合物、參與式觀察)幾乎沒有用量;中位數附近的用量則與時間占比相當。分數本身也講得通:與強化學習適用度的相關是 0.78、與認知型工作 0.69、與實體型工作負 0.57、與人際互動負 0.31、與法規限制負 0.38。任務結果容易驗證、可以反覆練習的,AI 最強,科學家用得也最深。
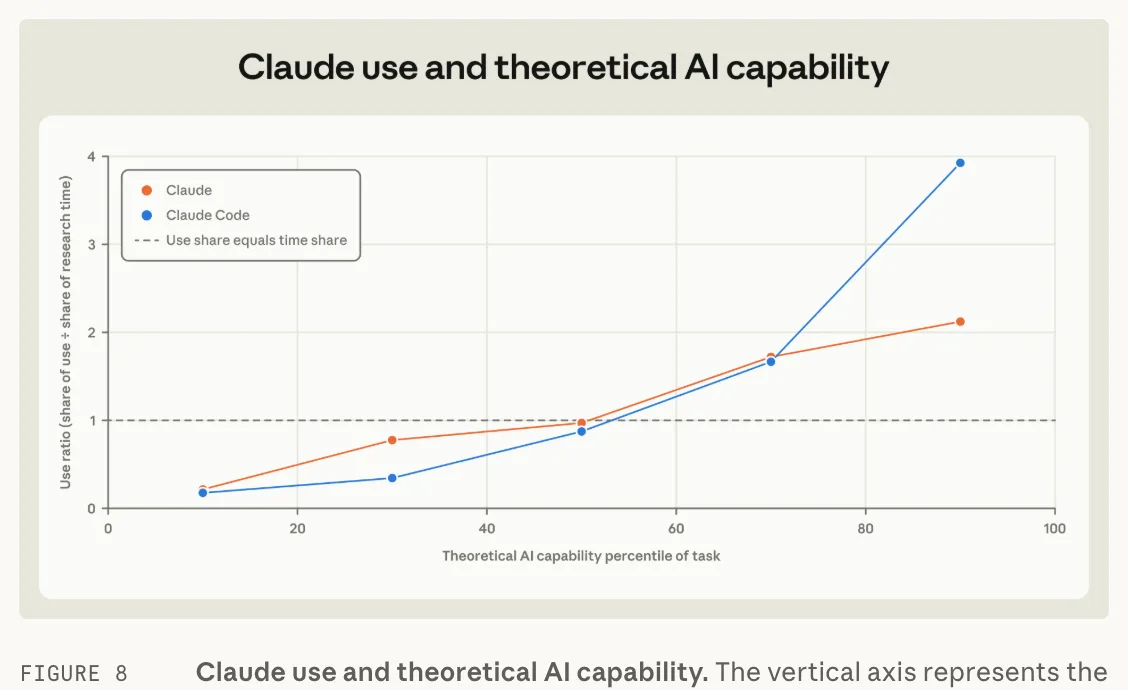
換句話說,目前的採用結構接近「AI 做得到什麼,就先外包什麼」,而不是按研究價值排序。報告同時點出規律的例外:健康科學的用量低於能力分數的預測(可能與醫療資料的法規限制有關);正式科學、社會科學與人文的用量高於預測,報告認為原因很可能是這些領域的多數工作經由文字與程式碼完成。
報告另外拿 Claude Science(連接多個研究資料庫與工具的專用科學介面)做補充樣本比較。在生物與生醫領域(兩者合計占 Claude Science 對話量超過一半),使用集中在更專門的任務:「為蛋白質與蛋白質或小分子的交互作用提出機制模型」這個任務,在 Claude Science 出現的機率是 Claude 的 5.6 倍;草稿撰寫、協調合作者這類通用事務反而相對變少。
發想占比的變化更值得看:Claude Science 的對話裡發想占 8%,與研究者時間占比大致相當,而在通用 Claude 上這個數字是 4.2%。任務也更長更難:報告估計 Claude Science 的工作換算成人工要花近兩倍小時、超過 80% 需要博士級訓練(其他介面約五到七成)、超過 70% 的對話以高自主完成,對比 Claude 的 23.7% 與 Claude Code 的 64.1%。
但書要寫清楚:這是補充樣本,報告未公開其樣本數;會去用專用科學介面的人,本來就偏向有專門需求的使用者,報告也把這組觀察稱為「使用型態」的差異,而不是效果證明。專用工具是否真能把發想用量拉起來,要等更大樣本與後續追蹤才能回答。
報告後半的加速倍數,是最容易被斷章轉引的部分。團隊用經濟學裡標準的點子生產函數模型跑了三個情境,並且明確標示這些是「illustrative scenarios, not forecasts」,示意用的情境,不是預測。
情境一假設現有能力被廣泛採用:AI 可接手 27% 到 52% 的研究者時間(跨領域中位 38%),換算成研究產出,藝術約 1.35 倍、人類學 1.36 倍、化學 1.41 倍、電腦科學 1.96 倍、統計 2.02 倍。連最 AI 友善的領域都只有約兩倍,因為目前的使用形態以輔助與共享為主,研究者幾乎每一步都還在場。
情境二與情境三是假設性的未來。非實體步驟被自動化 75% 時,電腦科學約 8 倍、統計與圖書資訊約 7 倍、經濟約 6 倍,多數社會科學、數學與物理天文約 4 到 5 倍;100% 自動化時,統計、電腦科學、經濟、數學、心理學與多數社會科學、人文約 15 到 16 倍,而生物、化學、材料、農業與生醫等實驗科學只有 3 到 4 倍。分野的來源是實體工作:實驗室與田野科學的研究者時間有 38% 到 41% 花在實體步驟,對比全體領域中位的 4%,這部分 AI 沒有手。
倍數對成本假設非常敏感。模型假設 AI 代理每小時 30 美元、研究者每小時 95 美元、AI 花 0.2 小時換 1 小時人力;在這組假設下,全自動任務的成本約是人力的十六分之一,成本減半、加速倍數大約加倍。模型也未計入儀器與實驗材料成本、大型設施的排程上限(報告舉大型強子對撞機為例),以及想法品質這個變數:如果 AI 提的假說成功率更高,加速會更快;如果研究品味是人類獨有,就會更慢。
問卷裡的研究者預期走得更遠:約 40% 預期 2030 年 AI 能獨立完成完整研究計畫、64% 預期 2035 年、16% 認為不會發生;2030 年前 AI 在資料分析匹敵頂尖研究者此一預期達 94%。但這批受訪者以生命與健康科學研究者為主,招募自 Anthropic 的 AI for Science 等補助計畫申請者(該公司另有請領域專家替 Claude 出難題的研究員計畫),隸屬美國與加拿大機構、本來就主動申請 AI 研究額度,很可能是偏重度的採用者,預期偏樂觀有結構性原因;先前 Anthropic 的另一份調查也顯示,員工與公眾對 AI 時程的預期本身就有明顯落差。報告同時引預測史提醒反方向:2022 年的調查裡,領域專家的中位估計說 AI 拿下國際數學奧林匹亞金級是 2030 年、超級預測者說 2035 年,實際 2025 年就發生了。
報告討論段把幾個沒有數字、但會決定上述情境真偽的變數講得很白。採用會落後能力:新技術的生產力要到組織圍繞它重整之後才會兌現。發想可能是新瓶頸:研究題目大致決定計畫的價值,而 AI 產出好題目的能力還不明朗。產量會考驗吸收:論文變便宜後,同儕審查與驗證的容量會成為新的限制,期刊、出資機構與機構的誘因設計會決定多出來的產能流向數量還是品質。安全要留檢查點:報告特別點名生物學,同一批加速醫療的能力也可能產出危險知識或材料,必要時值得用放慢進度換風險下降。最後是職涯:AI 接走乏味的行政工作(美國聯邦計畫主持人的研究時間約 44% 花在行政要求)可能提升滿意度,接走有趣的部分則可能相反,淨效果未知。
多數研究者不需要因為這份報告立刻改變什麼:它量的是行為,不是規範。比較有用的用法是把它當鏡子:拿出任務對照表,看自己團隊的 AI 用量落在哪一格,再問一句「發想與資料收集這兩段,我們是有意識地留給人,還是只是還沒想過」。前者是策略,後者是缺口。
三種分流。研究生與博士後:資料分析與寫作是樣本裡被反覆驗證的高用量段落,把可驗收的部分交給 AI、自己保留對結果正確性的最終檢查,是這份用量資料裡最常見的用法;但別把「AI 想題目」當成已解決的問題,發想在問卷的重要性排序居首、用量卻最低,落差本身就是提醒。實驗科學團隊:加速情境顯示實體步驟是上限所在,把 AI 投在分析與寫作、把人力留在濕實驗室,正是情境模型裡人力重新導向的方向;AI 找線索、人類做實驗的分工,實務上也已經有案例可循。機構與期刊:報告點名的吸收與驗證容量,是政策要提前想的問題,等產量上來再想就晚了。
未確認與保存期限同樣明確。發想在分類上有低估可能(織在其他任務裡難以單獨標出)、問卷母體很可能是偏重度採用者、Claude Science 樣本數未公開、加速模型未計設備與設施成本。報告數字對應 2026 年 11 月 5 日發布、11 月 6 日最後修改的版本;Claude Science 的產品與定價變動、SciNet 資料集更新,或 Anthropic 下一份用量報告發布時,任務分布與情境數字都需要重查。