TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

WeClone 是 1.8 萬星開源數位分身工具,用 Telegram 聊天紀錄微調 Qwen 模型,練出講話像你的 AI 分身再接上機器人。微信資料源與語音克隆已在 2025 年 7 月移除,投入前先看清硬體門檻與隱私邊界。
用 AI 摘要這篇文章:
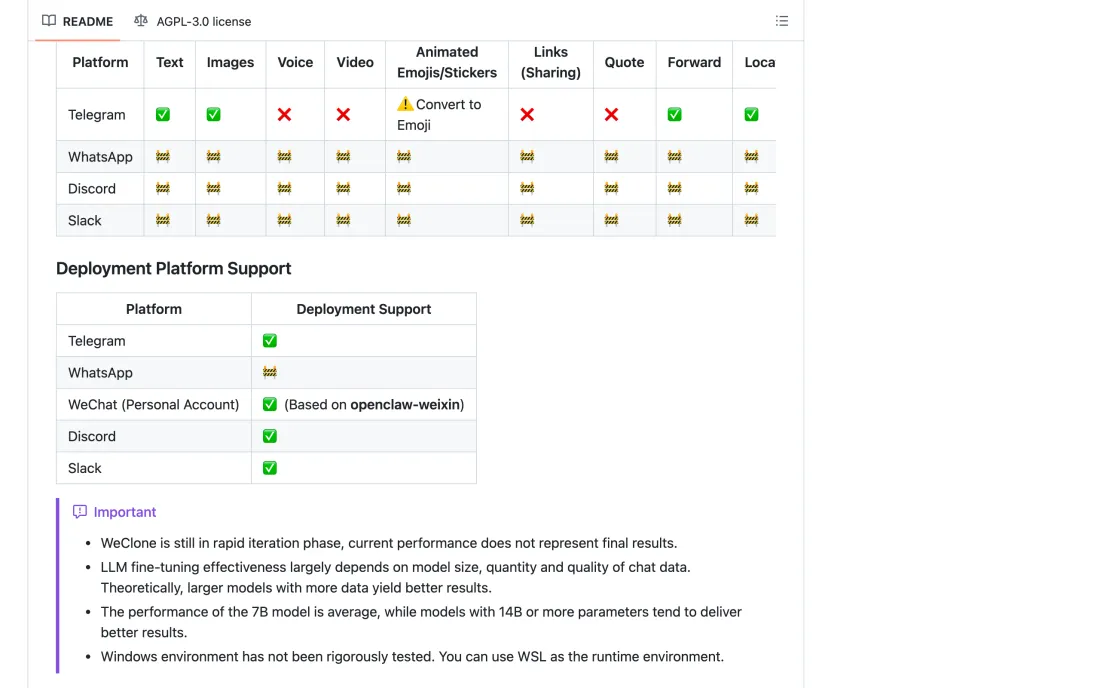
2025 年春天這個專案暴紅的時候,大家記住的畫面是:解密微信聊天資料庫,餵給大模型微調,再克隆你的聲音,做一個「微信數字分身」。一年半後把它的 GitHub 倉庫 clone 下來翻版本歷史,看到的是另一個故事:微信解析程式在 2025 年 7 月 16 日被整支刪掉,語音克隆模組兩天前先走一步,現在安裝文件教你匯出的第一個資料來源,是 Telegram。
18,231 顆星(截至 2026 年 9 月)、AGPL-3.0 授權、持續有維護,WeClone 仍然是「用聊天紀錄練一個像自己的 AI」這條路上最完整的開源管線。只是它今天吃什麼資料、要付什麼代價、中間踩過哪些線才變成現在這個樣子,跟一年前中文圈流傳的版本差得很遠。接下來把它現在的樣貌、轉向的過程,以及投入前該知道的邊界一次講清楚。
一句話:把你在 Telegram 上的聊天紀錄整理成問答資料,拿去微調一個開源語言模型,練出講話節奏與用詞習慣都像你的小模型,再包成 API 接到聊天機器人上。官網把這條鏈包裝成「數位分身一站式方案」,賣點四個:聊天資料匯出、私有資料微調、多平台機器人整合、隱私過濾與本地部署。整條鏈自己跑完,沒有任何打包好的雲端服務在中間抽成:
| 階段 | 它給你的東西 |
|---|---|
| 資料 | Telegram Desktop 內建匯出功能,把指定聯絡人的 JSON 聊天檔放進 dataset 資料夾 |
| 整理 | weclone-cli make-dataset 自動配對問答、過濾個資、產生訓練集 |
| 訓練 | 預設 Qwen2.5-VL-7B-Instruct 搭 LoRA 微調,底層引擎是 LLaMA-Factory |
| 測試 | weclone-cli webchat-demo 開一個本機網頁,先跟自己的分身聊天調參數 |
| 部署 | weclone-cli server 起一個 OpenAI 相容 API,交給聊天機器人框架接上 Telegram、Discord、Slack |
專案 2024 年 1 月 31 日建立,作者 xming521,README 致謝裡列了北京郵電大學 VCIS 實驗室的支持。2026 年 9 月 17 日還有新的 PR 合併,內容是讓舊款顯卡能用 float16 跑訓練,所以它不是棄坑專案;但 2026 年到目前只發過一版 v0.3.03(2026 年 1 月 4 日),版本節奏明顯放慢。
時間線要從 2025 年 4 月說起。
2025 年 4 月 22 日的 v0.2.0,是它爆紅時的樣子:README 教你用 PyWxDump 解密微信本機資料庫、匯出 CSV;同年 5 月的更新明寫不支援微信 4.0,6 月起圖片還得再過一支第三方解密工具;語音克隆模組 weclone-audio 只能在 Windows 匯出語音,用 0.5B 參數的 Spark-TTS 模型合成聲音。同時期中文報導流傳的「聲音相似度 95%」「5 秒樣本建模」「自動處理好友請求」,在當時版本的 README 與模組文件裡都找不到出處,這些數字當故事聽就好。
一週後的 4 月 30 日,微信安全中心發布打擊公告,點名「以 AI 管理用戶微信聊天記錄等名義、繞過微信安全技術措施」違規取得用戶資料的第三方工具,表示要依平台規則處理。這份公告的連結,到今天還掛在 WeClone 中文版 README 的免責聲明裡。
接下來的兩個多月,專案連續走了幾步:
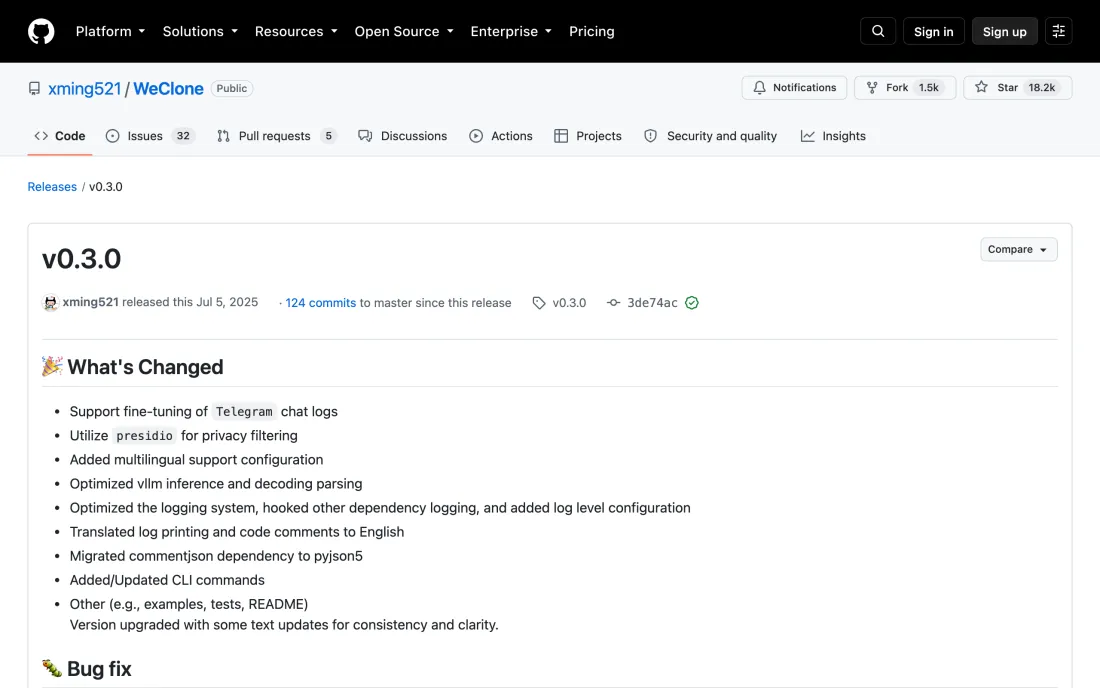
remove wechat:87 行的 wechat_parser.py 刪除,資料來源支援表上的微信整行移除。作者沒有在任何地方說明刪除微信的原因。時間先後就擺在那裡:打擊公告在 4 月底出現,轉向在 7 月中完成,中文 README 的免責區掛著公告連結。要說平台政策壓力是轉向主因,這是我的推論;但資料路徑從「解密別人家的資料庫」換成「Telegram 官方內建匯出」,方向確實往安全的那一側走。
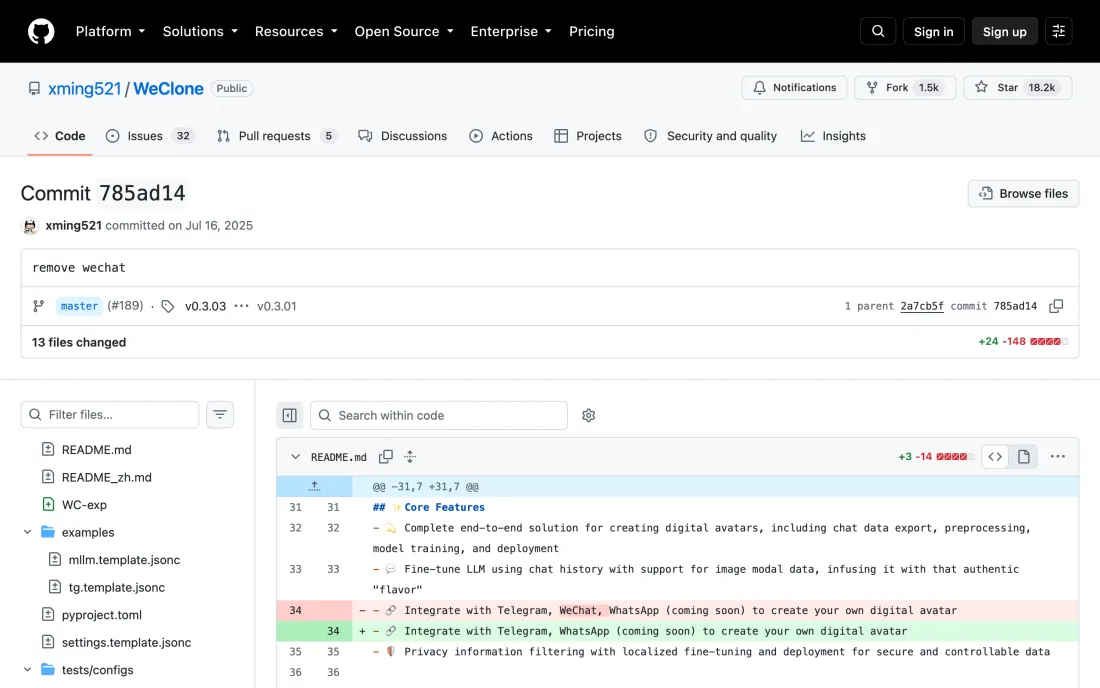
轉向之後的版本史也看得出重心移到哪裡:v0.3.01(2025 年 7 月 17 日)給雲端清洗呼叫加上自動重試;v0.3.02(2025 年 8 月 17 日)讓離線清洗可設定思考模式、改善圖片與 GIF 在問答配對裡的處理;v0.3.03(2026 年 1 月 4 日)把 Python 升到 3.12、整理資料集管線。半年三版,方向都是資料處理的穩定性,沒有再回到微信或語音的跡象。
轉向是有代價的。語音克隆沒有搬家,直接消失了:現在的 README、官方文件與官網 weclone.love 都不再提語音這件事,分身只剩文字與圖片兩種模態。想要會說話的分身,得自己找語音克隆方案另外接上去。
還有一條沒寫在文件上的暗路:程式裡的 PlatformType 列舉其實留著 chat 這個通用值,會去讀 dataset/csv 目錄下的 CSV 檔,格式正是當年 PyWxDump 匯出的那一種。程式碼還在,文件不教了。真要餵微信資料的人技術上辦得到,但踩的線跟 2025 年一樣,公告也還掛在免責區。
資料準備從 Telegram Desktop 的「匯出聊天記錄」開始:選 JSON 格式、勾照片,把每個聯絡人的 ChatExport 資料夾放進 dataset/telegram,再在設定檔填上自己的 Telegram user ID,程式才知道哪些訊息是你說的。官方建議一對一聊天為主,群組紀錄不推薦,畢竟分身要學的是你跟特定對象的相處方式,幾十個人插話的群組只會把資料弄髒。
整理階段把同一個人兩分鐘內連發的訊息合併成一輪,把五分鐘內一來一往的訊息配成問答,接著跑隱私過濾。封鎖詞清單可以自己加,含封鎖詞的整句會直接從訓練集剔除。要帶圖片的話,設定檔的 include_type 勾 image,每筆訓練資料最多帶 2 張;貼圖也能勾,但會被轉成 emoji,官方在設定檔註解裡自己承認後果是分身可能輸出一堆表情符號。
訓練預設用 Qwen2.5-VL-7B-Instruct 做 LoRA 微調。顯卡記憶體門檻官方給過一張表:7B 用 LoRA 要 16GB,QLoRA 壓到 4-bit 約 6GB 就能跑;改用 14B 模型,LoRA 大約 32GB 起跳。沒有這種等級顯卡的人,官方 FAQ 給的路徑是先在雲端平台租 GPU 訓練,再把訓練好的 model_output 資料夾下載回本機跑推理,訓練與部署可以拆在兩個地方。訓練完先用網頁 demo 聊一聊,調溫度與 top_p,滿意了再開 API 服務。
部署是把它包成一個 OpenAI 相容的 API 端點:模型名稱固定填 gpt-3.5-turbo,金鑰欄隨便填。AstrBot、LangBot 這類開源聊天機器人框架都吃這種端點,接上 Telegram、Discord、Slack 之後,回話的就是你的分身。有個容易漏的細節:微調過的模型不再支援工具呼叫,官方 AstrBot 教學提醒要先在訊息平台送出 /tool off_all 把預設工具全關掉,否則分身的語氣會被外掛干擾,練出來的味道聽不到。個人微信號也能當部署端,官方表上標註靠 openclaw-weixin 專案接上,但那只是讓機器人活在微信裡,資料來源依然輪不到微信。
這是投入前最該看清楚的一段。
預設的隱私過濾用微軟 Presidio,處理電話號碼、信箱、信用卡號、IP 位址、地名、國際銀行帳號、加密錢包位址、年齡與一般 ID 編號;程式裡另有中文偵測器,補上 18 碼身分證字號的正規表示式。看起來很齊,但原始碼裡有一行清單寫得明白:PERSON、DATE_TIME、URL、NRP 這四類預設不濾。也就是說,聊天內容裡出現的人名、你們分享過的網址,都會原封不動進訓練集。
你在訓練自己,也在訓練跟你聊天的那幾百個人。他們的訊息成為你分身的一部分,這件事不需要他們同意,責任在按下訓練的那個人身上。封鎖詞清單是唯一的補救,人名要一個一個自己加。
另一個容易忽略的出口:訓練本身在本機,但兩個選配功能會把內容送出去。資料清洗預設關閉,打開後有兩種跑法,用本機模型離線打分數,或走 online_llm_clear 把對話批次送給雲端模型評分,文件建議用的是 DeepSeek-V3;圖片轉文字的 vision_api 一樣是填 API key 的雲端呼叫。「本地微調」四個字不涵蓋這兩段,鑰匙填誰家的自己決定。README 同時掛著一家 API 轉售商的贊助橫幅,附推廣連結,用哪家的金鑰沒有限制。
還有一個立場上的矛盾值得知道。設定檔的預設系統提示詞是「Please act like a human and don’t say you are an artificial intelligence」,叫分身裝成真人、否認自己是 AI;README 的免責聲明卻強烈建議每次對話開頭表明 AI 身分。官方一邊給你越線的預設值,一邊在免責區提醒別越線。拿去冒充真人跟別人聊天,出了事,免責聲明救不了你。
官方文件對效果意外地誠實:7B 效果普通,14B 可接受,32B 更好。作者在 2025 年 4 月版的 README 給過自己的量級:Qwen2.5-14B 配上約 3 萬條處理後的有效對話,loss 練到 3.5 左右。想要「像自己」的成果,模型大小與資料量都有門檻;6GB 顯卡能跑完流程,跟跑出好結果,是兩回事。FAQ 對「效果不理想」開出的藥方也圍繞這兩件事打轉:換更大的模型、累積更多聊天資料、開資料清洗,以及改用多模態模型減少訊息被切碎丟掉的數量。
GitHub issue #37 從 2025 年 4 月起就是微調效果反饋的集中串,效果不好的回報一直沒斷過。也有一條已關閉的討論在問,能不能克隆逝去的親友作為心靈慰藉;這類用途的情緒與倫理邊界,社群裡沒有共識。2026 年 9 月還有人來提案 consent-first(先取得同意)的訓練流程,目前停在提案階段。
Windows 官方明說沒有嚴格測試,建議用 WSL 跑;這對照當年語音匯出「僅限 Windows」的設計,多少有些諷刺。授權是 AGPL-3.0:修改後自架、對外提供服務,衍生程式有開源義務。免責聲明把專案定位在學習與實驗,商用與對外服務的風險全部自負;官方同時聲明唯一官網是 weclone.love、從未發行任何加密貨幣,市面上同名項目要自己當心。
適合動手的人大概長這樣:主力聊天軟體是 Telegram,有一張 16GB 以上記憶體的 NVIDIA 顯卡(或願意租雲端 GPU),想親眼看 LoRA 微調怎麼把一個人的說話風格種進模型。入場動作很輕:clone 倉庫、用 uv 建環境、匯出一份聊天紀錄,先用 webchat-demo 跟自己講話,不喜歡隨時停。官方文件在 docs.weclone.love,從硬體需求到每個設定檔參數都有獨立頁面,照著走不需要先懂 LLaMA-Factory。
想克隆聲音的人可以繞開了,這功能已經不在專案裡;資料都在微信裡的人也不必等,官方路徑已斷,剩下的暗路都踩著那份公告;想包成商業服務的人,AGPL 的開源義務加上實驗用途的免責定位,法務成本會比技術成本高。把它當成研究個人化模型的練習題,是今天這個專案最站得住腳的位置。
最後一個提醒:這個專案 2025 年暴紅時承諾的東西,跟今天倉庫裡的東西,已經是兩個版本的故事。往後再看任何「微信數字分身」的舊文,先確認文章日期,再決定要相信多少。這個轉向對身在台灣的我們其實是好事:Telegram 在台灣能用、匯出是官方功能,想認真玩一輪個人化微調,今天比 2025 年那個要解密資料庫的版本,門票便宜得多,只是這張門票仍然不便宜。