TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

阿里巴巴 Qwen 團隊在 11 月 16 日把 Qwen4-Max 從限時預覽轉為正式版,開放按量計費與六個部署區域。本文對照預覽版與正式版兩份官方文件,整理輸出上限、預設推理強度與快取的差異,並分開檢視官方自測、Artificial Analysis 與 Vals AI 三組評測數字各自量的是什麼。
用 AI 摘要這篇文章:
Qwen 團隊在 11 月 16 日上午 10 點(台北時間)於 X 宣布 Qwen4-Max 正式版推出,距離 11 月 11 日預覽版開放只隔了五天。模型代號從 qwen4-max-preview 換成 qwen4-max,阿里雲 Model Studio 的正式版文件與牌價表同日上線。
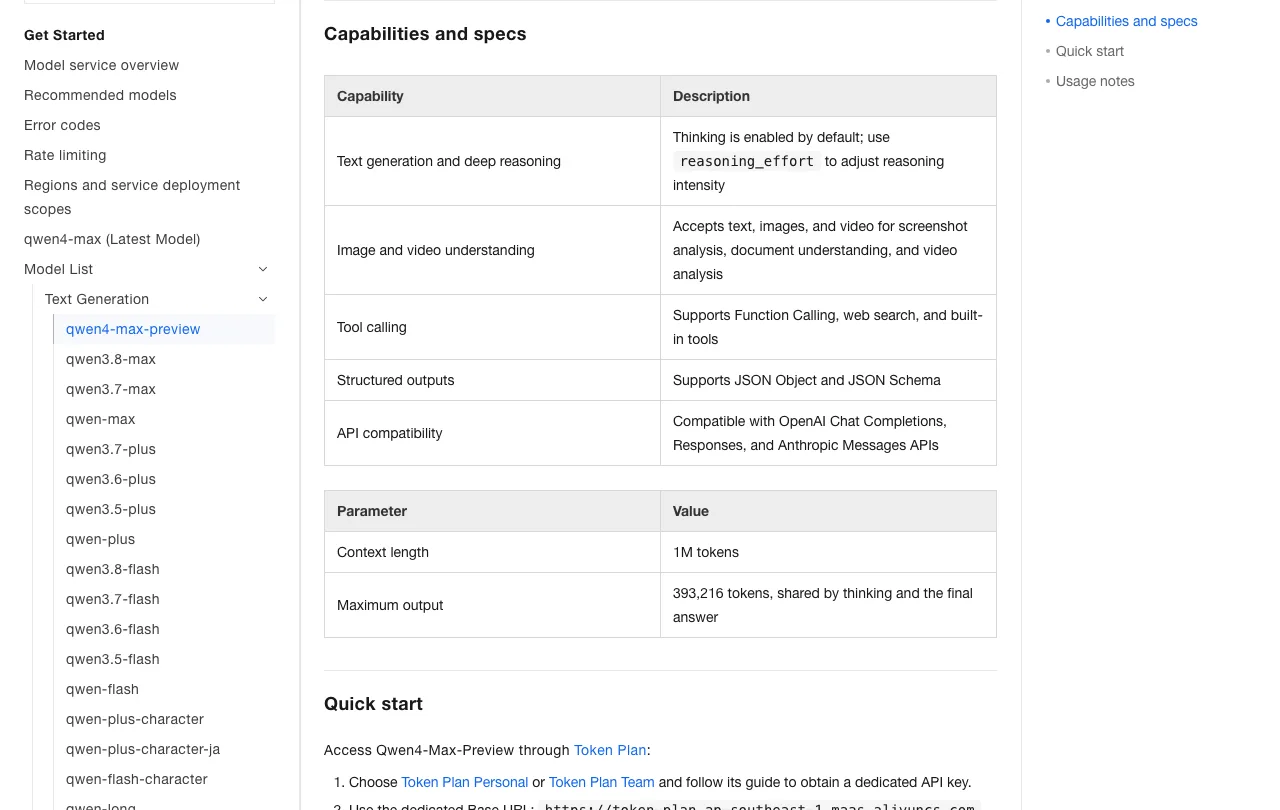
把預覽版和正式版的官方文件並排放,最影響開發者的差異只有一個數字:輸出上限縮水了。預覽版文件寫的是思考與答案共用 393,216 個 token,正式版文件改成合計 262,144 個,非思考模式另外給 131,072 個。曾經在預覽版上跑長輸出任務的程式,搬過去之前得先重算額度。預覽版本身會在 11 月 25 日 24:00(UTC+8,等同台北時間)退場,這個期限沒有改。
這篇整理兩份官方文件的逐項對照、按量計費的牌價與快取價,以及伴隨發表的三份成績單各自量的是什麼。能力與架構的數字全部來自官方宣稱,本文沒有實際呼叫 API,判斷的基礎是文件與公開牌價。
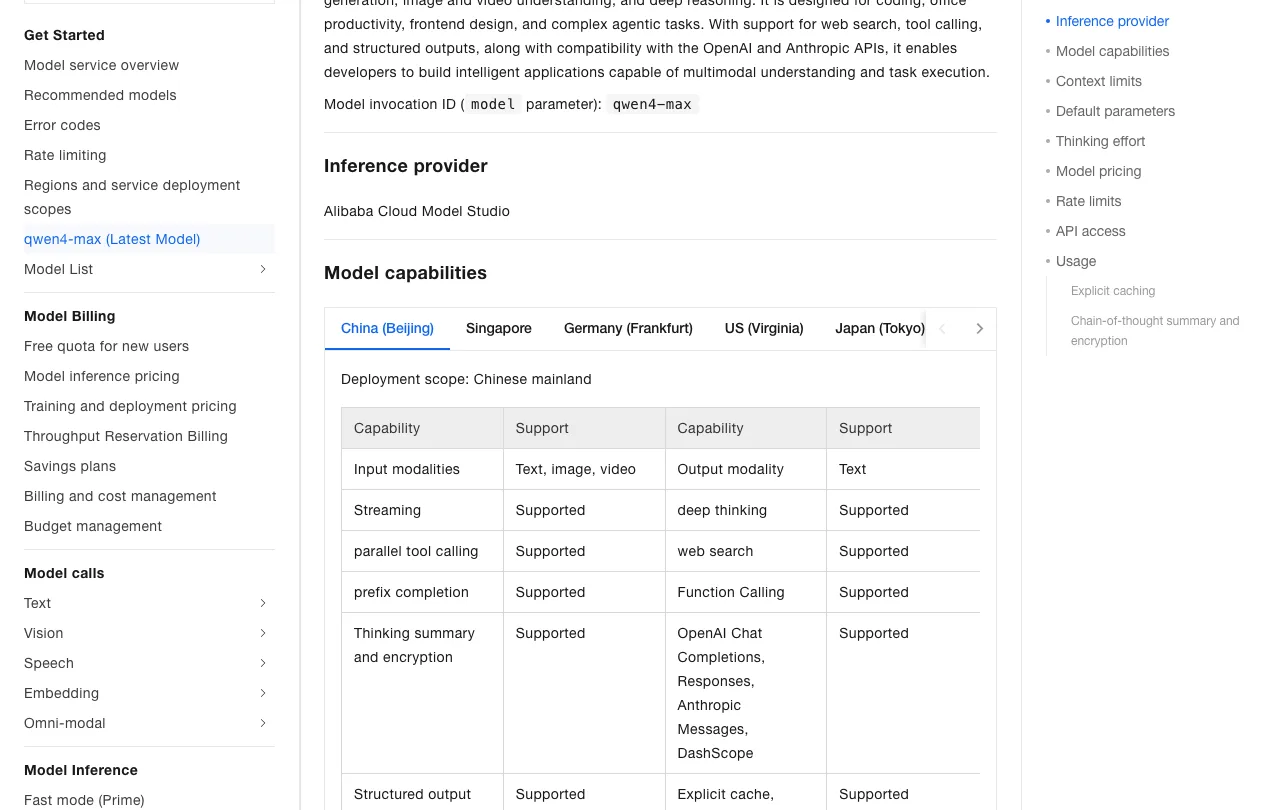
預覽版的規則我們在先前的預覽版整理寫過:只能用 Token Plan 訂閱的金鑰、走專用端點、按量計費帳號不能呼叫。正式版把這套入口整個換掉,改回阿里雲 Model Studio 的常規計費,並且一次開出六個部署區域:北京、新加坡、香港、法蘭克福、美國維吉尼亞與東京。
| 面向 | 預覽版(11 月 11 日文件) | 正式版(11 月 16 日文件) |
|---|---|---|
| 取得方式 | 僅 Token Plan 訂閱金鑰 | 按量計費,六區部署 |
| 輸出上限 | 思考加答案共用 393,216 | 合計 262,144;非思考 131,072 |
| 輸入上限 | 文件未單列 | 思考 983,616;非思考 991,808 |
| 推理強度 | low、medium、xhigh,預設 xhigh | low、high、xhigh,預設 high |
| 快取 | 文件未列 | 明確快取與隱含快取,含牌價 |
| 期程 | 11 月 25 日 24:00 退場 | 常設,免費額度 90 天 |
還有兩個文件層面的細節值得記下。預覽版文件在 11 月 11 日版寫的是「預覽期間不做變更」,11 月 16 日更新後這句改成了「模型能力會在預覽期間持續迭代升級」;同一次更新也補上一句「正式版已提供,建議使用」。也就是說,官方自己承認預覽期間的能力有在動,兩個版本跑出來的結果未必能直接比較。
另一個是契約上的取捨:正式版文件明列批次推論、微調與模型部署三項不支援。想把它搬進自己的推論叢集或做領域微調的團隊,這條路目前是關著的。
介面相容性倒是給得足:OpenAI Chat Completions、OpenAI Responses、Anthropic Messages 與 DashScope 四種 API 都能呼叫,網頁搜尋、平行工具呼叫、結構化輸出(JSON Object 與 JSON Schema)、字首補全都列在支援表上。預覽版當時的 Token Plan 指南把 Claude Code、Codex 這類對手陣營的編程工具列為支援對象,正式版回到按量計費後,這條接線的選擇只會更多。
六個區域的適用範圍也有差異,選區前值得看一眼:北京區的部署範圍標的是中國大陸,新加坡標 International,香港、法蘭克福、維吉尼亞、東京四區標 Global。對資料要存在哪個地區有合規考量的團隊,這個標籤就是選區的第一道篩選。速率限制在新加坡與北京按帳號在百鍊平台的月消費分三層:月消費 8,000 美元以下 TPM 上限 500 萬,8,000 到 14 萬美元 1,000 萬,再往上 2,000 萬;另外四個 Global 區沒有消費分層,固定是每分鐘 30,000 次呼叫加 TPM 500 萬。
遷移最容易踩的不是新增功能,而是那些看起來沒變的參數。
推理強度的檔位換了名字。預覽版的 reasoning_effort 接受 low、medium、xhigh 三檔、預設 xhigh;正式版改成 low、high、xhigh 三檔、預設 high。用 OpenAI 相容介面的開發者要特別注意映射規則:正式版把 medium 對應到 high、minimal 對應到 low、max 對應到 xhigh。如果你的程式寫死 medium,搬過去之後實際拿到的是 high 檔,思考行為和 token 消耗都會跟著變。
輸出額度的語意要重算。預覽版的 393,216 是思考與答案共用的上限;正式版改成合計 262,144,非思考模式另外是 131,072。官方文件在預覽版就提醒過,思考會吃掉同一份額度,只按答案長度設定上限的程式可能被提早截斷;換到正式版後這個提醒更加適用,因為上限本身就降了三分之一。預設的 thinking_budget 是 131,072、max_completion_tokens 在思考模式預設 262,144,這些數字都值得在遷移前逐一核對。
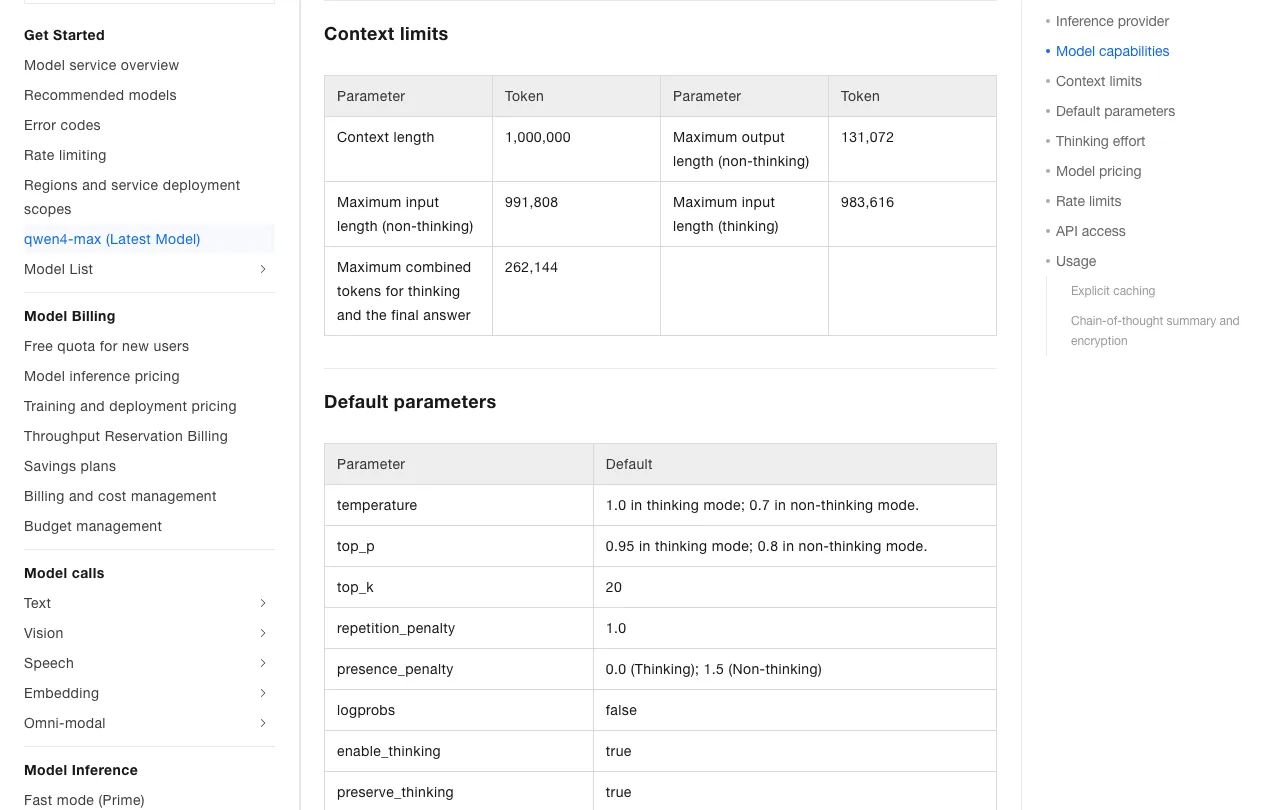
輸入側的帳也要重對。正式版文件把輸入上限分開寫:思考模式 983,616、非思考模式 991,808,這兩個數字是上下文一百萬扣除預留輸出空間後的值(分別預留 16,384 與 8,192),輸入與輸出不能同時取到最大值。倚賴長文件、整批資料往 prompt 裡塞的流程,建議先用邊界值試一次。
多輪對話的思考欄位也有新東西。正式版把「思考摘要與加密」列為正式能力:模型回傳摘要式的推理過程供介面顯示,另給一份加密過的完整思考,多輪時原樣傳回即可延續脈絡,不必把整段推理攤在請求裡。預覽版只有 preserve_thinking 保留開關,正式版等於把這塊的介面契約補完整了。
官方部落格對新架構給出的數字是:主幹 2.4 兆參數、每處理一個 token 啟用其中 710 億,另外有一組 3,280 億的 N-gram 嵌入參數。這是稀疏混合專家(MoE)設計,把參數分給多個專家、每次只呼叫一小部分,所以總參數量和實際運算量是兩回事,概念上和其他 MoE 模型的專家結構同一家族。
官方宣稱這次改了三個地方:注意力機制採用 Gated DeltaNet 搭配 Qwen Sparse Attention,每層 QSA 配三層 GDN,把歷史壓縮成固定大小的狀態,再用輕量索引器挑出相關上下文,官方稱這能降低長序列的注意力成本;各層之間改用四條平行殘差分支加動態讀寫閘;第二層加入 N-gram 嵌入。官方另稱預訓練過程損失曲線平穩、基地模型在自測的 BPB 指標比上一代低 5% 到 13%,而且啟用參數少 25%。
這些說法的證據層級要畫清楚:權重沒有公開。第三方追蹤站 Vals AI 把它標為 Private,我查了 Hugging Face 的 QwenLM 組織,目前查不到任何 qwen4 模型。官方只預告 Qwen4 家族較小的模型「將開源」,沒有給日期。同期真正開源的是一個周邊工具:Live-Delivery-Plugin,Apache-2.0 授權的 TypeScript 專案,11 月 14 日建立。架構宣稱在權重公開前,只能當作賣方自述。
按量牌價以新加坡區(官方標 International)為基準:輸入每百萬 token 1.5 美元、輸出 4.5 美元;北京、香港、法蘭克福、維吉尼亞、東京五個區域是 1.413 與 4.24 美元。對照同一張牌價表裡的 qwen3.8-max(2 美元與 6 美元),等於輸入輸出都降了 25%。新模型附帶 100 萬 token 免費額度,自帳號啟用、模型發布或申請通過三者中最晚的日期起算 90 天。
快取的計費結構值得單獨看。明確快取支援 5 分鐘與 1 小時兩種 TTL,寫入價分別是輸入單價的約 125% 與 200%(新加坡區是 1.875 與 3 美元),讀取只要 0.075 美元,約輸入價的 5%。對系統提示、工具描述、參考文件這類會重複出現的字首,命中快取的輸入成本幾乎可以壓到原本的二十分之一;沒被快取覆蓋的 token 仍按原輸入價計。官方文件同時提醒,命中率取決於字首與斷點位置是否穩定,請求模式會漂移的場景要先算清楚。官方部落格也明說,相較上一代「快取輸入的降幅尤其大」。
官方同時給了一個每任務成本的數字:在自家 Work360 評測裡,平均每任務成本從 4.43 美元降到 1.67 美元,降幅 62%。這是內部評測的宣稱,它的前提是 token 用量同步下降(官方稱 Work360 用量在極高檔位 xhigh 約降 24%、高檔位 high 約降 35%)。你的任務成本降幅取決於自己的用量結構,牌價降 25% 不等於帳單降 25%。
不想開阿里雲帳號的話,Vercel AI Gateway 已經用同樣的 1.50 與 4.50 美元列價提供這個模型,算是目前最直接的第三方入口。
官方的成績單來自自建的 Work360 基準:這套分類覆蓋 26 個一級領域、182 個二級子領域、721 個三級專業,Qwen4-Max 得分 52.69,官方給出的上一代分數是 47.74。X 上的發表貼文把用量宣稱濃縮成一句「比 Qwen3.8-Max 最多省下約五成 token」,部落格裡對應的數字是 Work360 極高檔位(xhigh)約降 24%、高檔位(high)約降 35%,Terminal-Bench 4.0 兩個檔位都在 48% 到 49% 之間。問題是這些全是 Qwen 自己測的,分類與題目都出於自家對「工作場景」的定義,外部單位目前沒有獨立重跑的結果可對照。
Artificial Analysis 給的分數是 42.89,頁面取整顯示 43。在同一份榜單裡,它排在 Kimi K3.1 Pro(46.45)與 Muse Wonder(43.57)之後、Grok 4.7(35.49)與 GLM-5.3(31.65)之前,屬於中段位置。有個容易漏看的細節:AA 已經把 Qwen3.8-Max 的兩個版本都標成棄用,現行榜單上沒有它們的分數。想在 AA 頁面上直接做世代對比的讀者,這條對照線目前已經斷了。
Vals AI 給的是另一種答案:Vals Index 63.20%、誤差約正負 1 個百分點,38 個模型裡排第 11。分項的落差比總分更能看出定位:程式生成方向的 Vibe Code Bench 有 86.66%(129 個模型中排 15)、金融 61.99%(41 個中排 8)、法律 70.71%(39 個中排 17);另一端,法律研究基準只有 41.35%(95 個模型中排 33)、稅務代理 40.35%(86 個中排 13)、長時程代理基準 HLAB-Vals-1.1 是 21.25%(39 個中排 7)、Terminal-Bench 4.0 是 48.48%(65 個中排 15)。同一個模型在「答題型」分項靠前,「長鏈研究型」分項的絕對分數卻明顯偏低(21% 到 41%),這個形狀對照官方主打的長任務敘事,正是需要更多獨立驗證的地方。另外兩個後設細節:Vals 把收錄日期標為 11 月 15 日,比官方公告早一天,第三方收錄與官方時程本來就可能有時間差;它的資料頁也標註權重 Private,與官方文件宣稱的影片輸入支援相比,Vals 頁面標的是影片輸入不支援,兩邊不一致時我以官方文件為準。
把三份成績單疊起來看,一個從榜單結構推導的判斷是:官方主打的每任務成本沒有第三方同口徑的量法,長任務只有 Vals 的 HLAB 分項沾到邊;世代對照在 AA 斷了鏈,同指標可查的只有 Vals Index:它給 Qwen4-Max 63.20%,並註明上一代 Qwen3.8-Max-0902 是 59.05%。有趣的是兩家榜單連相對位置都不同調:Vals 上它以 63.20% 領先 Kimi K3.1 Pro 的 62.52%,AA 上反而以 42.89 分落後對手的 46.45。「比上一代強多少」「排第幾」目前都沒有單一權威答案,跨榜單引用前先看口徑。
如果本來就在預覽版上測試,11 月 25 日前有幾件事值得排進去:
reasoning_effort 的設定整串掃一遍,特別是寫死 medium 或依賴預設值的段落;還沒有答案的部分也要說清楚:本文沒有實際呼叫 API,端到端的表現與穩定度未驗證;較小 Qwen4 模型的開源只有預告、沒有日期;快取牌價本文引用的是新加坡區數字,其他五區的快取價位沒有逐一展開。回查的三個錨點:11 月 25 日預覽退場當天、Hugging Face 的 QwenLM 組織頁(開源兌現與否的第一手訊號)、以及 AA 與 Vals 的分數變動。從 9 月雲棲大會的一張投影片到正式版牌價上線,Qwen4 這條線走了將近兩個月,下一個值得盯的節點是它何時把「開源」兩個字變成 repo。
回到一開始的問題:要不要遷移?文件的答案很直接,預覽版 11 月 25 日就沒了,繼續用本來就得搬。真正要判斷的是你的用量結構吃到哪一段價:長字首重複的場景有快取讀取價撐著,高檔位長任務則要看官方宣稱的 token 用量降幅在自己身上成不成立。這兩個數字,都比榜單名次更值得花時間算。