TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Omarchy 在 11 月 9 日同日合併代理面板推薦行、引擎下載狀態與 64GB 模型配方,DHH 六天後在 NVIDIA N1x 筆電展示 18 秒完成系統安裝。兩份 64GB 配方附實機量測:Nemotron 3.5 Bolt 保住 262K 視窗,Qwen3.8 27B 用視窗換 12 GiB 快取,長對話恢復從兩分鐘級縮到 1.7 秒;面板的下載入口官方明記尚未完成端到端驗證。
用 AI 摘要這篇文章:
Omarchy 在 2026 年 11 月 9 日同一天合併了三個互相依賴的變更:本機 AI 引擎學會回報下載狀態、模型目錄新增 64GB 機器的配方、代理面板開始在首頁推薦可以下載的本機模型。同日發布的引擎版 v0.5.0 把引擎與配方打包成一次更新,桌面側的面板變更則要搭配這個新版引擎。六天後,專案作者 DHH 貼出一張 NVIDIA N1x 筆電上「0 分 18 秒裝完 Omarchy」的照片,配文寫著再過幾秒,系統就會建議你下載一個很不錯的本機模型來跑。
如果你只想帶走三件事:十八秒量的是作業系統安裝,模型本身的載入要再等 37 到 56 秒,兩件事不能相加也不能互換;64GB 的 N1x 與 DGX Spark 級機器,現在的推薦順序是 Nemotron 3.5 Bolt 先、Qwen3.8 27B 後,兩份配方都附實機量測數字;代理面板的下載入口在合併記錄裡明寫還沒做過端到端確認,畫面讀得到狀態與全程驗收是兩回事。
這三個變更的驗證基礎強度有別:配方數字有實機量測、面板有自動化測試、引擎有實際執行紀錄。
先認識兩個名字。Omarchy 是 DHH 打造的 Arch Linux 桌面發行版,MIT 授權,GitHub 上有四萬多顆星。omarchy-local-ai 則是 11 月 1 日才建立的官方倉庫,自我定位是「Omarchy 代理使用的本機模型目錄」,同時也是引擎本體:它負責解析配方、下載釘住版本的權重,並用 rootless Podman 容器把模型伺服器跑在內部網路、唯讀根檔案系統與白名單裝置的邊界裡。換句話說,目錄與引擎是同一份東西,隨套件一起安裝,執行時不會另外上網抓目錄。
時間軸排開是這樣:11 月 8 日晚間(UTC),64GB 配方的合併請求提出;11 月 9 日上午,引擎側的下載狀態變更先合併(07:38 UTC),64GB 配方在 13 分鐘後跟進,Omarchy 桌面側的面板推薦行再過半小時合併,v0.5.0 於 08:30 UTC 發布。之後三天內又連發五個版本,把兩台 DGX Spark 用 ConnectX-7 串起來跑單一模型、跨機分享模型等功能一路疊到 11 月 12 日的 v0.6.4。
11 月 15 日深夜(台北 23:18),DHH 在 X 上貼出安裝結果照片:深色終端畫面、OMARCHY 像素字樣,中央一行「Installed Omarchy in 0m 18s」,下方是重新開機按鈕。原貼全文的承諾其實有兩段:18 秒裝完系統,以及幾秒後系統建議你下載本機模型。第二段正是 11 月 9 日那個面板變更在使用端實際看到的畫面,只是這次示範的機器換了主角。
主角是 NVIDIA N1x,DHH 量測用的機器是搭載這個平台的 Dell XPS 16 筆電、64GB 統一記憶體。目錄的分類邏輯寫在引擎程式碼裡,一行映射把 nvidia-n1x 歸進 nvidia-gb10 類別,也就是 DGX Spark 採用的晶片等級;兩種機器共用同一份推薦清單,由記憶體大小決定能跑什麼,量測記錄仍會標註實際在哪種硬體上量的。這個設計對讀者的意義:DGX Spark 的既有討論與 N1x 新機器的適用性,看的是同一張表。清單也照顧其他陣營,AMD Strix Halo 等級的 128GB 機器有自己的推薦組合,Qwen 兩份配方在 AMD 上走另一套名為 Gufo 的執行環境。
把本機代理帶進大眾桌面這條線,今年已經很熱鬧:從 Perplexity 把本機 Agent 帶上 Windows,到 Osaurus 1.0 免費上架 Windows,各家都在降低「在自己機器上跑代理」的門檻。Omarchy 這步的差異化在於連「該裝哪個模型、要給多少快取」都一起接上,而不只是把代理裝起來。
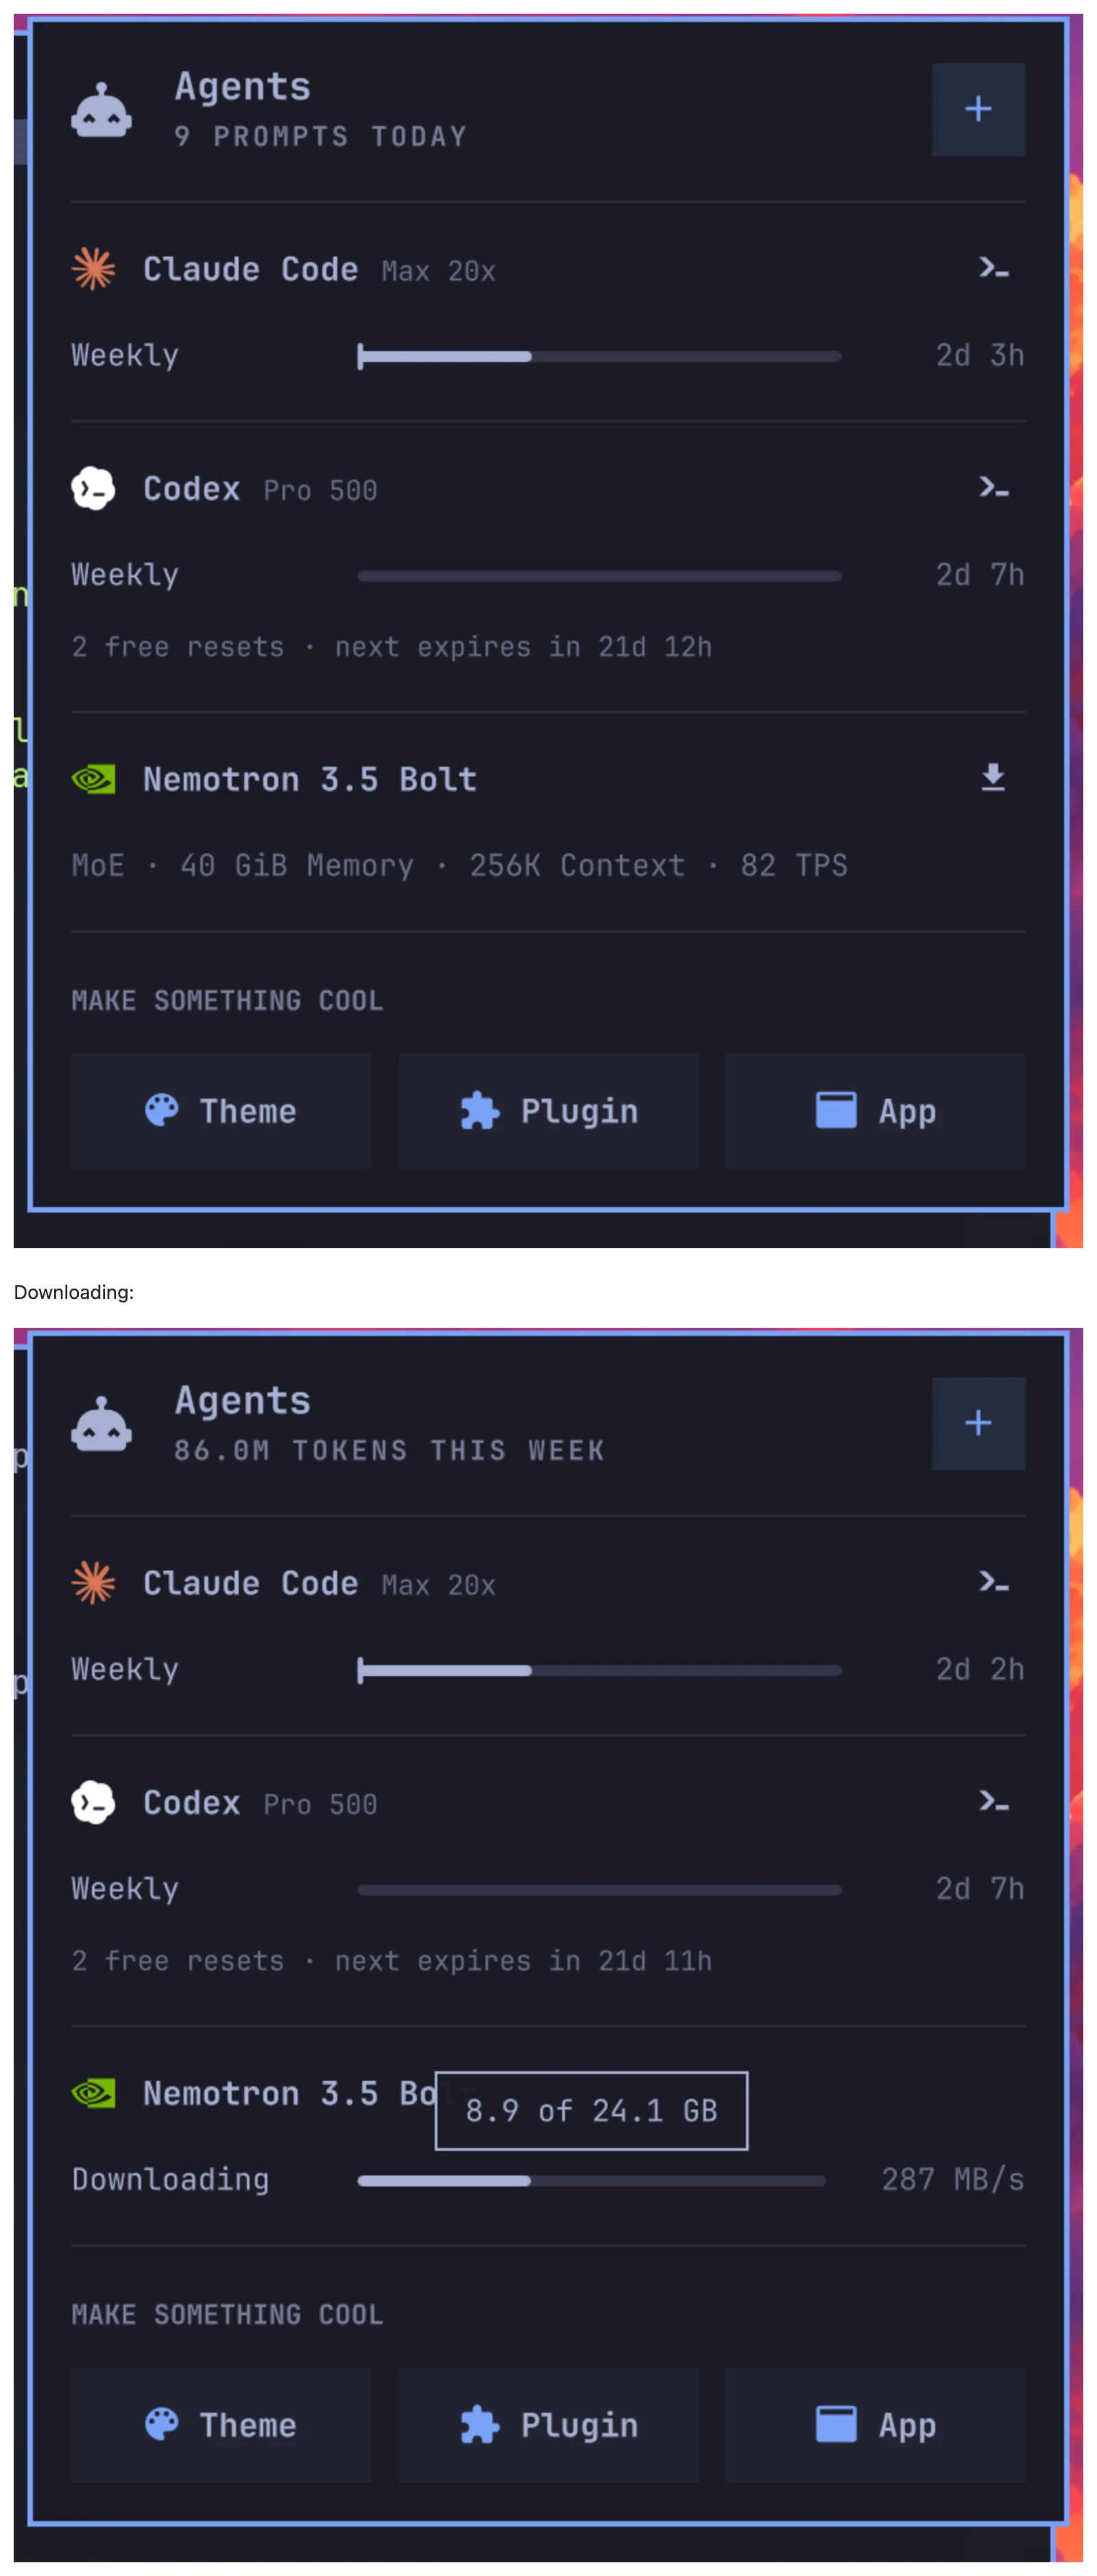
在這次更新之前,本機模型只能從面板的「Add another › Local AI」走終端機設定,門檻是你要先知道自己該裝哪個模型、接受一段命令列流程。更新後,只要機器上還沒有任何本機模型,代理面板首頁就會多出一條推薦行。
推薦行的挑選規則寫得很具體:目錄清單裡同時標為最佳與可用、而且尚未安裝的那份配方。畫面上會顯示廠商標記、模型名稱與三個事實欄位(記憶體、上下文、速度),下載按鈕放在本來代理終端機按鈕的位置。它和裝好後的模型共用同一個編號(local: 加配方名),所以裝完後會留在你儲存的排序裡;把它刪掉則代表隱藏這條推薦,之後不會自己冒回來,想重來隨時可以從原本的 Local AI 入口走。
按下下載後,面板呼叫引擎的 use –detach 指令在背景執行。狀態回報是一個小狀態機:先進等待(等設定鎖),接著下載中,畫面是一條含已抓位元組與速度的進度條,權重檔與執行環境映像檔算在同一條裡,速度取最近四秒的平均,每半秒只改寫那一行而不重掃全部狀態。模型開始載入後換成載入進度條;設定失敗會留在畫面上並顯示失敗原因。刪除鍵有兩種行為:取消進行中的設定,或關掉一條失敗記錄,後者會讓推薦行重新出現。
有個務實的細節:面板裡沒有終端機可以輸入管理者密碼。當背景設定偵測到 Podman、crun 或 NVIDIA 容器工具包缺裝時,會開一個浮動終端機把套件裝完,再回頭繼續背景工作。少打命令是真的,但安裝權限仍然存在,只是被搬到你看得到的地方。
兩個倉庫同日合併不是巧合。面板的介面程式原本遇到不認識的狀態單元,會把整份狀態檔拒讀;如果引擎先出現「安裝中」這種新狀態,面板的本機模型區塊會整個凍住。所以順序必須是引擎先支援安裝狀態、面板再學會讀它,合併記錄裡也明寫桌面端需要搭配新版引擎。這對使用者的實際含義:介面看起來怪怪的時候,先檢查兩邊版本是否成對。
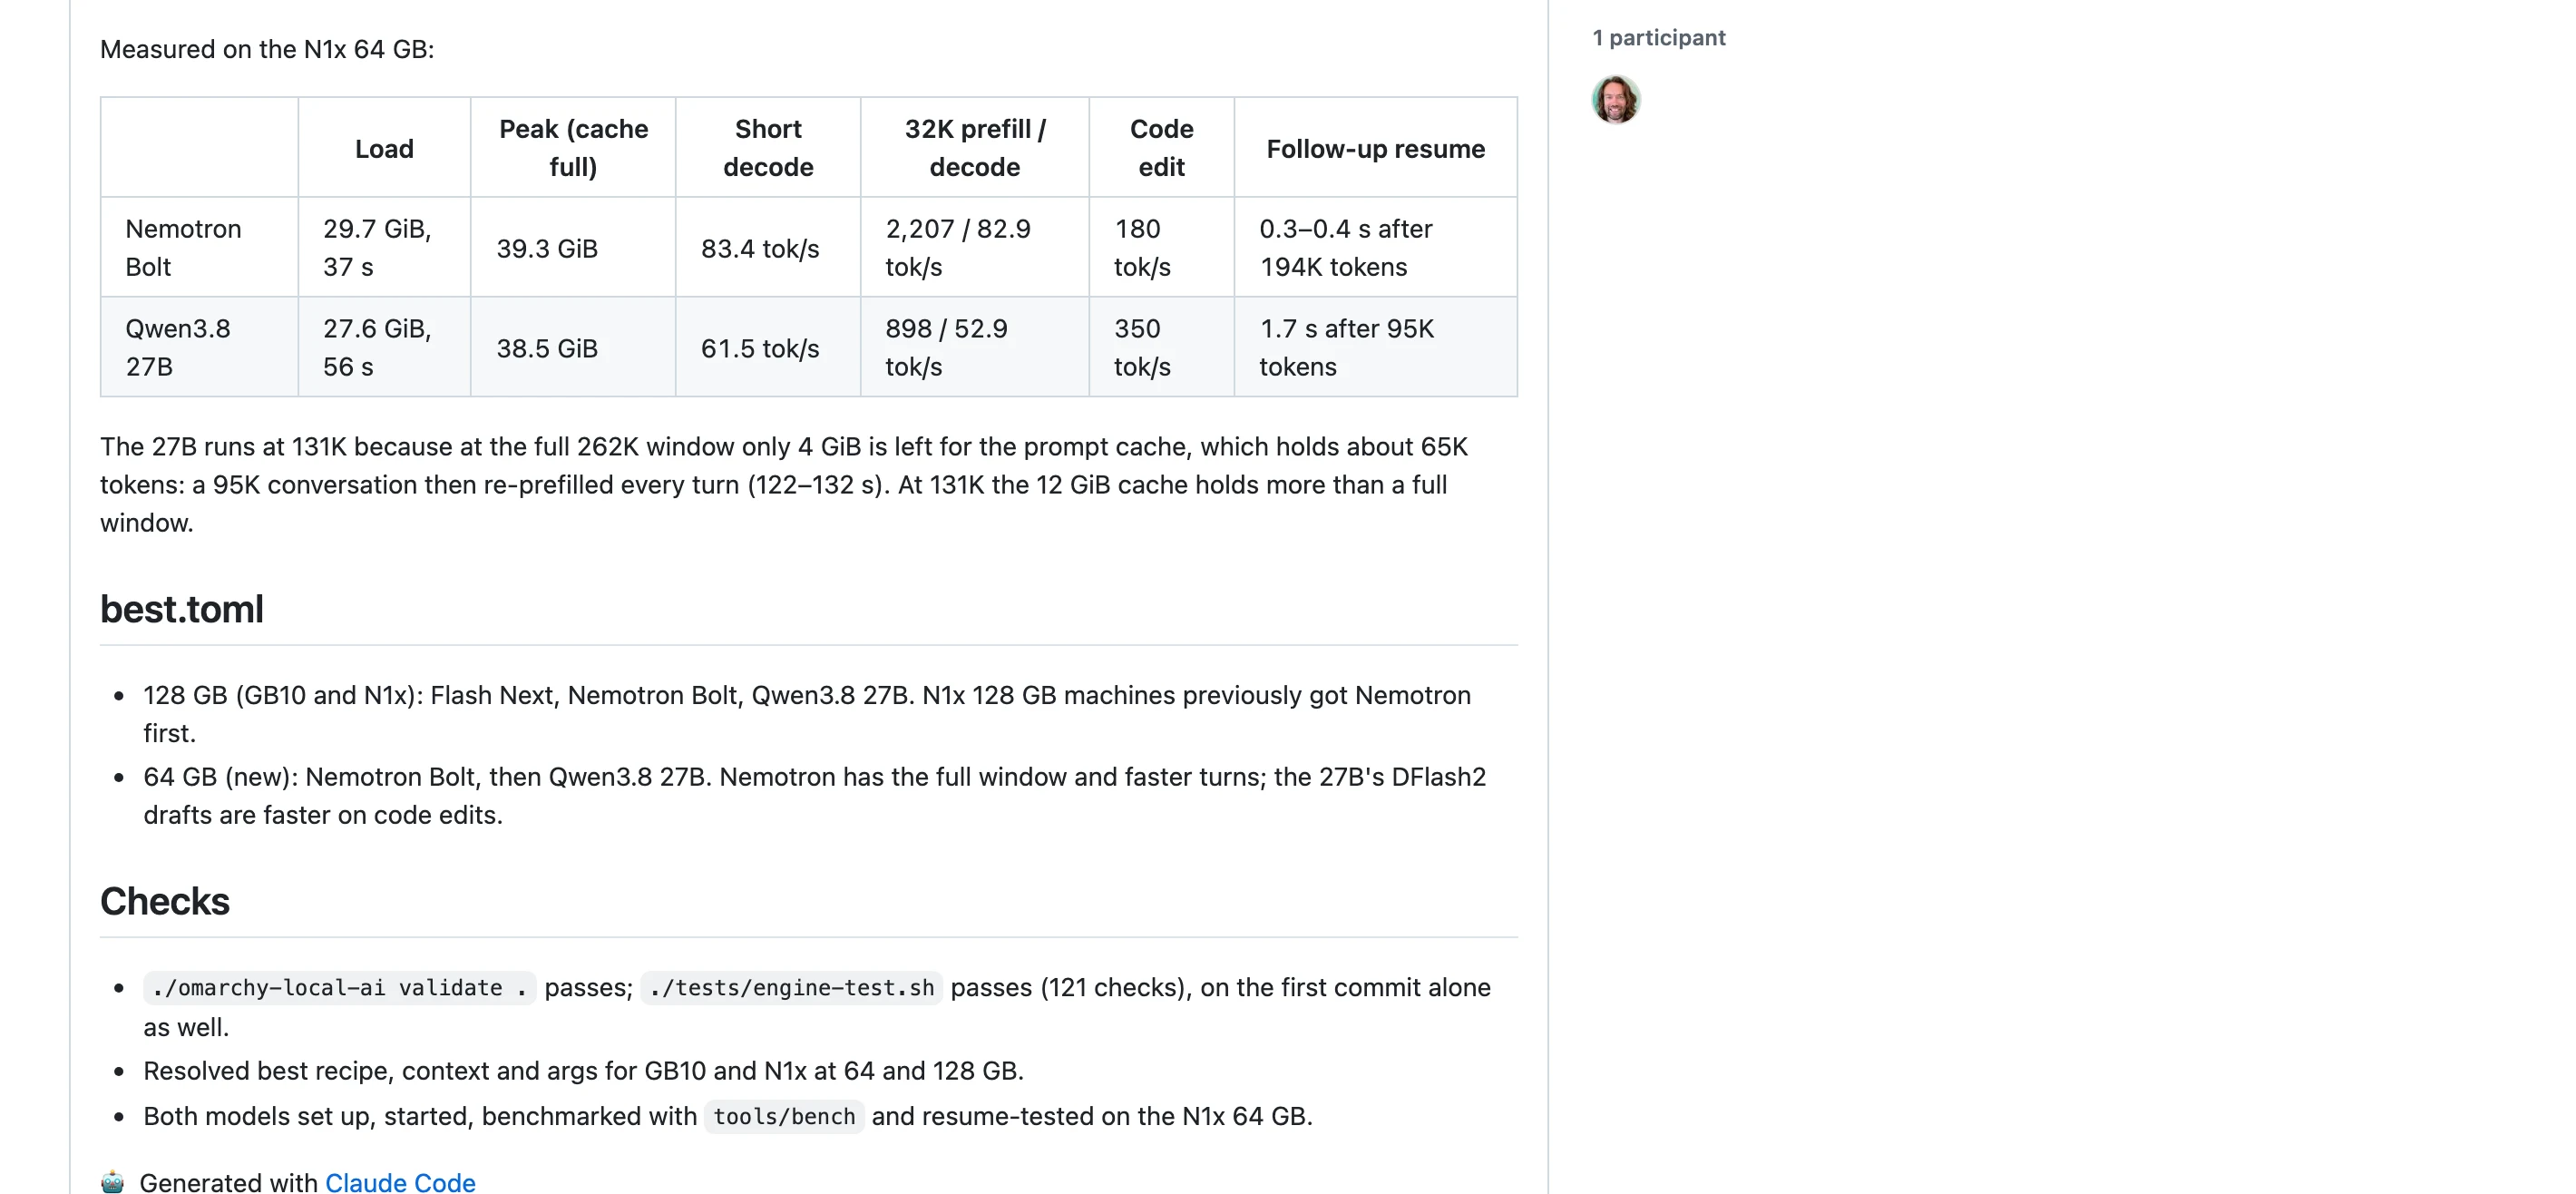
配方是這次更新真正的主角。一份配方把模型權重、執行環境、上下文長度、並行工作階段數與提示快取大小綁成一包,並附上在特定硬體上的量測記錄。64GB 類別目前有兩份,量測都在那台 Dell XPS 16 上完成:
| Nemotron 3.5 Bolt | Qwen3.8 27B | |
|---|---|---|
| 架構 | 74B 混合專家,每 token 活躍 9B,打包進 24GB | 27B 密集模型,4-bit 量化 |
| 上下文視窗 | 262K(完整保留) | 131K(從 262K 縮半) |
| 並行工作階段 | 1(128GB 版是 4) | 1(128GB 版是 3) |
| 提示快取 | 8 GiB | 12 GiB |
| 載入 | 29.7 GiB,37 秒 | 27.6 GiB,56 秒 |
| 峰值記憶體(快取填滿) | 39.3 GiB | 38.5 GiB |
| 短提示生成速度 | 83.4 token/秒 | 61.5 token/秒 |
| 32K 輸入後生成速度 | 82.9 token/秒 | 52.9 token/秒 |
| 程式編輯速度 | 180 token/秒 | 350 token/秒 |
| 長對話後恢復 | 0.3 至 0.4 秒(19.4 萬 token 之後) | 1.7 秒(9.5 萬 token 之後) |
兩份配方的取捨邏輯不同。Bolt 選擇保住完整的 262K 視窗,代價是把並行工作階段從 128GB 版的四條砍到一條,快取維持 8 GiB;配方檔的量測註解寫著,用 19.4 萬 token 的對話實測,後續追問 0.3 到 0.4 秒就接上,首輪則要 86 秒。Qwen 27B 走相反路線:如果硬用完整 262K 視窗,記憶體只剩 4 GiB 給提示快取,大約裝 6.5 萬 token;一段 9.5 萬 token 的對話就會超出快取,每一輪都要重新預填,合併記錄寫每次 122 到 132 秒(配方檔另一處註解寫 133 秒,口徑接近)。把視窗縮到 131K、快取放大到 12 GiB 之後,快取裝得下超過一整個視窗的內容,同樣情境的恢復時間變成 1.7 秒。
這組數字背後有一個對所有本機模型都適用的教訓:視窗上限與提示快取吃的是同一池記憶體。模型宣稱能讀多長,與每一輪能否有效重用讀過的部分,由不同的記憶體預算決定。如果你的工作型態是在同一份專案上連續追問,快取空間比視窗數字更直接決定你的等待;如果你的回合短、輸入不長,完整的視窗與較快的基本速度更有感。這與 Strata 在 12GB 顯卡上跑 DeepSeek V4.1 Flash 要先算硬碟與記憶體帳是同一族問題:先算記憶體帳,再選模型。
128GB 版的 Qwen 配方把同一套邏輯放大給你看:三條並行工作階段、24 GiB 快取,代價是三條工作階段的注意力快取在啟動時就預留(每一條 16.9 GiB),載入即 70 GiB、快取填滿約 94 GiB 峰值。官方在 DGX Spark 上量的恢復數字同樣戲劇性:19.4 萬 token 的對話後追問,3.4 秒接上,對照沒快取可用時的 241 秒。記憶體翻倍買到的與其說是更大的模型,不如說是把「快取裝得下整段工作」這件事做寬。
兩份配方的草稿機制也值得看一眼,因為它解釋了程式編輯速度的逆轉。Bolt 用 NVIDIA 的 LiLiCorr 草稿器,每輪最多先猜七個 token 再交給主模型查核;Qwen 27B 用 z-lab 的 DFlash2 區塊草稿器,一輪可以先展開一整棵草稿樹。後者在程式編輯這種高重複性工作把速度推到每秒 350 token,明顯快過 Bolt 的 180;但短提示與 32K 輸入後的生成速度都是 Bolt 領先。64GB 的推薦順序把 Bolt 放前面,官方給的理由是它有完整視窗與較快的回合;偏好程式編輯手感的人,第二順位其實是為你準備的。
128GB 類別這次也跟著調整:N1x 128GB 原本首推 Bolt,現在的清單變成 Qwen3.8 Flash Next(125B 混合專家、MTP 草稿)、Bolt、Qwen 27B 三層。再往上一級還有兩台 DGX Spark 用 ConnectX-7 串接的配對類別,跑 GLM-5.3 Flash。
這次更新最誠實也最容易被忽略的部分,是它的驗證範圍寫得非常清楚,三個層級強度不同。
配方數字是最硬的一層,但注意量測者身分:所有 64GB 數字都出自維護者本人在實機上跑的基準工具與恢復測試,沒有第三方重跑過。目錄有一條自律規則幫它背書:配方只能列在有量測記錄的硬體類別上,推薦清單上的每個位置都對得回一份量測檔。另外有個小坑:v0.5.0 的 release 說明寫 Bolt 短提示速度 91 token/秒,合併記錄的表格寫 83.4,兩個官方版本各說各話且都沒附測試條件,引用時建議註明出處而不是只報一個數。
面板這層是中等強度。合併記錄列的驗證包括:shell 測試 60 項通過(其中 8 項新增)、翻譯字串測試、以及用配方倉庫附的模擬狀態檔在實機上確認推薦行與下載中畫面讀得進來。但同一節明寫:還沒有用面板真正驅動一次完整背景下載做端到端確認,這需要新引擎裝好後才能做。
引擎這層反而有實測:use –detach 在 DGX Spark 上實際跑過,84 毫秒返回、總量 19.92 GB 在開始時就知道、穩定在每秒約 290 MB。把三層合起來讀:推薦與下載的畫面邏輯有測試保護,引擎的下載路徑有實機紀錄,但「從按下按鈕到模型可用」這條完整鏈,官方自己標記為未驗收。實際試用時若看見推薦卻下載失敗,先核對引擎版本,再查設定狀態,別急著怪硬體。
供應鏈與授權邊界也交代得完整:引擎本身 MIT;Bolt 的權重走 NVIDIA 自家的 OpenMDW 授權條款(配方檔標記為 other 類),Qwen 27B 的權重與草稿器都是 Apache-2.0;執行環境是按 digest 釘住的第三方映像檔,上層是簽章發布的 tensorfold-native 1.2.1 原版、debian 精簡底層、不含 CUDA 工具鏈與 PyTorch。v0.5.0 還順手修了一個統一記憶體的坑:Bolt 映像檔現在把可回收記憶體算進可用額度,頁面快取填滿後不會再拒絕超過 4096 token 的請求。
版本先對齊:64GB 配方與安裝狀態都從 v0.5.0 開始才有,面板行為要配對應的引擎版本,本文核對時最新版是 11 月 12 日的 v0.6.4。
環境方面,第一次按下下載時若跳出浮動終端機,那是系統在補裝 Podman、crun 與 NVIDIA 容器工具包,屬正常流程。習慣 Ollama 生態的人要想清楚差別:這裡的目錄把參數、快取大小與量測記錄綁成整包,好處是不用自己調,代價是選擇目前限於目錄收錄的三類硬體。
期待值方面,64GB 的兩份配方都只有一條並行工作階段,一次服務一個代理對話;想同時跑多個代理,那是 128GB 版配置(Bolt 四條、Qwen 三條)的領域。
工作型態對應:長對話連續追問選 Qwen 拿快取優勢,短回合與完整視窗選 Bolt;記憶體被瀏覽器或其他程式佔走時,載入與峰值都會漂,自己的數字自己記。
最後留一個回查錨點:這套目錄從無到有只花了兩週,五個 release 疊得很快。兩個訊號出現時值得回來看:面板端到端驗證補上,或 64GB 推薦順位再變動。在那之前,十八秒的照片就讓它留在作業系統安裝那一步,模型的世界要用自己的碼表來量。