TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

ThinkInAI 的 DeepSeek 相容性檢測是免費網頁工具,選好記憶體規格就能判斷電腦跑得動哪個 R1 尺寸。實測三組配備與企業計算機,對照門檻與 Ollama 官方大小完全一致,並提醒兩件事:六個小尺寸都是蒸餾學生版,計算機的 GPU 推薦未含站方自己建議的兩成預留。
用 AI 摘要這篇文章:
想在自己電腦跑 DeepSeek R1 的人,最先撞上的問題都一樣:我的機器到底行不行。ThinkInAI 做的 DeepSeek 模型相容性檢測工具,把這件事變成三分鐘的滑桿操作:選作業系統、拉出記憶體容量,六張卡片直接告訴你哪個尺寸能跑、哪個被擋。它是免費網頁工具,不用註冊,我實際操作了三組配備,外加隔壁那台企業部署計算機跑了一輪 671B 的帳。判定背後的數字大多經得起對照:卡片上的模型大小,六個裡五個和 Ollama 官方標籤一致。
先講結論。這個工具值得放進書籤:公式攤在頁面上、門檻對得上官方資料,把判定邏輯攤開的程度勝過常見的一鍵偵測工具。但要把它的答案用對,有兩件事得先看懂。偵測器裡的六個 DeepSeek R1 模型全是蒸餾出來的學生版,真正的 671B 原版只存在企業計算機裡;而計算機開出的採購建議,沒有套用它自己文字建議的兩成預留,照單全收會買在緊繃邊緣。
介面只有兩類輸入:作業系統四選一(Windows、Linux、Apple 晶片 Mac、Intel 晶片 Mac),加上記憶體滑桿。系統記憶體的檔位是 8、16、32、64、128GB。選 Apple 晶片 Mac 時只問系統記憶體,因為統一記憶體架構下,系統記憶體就是顯示卡能動用的量,頁面也會標註這一點;選 Windows、Linux 或 Intel Mac 才會多一條 VRAM 滑桿,檔位從 0 到 64GB,Intel Mac 還會提醒需要獨立顯示卡才有 GPU 加速。
有個小限制先知道:滑桿只能停在檔位上。系統記憶體是 8、16、32、64、128GB 五檔,VRAM 是 0 到 64GB 的幾個整數檔,12GB 記憶體或 6GB VRAM 這種真實存在的規格只能就近選,判定從嚴或從寬一級,介意的人拿表格門檻自己心算反而準。
我用三組配備各跑一輪。最貼近一般人的是 Apple 晶片 Mac 配 16GB:1.5B、7B、8B、14B 四張卡片亮綠燈,32B 與 70B 被擋下。值得停下來看的是 14B 那張卡,工具開出的門檻正好寫 16GB 統一記憶體,這台機器是踩著及格線過關,談不上舒適。工具自己的說明文字建議記憶體要有 VRAM 需求的一點五倍,照這個係數,16GB 的 Mac 想舒服跑 14B,其實差了半個檔位。
另一輪用預設狀態的 Intel Mac(16GB 記憶體、8GB VRAM):7B 與 8B 過關,14B 的 GPU 判定轉紅,但 CPU 判定仍是綠燈。這裡可以看出它的雙軌設計:GPU 狀態講的是有沒有顯示卡可用,CPU 狀態講的是退而求其次、靠處理器硬撐能不能動。14B 在這台機器上屬於後者,跑得動,體驗會明顯慢一截。再把 Windows 拉到 32GB 記憶體與 16GB VRAM,14B 的 GPU 判定轉綠(門檻 12GB),32B 仍被擋(建議 24GB,RTX 4090 等級)。
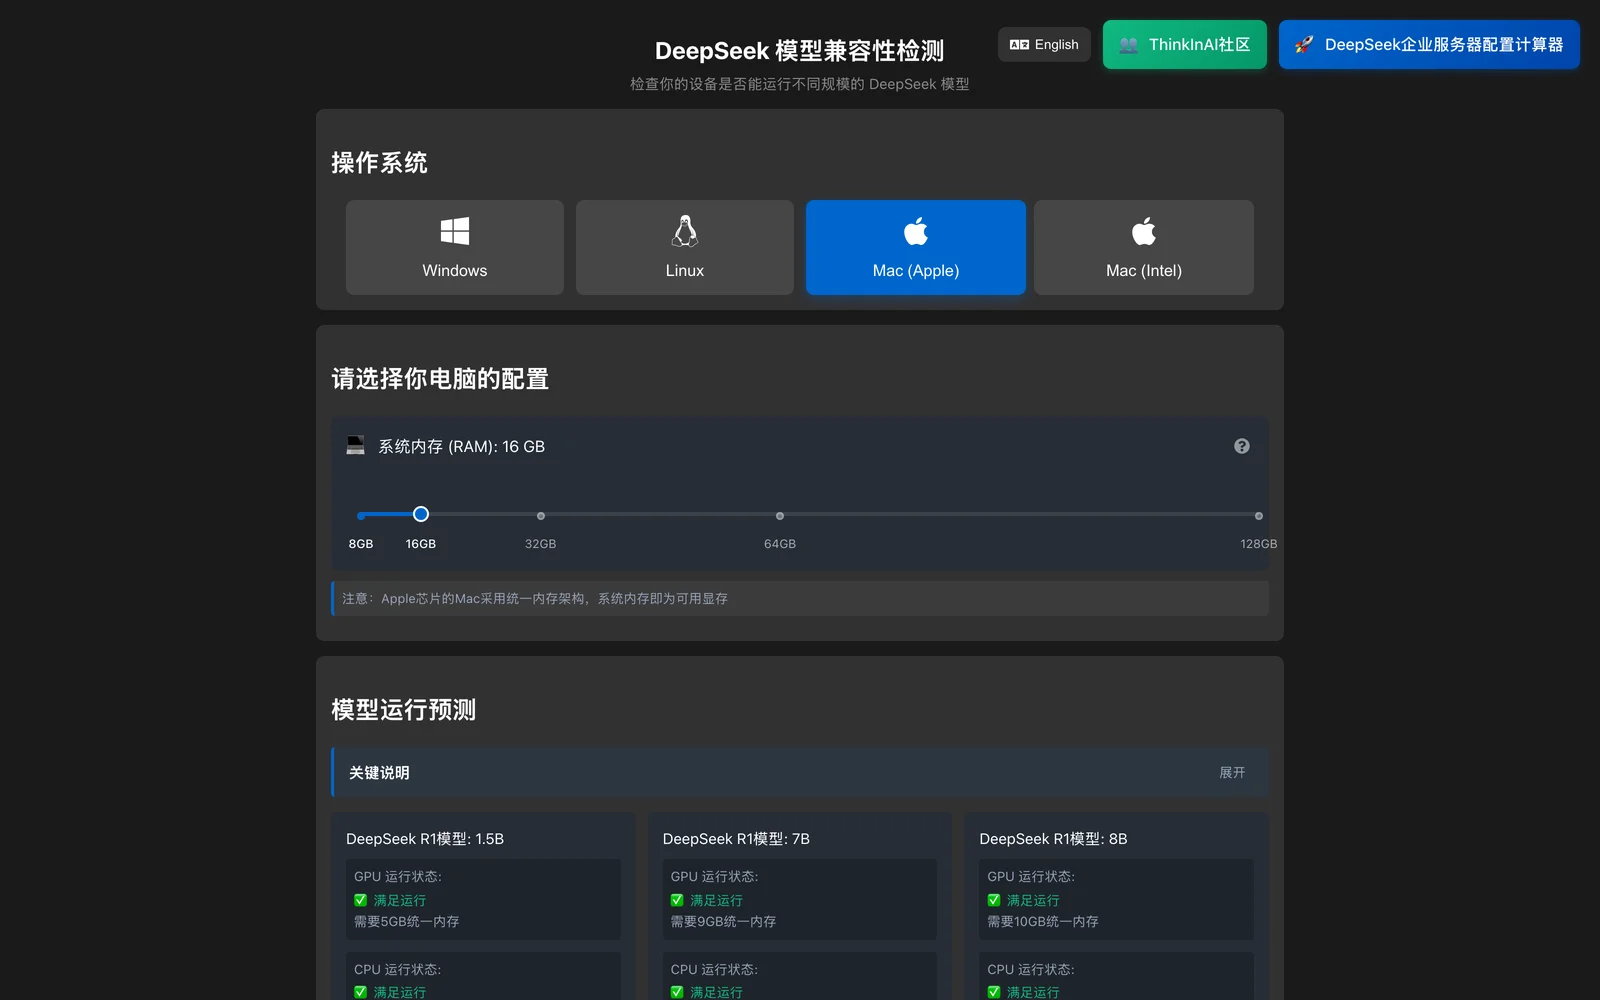
六個尺寸的完整門檻長這樣,16GB Apple 晶片 Mac 的判定放在最後一欄:
| 模型 | 下載大小 | 最低 VRAM | Apple 統一記憶體門檻 | 16GB Mac 判定 |
|---|---|---|---|---|
| DeepSeek R1 1.5B | 1.1GB | 3GB(GTX 1060 以上) | 5GB | 可跑 |
| DeepSeek R1 7B | 4.7GB | 6GB(GTX 1650 以上) | 9GB | 可跑 |
| DeepSeek R1 8B | 4.9GB | 8GB(GTX 1660 以上) | 10GB | 可跑 |
| DeepSeek R1 14B | 9.0GB | 12GB(RTX 3070 以上) | 16GB | 臨界可跑 |
| DeepSeek R1 32B | 20GB | 24GB(RTX 4090 等級) | 36GB | 被擋 |
| DeepSeek R1 70B | 43GB | 多卡(2 張 A100) | 75GB | 被擋 |
每張卡片還附上對應的下載指令,從 ollama run deepseek-r1:1.5b 到 ollama run deepseek-r1:70b,複製貼上就能裝,判定和指令是綁在一起的。
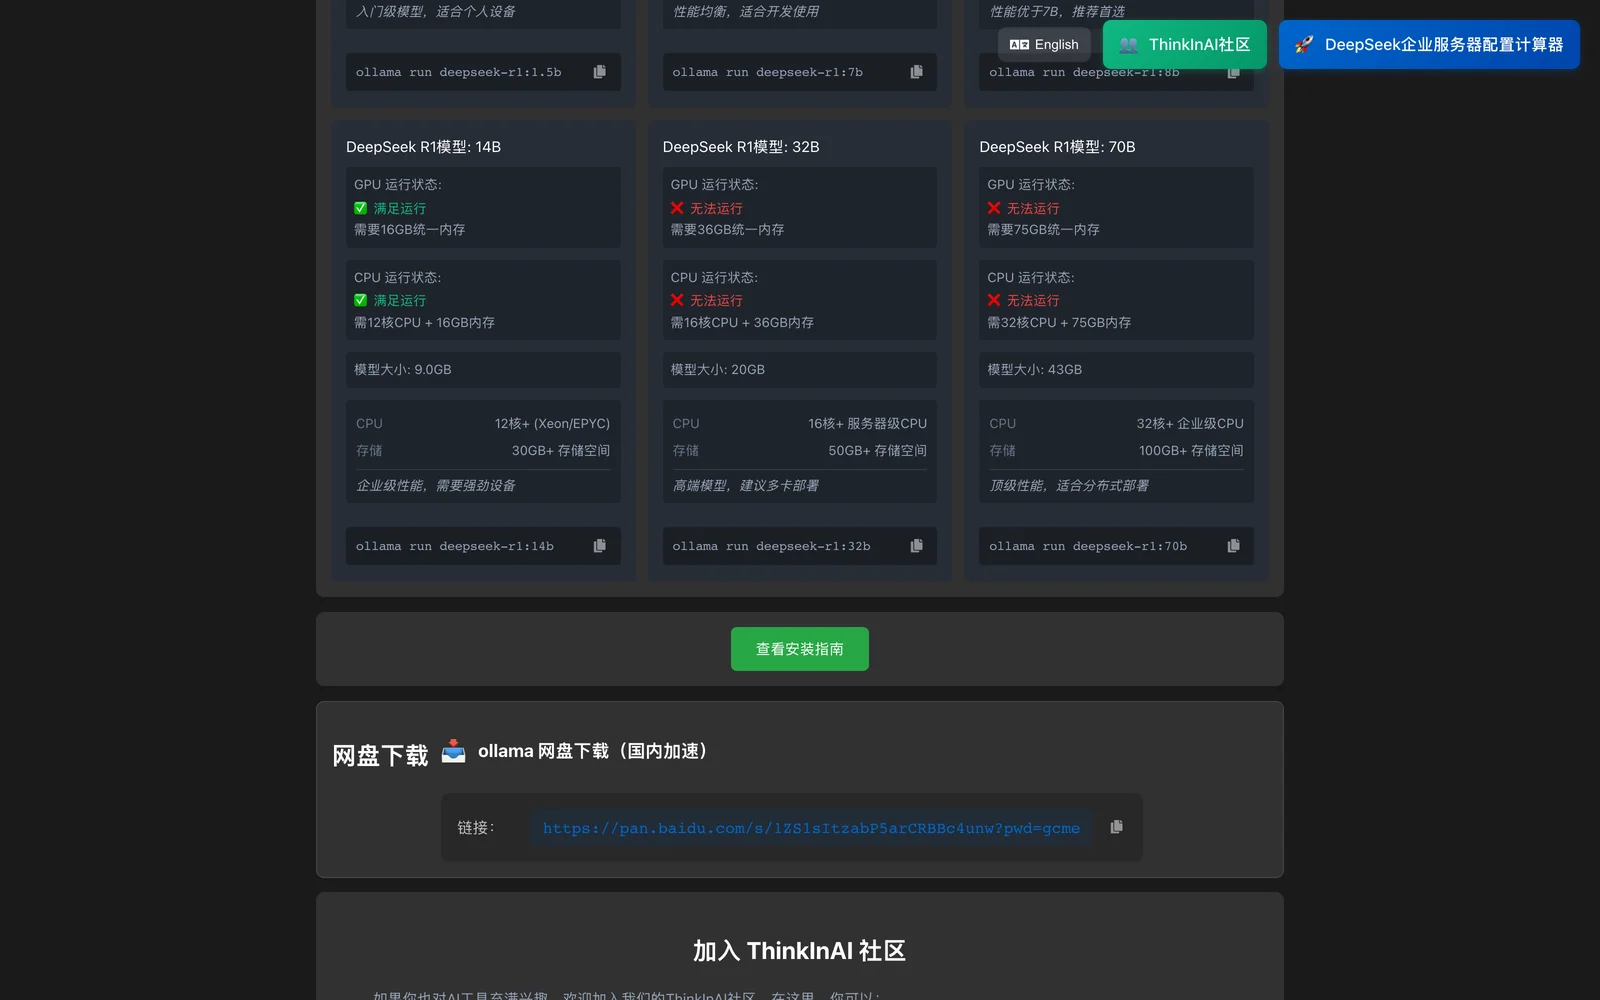
小型檢測工具最常見的毛病,是門檻憑感覺。這個工具大體不是:1.1、4.7、9.0、20、43GB 五個數字,與 Ollama 官方模型庫 deepseek-r1 的主標籤下載量一個都不差。第六個 8B 卡片寫 4.9GB,對應的是 Ollama 的 8b-llama-distill 標籤,這裡順手抓到一個小把柄:Ollama 在 2025 年 5 月把 8b 主標籤換成 5.2GB 的 Qwen3 蒸餾版,工具卡片停在改版前,沒有跟進。Ollama 同頁還列了一個 671b 標籤,下載量 404GB,就是原版的大小量級,個人偵測器沒放這個尺寸,理由很簡單:沒有個人的電腦裝得下。換句話說,它做的事接近把 Ollama 生態的實際大小整理成判定,而不是自己發明一套,只是整理的快照會過期。
頁面上攤開的換算邏輯也寫得清楚。VRAM 需求約等於參數量乘上精度位元組,再加激勵值(activation):7B 用 FP16 存放,大約 7 乘 2 等於 14GB;實際部署建議再多留兩成,所以頁面寫成 18GB 以上。精度位元組白話講就是每個參數用多少空間存:FP32 用 4 位元組、FP16 用 2、INT8 用 1、INT4 用 0.5,量化就是把參數壓縮存放的技術。頁面說 8-bit 量化讓 VRAM 減半、4-bit 再減半,代價是可能損失一到三個百分點的精度,而 Ollama 預設拉的就是 4-bit 模型。我對照過 Ollama 官方頁:7b 標籤下載量 4.7GB,正是量化後的權重大小,與頁面的說法方向一致。
這也解釋了門檻的立場:卡片的最低 VRAM 是照量化後的實際大小開的,說明文字裡的 FP16 公式是給你想懂原理用的。兩套數字並存,讀的時候別混在一起,拿 14GB 的 FP16 數字去嚇自己 8GB 顯示卡,是常見的誤讀。
順著同一套邏輯可以自己算安全邊際。8GB VRAM 對 8B 門檻 8GB,看起來剛好過,但模型載入後還要放上下文與系統狀態,實務上貼著線的組合都建議退一級:8GB 卡選 7B、16GB 統一記憶體的 Mac 把舒適線畫在 8B,都是同一個道理。工具給的是及格線,不是舒適線,這一級之差就是使用體驗的分界。
工具頁連安裝教學都備好了:Windows、macOS、Linux 三份 Ollama 安裝指南,Windows 部分註明需要 64 位元系統與 CUDA 11.7 以上,Mac 支援 Intel 與 Apple 晶片。對第一次碰本地模型的人,判定完直接照著裝,動線是通的。
多數人不知道、而這個工具頁面也不會主動告訴你的事:那六個小尺寸的 DeepSeek R1,沒有一個是 DeepSeek 自己的架構。
證據在工具的配置源檔裡。企業計算機每選一個模型,旁邊能展開該模型的完整架構參數,這份資料直接內建在前端程式碼中,頁面上也給了查看入口。打開看:1.5B、7B、14B、32B 的架構欄寫的是 Qwen2ForCausalLM,8B 與 70B 寫的是 LlamaForCausalLM。我拿這份清單和 HuggingFace 上 deepseek-ai 官方帳號的模型組態逐項對照,完全一致:R1-Distill-Qwen-1.5B、R1-Distill-Llama-8B、R1-Distill-Qwen-32B、R1-Distill-Llama-70B,四個模型全部在 2025 年 1 月 20 日、也就是 R1 發布當天上線。真正的 DeepSeek R1 本體在源檔裡也有,架構是 DeepseekV3ForCausalLM,256 個專家、每個 token 動用 8 個,詞表 129,280,這些參數和 HuggingFace 官方配置同樣對得上。
所以「DeepSeek R1 模型 7B」的正確讀法是:拿 Qwen 7B 當底,用 R1 產生的推理資料訓練出來的學生版。蒸餾這個詞可以用補習班的比喻理解:R1 這個老師把自己解題的過程一題題寫下來,讓小模型照著模仿,小模型學到的是解題的節奏與套路,腦容量仍然是自己的。它學的是 R1 的推理行為,能力和上限繼承自基底模型,與 671B 原版是不同的東西。蒸餾版表現接不接近原版,屬於模型研究的課題,這個工具沒有、也無法評測。但至少在「我下載的到底是什麼」這件事上,源檔給了誠實的答案,比多數介紹文章都直白。
順帶一提,工具卡片把 8B 標成優於 7B 的推薦首選,這句斷言要打折:7B 的底是 Qwen,8B 的底是 Llama,跨家族比誰強,本來就沒有理所當然的答案,兩者各有擅長的推理型態,選哪個更該看你的機器落在哪個門檻。另外源檔也顯示,六個小尺寸的上下文長度都是 128K,原版是 160K,規格是從配置直接讀出來的,行銷文案寫不出這些。
企業計算器是另一個頁面,參數多得多:模型尺寸(1.5B 到 671B 七檔)、量化精度(FP32、BF16、FP16、FP8、INT8、INT4)、序列長度(預設 2048,可到 128K)、批次大小(預設 4)、GPU 數量,外加個人開發、團隊協作、生產環境、研究開發四個情境預設,點一下整套帶入。選好模型,旁邊就展開架構明細:隱藏層維度、層數、注意力頭數、KV 頭數、FFN 擴展比、MoE 專家數,全部攤開。
我把模型選到 DeepSeek-R1-671B、精度 FP8,其他用預設值。畫面上出現的是一條攤開的加法:框架固定開銷 1GB,加上模型參數 671GB(671B 乘 FP8 每參數 1 位元組),加上激勵值 167.75GB(參數量的四分之一,站方對 32B 以上模型用的動態係數),加上輸出張量 0.99GB,合計 840.74GB。輸出張量那一項的公式也寫明白:批次大小乘序列長度乘詞表大小再除以 GPU 數量,一般情境下它是小頭,但長批次推理時會長大。推薦配置跟著出爐:至少 9 張 H800 SXM(94GB 版)、AMD EPYC 雙路 128 核、1536GB DDR5 記憶體、200Gbps InfiniBand、16TB NVMe,並附上一組 vLLM 部署命令,python -m vllm.entrypoints.openai.api_server --tensor-parallel-size 的並行度直接按你的 GPU 數算好,從 HuggingFace 下載權重的指令也一併附上。
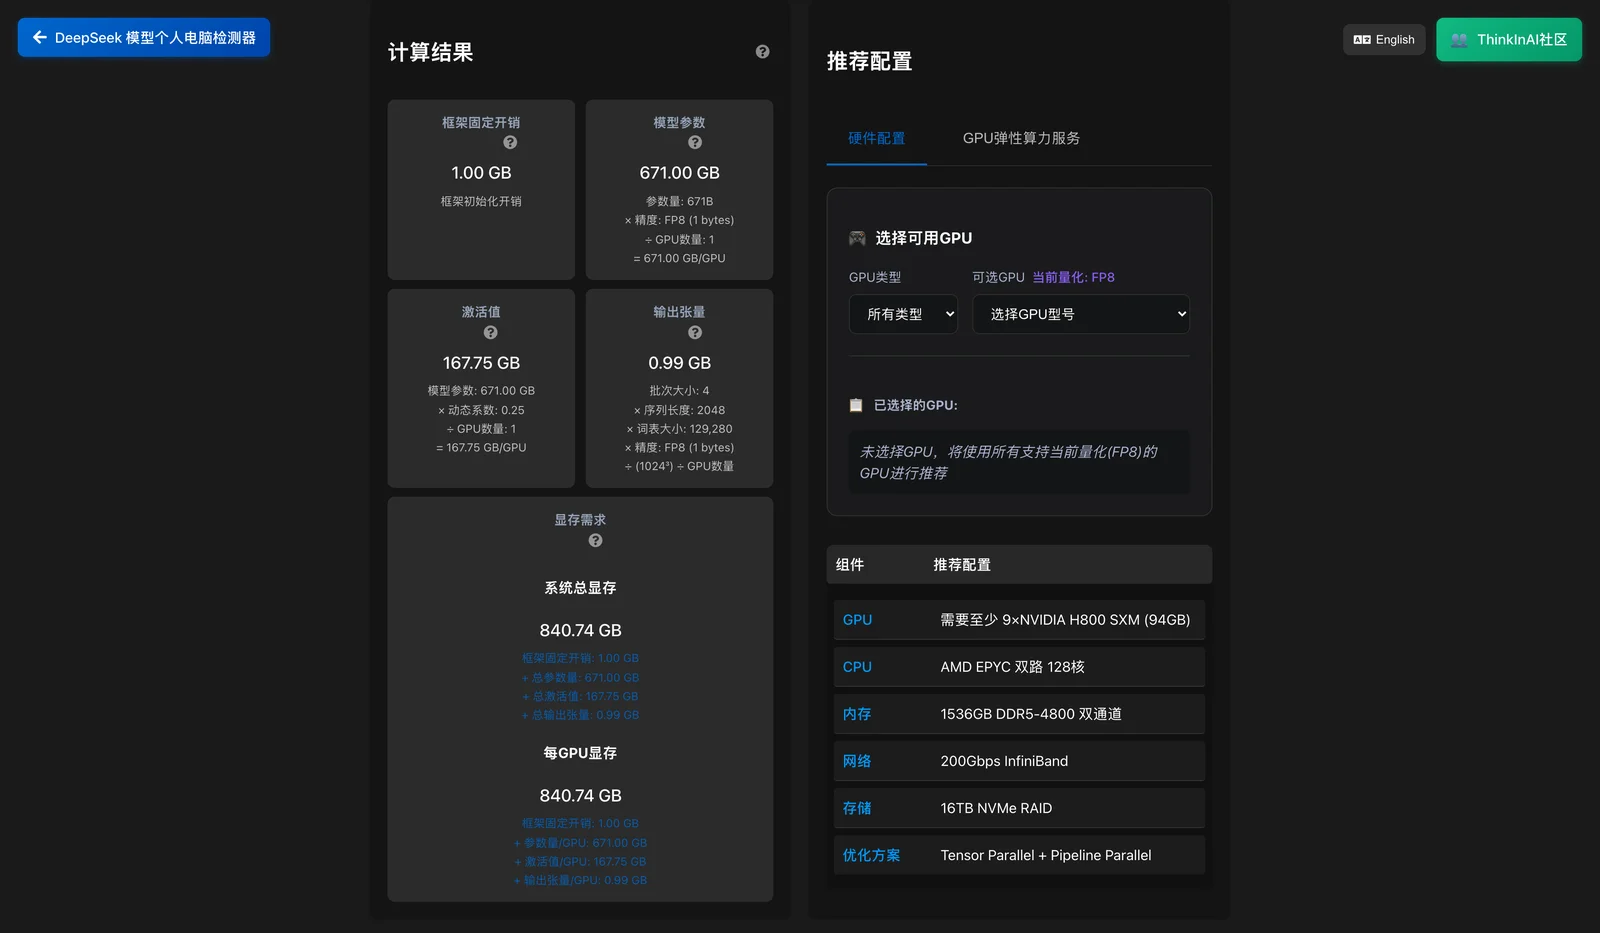
這個推薦有一個值得注意的地方。9 張 94GB 是 846GB,只比 840.74GB 的需求高百分之零點六;而工具自己的說明文字寫著,實際部署建議預留兩成冗餘。把兩成一乘,需求變成約 1009GB,需要 11 張 94GB 的卡才符合它自己給的建議。換句話說,推薦欄位沒有套用說明欄位的係數,照抄會把系統買在緊繃邊緣,沒有留故障與尖峰的餘裕。
固定係數本身也是簡化。激勵值用的是固定比例(7B 以下 0.1,往上逐級到 32B 以上 0.25),長上下文與多人同時使用的 KV cache 增長,只反映了輸出張量那一小項。如果你的情境是長文件分析或對外服務,把這台計算機當下限估算,再自行上調,會比直接信推薦配置穩。
GPU 清單則透露了它的目標市場:A800、H800 這些因出口管制而生的大陸市場規格,加上華為昇騰 910B,全部在列,還能按資料中心卡、專業卡、遊戲卡分類篩選。頁面設計上有個防呆值得肯定:手動選了過多的 GPU 時,它會提示目前配置的卡片數太多,改推薦性價比更高的組合。對台灣讀者來說,這份清單的用處是理解量級,採購時自然會換成自己拿得到的卡。
ThinkInAI 不是工具公司,是上海的 AI 開發者社群。主站辦的活動包括雙週的極客聚會、隔月的線上技術專題、每月的實體聚會,還有走進企業參訪、技術培訓與全球開發者技術峰會,頁尾掛著滬ICP備20019669號-4 的備案字樣。工具站本身沒有掛備案,也沒有任何條款或隱私頁面,這點對商用引用的人要留心:工具可自由使用,但權利義務沒有白紙黑字。
時間點也值得知道。thinkinai.xyz 網域在 2025 年 1 月中註冊,R1 在 1 月 20 日發布,據網際網路檔案館收錄紀錄,這個工具 2025 年 2 月中已經上線,上線頭一個多月連改了幾版,標準的熱潮期產物;拿 2026 年初的存檔和現在的頁面比仍有差異,站點至今也還能正常操作,不算棄坑。
免費工具的商業落點就長在頁面上。往下捲有三個入口:社群 QR code、用百度網盤分發的 Ollama 安裝包(對大陸下載加速),以及算力包服務,文案寫 1 度算力等於 312TFLOPS 乘 1 小時、相當於 A100 單卡一小時,支援 1 到 800 張 H100/H200 叢集按量計費,要掃碼加小助手洽談。檢測器引流、算力變現,路徑很直白,判定數字本身沒有因為這層商業結構而失真,這點我對照過官方資料。
隱私邊界倒是單純。整個計算在瀏覽器內完成,沒有帳號系統;我側錄了完整載入與操作過程的對外請求,唯一的外部服務是 Google Analytics(編號 G-679536ZX8V)與頁面素材,你填的硬體規格不會送往任何計算後端。GA 只知道有人來用工具,不知道你選了什麼配備。
核心數沒有被檢查。工具從頭到尾只問記憶體,卡片上那行 12 核 CPU 的需求是參考文字,真正驅動綠燈紅燈的是記憶體數字。拿 16GB 記憶體、只有 4 核的老機器去測,14B 的 CPU 判定照樣亮綠燈。老機器用戶要自己把關處理器,別讓綠燈替你決定。
速度沒有數字。判定只講能不能跑,不講跑多快;頁面雖有每秒 token 數的欄位設計,實際顯示是無資料。14B 靠 CPU 硬撐和 8B 靠顯示卡跑,體感差很大,判定看不出來,要有心理準備。
介面語言有中英切換,中文是簡體,沒有繁體選項。台灣讀者使用上沒有功能障礙,就是讀簡體介面,名詞也是大陸慣用說法,對照著看就好。
最後,門檻是靜態的。它不知道你背景還開著什麼、系統要吃多少,Apple 晶片 Mac 尤其如此,16GB 機器跑 14B 的臨界可跑,實際上是你和作業系統搶記憶體的局面,這正是站方一點五倍建議存在的原因,寧可保守半個檔位。
想在本機跑 R1 蒸餾版的人,直接用,把判定當下限:16GB 的 Apple 晶片 Mac 抓 8B 當舒適上限、14B 當可試;8GB VRAM 的顯示卡抓 7B 或 8B;24GB 等級才考慮 32B。下載安裝照卡片給的 ollama run deepseek-r1:7b 指令走,大小和工具顯示的一致;想拿 Llama 基底的 8B 版,要在 Ollama 標籤頁指名 8b-llama-distill 系列,直接拉 8b 會拿到後來換上的 Qwen3 版。模型跑起來之後,接下來的問題是管理:想讓模型變成日常工作流的一部分,可以看看把本地模型裝進桌面助理的做法,例如 AingDesk 這類把模型與知識庫搬進自己電腦的工具;想再進一步做成自動化代理,AgenticSeek 用顯卡換掉雲端月費的思路值得參考。
要把模型做成對外服務、或想估 671B 原版的人,計算機當顧問,不當採購單:它的分解公式透明,但推薦配置記得自己補兩成,長上下文與併發再另外上調。真的要評估這個量級,找雲端按量計費試跑一輪,比一次買齊九張卡便宜得多,這也正是頁面上算力包生意存在的理由,工具把量級算給你看,生意再接手。
只是想用 R1 的能力、不在乎模型在誰機器上的人,本地部署本來就不是唯一路線。API 按量付費是最輕的起步,桌面端有監控 Token 消耗的配套工具;連手機離線跑小模型都有人做了,Google 的 AI Edge Gallery 就是那個方向的嘗試。先想清楚你要的是擁有模型,還是使用模型,答案會差很遠。
一句話收尾:這個工具最好的用法,是把它當成把模糊問題變成具體數字的翻譯器。數字它給得起,最後那一成兩成的安全邊際,仍是你自己的判斷。