TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Overmind 在 X 公開 1,000 筆客服訊息微調 Qwen 3.5 0.8B 的完整示範,官方宣稱分類準確率從 36.7% 到 84.0%、23 分鐘完成。本文核對四則官方貼文、setup.md 安裝文件與 GitHub 授權,整理數字怎麼讀、保留測試怎麼設計,以及自架仍需 Modal 與 OpenRouter 的真實邊界。
用 AI 摘要這篇文章:
台北時間 10 月 27 日凌晨 1 點 45 分,開源訓練平台 Overmind 在 X 上連發三則貼文,配上一段 39 秒的示範影片,公開了一場完整的訓練示範:把一行指令貼進 Claude Code,讓 coding agent 自己讀文件、裝工具,用 1,000 筆客服訊息微調 Qwen 3.5 0.8B 這個八億參數的小模型,再和完全沒動過的原模型對照。官方宣稱分類準確率從 36.7% 提升到 84.0%,從啟動訓練到模型可用花了 23 分鐘。
同日下午 3 點 10 分的追蹤貼文補上關鍵細節:測試是在 300 筆模型沒見過的訊息上進行,成績約從 37% 到 84%。訓練資料來自 Hugging Face 上公開的 banking77 資料集,不是 Overmind 的私有資料,這代表任何人都能下載同一份資料、用同一個任務檢驗這套流程講不講得通。
值得帶走的並非那個 84%,而是這場示範攤開的驗證方法:任務範圍固定、訓練與測試資料分開、和原模型對照。想用自家資料微調模型的團隊,這三件事比任何單一數字都有用。這篇文章整理這場示範實際做了什麼、數字怎麼讀,以及開源授權與自架的真實邊界。
官方給的起點只有一行英文,貼進 Claude Code 就算開始:讀 console.overmindlab.ai/setup.md、完成 Overmind 設定,然後拿 1,000 筆客服訊息微調 Qwen 3.5 0.8B,在模型沒見過的訊息上和未動過的原模型比一比。背後的setup.md 是一份寫給 agent 看的安裝文件,開頭就聲明「這份文件是給你這個 AI coding agent 看的,人類把文件交給你,是要你動手做,不是要你講解給他聽」。
文件要求 agent 用 pip 安裝 overmind 套件(Python 3.10 以上,版本 0.1.106 起),執行 init 指令把工具接進四種開發環境之一:Claude、Codex、Cursor 或 OpenCode。入門分兩條路:有程式碼庫的團隊讓 agent 掃描自己的 agent 程式碼,找出 AI 被用在哪些環節;只有資料、沒有程式碼庫的團隊直接上傳資料集走微調。這次示範走的是第二條。裝好之後,agent 透過 MCP 工具操作整個平台:建立金鑰、列出專案、上傳資料集、跑評估、發起微調。網頁 Console、命令列 CLI、REST API、MCP 四個入口對應同一套流程,差別只在誰來操作:人用網頁、腳本用指令、agent 用 MCP。
那段 39 秒的示範影片分兩段。前半是終端機裡的代理對話實錄:輸入單一指令、挑模型、進訓練、部署、自動跑評估,中途代理還會停下來問要不要等分數出來再比較,人點頭才繼續。後半用一張方格圖收尾,標著 300 MESSAGES IT NEVER TRAINED ON,左邊 BEFORE 36.7%、右邊 AFTER 84.0%,再補上 23 min LAUNCH TO LIVE 與結尾的 /overmind finetune 指令。影片是產品展示,不是第三方驗收,但它把「一行指令到模型上線」中間每個該出現的環節都亮了出來,什麼環節是自動、什麼環節要人點頭,看影片就能對上。
官方文件裡有兩個設計值得停下來看。一個寫在 GitHub README 的 MCP 段:每個工具宣告自己的成本等級(free、compute、llm、gpu)與是否具有破壞性,agent 在發起呼叫前就看得出這一步會不會花錢、會不會刪東西,等於把成本與風險揭露做進了工具介面層。另一個寫在 setup.md:它明文要求訓練紀律:先按群組切分資料再擬合、先量基準成績、不要拿最終用途的資料做挑選。這幾條是防止訓練資料汙染測試成績的基本功,寫進 agent 的操作手冊,本身就是對「自動化訓練最容易在哪出錯」的一種回答。
訓練結束後,平台自動部署模型,但切換上線要走 set_active_model 並經過核可;換模型時平台產出程式碼修改建議,由人套用。憑證的處理也有類似的界線:文件要求金鑰由人在終端機輸入,不得貼進對話裡。全自動跑完訓練,花錢、上線與憑證這幾步把關的還是人。
訓練與測試用的資料來自 banking77,自然語言處理領域常用的公開基準資料集,內容是線上銀行的客服查詢,共 13,083 筆、標成 77 個意圖,語言是英文。資料集裡的例子長這樣:「I am still waiting on my card?」標成 card_arrival(卡片寄達)。Overmind 連的是 legacy-datasets 帳號下的舊版頁面,該頁現在標注建議改用 PolyAI/banking77。

任務本質是把訊息放進 77 個類別裡的正確一個。這種任務範圍固定、答案可核對,跟「寫一封回覆」「診斷問題」這類開放式工作不同,所以適合用保留測試資料驗證:拿模型沒見過的 300 筆訊息考它,答對幾筆一翻兩瞪眼。官方流程是訓練組 1,000 筆、測試組 300 筆,兩邊不重疊。
資料集頁的檢視器給了完整的規模對照:標準切分是一萬筆訓練、約三千筆測試,官方示範只各取其中一小部分,訓練用的 1,000 筆連標準訓練集的一成都不到。這個安排本身有資訊量:它展示的是「少量資料就能把固定任務的模型拉起來」這條路,不是把整個資料集吃乾抹淨的重訓。資料集採 CC BY 4.0 授權、源自 2020 年的一篇論文,想驗證的團隊可以直接下載,切自己的 1,000 筆訓練與 300 筆測試,看自己跑出的數字和宣稱差多遠。
這次微調的基礎模型 Qwen3.5-0.8B 是阿里 Qwen 團隊官方釋出的開放權重模型,在 Hugging Face 累積超過 374 萬次下載。它不是 Overmind 的產品,Overmind 做的是把資料整理、評估、微調、部署串成一條流程的平台。分清這兩層,授權與成本才會算得準。
36.7% 到 84.0%,先分清楚這是增加 47.3 個百分點,換算相對增幅約 2.29 倍。行銷文案寫「提升 47%」或「準確率翻倍」都不算算錯,但量感差很多,引用時把兩個原始數字一起放上最保險。
300 筆的測試樣本不大。84% 換算下來,300 筆裡仍有約 48 筆分錯,差不多每六筆一筆。77 個意圖裡哪些類別被分錯、錯的後果多嚴重,貼文沒有給分類別成績,而這恰恰是判斷能不能上線時最該問的問題。這個資料集裡光是 card_arrival(卡片寄達)一個類別就有十幾種問法,等卡片、問追蹤、怕寄丟全算同類;類別之間的界線越細,分錯的代價就越看情境,把需要急件處理的訊息分到一般詢問,成本跟反過來不同。評估時把每個類別的錯誤分開看,才知道 84% 的品質落在哪裡。
36.7% 這個基準值得順便看。77 類的任務亂猜約 1.3%,36.7% 遠高於亂猜,代表微調前的 0.8B 模型已經有一定分類能力(這句是從數字推的,貼文沒有交代基準怎麼量)。微調帶來的改善,合理的理解是把這份特定資料的分類規則學進模型權重,而非模型忽然變聰明。
23 分鐘是官方量的流程時間,從啟動到模型上線。那是這一場示範的數字,不含你整理資料、定義答案、清理標注的時間。而且整組數字都來自產品方自己的單一案例,外部目前沒有重現紀錄,示範訓練出來的模型也沒有發布:Overmind 在 Hugging Face 的組織底下只有 2 月上傳的另一個模型 nerpa。要用這組數字,把它當「流程可行性證據」比當「效能保證」穩妥。
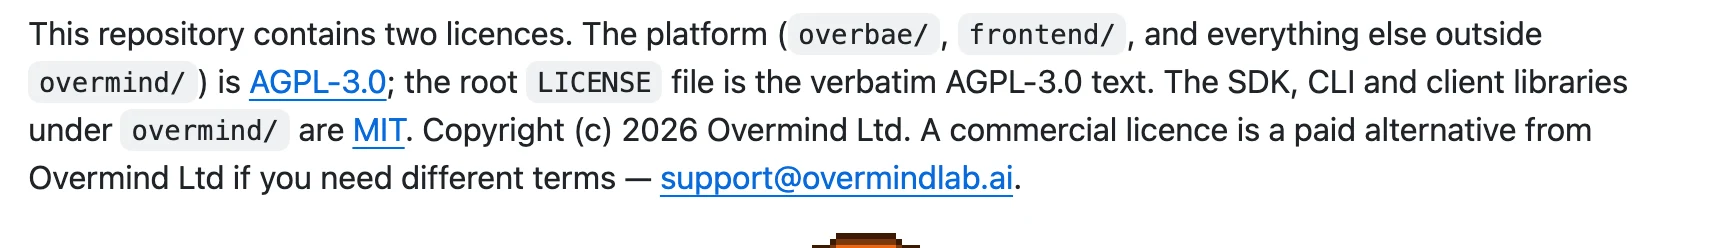
平台程式碼在 GitHub 上的 overmind-core/overmind(725 顆星,10 月 29 日仍有推送),授權分兩層:平台本體採 AGPL-3.0,pip 安裝的 SDK、CLI 與客戶端函式庫採 MIT,README 的授權段寫明需要不同條款時可向 Overmind 購買商業授權。所以把整套平台講成「MIT 開源」是讀錯,講成「全部 AGPL」也不對,基礎模型 Qwen 的授權又是另一份文件。AGPL 的網路條款對把平台包進自己對外服務的團隊有額外的原始碼公開義務,這也是那份商業授權存在的理由,公司要在內部採用前值得讓法務看過這一段。
自架方面,README 提供 docker compose 一次啟動整套服務:資料庫、API、Console 介面、工作佇列、監控面板。但依賴表列得很誠實:評估與評分要 OpenRouter 的 API 金鑰,訓練與推論跑在 Modal,微調檢查點存 AWS S3,抓 gated 基礎模型要 Hugging Face token。換句話說,自架省的是平台軟體的授權費,訓練與推論的運算帳單照樣要付給雲端服務商,「開源」在這裡不等於「零雲端、零費用」。
費用數字官方目前沒有給。官網導覽列掛著 Pricing,截至 10 月 30 日頁面仍顯示 Page not found。這條路比自己養 GPU 便宜多少、訓練一次實際多少錢,現在沒有可核對的價目,商業評估只能先掛著。
官網另有一句主打的宣稱:「你可以持有權重,選擇讓 Overmind 託管或自己跑」。這講的是權重歸屬與部署選項存在,實際的匯出、搬遷與維運體驗如何,要等有團隊公開第一手紀錄。同頁的 Zero third-party training 行銷句,講的是你的資料不會被拿去訓練公共基礎模型,跟自架與資料流向是兩件事,讀的時候別混在一起。

最該看的族群:已經有穩定的重複性分類工作,而且手上累積了一批「輸入與正確答案成對」的歷史資料的團隊。客服路由、工單分類、垃圾訊息判斷都算。對這些團隊,官方示範就是一個可以直接照抄的驗證模板:切出一批不參與訓練的測試資料,量原模型的基準,微調,同一批資料再考一次,進步幅度夠才談下一步。同樣以「用自家累積資料微調小模型」為賣點的還有開源工具 WeClone,思路同源,方向是個人聊天紀錄。
還在「連什麼算答對都沒定義」階段的團隊,先別急著微調。資料裡若藏著錯誤標注,模型會照單全收,把舊錯誤學得更牢;把更多資料堆進去,也不會自動變好。台灣讀者若處理的是中文客服訊息,還要留意示範用的是英文資料集,自己資料的量與分布不同,成績不能直接類比。
也有整條路不適用的情境。答案會隨時間漂移的任務(促銷活動期間的訊息樣態和平常不同)、類別每季都在改的 taxonomy、或輸出要整段文字而非單一標籤的工作,微調小模型都不會是第一選項,先回到提示詞工程與工作流設計反而務實;若要的是「在幾個固定選項裡挑一個」的判斷,把選項機率判斷搬進本機的 Drex 決策模型走的則是另一條不需要微調的路。另一頭,已經有遙測基礎的團隊可以看平台提供的另一條路:setup.md 裡的 create_dataset_from_traces 指令把 agent 執行紀錄直接轉成資料集,等於把平常就在累積的工作紀錄變成訓練素材,這比從零標注省力,但資料品質的把關責任也跟著回到自己身上。
第一步的門檻很低:把 setup.md 那行指令貼給手上的 coding agent,四種主流環境都在支援清單,或直接 pip install overmind。心態上把它當「跑一輪對照實驗」的起點,而不是「一鍵變準」的按鈕。實驗設計上有兩個自保動作:保留測試集只用一次,看完錯誤就收起來,別每調一輪就拿同一批題目重考,否則高分會慢慢變成背題;換模型前保存舊版本與同一組輸入的結果,新模型上線後先接一小段真實流量對照,輸出不對就切回來。實驗跑完,你會拿到自己資料上的兩個數字,那比任何示範影片都更能回答「要不要繼續」。
幾件事官方貼文與文件都沒有交代:訓練的超參數與輪數、84% 的分類別成績、示範模型會不會公開、正式價目表,以及英文以外資料上的表現。儲存庫本身活躍,這些缺口補上的速度值得觀察。文中數字與頁面狀態截至 2026 年 10 月 30 日。