TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

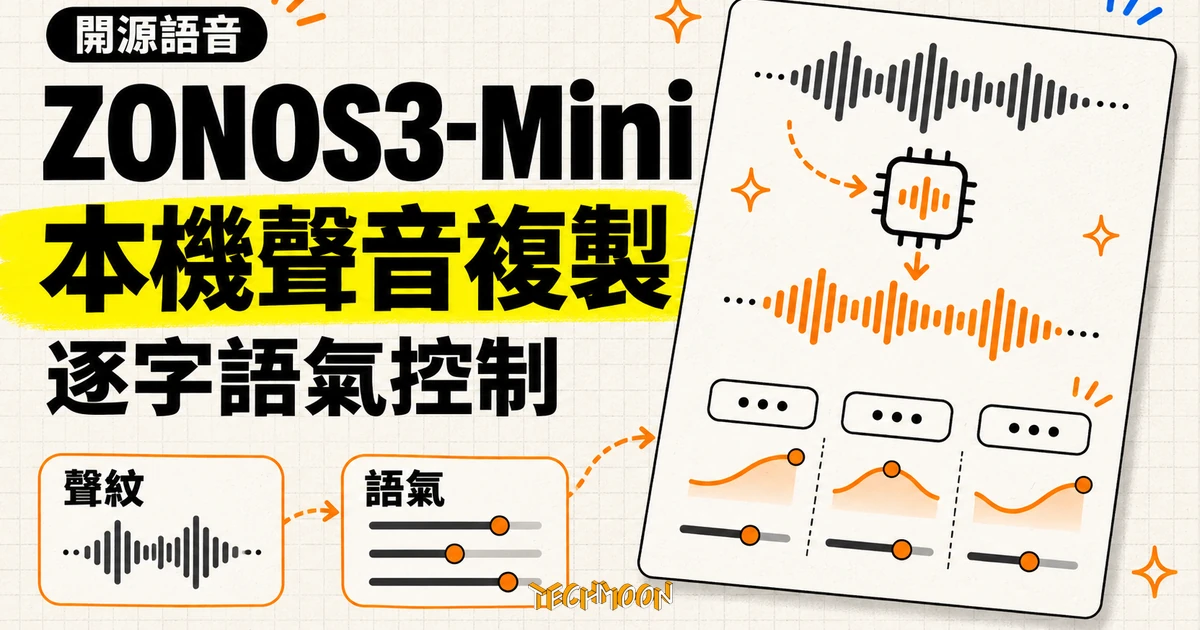
Zyphra 於 11 月 9 日開源 ZONOS3-Mini 語音模型,權重採 Apache 2.0、程式碼 MIT,約 1 億啟用參數就能在瀏覽器與手機本機複製聲音,支援華語在內 43 種語言,並提供逐字語氣控制與語音編輯模型。本文對照官方公告、模型卡與技術報告,拆解兩種延遲口徑、自建指數排名的範圍與授權角落。
用 AI 摘要這篇文章:
Zyphra 在 2026 年 11 月 9 日把新一代語音模型 ZONOS3-Mini 的權重、執行程式碼與瀏覽器版本一次開放,11 月 12 日再於 arXiv 補上技術報告。變動本體一句話:一個每個 token 只啟用約 1 億參數的文字轉語音模型,能零樣本複製聲音、逐字調整語氣,官方宣稱從幾年前的手機到資料中心 GPU 都跑得動。權重採 Apache 2.0 授權、程式碼採 MIT,華語列在 43 種支援語言清單裡。
對需要旁白、配音或語音助理的人,這次釋出值得花二十分鐘弄清楚三件事:數字怎麼讀,官方兩份文件的首音延遲寫法並不一致;排名怎麼解,開源第一名的頭銜只存在於官方自建的綜合指數;授權有哪三個角落,語音編輯模型與發音詞典其實不在公開 repo。以下把官方公告、Hugging Face 模型卡與技術報告三份文件對齊攤開。
ZONOS3-Mini 的定位要對著上一代看才清楚。這個系列從 2025 年 2 月的 Zonos v0.1 beta 起家,ZONOS2 在 2026 年 6 月發表時走 8B 參數,而且卡在 Descript Audio Codec 每秒 86 格的音訊表示上,官方公告自己承認這限制了部署範圍。ZONOS3-Mini 換掉兩件事:模型縮小為技術報告寫的 886M 總參數,每 token 約 1 億啟用(官方部落格與模型卡概略寫 800M,引用時建議註明出處口徑);音訊表示換成自家的 ZAC-1 編碼器,把 44.1 kHz 的聲音壓成每秒 15 格、10 本密碼本的離散表示,位元率 1.80 kbit/s。生成一段聲音要反覆跑的次數變少,這是它塞得進瀏覽器的根本原因。
架構細節模型卡寫得很完整:11 層、模型維度 1,024、64 個潛在專家的混合專家結構(每 token 取前 2 名)、上下文 32,768 個位置;序列混合是 9 層 Gated DeltaNet 搭 2 層全域注意力。混合專家的意思是權重全部要放進記憶體,但每次運算只動用其中一小部分,所以「1 億啟用」不能直接換算成下載體積。訓練用了 112 張 H100、2.5 天,語料 6.1M 小時(公開與私有混合)、375k 步、4.5T 個 token,訓練後再接 DPO 與 GRPO 兩階段強化。ZAC-1 的效果官方只給了自家說法:同樣資料約束下,用 ZAC-1 訓練的模型字錯率是 DAC 版的十分之一;和 Fish 的 S1-DAC、MOSS 音訊 tokenizer v2 相比,是更好的壓縮率下表現相當、相近壓縮率下略好。這些都是發布方自己跑的對照,沒有第三方重測。
與 ZONOS2 的前後差異,論文給出了交換條件:直接餵參考音檔的路徑,聲音相似度 69.8 高於 ZONOS2 的 68.8,但 macro 字錯率 6.70 略差於 ZONOS2 的 6.22。用九分之一的參數換到更高的聲音相似度,代價是字錯率小幅讓步。截至撰稿,模型卡顯示 19,743 次下載與 345 個讚,發表六天的成績。
官方同時在公告頁提供對照試聽:同一段文字讓 Fish Audio、Qwen、Cartesia、ElevenLabs 與 OmniVoice 各念一次,官方在頁面上的立場很直接,語音模型最好的評估方式就是聽。範例稿子刻意選了迷因改寫的旁白稿,從科幻小說式的紀律獨白,到脫口秀演員連珠炮式的段子都有,想自己聽的人可以直接到公告的 Model Comparisons 段落播放。
這是整份發布裡最值得放慢看的地方。同樣講「瀏覽器裡發出第一個聲音要多久」,官方部落格寫 Pixel 9 低於 570 毫秒、M3 MacBook Air 低於 150 毫秒;三天後的技術報告寫的卻是低於 800 毫秒與 450 毫秒。兩份都是官方自己出版的文件,數字差了四成與三倍,官方沒有解釋量測條件差在哪裡。要引數字只能二選一,引部落格就標部落格,引報告就標報告,不要混著寫成「官方數字」。
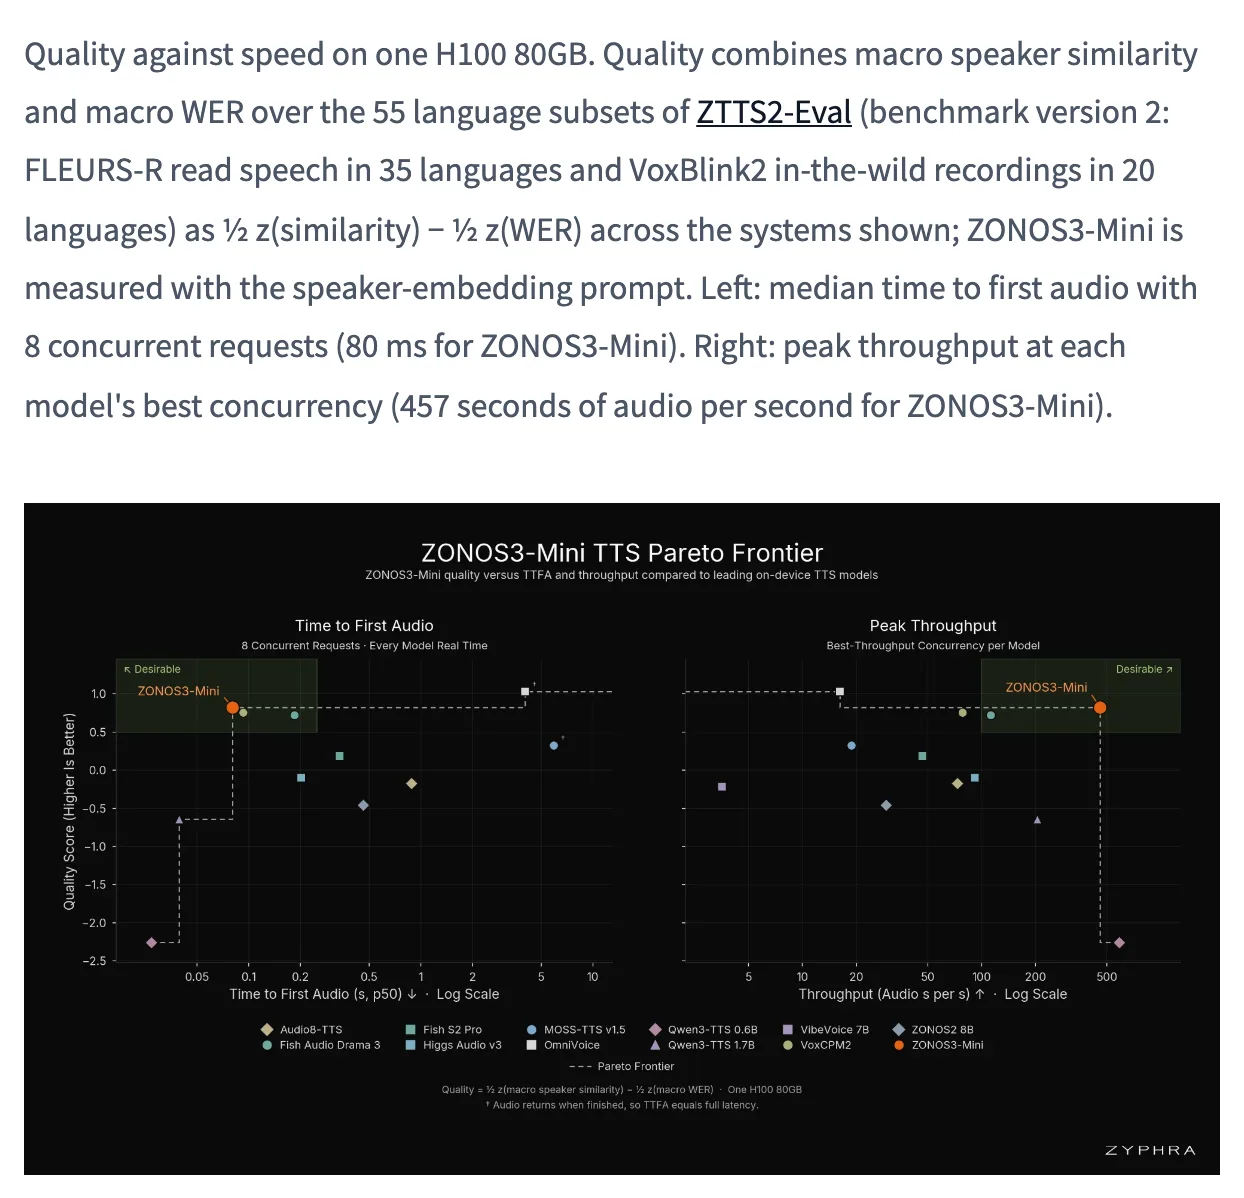
伺服器端的數字反而整齊。模型卡評測圖的圖說寫明:H100 80GB 上 8 個併發請求的中位首音 80 毫秒,最佳併發的尖峰吞吐是每秒產生 457 秒音訊。技術報告再補上量化檔的表現,從 Q8_0(1.03 GB)到 4-bit QAT 專家(0.66 GB),H100 單一串流每秒解碼約 20 秒音訊,純 CPU 每秒 129 到 160 格。讀吞吐數字有個前提:那是多請求共享的產能指標,457 秒每秒不代表你的一段話會以 457 倍速完成。另一個容易混淆的點是三種等待講的是不同的事:首音延遲是多久開始聽到聲音,整段完成時間是多久拿到完整檔案,吞吐是伺服器同時消化多少工作。做離線配音的人該看第二種,做即時語音助理的人第一種才是生死線,把三個數字混在一句話裡比較沒有意義。
執行路徑則是一整排:瀏覽器 WebGPU、伺服器 SGLang 與 vLLM、Apple 晶片 MLX、C++/ggml(CPU、CUDA、Metal、Vulkan 都行),另外有離線 Python API;四種伺服器共用同一套 HTTP 介面。下載體積要分開看:GPU 伺服器的 PyTorch 權重官方 README 寫約 9 GB(含預設解碼器,repo 裡完整資料夾更大);瀏覽器版用的是另外打包的 web 分片,整包約 5.7 GB,第一次開啟時下載、之後留在快取,不必重抓;ggml 與 MLX 用的 GGUF 檔案散裝在 9.9 GB 的資料夾裡按需挑選,不過單靠一個檔跑不起來,論文寫的 Q8_0 1.03 GB 到 4-bit 0.66 GB 指的是主幹的量化大小,實際部署還要再抓解碼器與說話者編碼器等檔案。27 個依語言分組的預設聲音放在 gguf 資料夾,單次生成最長 10 分鐘音訊。
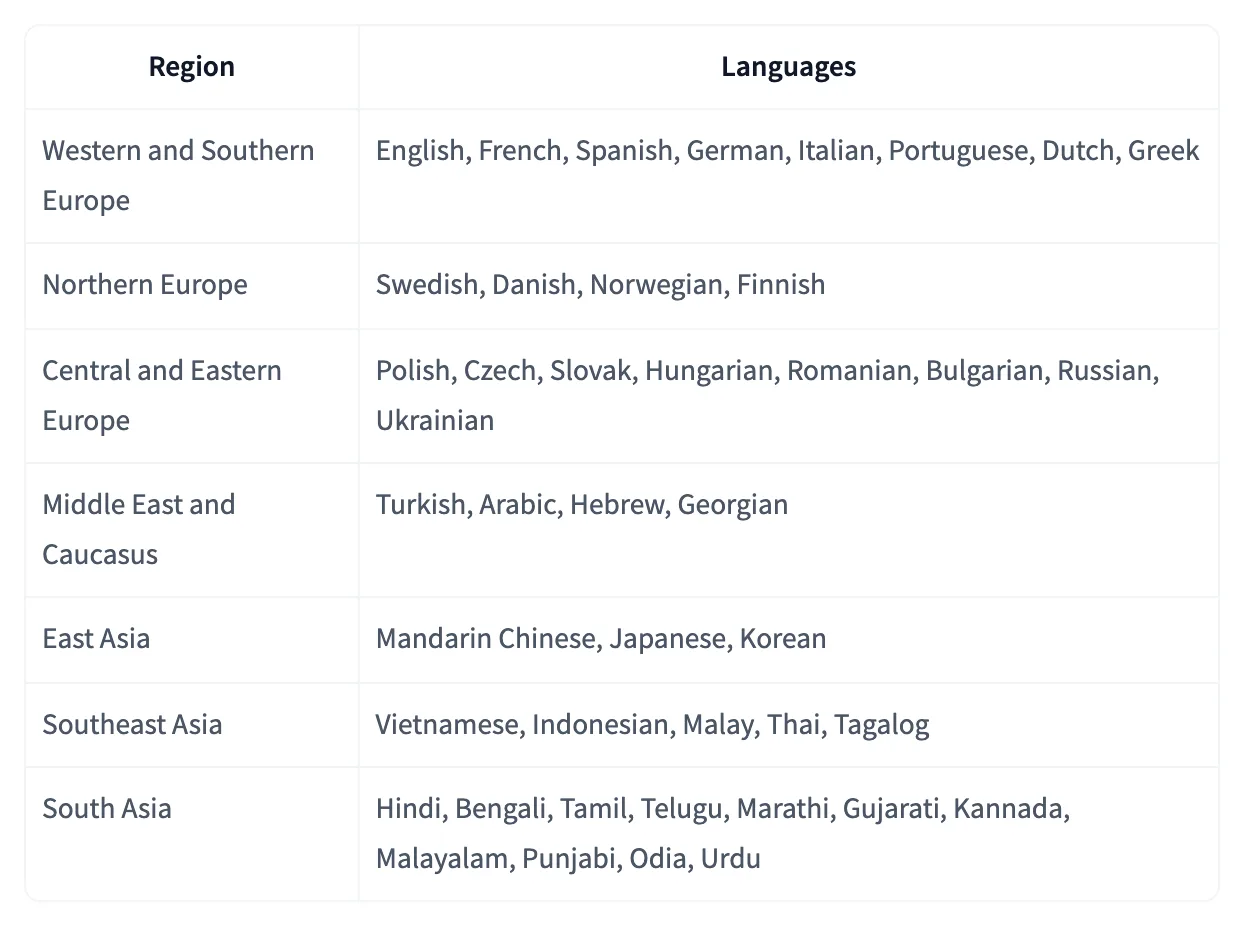
模型卡以地區表列 43 種語言,東亞組是華語、日語、韓語。文字正規化採 NeMo,只覆蓋英、華、日、韓、德、西、法、義、葡九種,其餘語言照字面通過。把「支援華語」直接讀成「台灣口音與專有名詞過關」是兩回事:官方文件沒有提供任何在地口音的驗收資料,多音字、人名、地名的實際表現得自己試。
對中文旁白有需求的人,可以對照先前介紹過的兩條路:走雲端的 Gemini 3.8 Flash TTS 已經把配音當成可逐句下導演指令的工作;走本機的 Ollama 語音生成 目前只有英法德西葡五種語言、中文不在列。ZONOS3-Mini 補上了「本機念中文」這一格的開源選項,但這是清單意義上的補上,不是品質意義上的保證。
零樣本聲音複製的意思,是給一段參考聲音就能合成相近音色,不必為每個說話者重訓模型。ZONOS3-Mini 提供兩種聲音條件:把參考剪輯(最長 60 秒)直接編進模型上下文,或先用 MECT-B2 模型轉成 192 維的說話者嵌入。官方公告明講兩者的取捨:剪輯路徑從預訓練就開始練、聽感較自然,但不會逐字複製韻律;嵌入路徑是預訓練後短暫微調的產物,對聲音的控制較好掌握。
語氣控制走 activation steering,在模型內部表示加上方向向量,六個軸是情緒價值、激發程度、支配感、音量、速度、清晰度,另外有年齡感、性別表現、口音、質地等聲音設計項,多個方向可以疊加。官方的選角示範就是疊加出來的:同一位參考旁白,調成年輕的澳洲口音女性、中年的美國口音男性、年長的英國口音女性三個角色,各是不同控制項的組合。官方控制範例把界線寫得很白:這些是生成目標不是量測值,速度調整會連動音高與音量,年齡設定不等於驗證過的歲數,柔和質地只是近似氣聲、沒有專用的氣聲控制項。
逐字控制有兩條獨立的路。串流生成時,靠學出來的對齊注意力頭(官方稱 LACI)對指定詞語施加 steer,例如只把一句話的開頭改成耳語,官方示範的參數是 whisper +4。生成後另有按 VoiceCraft 配方訓練的編輯模型,在既有音檔裡直接改句子,同樣吃得到前述控制;它是在預訓練完的檢查點上用遮蓋片段填充再訓 10k 步的產物,剪輯沒附文字稿時可以靠選配的 Qwen3-ASR 先轉出逐字稿。對旁白工作流的實際影響是編輯性的:改一句話從「重念整段」變成「局部替換」,前提是編輯模型在你的語言與音檔長度上夠穩,這點官方只給了食譜、沒給邊界報告。
評測要分兩層讀。ZTTS2-Eval 是 Zyphra 自家的基準:乾淨朗讀集覆蓋 35 種語言、真實環境集 20 種,合計 74,041 條語句,ZONOS3-Mini 繳出 6.71% 的 macro 字錯率。公告裡「開源模型排名第一,後面是 Fish S2 Pro 與 MOSS TTS v1.5」這句話,講的是官方用試題反應理論把 420 個「指標乘資料集乘語言」項目建模出來的綜合能力指數,全部樣本與互動介面都放在 ZTTS2-Eval 網站。
單項指標是另一回事,而且論文自己就寫了。全部受測系統中最低字錯率是 Fish Audio Drama 3 的 4.74%,那是一個 35B 總參數、3B 啟用的模型,接著是 ZONOS2 的 6.22% 與 OmniVoice 的 6.62%,ZONOS3-Mini 的 6.70 到 6.71% 排在其後;macro 相似度也只有 VoxCPM2 與 OmniVoice 兩家高於它。還有一個影響公平性的細節:論文讓每個系統都跑全部語言,而 Qwen3-TTS 與 CosyVoice 3 官方支援的語言較少,分數會被拖累,比較時要記得這層條件。對上閉源系統的德英西中四語言子集裡,ElevenLabs v4 的 clone 模式字錯率 2.07% 最低,Cartesia Sonic 3.6 的相似度 85.0 最高,ZONOS3-Mini 以 embedding 條件繳出 2.55% 與 83.1%,真實環境相似度 77.5 反而是該表最高。合併起來的解讀:不是誰碾壓誰,而是在 1 億啟用參數的量級把差距縮到個位數,綜合排名的功勞要記在指數的加權方式上。
權重 Apache 2.0、GitHub 程式碼 MIT、論文內文 CC BY-SA 4.0,主幹可以商用。角落一:語音編輯的 LoRA 在 SGLang 這條伺服器路徑要從私有 repo 取得,公開使用者是走 GGUF 檔拿到同一功能,功能等價、零件來源不同;角落二:黃金發音詞典同樣在私有 repo,公開路徑的音素猜測靠選配的 espeak-ng,它是 GPL-3.0 授權、不安裝就不會被帶進你的專案;角落三:強制對齊用的 FuseAlign 本身是 Apache-2.0,但 1.34 GB 的檢查點要另行下載,選配的語音辨識是 Qwen3-ASR-1.7B,一樣是額外元件。
聲音素材的授權與說話者同意,不會因為模型開放而自動取得。技術報告沒有浮水印、濫用防護或資料同意的專章,6.1M 小時的訓練語料只標了公開與私有混合;參考聲音能不能用於對外內容,同意範圍要自己把關。同樣做本機聲音複製的 VoiceStudio 開源配音工作台 先前面對的是同一組問題,可以對照。
想聽看看的人成本最低:官方的 Zonos Voice Studio 與 Lite 頁在瀏覽器裡跑 WebGPU,首次下載後留在快取,不必安裝任何東西,需要支援 WebGPU 的瀏覽器。Lite 頁可以挑預設聲音、上傳參考音檔、直接錄一段,或載入聲音嵌入檔來用。試的時候有一個值得抄官方的習慣:控制範例頁的每組示範都用同一句文字、固定隨機種子,一次只動一個控制項,A、B、C 三版直接對照。自己驗收時比照辦理,固定文字與種子,先聽中性設定的完整性(數字、地名、人名有沒有被吞掉),再逐項加速度與情緒,音色走音時才知道是哪個控制造成的。
要做成產品的人:伺服器走 SGLang,提供 OpenAI 相容的 /v1/audio/speech 端點、串流輸出,參考剪輯不必附文字稿;Mac 走 MLX;不想碰 Python 的環境走 C++/ggml。已經用雲端語音 API 而且沒有隱私或成本壓力的人,這次釋出不改變你的現狀,等第三方數字再說。對中文旁白有硬需求的人,先別遷移工作流,拿自己的短稿試生成,對照既有做法的成果再決定。
未確認的事項就讓它維持未確認:台灣口音與實際硬體的延遲沒有第三方數字,兩組首音口徑的成因官方沒有說明,編輯模型在長音檔上的穩定度沒有報告。這篇文章的保存期限,大約到社群實測與後續版本出現為止,屆時延遲數字、排名與編輯功能都應該重查一遍。