TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

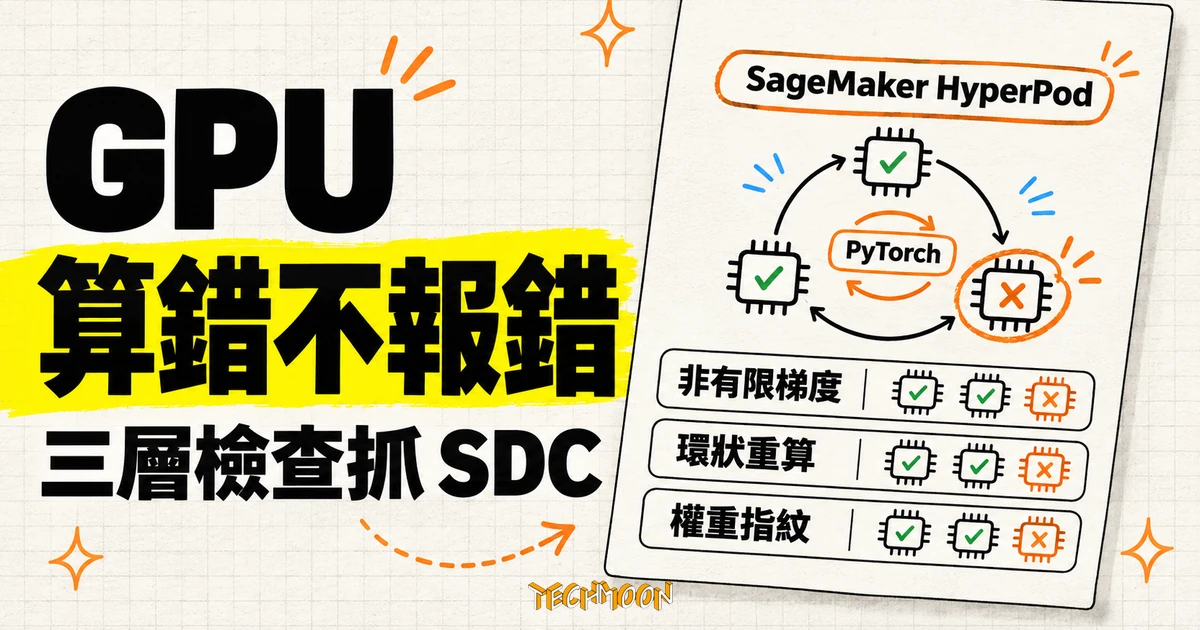
AWS 於 2026 年 11 月 11 日在 Machine Learning Blog 公開 SageMaker HyperPod 的無聲資料損壞(SDC)偵測方案,配套程式碼更早已在 10 月 26 日合入 awslabs 開源儲存庫:三層檢查放進 PyTorch DDP 訓練迴圈,每步的 NaN/Inf 梯度檢查、跨節點環狀重算稽核、更新後的權重指紋比對,搭配定位、隔離與檢查點回滾。官方量測的效能代價落在 +7.4% 到 +34.7%,範例並自曝兩個漏抓案例;前提是三節點、DDP 與共享儲存。
用 AI 摘要這篇文章:
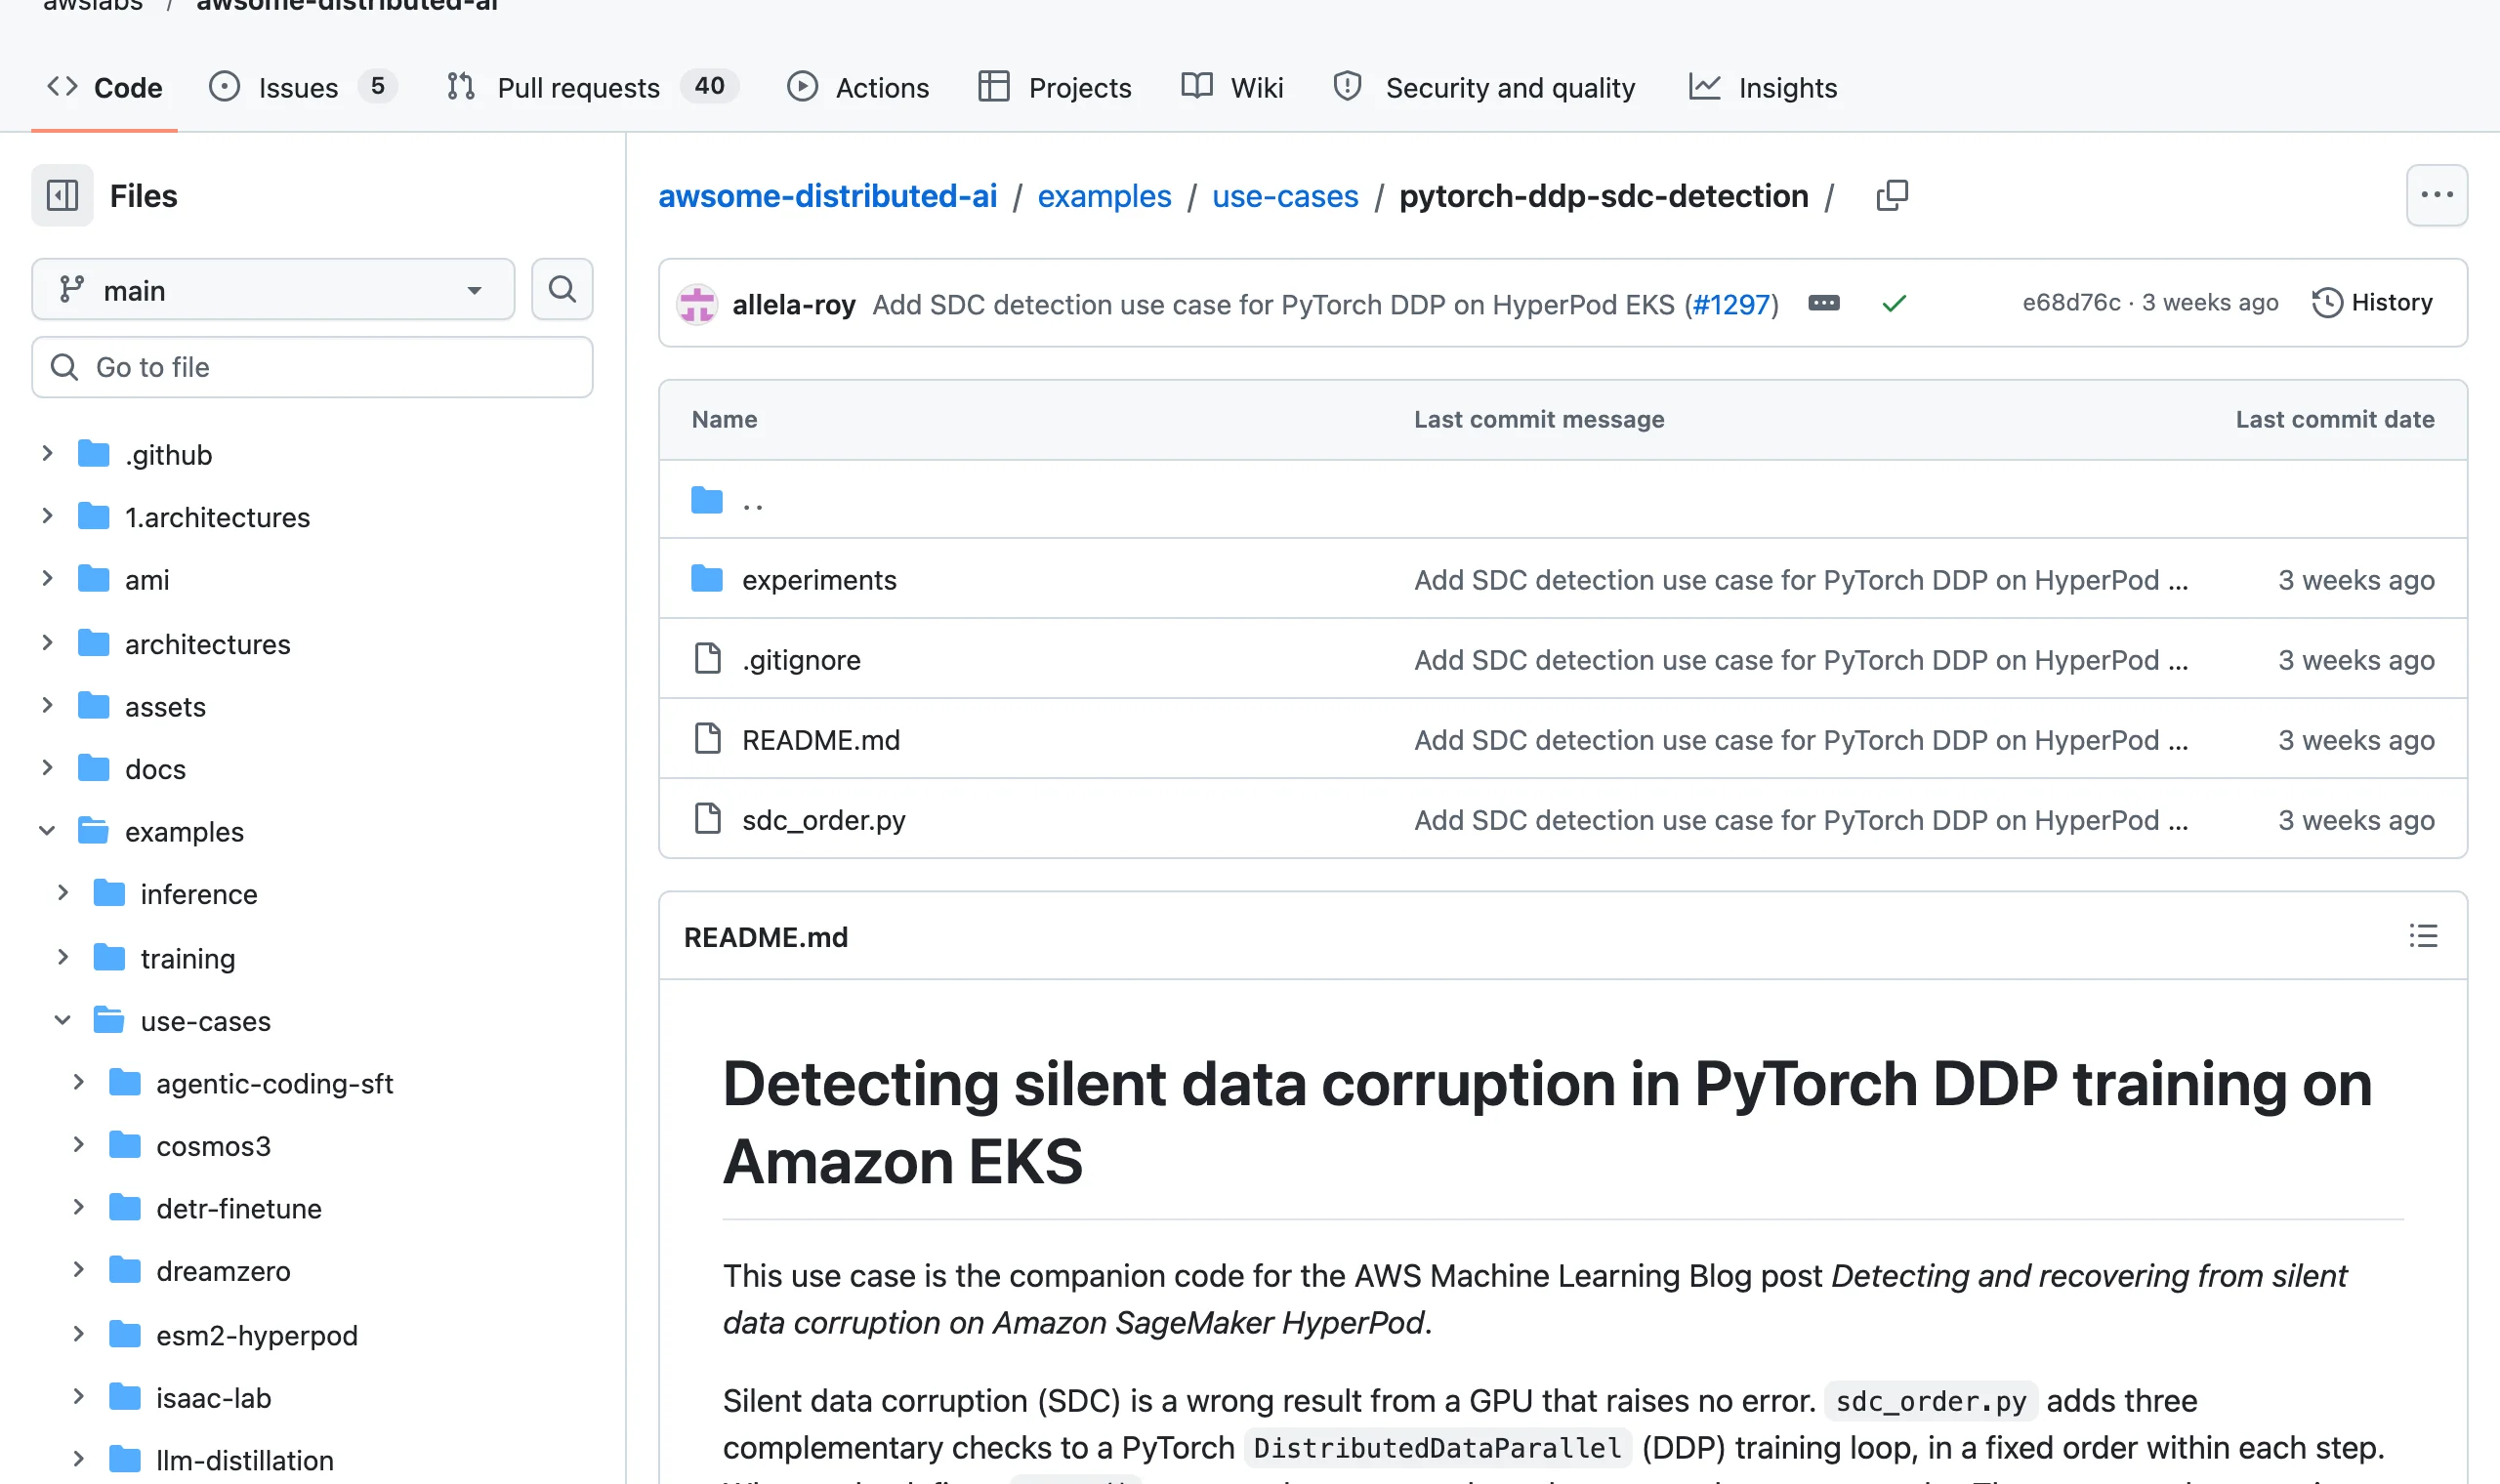
AWS 在 2026 年 11 月 11 日於 Machine Learning Blog 發表〈Detecting and recovering from silent data corruption on Amazon SageMaker HyperPod〉,其配套範例程式碼已先在 2026 年 10 月 26 日合入 awslabs 的 awsome-distributed-ai 儲存庫(PR #1297),文章發表時已公開逾兩週。一句話講清楚這次變動:一份把無聲資料損壞(silent data corruption,SDC)偵測放進 PyTorch 分散式訓練迴圈的參考實作,附上 32 張 H100 上的效能代價量測,以及十餘種軟體注入故障的偵測結果。它不是 HyperPod 的新平台開關;訓練團隊要把檢查程式碼整合進自己的訓練腳本,才有效果。
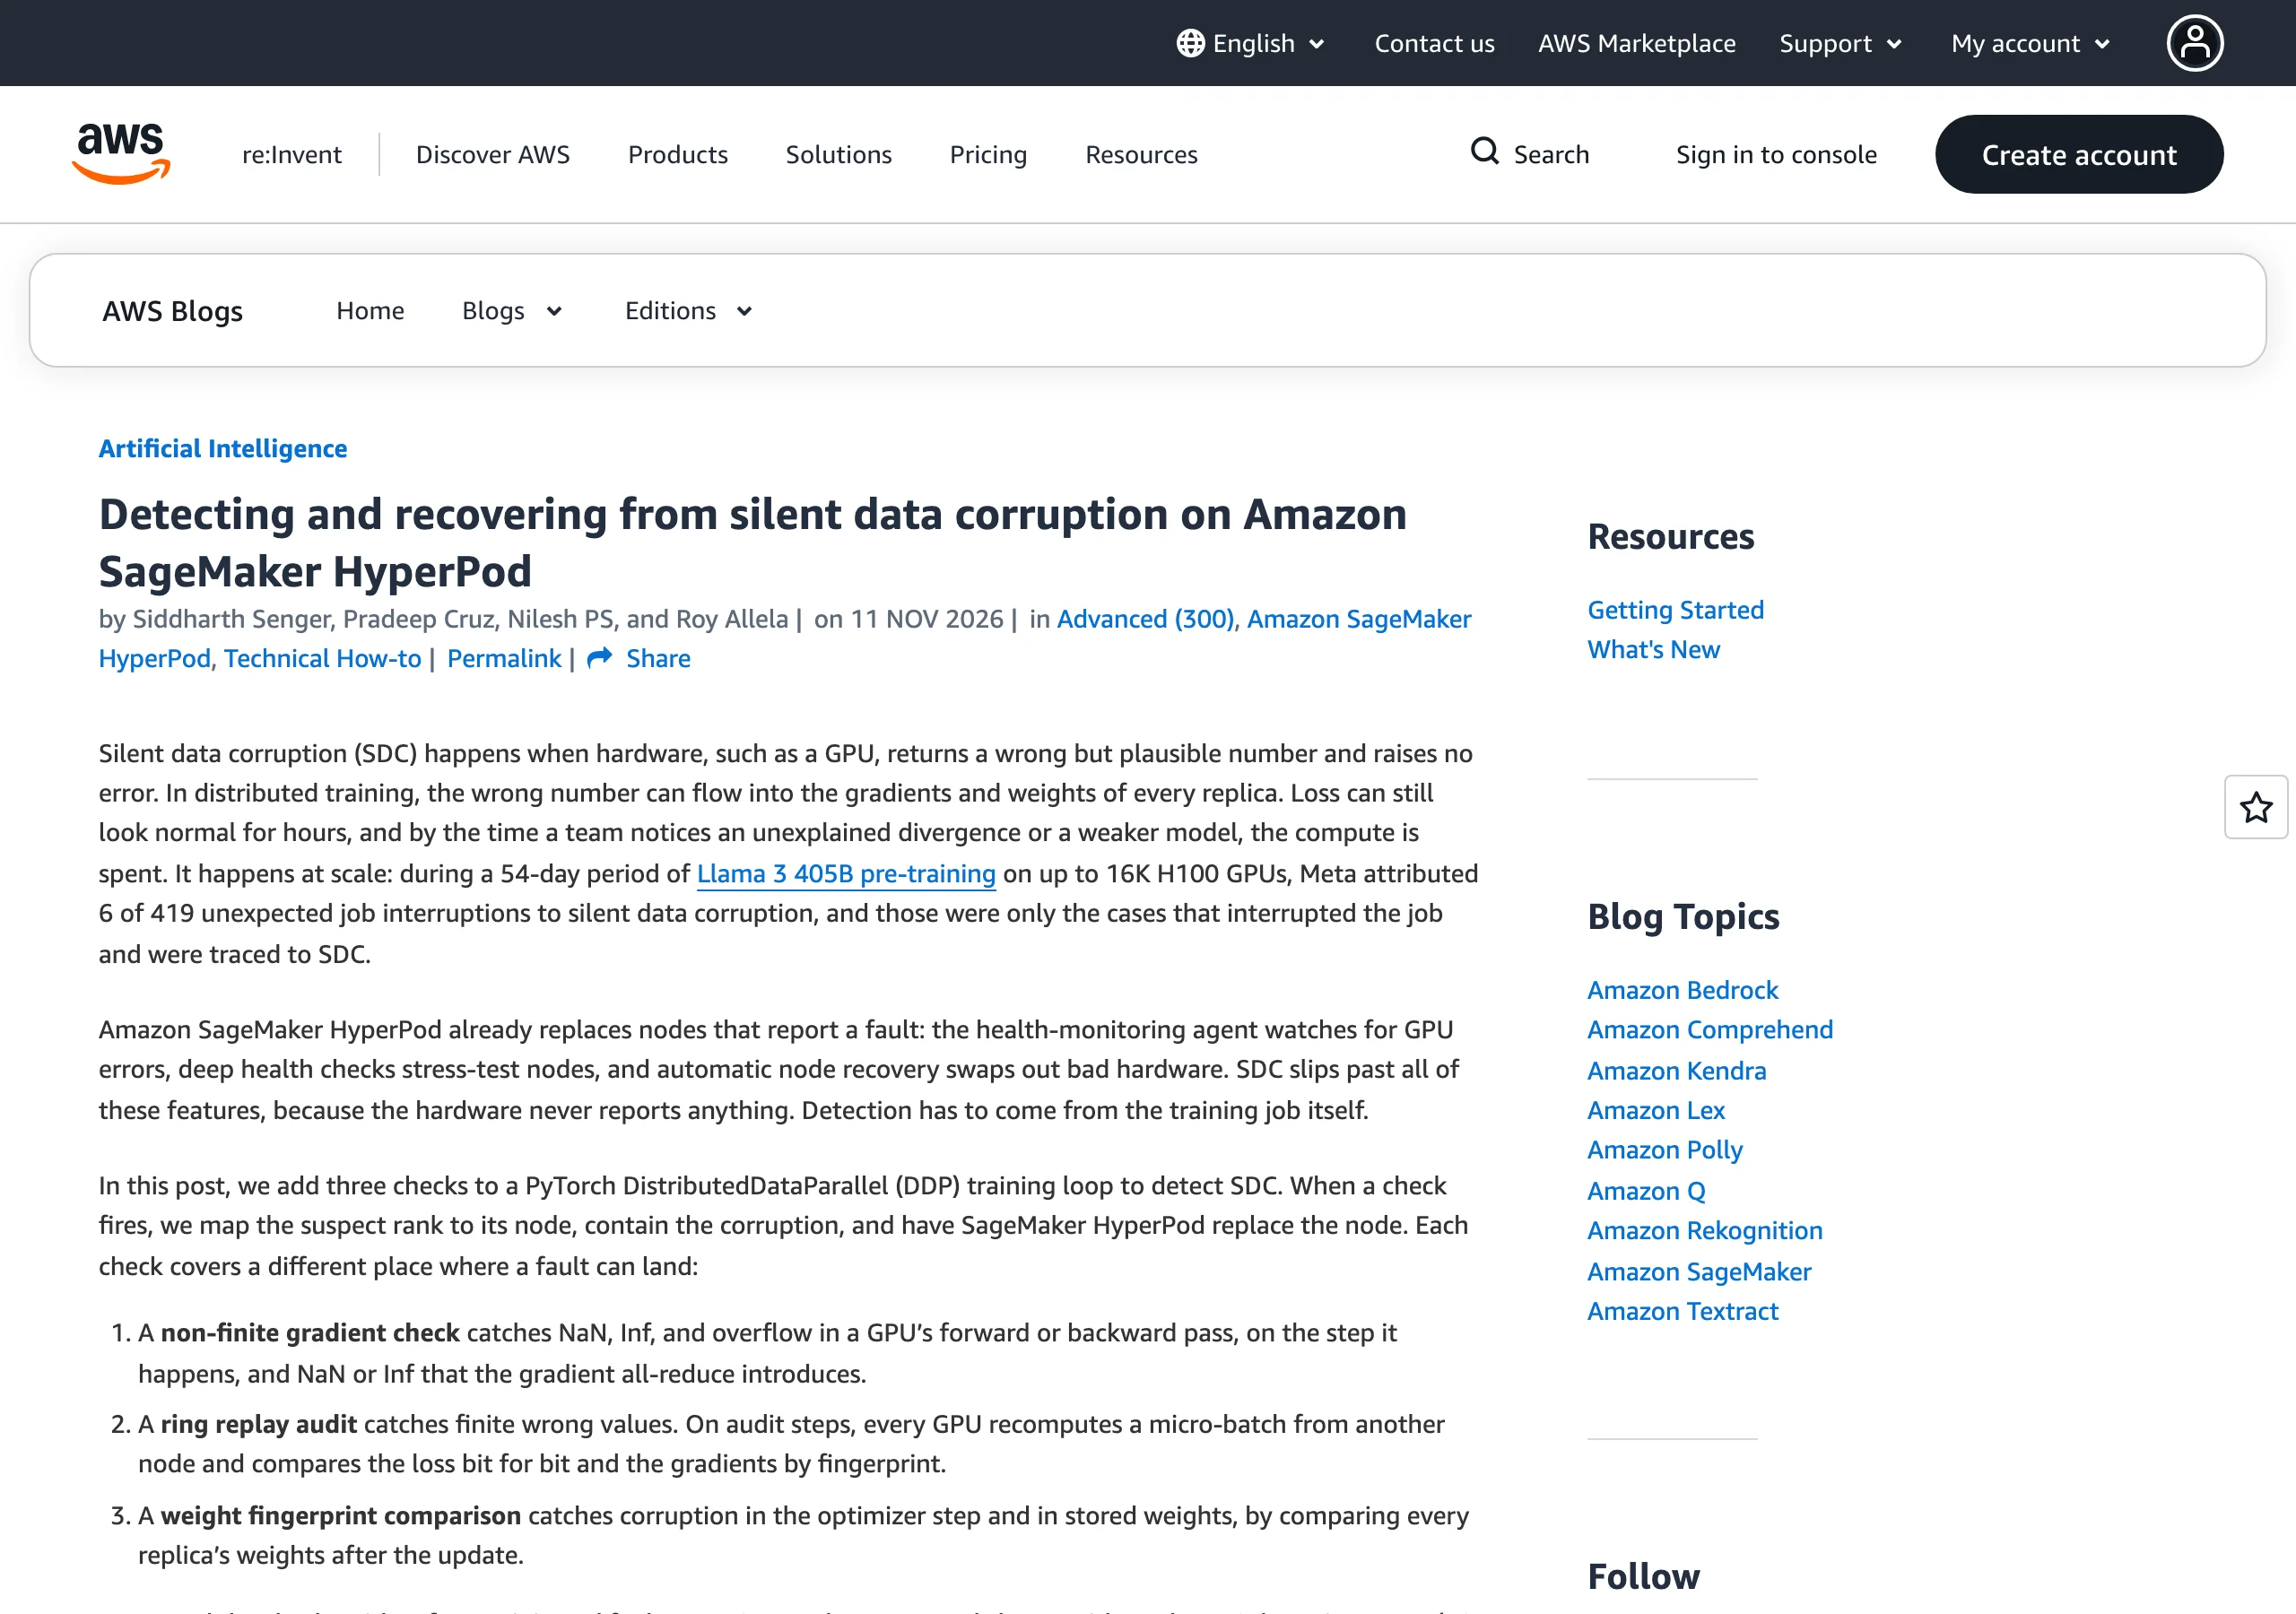
適用範圍值得先核對。這份範例針對以 Amazon EKS 協調的 SageMaker HyperPod 叢集、至少 3 個 GPU 節點、採用 PyTorch DistributedDataParallel(DDP,資料平行訓練)的工作;儲存庫 README 補充,其實任何 EKS GPU 叢集都能跑這套程式碼。反過來說,用 FSDP 或 ZeRO 做權重分片的訓練、少於三個節點的叢集、純推論服務,都不在這份範例的涵蓋範圍內。已經在跑大規模訓練的團隊可以對照 MaxText 的長序列訓練或 PyTorch 多 GPU 通訊後端的升級時程思考自己的位置。
無聲資料損壞指的是 GPU 回傳一個看起來合理的錯誤數字,而且不舉報任何錯誤。AWS 在文章中解釋成因:製造缺陷或矽老化通常落在 tensor core 的乘加電路上,這條電路多數時候算得對,只在高溫、電壓下降或特定運算元組合下算錯;算術路徑沒有 ECC 錯誤修正(記憶體有,運算結果沒有),於是 4.0001 被當成 4.0000 用,錯誤沿著梯度和權重擴散到每個訓練副本。損失函數可以看起來正常好幾個小時,等發現模型莫名變弱時,運算時間已經花掉了。
HyperPod 原本就會替換舉報故障的節點:健康監控代理盯 GPU 錯誤、深度健康檢查對節點做壓力測試、自動節點恢復換掉壞硬體。問題在於 SDC 從不舉報,而 AWS 在文章裡把既有檢查一條條對上去,說明它們守的都是別的邊界:ECC 守記憶體、不守運算;Xid 錯誤要 GPU 自己發現故障才會出現;DCGM 深度健康檢查在閒置節點上跑,碰不到你工作負載才會用到的運算元、熱狀態與時序;NVLink、PCIe、EFA 的檢查碼驗證位元組送達時沒變,不驗證算得對不對;檢查點檢查碼驗證儲存往返,一份被汙染但內部一致的檢查點照樣通過。結論是偵測必須來自訓練工作本身,檢查運算結果。
這件事在最大規模的訓練裡有實證。Meta 的 Llama 3 405B 預訓練報告記錄了 54 天期間、最多 16K 張 H100 上的 419 次意外中斷,其中歸因於無聲資料損壞的有 6 次(佔 1.4%);AWS 特別提醒,這只計入有造成中斷而且被追溯到 SDC 的案例,安靜漂過的汙染不會出現在這個數字裡。SDC 不是最大宗的中斷源(GPU 相關問題合計佔 58.7%),但它有個惡劣性質:其他故障會停下來叫人,它不會。
DDP 訓練裡,每個副本拿不同的資料切片算梯度,all-reduce(跨副本聚合平均)之後每個副本套用同一份平均梯度。錯誤落在哪個階段,決定哪種檢查看得見它:如果某副本在向前或反向傳播算出一個有限但錯誤的梯度,all-reduce 會把錯誤平均給所有副本,更新後大家的權重仍然一致,互相比權重抓不到;如果錯誤發生在優化器更新或儲存階段,某個副本的權重就會與別人不同。AWS 因此把三層檢查放進每個訓練步的固定順序裡。
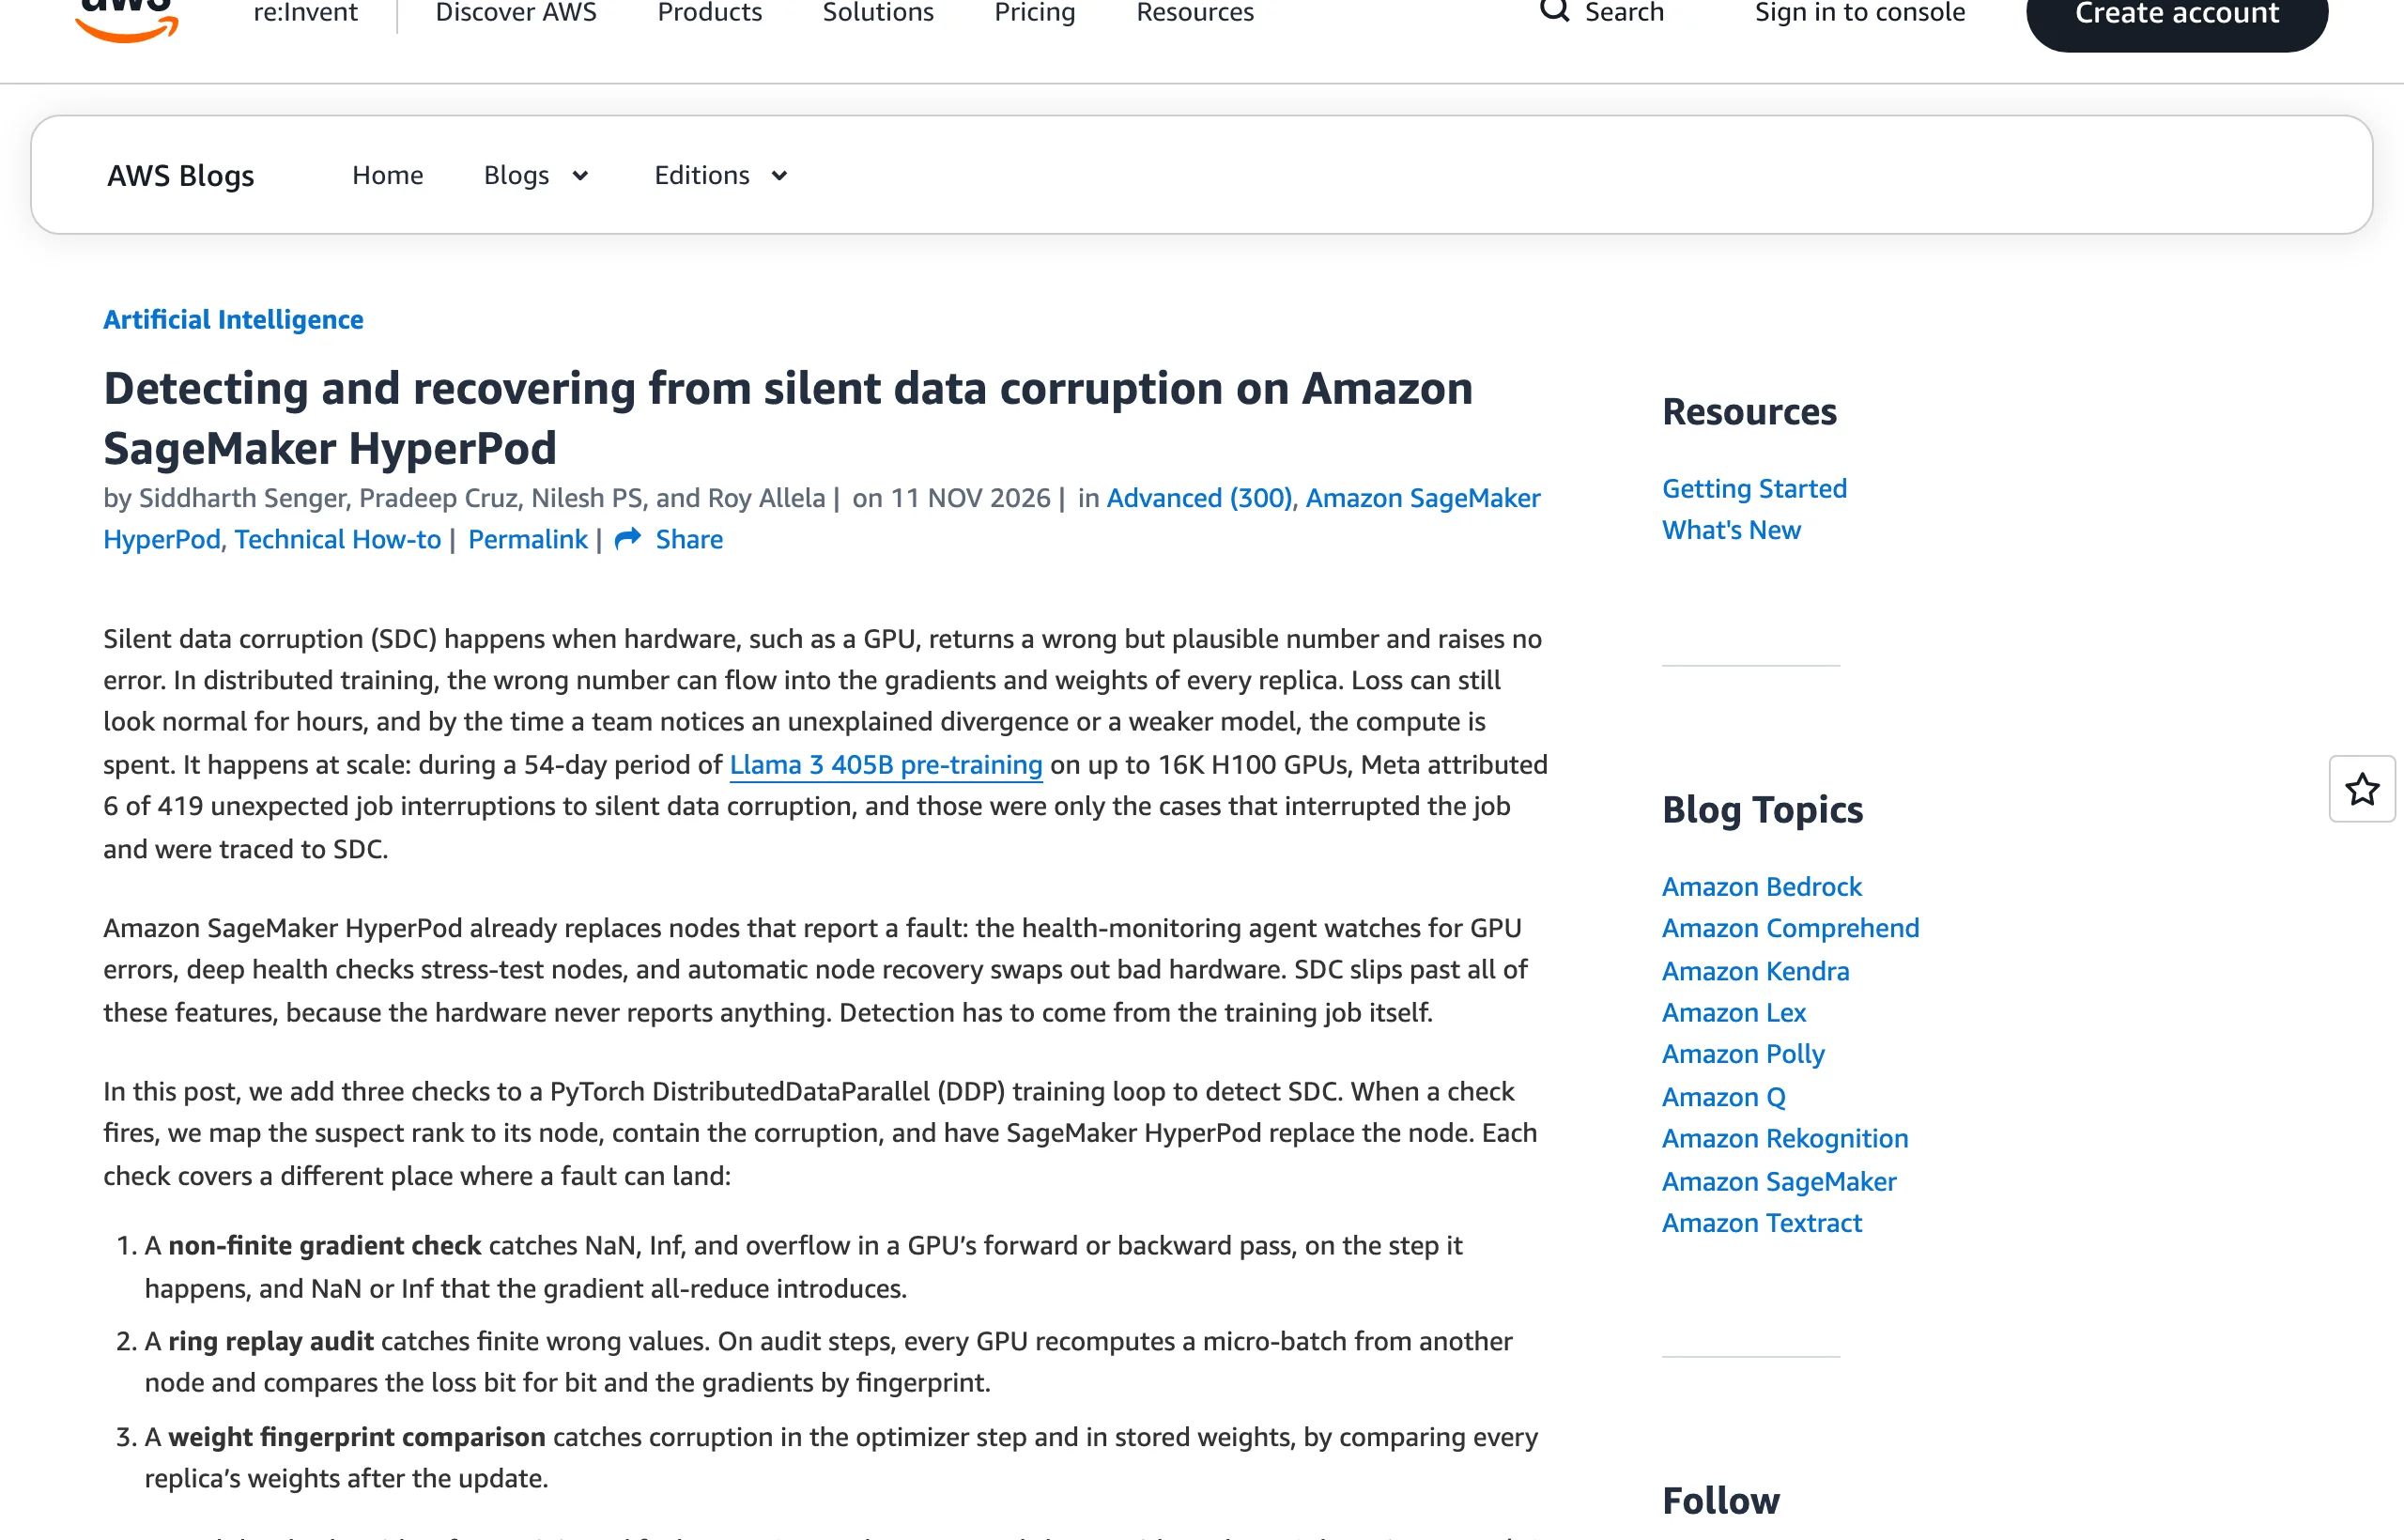
非有限梯度檢查成本最低,每步都跑:all-reduce 之前檢查每個副本自己的梯度有沒有 NaN、Inf 或溢位,all-reduce 之後再檢查平均梯度一次,然後才允許更新。它只抓會變成非有限值的錯誤,但它在錯誤發生的那一步就點名 GPU,而且能在壞梯度碰到權重之前擋下整個更新。
這裡有個值得記下的失敗設計。AWS 團隊最初的方案是比較各副本的梯度範數(gradient norm),偏離中位數超過 k 個 MAD(中位絕對偏差)就報警。他們在 32 張 H100、9.53 億參數模型上記錄了三輪無故障訓練共 22,800 步的每個副本範數,結果這個方法不可用:健康的副本之間範數差異本來就巨大,前 800 步就出現偏離 224 個 MAD 的健康值,全程達到 1,240 個 MAD;把門檻放到 k=336,剩下的 22,000 個健康步裡仍誤報 11 次,而注入故障的副本分數最高只有 6.9,把某個 activation 乘上 10,000 也一樣。常規值比較這條直覺路線,AWS 已經用這份量測紀錄替大家踩過雷了。
環狀重算稽核抓有限但錯誤的值。在指定的稽核步(audit step)、優化器更新之前,每個 rank(副本編號)重算另一個節點上 rank 的 micro-batch,把損失值逐位元比對;開啟 deterministic kernels(確定性核心)時,連每個參數的梯度指紋都一同比對。在 p5 執行個體上每節點 8 張 GPU,所以重算對象是 r+8,剛好跨到隔壁節點。每個 rank 會出現在兩組比對裡:自己那批被別人重算、自己重算別人的那批。兩組都不符的就是元兇;只有一組不符時,由第三張(第三節點上的)GPU 與目標一起再重算一次確認,還能區分持續性故障與暫時性故障。範例裡有條硬規則:永遠不要只在嫌疑 GPU 上重算它自己的工作,因為持續性缺陷會重現自己的錯答案。
權重指紋比對守更新與儲存階段。優化器更新之後,所有副本的權重必須逐位元相同,沒有容差可調;每隔 N 步、以及每個檢查點之前,比對每個副本的權重指紋,用嚴格多數決點名歧異者。它是唯一跑在更新之後的檢查,因此是唯一能擋下「從被汙染的副本存出檢查點」這件事的檢查。
指紋本身是個輕量設計:每個張量壓成兩個 64 位元總和,一個是原始位元模型的直接加總,另一個按位置加權。改動一兩個元素必然改變指紋(張量元素少於 2 的 32 次方、每元素不超過 4 位元組時);更大量的改動理論上可能互相抵銷,所以指紋相等是強證據,不是證明。位置加權那個總和有其必要:AWS 的注入測試裡,互換兩個權重值、或對兩個值做補償性修改,直接加總完全不動,只有加權總和抓得到。
AWS 團隊在 4 台 ml.p5.48xlarge(32 張 H100)上訓練 9.53 億參數的 Llama 風格解碼器,對每種排程連續量測 1,000 步的平均步時,結果如下(作者宣稱的量測值,模型與工作負載見其文章):
| 排程 | 平均步時 | 相對無檢查 |
|---|---|---|
| 無檢查的 DDP | 157.4 ms | 基準 |
| 加檢查、不做稽核 | 169.0 ms | +7.4% |
| 確定性稽核每 10 步 | 211.9 ms | +34.7% |
| 預設核心稽核每 10 步 | 177.0 ms | +12.5% |
| 確定性稽核每 100 步 | 173.3 ms | +10.1% |
| 預設核心稽核每 100 步 | 169.3 ms | +7.6% |
幾個讀法。約 7 個百分點的成本與稽核頻率無關,那是每步都跑的梯度 hook、兩次 NaN/Inf 檢查,加上每 10 步的權重比對(每次 31.1 ms,約當一步的 2%)。確定性稽核步的成本是普通步的 2.4 倍,因為確定性注意力走 math kernel,成本隨序列長度平方成長,AWS 明言要團隊用自己的模型量,不要直接套這張表。假警報方面,兩種叢集規模合計 150 分鐘、30,800 步、15,320 次稽核加 3,080 次權重比對,零警報;AWS 據此把假警報率上界定在約每 5,100 次稽核步 1 次(95% 信賴區間)。AWS 建議的生產起點是確定性稽核每 100 步,在它的模型上約當 10.1%:100 步內抓到持續性故障,代價是最多 99 個已套用的汙染更新需要回滾。
這份材料的價值有一半在官方自曝的邊界。故障注入結果表裡有兩列明確標示漏抓:對「只影響反向傳播」的權重梯度故障,預設核心稽核在 50 步內零警報,而且步 20 與步 40 的檢查點帶著「稽核通過」的標記照常存出,因為損失值不受影響、每個副本又套用了同樣的汙染更新;要開確定性稽核,靠梯度指紋才點得了名。另一列:關閉檢查點前的強制權重比對後,步 31 被翻轉一個位元的權重,在步 35 的檢查點照存出去,要到步 40 的環狀稽核才抓到 rank 0,晚了五步。
還有設計上就放掉的東西。all-reduce 本身產生的有限錯誤會一模一樣地進到每個副本,三層檢查全部通過,官方明言這是缺口。非稽核步上只發生一次的有限錯誤,完全抓不到。兩次稽核之間,最多 audit_every 減 1 個汙染更新已經套用進權重。權重比對對 ZeRO-1 或完整 FSDP 分片無效(每個分片的更新只在單一 rank 上計算),只有兩份副本時能報分歧、無法點名。而最根本的:儲存庫 README 原文寫明,實驗全部資料合成、全部故障軟體注入,它證明每層檢查按設計運作,不證明真實硬體的故障率或偵測率。部落格也建議,在自家工作負載累積精確度證據之前,每次換節點都保留人工審核。
一份乾淨的 DCGM 遙測面板同樣不能還節點清白:純粹的 SDC 經常不留硬體痕跡,這也是為什麼整套流程把「訓練程式內比對運算結果」放在中心,把硬體遙測降為佐證。
範例給的恢復流程分四步。偵測由訓練工作自己完成;定位靠 Kubernetes,HyperPod EKS 的節點名稱就是執行個體 ID 加上 hyperpod- 前綴,用 downward API 把 NODE_NAME 傳進 pod,工作啟動時記一份 rank 到節點、執行個體與 GPU UUID 的對照表。之後是圍堵:先停工作,kubectl cordon 把嫌疑節點標成不可排程,再到 HyperPod 觀測套件的 DCGM 面板看警報時段該 GPU 的可修正 ECC、PCIe 重試、溫度與降速紀錄。難以判讀的警報用 StartClusterHealthCheck 對嫌疑節點跑 DCGM L4 深度健康檢查;AWS 提醒壓力測試抓的是會舉報的硬體故障,資料相依的微妙缺陷常常通過,它只能當分診工具用。
確認後換節點有兩條等價路徑:給節點貼 sagemaker.amazonaws.com/node-health-status=UnschedulablePendingReplacement 標籤讓 HyperPod 自動恢復接手,或直接呼叫 BatchReplaceClusterNodes API。注意換節點會連根毀掉該節點的根磁碟與本機 NVMe,檢查點必須放在 FSx for Lustre 或 S3 這類共享儲存上,這是範例列出的前提條件之一。
回滾有個容易被忽略的細節:要從嫌疑時段(suspect window)開始之前保存的檢查點恢復。把同一份受汙染的狀態直接搬到新硬體上繼續跑,等於帶著錯誤結果前進。載入檢查點後、走第一步之前,先跑一次權重比對。AWS 還提醒,檢查點上的「稽核通過」標記只是該步當下曾通過檢查的紀錄,並不保證存檔內容乾淨。要全自動化的話,文章給了控制器樣板:訓練工作把警報發成 CloudWatch 指標(sdc_nonfinite_grad、sdc_replay_mismatch、sdc_divergent_tensors),用 EventBridge 或 Kubernetes operator 串起圍堵與換節點,但人工審核那道閘在他們的設計裡仍然留著。
HyperPod EKS 上跑 DDP、三節點以上的團隊,這份範例值得照著評估:先用官方腳本量自己模型上確定性稽核的真實成本(長序列注意力會讓代價遠高於示範模型的 10%),核對 micro-batch 能否用固定種子取樣器重建、檢查點是否已在共享儲存。生產起點照官方建議從確定性稽核每 100 步開始。用 FSDP 或 ZeRO 的團隊這版先不用考慮:權重比對需要同一份權重的至少三個完整副本,分片架構要等社群把 find_divergent_ranks 改接到持有同分片副本的 group,或者自己動手。還沒上這種規模的團隊也沒有急事;SDC 是規模問題,HyperPod 用戶可先開內建的 MultiNodeTraining 深度健康檢查篩選新節點與替換節點,把它當前端防線,再決定要不要上程式內檢查。
兩件事尚未確認。真實硬體上的偵測率與故障率,合成實驗推不出來,AWS 自己也這樣寫;另一件事是,目前這是範例程式碼與方法文件,AWS 是否會把 SDC 偵測收進 HyperPod 平台功能,公告裡沒有承諾。儲存庫仍在活躍更新(11 月 14 日仍有提交),若出現 FSDP 支援或平台層整合,本文的適用範圍結論需要回查;效能數字的基準是 AWS 部落格 2026 年 11 月 11 日版本。
資料來源:AWS Machine Learning Blog 官方公告(2026-11-11)、awsome-distributed-ai 範例程式碼(MIT-0 授權)、The Llama 3 Herd of Models。AWS 開源評測框架的近例可參考這篇 UAEF 介紹,同系列訓練基礎建設還有 SGLang-Neuron 上 Trainium3 的公開預覽。