TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

RoboColosseum 在 124 個真實場地完成 15,000 次實機評測,論文與排行榜同步公開。開放路線盲測配對讓語言代理與專用模型同場較勁,排名卻隨機構與路線洗牌,G1 人形機器人五項任務全數零完成。本文拆解數字口徑與申請免費評測的入口。
用 AI 摘要這篇文章:
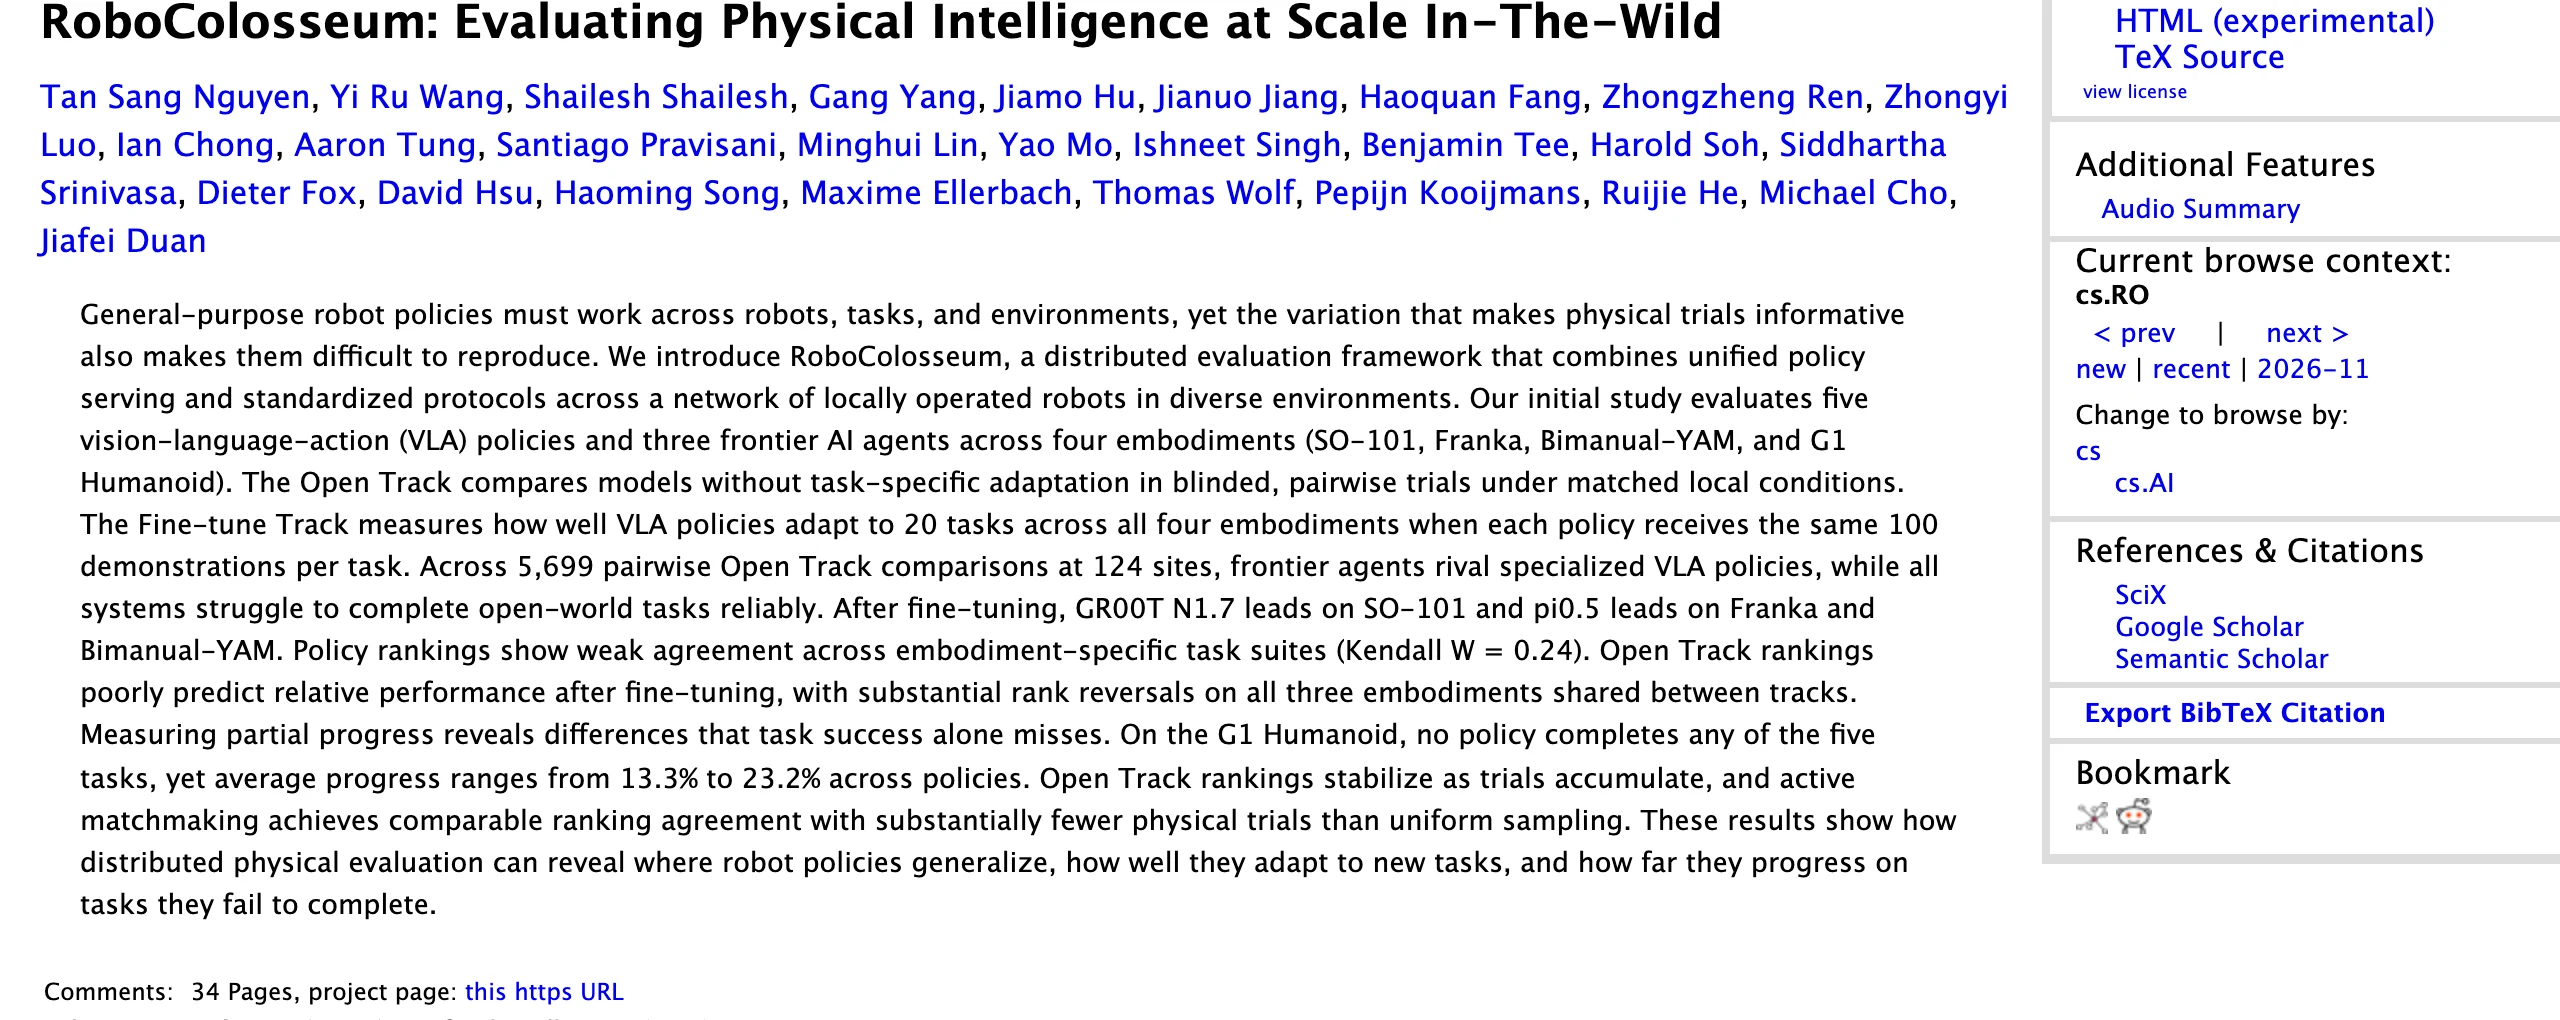
11 月的第一個星期,機器人評測出現一件新裝置:一篇 11 月 2 日提交 arXiv 的論文(編號 2611.02497),配上 11 月 4 日上線的官方網站與申請入口,把「機器人模型到底多能幹」這個問題,從各家自己剪輯的展示影片,搬進 124 個真實場地。計畫名稱 RoboColosseum,由 NUS MAGIC Lab、BitRobot Foundation、Singapore Embodied AI Centre 與 Hugging Face 共同創辦,論文作者群另外掛名華盛頓大學、史丹佛、AI2 與牛津等機構。
首批成績的規模寫在官方公告:15,000 次實機評測。其中開放路線在 41 天內累積 11,398 次評估、橫跨 124 個場地,涵蓋四種機構:SO-101 開源機械手臂、DROID 設定的 Franka、雙臂 YAM,以及 Unitree G1 人形機器人;場景從教室、圖書館、美食街一路到真實住家。評測不是在一間實驗室裡完成的,場地由各地據點在本地操作,再用共同協議串成同一份榜單。受測模型共八個,五個視覺語言動作模型(VLA)加上三個前沿語言代理:Grok 4.7、Claude Opus 5.5 與 GPT-6 Astra。
這批數字最一致的結論,反而是沒有一致的贏家。排名隨機構、任務與評測路線變動,開放路線的強者到微調路線可能翻車,人形機器人在五項微調任務上全數零完成。看膩了「一家模型稱霸」敘事的機器人圈,這份誠實的榜單本身就是新聞。
RoboColosseum 把評測拆成兩條路線,回答兩個本來就不一樣的問題。
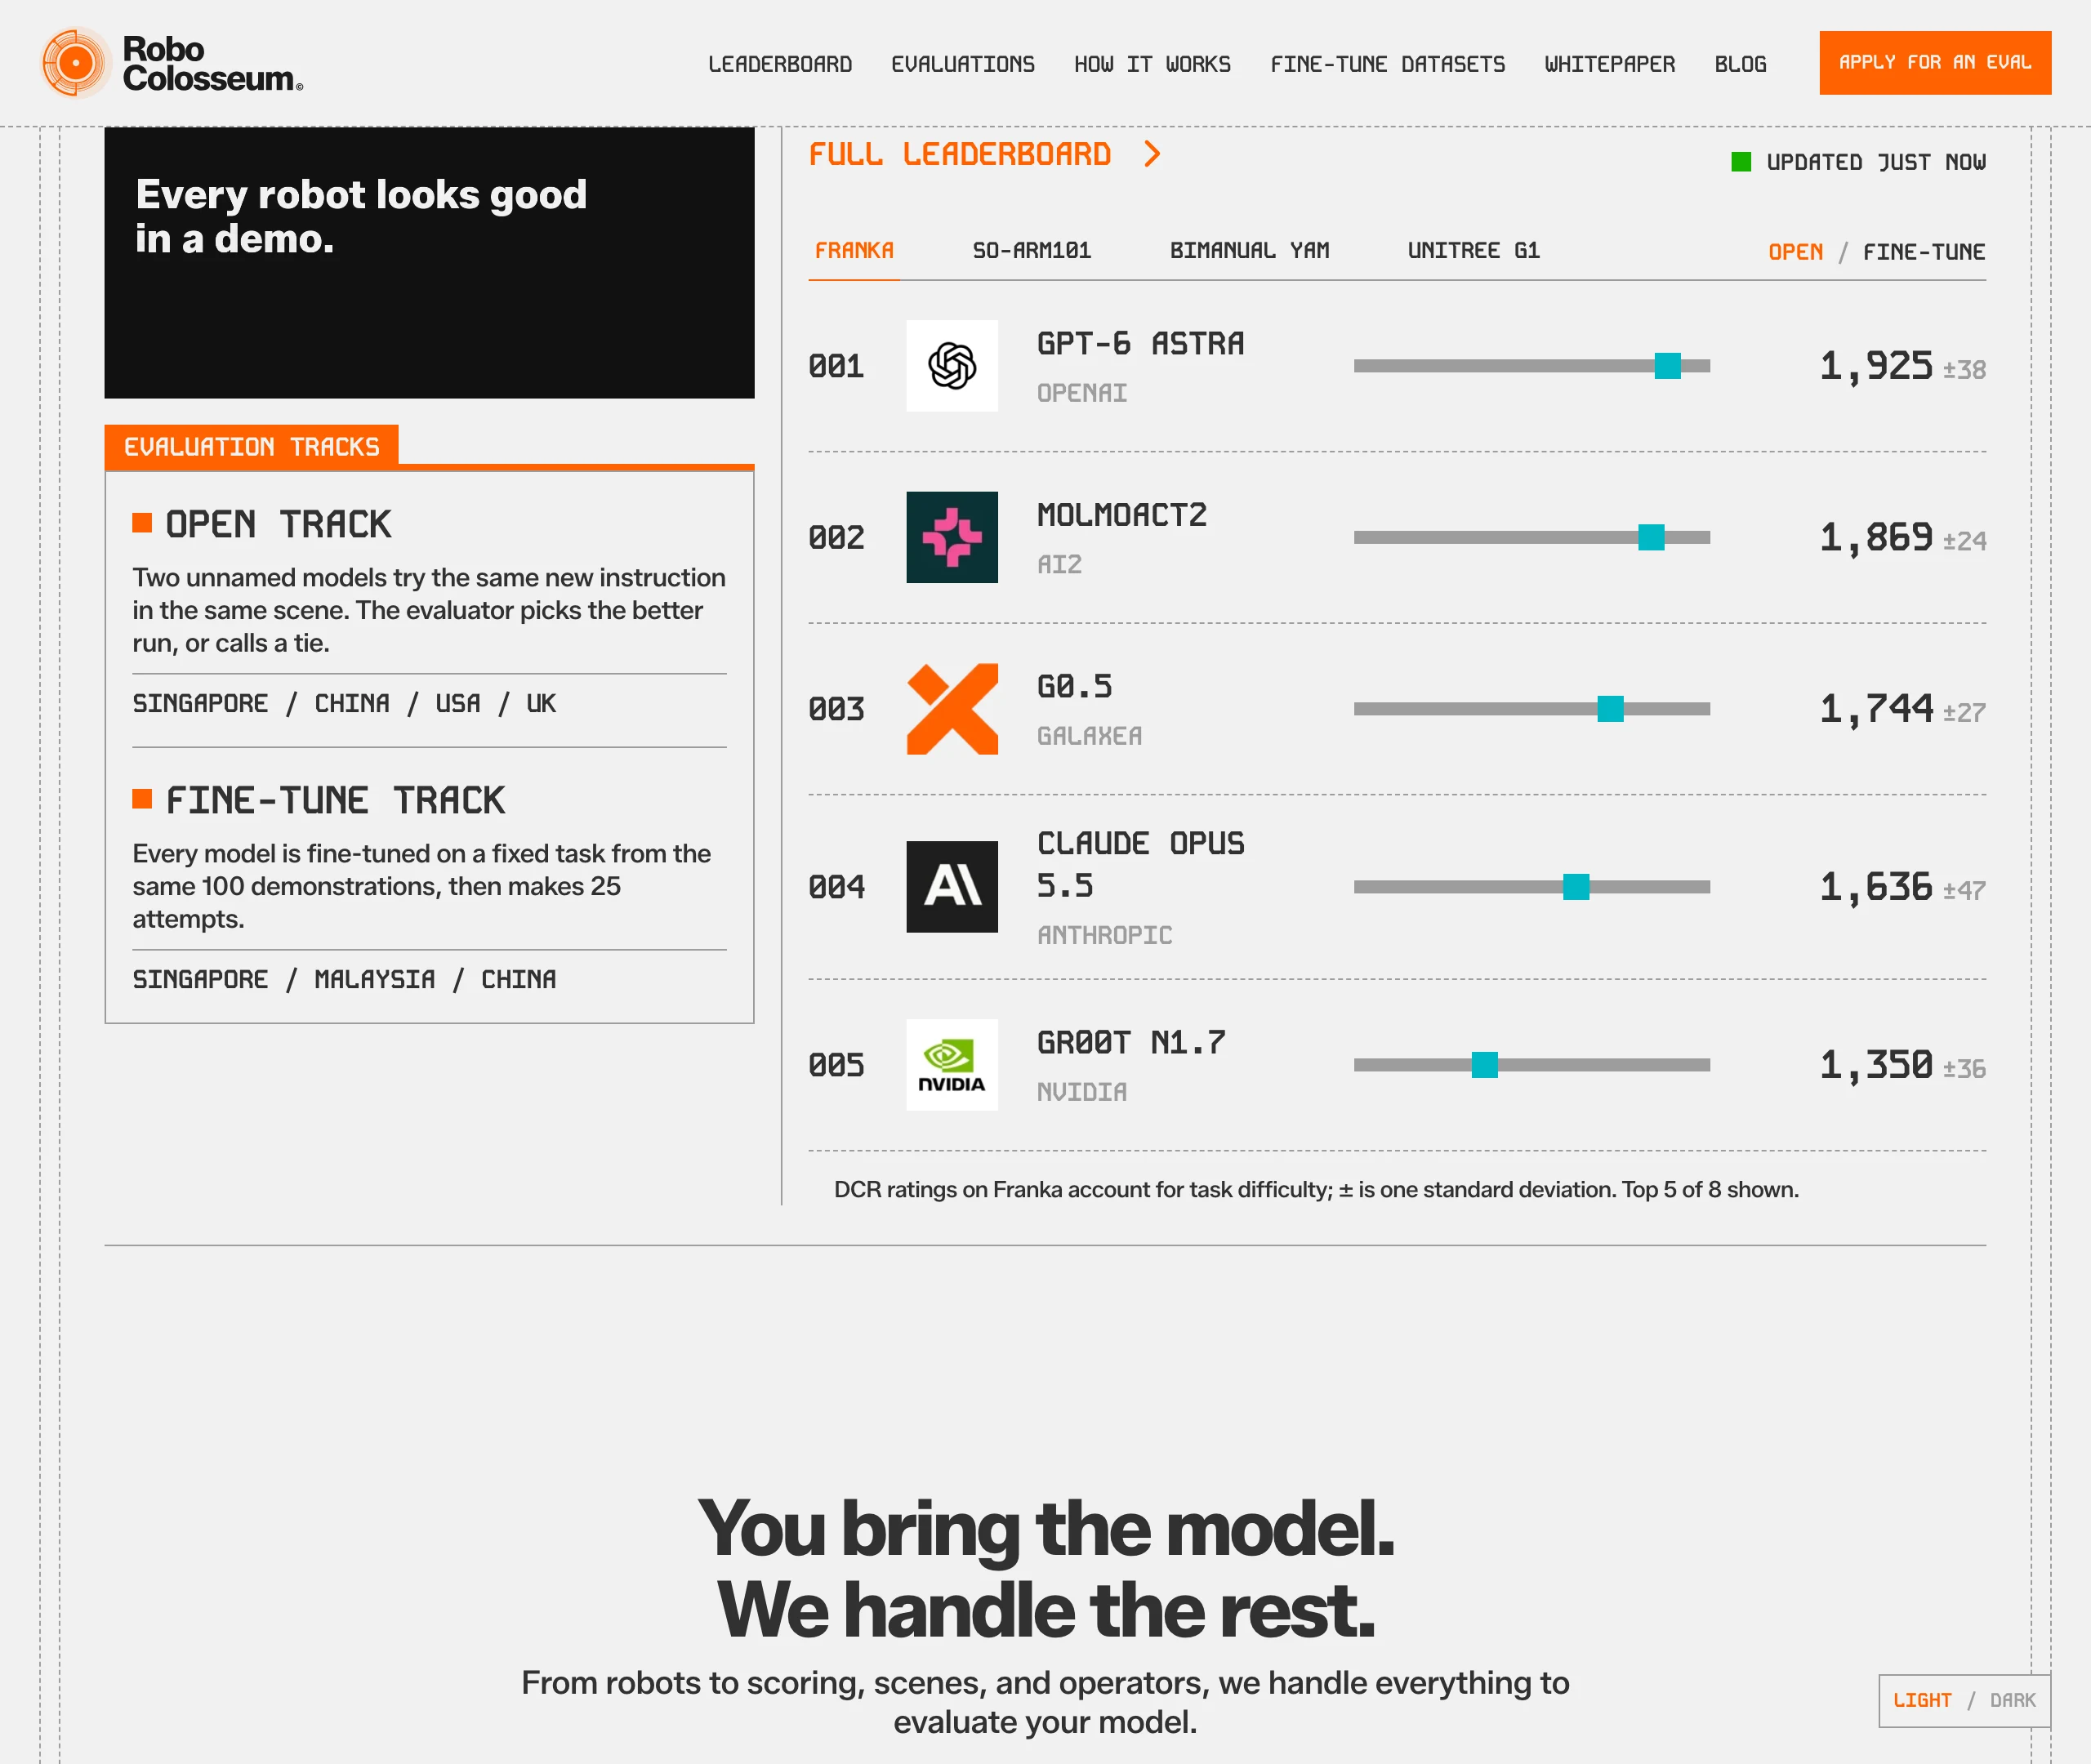
開放路線量「拿來就能用」。模型不做任務專屬微調,兩個匿名模型在同一場景接到同一道新指令,指令由評測員當場撰寫,不在預先定義的題庫裡。各跑一次之後,評測員盲測選出較好的那次,或判平手。五個 VLA 與三個語言代理都參加這條路線,而且語言代理只參加這條。
語言代理上場的方式值得展開:論文特別註明代理「按發布版使用」,不做微調、不做任務專屬提示、拿不到任何示範。它們每一步收到的是全部相機的 640×480 影像(SO-101 與 Franka 兩個視角,YAM 三個)、帶標籤的數值狀態與文字指令,每一回合只能呼叫一次工具:移動到指定關節位置、宣告完成,或放棄。移動時還必須附上一兩句話,說明自己看到什麼、為何選這個動作,這些註記隨紀錄保存。任務分配、控制、逾時與計分,全部與 VLA 用同一套。
微調路線量「給同樣資料後誰學得好」。每個模型拿到同一批每任務 100 段的人類示範,在四種機構共 20 項預定義任務上微調,再各做 25 次嘗試。這對應的是現場收集得到示範資料的採用情境,而示範採集本身就是個工程,先前介紹過的 UMI-Live 雙手採集器解的正是這一段。
兩條路線名次不一樣,是設計使然。看數字前先問自己屬於哪一種情境:模型拿來不改就用,該看開放路線;現場收集得到一百段上下的示範,該看微調路線。泛化能力與資料效率本來就可能屬於不同的模型,單一總榜同時回答不了兩種問題,這點在後面的排名翻轉會一再出現。
真實場地最麻煩的地方在於不公平:每個據點的燈光、桌面、物品擺放都不同,直接把各地的成功率加總,量到的往往是場地難度而非模型能力。RoboColosseum 的回應是三件事疊起來:同一種機構內統一硬體設定、30 人規模的專職操作員與評測團隊、以及配對制比較。同一場地、相近條件下讓兩個模型依序上場,只比相對好壞。
每輪比較的現場工作是重的:操作員重排場景、確認後一個模型的起點夠接近前一個,每台相機全程錄影。官方網站把這些錄影做成評測檢視器,真實的盲測配對雙畫面同步播放,評測員的選擇與當場筆記附在旁邊,任何人都能點開看。對習慣只看剪輯精華的機器人圈,這種把原始過程攤開的做法,比任何分數都更有說服力。
排名方法本身也考慮了難度。官方採用難度校準的 Rasch 模型(縮寫 DCR),把「模型能力」與「任務難度」放在一起估計,人類對任務的 1 到 10 分難度評分是輸入之一。直白講:它不只問誰贏,也問這場比賽有多難。兩個模型都成功與都失敗在帳面上都是平手,但對任務難度透露的訊號不同,DCR 把這層差異保留下來。
真機測試很貴,每輪比較前都要有人重排場景。團隊因此用主動配對,把測試優先留給勝負還不清楚的組合:論文的數字顯示約 400 到 500 次評估,就能達到與完整資料約九成的排序一致,均勻抽樣則約需 1,000 次。這個效率設計決定榜單能不能持續更新,而不是一次性表演。
另一個少見的承諾是資料全公開:所有評測過程,包含失敗的嘗試,都以 LeRobot 格式發布在 Hugging Face 上的 RoboColosseum 組織頁,程式碼也在 GitHub。不申請評測,照樣能下載資料分析或訓練。
首批結果最有話題性的一段,是前沿語言代理與專用機器人模型的對比。在 901 組配對評估中,代理拿到較多任務進度的有 394 組,專用 VLA 有 265 組,剩下的 242 組平手,平均進度差距 5.3 個百分點。
「追平」在這裡要小心用。這是進度口徑的配對結果,只限開放路線,而且平手組比任何一方的勝場都多。細看單一代理,差距也不均勻:Claude Opus 5.5 與 GPT-6 Astra 的平均進度優勢分別有 12.1 與 11.0 個百分點,Grok 4.7 反而落後配對的 VLA 7.5 個百分點。論文自己的措辭是:前沿代理已能匹配甚至超越專用 VLA 政策,但相對表現取決於代理與機構。真正的驚訝點不在代理比較強,在通用推理能力接上機器人介面後,已經能坐上同一張牌桌。
官網排行榜現在就看得到各機構分頁。以本文截圖當下的 Franka 分頁為例,前五名依序是 GPT-6 Astra(1,925 分,不確定度 ±38)、MolmoAct2(1,869)、G0.5(1,744)、Claude Opus 5.5(1,636)、GR00T N1.7(1,350)。對照論文「GPT-6 Astra 在 Franka 拿到最高 DCR 點估計」的敘述,榜單與論文一致;論文同時指出 Claude Opus 5.5 在 SO-101 與雙臂 YAM 的點估計最高。同一批模型,換機構就換領先者,這正是下一節的主題。
如果只想從這份榜單帶走一個結論:不要用單一排名挑模型。微調路線跨機構任務組合的排名一致性很低,Kendall’s W 只有 0.24;這個係數從 0 到 1,越高代表各機構的榜越一致,0.24 意味著換一套任務,先後順序幾乎要重抽。微調路線上,GR00T N1.7 在 SO-101 表現最好,π0.5 則同時拿下 Franka 與雙臂 YAM。開放路線的排名也無法預測微調後的表現,三個兩邊都參加的機構,全數出現名次翻轉。
論文裡一個例子把「適應能力」拆得更細。雙臂 YAM 的微調任務上,π0.5 有四項任務達到 96% 到 100% 的成功率,疊杯任務 72%;G0.5 在抽屜與微波爐兩項都是 100%,疊杯卻只有 20%。同樣 100 段示範餵進去,個別任務學得會,不代表整組任務都學得會。
對要部署的人,含義很直接:先列出自己的機構與工作類型,再找相同條件的證據。抓取零件、雙手裝袋、全身移動需要的能力不同,硬體換了,先前的排名就要重看。這與先前 SO-101 Bench 用模擬篩政策、真機量成功率的思路相通:證據要對得上使用條件。
微調路線在人形機器人 Unitree G1 上的結果最刺眼。五項任務是把盤子立進瀝水架、搬箱、折毛巾、把衣物放進洗衣機、掛鑰匙,全都是家裡會出現的動作,而所有受測策略在五項上全數零完成。論文還補了一個更冷的數字:不到四成的測試次數,滿足哪怕四分之一的評分條件。
但零完成不等於零資訊。各策略的平均進度分數落在 13.3% 到 23.2% 之間,逐項看差異更大:把衣物放進洗衣機這一項,表現最好的策略平均走到 44% 的進度,同場有一個策略是 0;掛鑰匙、折毛巾各策略的起伏模式也完全不同。論文把這組數字當成進度指標的示範案例,對研究者是診斷線索,看得出改善來自更常走到中途,還是真正增加完成整項任務的比例。
對要交付完整工作的現場,成功率仍是唯一硬指標,進度分數只是補充視角。這也與 RobotAgentBench 觀察到家用機器人「會抓物、不會把家務收尾」的結論互相呼應:段與段之間的收尾,仍是目前機器人政策最薄的一環。模擬環境裡的版本可以參考 micro1 雙臂模擬評測,那裡的問題同樣出在「模型說做完了,感測器說沒有」。
計畫提供 10,000 小時免費評測,採申請制:在官方表單說明你的策略與想測的機構,團隊逐一審核後安排。接模型有兩種方式,自己架推理伺服器,透過 policy API 讓機器人把觀測串流過來;或者直接交出 checkpoint,由團隊在機器人旁的機器代跑。
可測機構目前就是前述四種,輪式機器人 Earth Rover Mini+ 在官方 FAQ 標註即將加入。門檻也寫得明白:策略要能吃機器人的相機輸入,並產出對應機構的動作格式。
這個入口對三種人各有用處。有策略的研究團隊,借的是場地、硬體與一套已經跑起來的規則;正在選型的人,拿到的是條件對得上的比較證據;而資料工作者就算不申請,也能直接下載含失敗紀錄的 LeRobot 資料集。方法、20 項微調任務的完整定義(含工作區照片、成功條件、部分進度評分標準)與每張圖表的數值,都在 arXiv 2611.02497;想直接看排名,官方排行榜即時更新。
這份榜單是活的。官網首頁寫 140 個以上場景,實際數量隨據點加入持續增加;分數與排名會隨評測累積持續修正,文中引用的名次對應的都是截圖當下的狀態。引用任何數字時,建議連同排行榜一起回查,第一批 15,000 次測試對一個要長期運作的評測網路來說只是起點。
還沒有答案的部分也該說清楚:免費時數的分配由團隊裁量,標準未公開;額度之後是否收費,官方沒有提。場地網路以新加坡為主,加全球夥伴據點,官方感謝名單裡有新加坡國家機器人計畫的經費支援,以及 FrodoBots 在東南亞住家與都會空間的資料採集。結果的地理適用性因此有邊界,你在自己廚房量到的,不會和美食街一樣。
值得盯著看的變化也有幾個:開放路線的首批成績還沒有 G1 條目,人形機器人的零完成目前只出現在微調路線;輪式機器人 Earth Rover Mini+ 上線後會帶來移動底盤的成績;語言代理受限於接取方式,短期內不會出現在需要交出 checkpoint 的微調路線。這些缺口補上的速度,會決定這份榜單從「首波快照」變成「常用參考」的時間表。
把這次事件看成一個結構轉變,會比看成一場比賽更有用:機器人能力的比較,第一次有了持續運作的真機基礎設施,而且連失敗影片都攤在陽光下。下次再看到某家實驗室釋出「機器人會做家務」的展示影片,可以多問一句:同樣條件下,跟誰比過。