TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

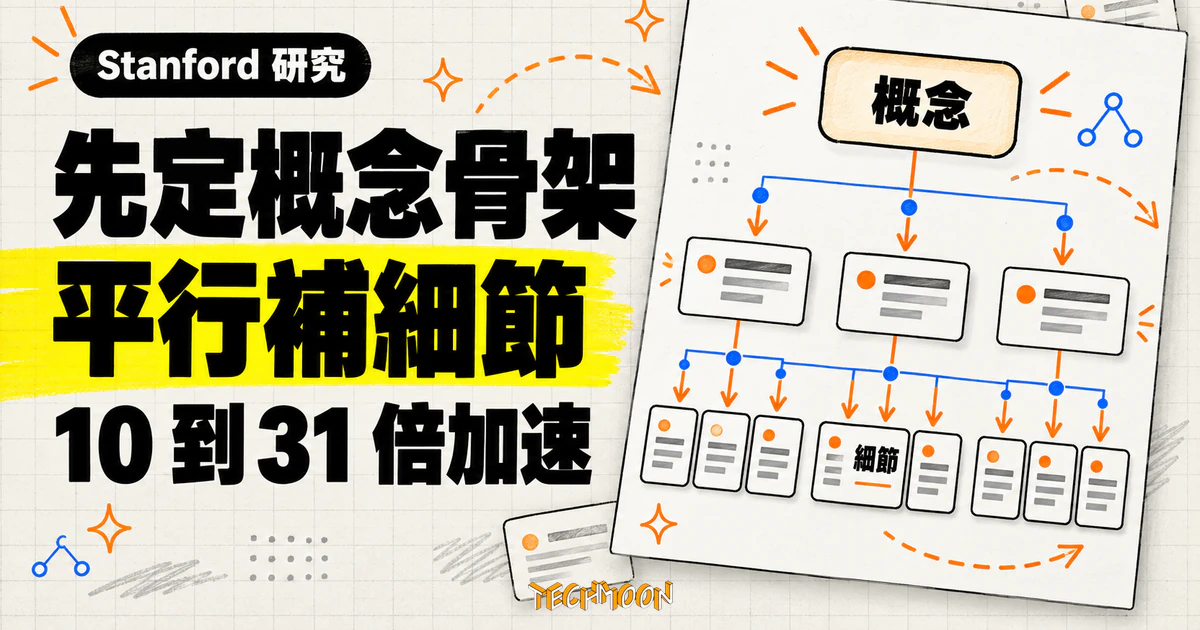
Stanford Hazy Research 提出 Next-Concept Modeling,把文字生成從逐詞元接龍改成逐層平行補細節,官方在單張 H100 上量到 LM1B 21 倍、OpenWebText 10 倍、XSum 摘要 31 倍牆鐘加速,訓練詞元省 4.9 倍;權重、資料與評測腳本已連同 MIT 程式碼一週內公開,規模與中文表現尚未驗證。
用 AI 摘要這篇文章:
先把結論說清楚:Next-Concept Modeling(NCM)量到的 31 倍加速是真的,但它是「XSum 摘要任務、單張 H100、與研究團隊選定的強擴散基線、ROUGE-L 分數對齊」這組條件下的答案;換成別的任務,同一份研究報告的是 21 倍與 10 倍。這套方法真正的新聞不是倍率,是它把文字生成的單位從「詞元」換成「層」,讓同一層的內容平行產生。2026 年 10 月 9 日論文提交到 arXiv,10 月 11 日程式碼上線 GitHub,10 月 12 日 Stanford Hazy Research 官方說明發布,一週內把權重、訓練用資料與評測腳本全部公開,重現的大門是開的。任何聊天機器人不會因此變快,但研究生成效率的人得到了一套可以親自查證的材料。接下來把每個數字的出處與條件攤開:方法怎麼運作、倍率在哪些任務上量到、重現要花什麼力氣、哪些部分還沒被證明,還有一個現實:材料齊備到今天剛好一週,獨立重現仍然缺席。
NCM 的論文全名是《Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation》,編號 arXiv 2610.14162,由 Stanford Hazy Research 的九人團隊完成:Hermann Kumbong 與 Ishan S. Khare 並列一作,Simran Arora、Azalia Mirhoseini、Christopher Ré 共同指導。速度數字全部出自官方說明的效率段,量測方式是單張 NVIDIA H100 SXM 80GB 上的實際生成時間:
| 任務 | 速度 | 品質條件 |
|---|---|---|
| LM1B 無條件生成 | 21 倍 | 生成困惑度優於比較對象 |
| OpenWebText 無條件生成 | 10 倍 | 生成困惑度相當 |
| XSum 極端摘要 | 31 倍 | ROUGE-L 分數對齊 |
表裡的「無條件生成」指模型不給輸入、自己憑空寫一段文字;「條件生成」則是給定原文或外語句子再產出對應內容,摘要與翻譯都屬於這類。兩種設定的難度不同,倍率自然不能互換。
三個任務要各自認識一下。LM1B 是十億詞級的句庫基準,考的是模型接續文字的基本能力;OpenWebText 是從網頁爬取語料整理的通用語料;XSum 則是把整篇新聞文章壓成一句話的極端摘要任務,比較時用的是 ROUGE-L,這個指標以最長共同子序列量摘要與參考答案的重疊程度,對得上不代表內容全對,但至少把「速度贏、品質輸」的漏洞先補起來;所謂 ROUGE-L 對齊,白話就是先把品質調到與對手同分,再來比誰快。翻譯任務 WMT14 德譯英也測了,官方的寫法是與比較對象品質相似或更好、速度提升最高到 31 倍;另外還有一個更小的兒童故事語料 TinyStories 參與語言建模評測。摘要裡「參數規模對齊」這幾個字藏著比較的前提:比較是在同等參數量下進行的,這是擴散基線與 NCM 能站上同一個計分板的前提。三個倍率綁三個任務與三種品質指標,沒有一個是「對聊天產品全線提速」。論文摘要與部落格通稱 10 到 31 倍,取的就是這組範圍;量測用的 H100 是資料中心等級的顯示卡,換到其他硬體上倍率可能不同,這也是重跑評測有價值的原因。
這也是讀這類新聞的通用方法:倍率本身不會說謊,但它的分母、硬體與品質對齊方式,決定了這個數字能不能搬到你自己的場景。同一篇說明裡還有一個容易漏看的數字:在語言建模任務上,NCM 達到相近品質用的功能評估次數少 11 倍;論文裡這個指標的定義是生成器對每個輸出的呼叫次數。擴散模型圈習慣用評估次數談效率,官方這次特別強調改量牆鐘時間,理由寫得很明白:不同方法每次評估的運算成本差很多,只比次數會失真。NCM 每層只要一次前向計算,而且早期層的序列很短,正是「次數少、單次也便宜」的組合。這些數字全部出自官方在單張 H100 上的量測,第三方重跑的結果還沒有人提出。
現在主流的兩條生成路線各有等待結構。自回歸模型一次預測一個詞元,後面的字要等前面的字出來,答案愈長、序列步驟愈多;擴散語言模型能平行修正多個位置,但每一輪都要處理整段文字,減少輪數時品質掉得快,而且往往要把資料集反覆掃過很多次才訓練得好。擴散陣營自己的解法多半繞著步數打轉,例如把多步的教師模型蒸餾成少步的學生,或直接學出雜訊層之間的映射。當模型的輸出愈來愈長、推論逐漸成為運算的主要負擔,這些等待結構的代價都會被放大。NCM 的選擇不一樣:換掉表示方式本身,先把文字壓成分層表示,再一層一層展開。
訓練分兩個階段。第一階段訓練多尺度 tokenizer,學會把同一段文字壓成由粗到細的離散代碼階層:離散代碼可以想成從固定選項簿裡挑出的編號,不是自然語言的摘要句。最前面幾層只有少量代碼,抓住整體輪廓,愈往後層愈長、細節愈多,而且要能從代碼還原原文,壓得太兇會在還原時丟失資訊,生成器選對大方向也救不回細節。這裡的「殘差」結構拆開看更清楚:每一層存的不是另一批新內容,而是對目前重建結果還差多少的修正量,逐層疊加才把原文補完整。論文附錄的質性檢視也支持這個分工:粗層抓住的是全域結構,細層補的是區域細節。這套做法的血緣來自影像領域的 VAR,團隊為文字加了三個調整:每層有自己的代碼簿、用巢狀丟棄迫使前面的層不依賴後面的層也能有意義、加上詞元級的重建目標。第二階段凍結 tokenizer,訓練一個 transformer 從前面各層的累積重建預測下一層;先凍結再訓練,直觀的理由是生成器需要一個固定的表示空間當目標:壓縮規則若一邊學一邊生成,評分就沒有穩定的基準。訓練時所有層在一次前向裡一起算,並刻意汙染一部分條件代碼,讓模型對生成過程中的錯誤更有抵抗力;注意力設計上各層看自己的位置、對已有層做遮罩,推論時每層只需要一次前向計算,同一層內的所有代碼平行產生。附帶一提,每個任務的階層設定是分開練的:層數、每層的代碼數與訓練步數都按任務調整,摘要與數獨用的不是同一座階梯。
平行發生在層內,層與層之間仍有先後,這是讀懂這套方法的重要界線。效率邏輯也在此:早期層的表示很短,模型開頭不必處理跟最終文字一樣長的序列,運算隨細節需要才逐步加上去;同一層的位置數量多,但一次前向全部解決。把加速拆開看,來源就是這兩件事相乘:步驟數少(層數遠少於詞元數),而且前面的步驟比後面的便宜(序列還很短)。官方頁面放了一段德譯英的逐層示範:德文原句講的是中小企業持續暴露在駭客攻擊與監控風險下的疑慮,參考譯文是 “However, there is concern that small and medium-sized companies remain vulnerable to hacking and surveillance”,一個句子分 11 層補出細節,每一層都解碼一次,畫面上的句子從模糊輪廓慢慢變成完整譯文,頁面逐層計算 BLEU,靜態呈現的最終解碼句對參考譯文拿到 77.8 分。這種逐步現形的輸出方式,與自回歸模型逐字打出來的體感不同,對要做串流介面或進度提示的團隊,是值得記下的介面設計線索。要提醒的是,名稱裡的「概念」是模型學到的壓縮代碼,不是人類看得懂的大綱,也沒有證據說它像人一樣先想清楚再動筆。
速度之外,這份研究有兩組數字更能說明這條路線的份量。其一是數獨:這種每格選擇都會影響其他位置的任務,正好考驗粗到細生成能不能處理全域限制。官方成績以完全解出的棋盤比例計,對照組是自回歸模型加上 MDLM、DUO、FMLM+ 三個擴散語言模型。困難題(30 個提示)上 NCM 拿 86.1%,自回歸基線只有 1.0%,MDLM 30.2%、DUO 58.4%,擴散基線中最高的 FMLM+ 是 81.3%;中等難度(35 個提示)NCM 為 96.5%,自回歸只剩 5.1%,MDLM 與 DUO 分別是 77.1% 與 84.7%;簡單題(40 個提示)NCM 99.5%,仍高於全部對照組。自回歸在難題上的崩跌可以從機制理解:輸出一格之後就不能回頭改,前面錯一格,後面全部跟著錯,這是逐詞元生成的結構性代價;能回頭修正的方法天生佔優勢。論文同時註明,NCM 在數獨上用的功能評估次數也比所有對照組少,贏的不只解出比率,連計算效率一起贏。難度上升時每個方法的成績都在掉,NCM 的降幅是五個方法裡最小的。這組結果支持「先建結構再補細節有助於全域規劃」的假設,但數獨有明確的可驗證限制,每行每列每宮都能逐一檢查,開放式推理沒有這種計分方式,仍是另一回事。附錄裡對各層內容的質性觀察(粗層抓全域結構、細層補細節)也只能當輔助證據看,不是量化的結論。
其二是訓練成本:在 LM1B 上,NCM 用的訓練詞元約是比較對象的 4.9 分之一,OpenWebText 約 4 分之一,而且這個口徑把 tokenizer 與生成器兩部分的訓練都計入,不是只算生成階段的帳,量法相對嚴格。要注意詞元量與帳單是兩回事,不同架構每個詞元的運算成本不同,要算實際費用還得計入硬體與訓練時間,官方沒有提供總成本核算。
還有一個介於兩者之間的結果要記下:測試時擴充。研究用最小貝葉斯風險解碼,做法是生成多個候選,再從裡面挑「與其他候選最一致」的那個當輸出,用共識取代單次抽樣的運氣。這種做法任何模型都能用,但 NCM 生成快,在同樣的時間預算裡能生出更多候選,於是在 WMT14 與 XSum 上都拿到更好的分數。速度優勢在這裡被換成品質,這是「快」最實際的用法,也提示了速度數字的另一層意義:快不只省等待,還買到了品質的提升空間。
判斷這類研究新聞可信度時,我第一個會看的是材料能不能重查。NCM 在這點上給得相當完整:GitHub 儲存庫採 MIT 授權,10 月 11 日建立,到 10 月 19 日累積 216 個 stars、最後推送停在 10 月 14 日;Hugging Face 上放了全部已發布模型的權重與 tokenized 資料集,涵蓋 XSum、WMT14 德譯英、數獨三種難度、LM1B 三種尺寸、TinyStories 與 OpenWebText;這個月 Stanford 團隊的另一項開源研究也走了同樣的材料全公開路線,對照之下更像實驗室的固定動作而非個案。倉庫裡的 evaluate.py 一條指令就能跑評測,每個已發布檢查點都附一份相同設定的 yaml 設定檔,下載權重與資料後指名任務即可執行。輸出依任務而異:XSum 是 ROUGE-1/2/L 與生成困惑度;翻譯是大小寫分別計的 sacreBLEU、chrF 與長度比;數獨是棋盤解出率、單格正確率與合法棋盤率;語言建模是在 GPT-2 large 評分下的生成困惑度與單字熵,設定是 5 個種子各 256 個樣本,LM1B 另採 FLM 評分協議;摘要與翻譯還支援分類器無關引導的強度參數。兩個語言建模指標可以順便學起來:生成困惑度是請另一顆較強的模型替生成文字打分,分數愈低代表文字在它眼裡愈自然;單字熵看的是用詞分布的分散程度,防止模型只會重複少數安全的簡單句而不自覺。環境需求是 Python 3.10 以上與支援 CUDA 的 PyTorch,儲存庫也附了 TinyStories、XSum、WMT14 三種樣本逐層精細化的動圖,逐層現形的效果可以直接看;想讀第二份入門說明的話,Stanford 的 Scaling Intelligence 部落格也放了配套文章。
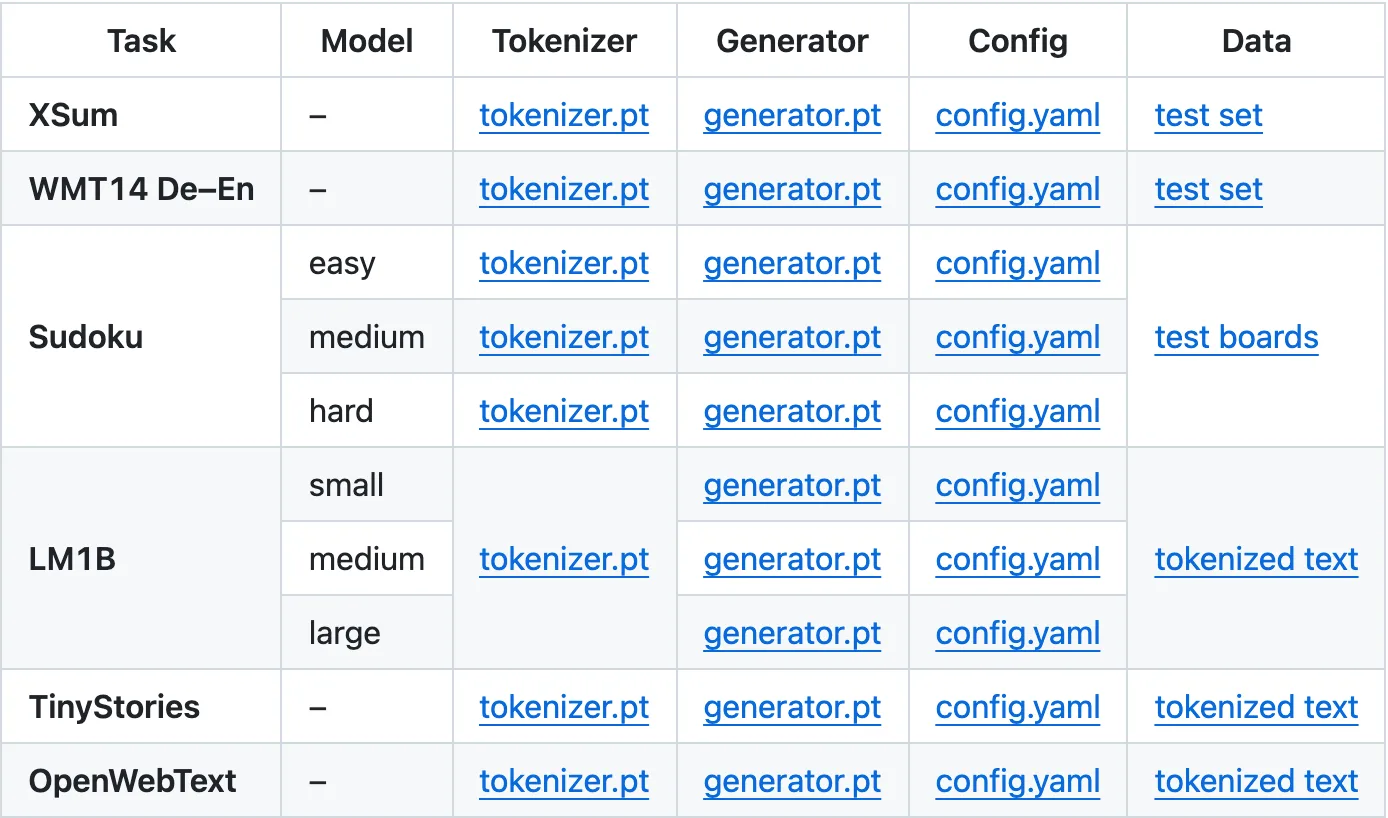
換句話說,前面所有倍率與成績,第三方都能下載同樣的材料自己跑一遍;評測腳本會依看得到的 GPU 數量自動分片再合併結果,多卡環境不用改程式。這不代表結論已經被重複驗證,公開管道至今沒有出現獨立重現結果;它代表的是驗證的門檻已經從「相信作者」降到「花 GPU 時間」。
這份研究自己劃出的邊界,比任何轉述都誠實。更大規模能不能維持優勢,作者列為後續工作,目前的規模實驗是 LM1B 上 9,700 萬、3 億 1,700 萬與 7 億 2,500 萬參數三種生成器,共用同一個凍結 tokenizer,放到今日語言模型的尺度裡都還是小模型;tokenizer 與生成器目前分開訓練,共同訓練是否能再進步也還沒有答案;每段文字現在都走固定層數,依難度動態調整深度是構想而非結果。從機制也能推出一條風險:生成器的目標是 tokenizer 學出來的表示,壓縮端若是把資訊壓丟了,生成端再會選也補不回來,兩階段設計的穩定性是拿凍結換來的。已發布的任務裡也沒有中文,繁體中文的詞元切分與語法會怎麼影響壓縮與還原,需要另外測;而且已釋出的權重全部是任務型模型,涵蓋摘要、翻譯、數獨與語言建模,沒有對話微調版本,拿它直接架一個問答服務的條件並不存在。另外論文仍是 arXiv 預印本,未見同儕審查紀錄。這篇文章的保存期限也由此決定:更大規模的結果、聯合訓練的進展或獨立重現出現時,這些判斷都需要回查;追蹤的具體入口是 GitHub 儲存庫的推送紀錄與 Hugging Face 集合的新檔案,兩者任何一個有動靜,就是回查的訊號。在那之前,這些數字就當單一團隊在受控條件下的證據看。
一般使用者不需要做任何事,這是研究發布,不是產品更新。正在付出推論成本的應用工程師值得記住它的形狀:長輸出、可平行、品質指標可對齊的生成任務,是這條路線目前證明過的範圍,與其他用更少算力換品質的研究指向同一個趨勢,推論成本的下降會先發生在特定任務,再慢慢擴散。手上有摘要或翻譯工作負載的團隊,驗證路徑已經鋪好:從 XSum 的設定檔與已發布權重跑出基準線,換上自己的資料與品質抽樣,再對照牆鐘時間,一個下午就能知道這條路線對自己的任務有沒有意義;算自己的帳時,記得同時量第一個結果出現的時間與整篇完成的時間,兩者對使用者的感受是不同的數字。研究生成架構的團隊則可以直接動手:權重與資料都是現成的,從論文相近的任務開始跑 evaluate.py,再換上自己的品質檢查,是這類速度宣稱唯一可靠的驗證方式。至於「31 倍」這個數字,記得它屬於一個摘要任務、一張顯示卡與一個被對齊的品質指標;把條件一起記下來,這個數字才會替你工作,而不是替標題工作。