TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

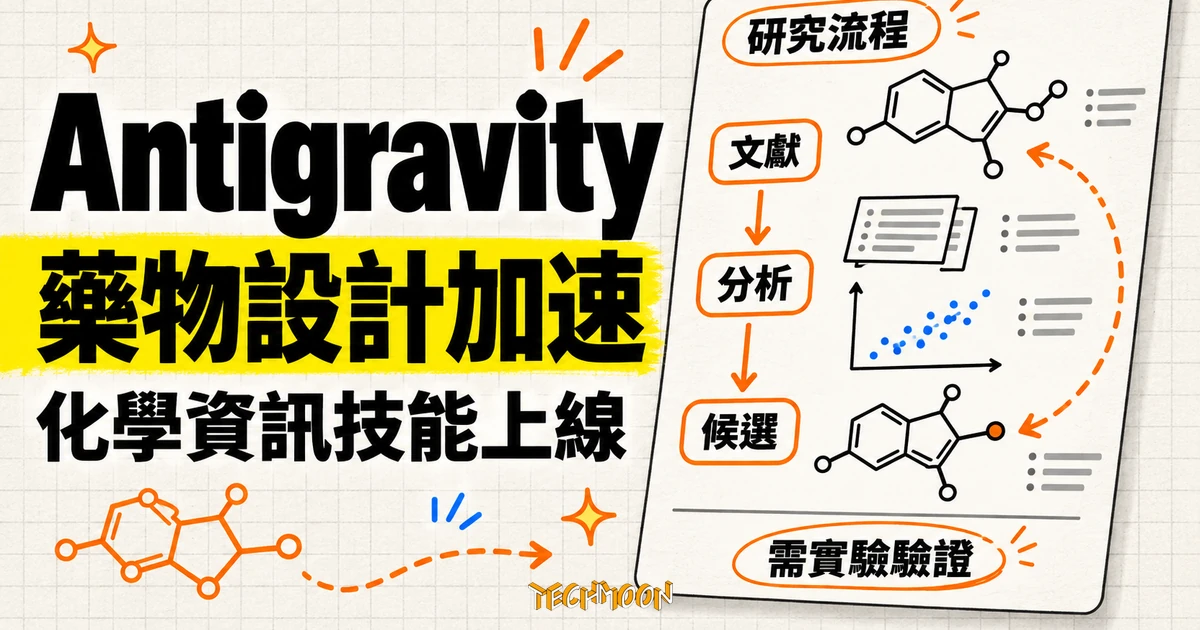
Google DeepMind 於 11 月 3 日在 Antigravity 上線化學資訊技能:以肺癌用藥 crizotinib 的剛性化為示範,官方宣稱代理約一小時走完過去要花多天的文獻檢索、分子配對分析與候選設計循環,分子計算交給 RDKit、ChEMBL 與 PubChem 等確定性工具。本文核對公告內容與開源儲存庫現況,拆解分工設計、可回查性與這條宣稱的邊界。
用 AI 摘要這篇文章:
Google DeepMind 於 11 月 3 日在官方部落格宣布,Antigravity 平台新增化學資訊技能(Cheminformatics Skills),鎖定藥物研究早期的工作流程。官方的示範數字很吸睛:找一款肺癌用藥的改良版,過去即使對有經驗的研究者,一輪文獻搜尋、資料整理到候選分子設計通常要花上多天,現在代理約一小時就能走完同一個循環。
不過這條新聞裡真正值得記住的,或許不是速度。官方把工作切成一種很少見的分工:語言模型只負責排工作、查資料庫、理解研究需求,絕大多數真正的分子計算都交給確定性工具去做。這個設計決定了結果能不能被檢查,也決定了「一小時」三個字能被信任到什麼程度。速度會隨模型升級不斷改寫,分工與可回查性才是這次更新留在流程裡的東西。
官方挑的示範題目是肺癌用藥 crizotinib 的改良。這款藥屬於第一代酪氨酸激酶抑制劑(TKI),用於治療特定類型的非小細胞肺癌。公告描述,crizotinib 分子上有五個主要可旋轉鍵,意思是它構形相當自由。分子越自由,跟目標結合時要付出的形狀代價越大,因為原本能隨意轉動的部分,結合後就被固定住了。藥物化學家因此長期研究能不能預先把分子「整理」成接近結合時的形狀,其中一種做法叫剛性化(rigidification),用環化把分子活動的部分扣起來。後來的第三代 TKI 藥物 lorlatinib 正是沿這條路線,把 crizotinib 一段柔軟區域環化,有效可旋轉鍵降到零,官方文件寫到這帶來更高的活性等效果。
這個題目的好處,是趨勢已知、文獻豐富,示範等於在研究者熟悉的路上重走一遍。流程是這樣展開的:代理先花幾分鐘從科學文獻撈出數千個相關化合物跟實驗資料,順手過濾掉緩衝液、溶劑這類跟藥物無關的材料;接著把資料整理成可互動的檢視器,例如把活性對上可旋轉鍵數量畫成散布圖,再用有沒有大環結構區分顏色。公告提到兩個觀察:跟 lorlatinib 同類的大環分子傾向有更少的可旋轉鍵與更高的活性,而最剛性的化合物往往活性最好。檢視器裡每個資料點都能點開,連回它的原始出處。
再來是配對分子分析(matched molecular pairs analysis):挑出只差一個小結構改動的分子對,比較彼此活性,把「環化」這個單一變因的效果獨立出來。這個方法解決的是化學資料的老問題,不同實驗、不同條件的活性數值放在一起比,雜訊太多;只比「同一個家族裡差一個小改動」的分子對,變因就單純得多。結果符合預期,環化減少可旋轉鍵,活性普遍上升。
建模之後才輪到設計。代理提出一組候選大環分子,每個都附上設計理由、前驅物與完整合成路線,畫出電子推移箭頭圖(electron-pushing diagram,化學家用來描述反應過程中電子怎麼移動的標準畫法),回頭查公開資料庫裡的相似反應來佐證每條路線的可行性,再用剛訓練的模型預測每個候選的活性。公告特別強調反應表示會被檢查有效性,讓化學家審提案時有具體材料可以對。成品可以匯出成業界標準化學軟體吃得下去的格式,也可以直接交給 AlphaFold 或分子動力學工具做後續分析。
要注意這些細節全部來自官方的單方敘述。Google 沒有提供第三方重現的紀錄,一小時的計時方式、代理中途被人工糾正幾次,公告都沒有寫。把它當採購依據之前,值得先用自己的題目跑一輪對照。
整份公告裡最值得停下來讀的一段,是官方對分工的說明:語言模型適合編排流程、導航資料庫、做科學推理;分子計算這種事,交給專門工具。化學技能建立在開源工具套件 RDKit 之上,並透過連接器接上 ChEMBL 與 PubChem 兩個化學研究常用的公開資料庫,前者收錄分子的生物活性量測,後者收錄大量化合物資訊。用官方的話說,這種分工讓結果更可預測,讓代理有機會交叉檢查中間結果、自己抓自己的錯,也讓輸出更容易解讀。
換句話說,模型不假裝自己會算化學。同樣的輸入丟給 RDKit 會得到同樣的輸出,這件事跟模型會不會幻覺無關,因為分子計算這一段不經過模型。模型犯錯的空間被壓縮到「排錯工作、查錯資料」這一層,而這一層的錯,研究者有機會從中間產物看出來。這跟不少打著科學旗號的代理工具走的方向剛好相反,把最需要精確的部分交給概率性的文字生成,出錯時連作者自己都難以定位。
Antigravity 本身的定位也值得知道。官方對它的描述是「以代理為先的開發環境」,也就是整個介面圍繞著讓代理排程、呼叫工具來設計,而不是讓人逐步操作。稍早 Google 展示過同一平台用自訂技能在 59 分鐘內把 Fortran 海洋模型核心搬進 Rust,當時的主角是工程驗收設計;這次換成化學研究,骨架裡的邏輯是同一套,讓代理跑,但把判斷點留在看得到的地方。
這套可回查性有幾個具體設計。代理產出的報告會記錄每一筆資料的來源,資料整理的每個決定都留下可重現的軌跡,報告並對每個設計提案附上風險評估。代理會依研究者給的條件建議下一步路線,但使用者隨時可以插手改方向,不是按下執行就一路到底。一個例子:示範中代理提出的大環候選,多數被預測可以穿透血腦屏障(肺癌常見的轉移部位之一是腦部),但報告同時標註這是計算模型的預測,必須實驗驗證。速度宣稱可以被行銷話術包裝,「每個點連回原始出處」這種設計很難造假,因為它邀請讀者回去查。
在建模這段,技能也把方法論細節做成引導:化合物有時間戳時,用時間切分(chronological split),拿較舊的化合物訓練、預測較新的,貼近真實研究裡手上只有舊資料的情境;沒有時間資訊就退回骨架切分(scaffold split),把核心結構不同的化合物分到不同集合,避免測試集裡混進跟訓練資料長得太像的分子、讓分數虛高。官方示範用骨架切分,對四種實驗讀值評測了多種機器學習架構。切分方式跟分數要放在一起讀,同一個模型換一種切法,數字可能差一截,講的是不同層面的泛化能力。
願意在發布當天寫清楚限制,是這份公告相對誠實的地方。官方明講:資料稀少、實驗室之間的量測差異、數值分布過窄,都會限制這些預測模型的精度。產出的候選分子是「可檢驗的假說」,不是藥。每一個提案都必須被合成出來、送進實驗驗證,這段路沒有因為一小時而變短。
範圍上,官方也說得保守:同樣的化學技能適用於任何小分子研究,從農用化學品到材料科學,但示範只做了一個案例。分子動力學模擬、量子化學等領域,官方的寫法是「正在擴展」,還沒上線。上一個月的示範是抗菌肽,從最初查詢到候選設計在 30 分鐘內完成,可以看出 Google 把這類科學技能當成一條產品線在經營,化學資訊只是最新一站。
回頭看整條證據鏈,其實每一環都是計算:文獻趨勢支持剛性化、配對分析支持環化、模型預測候選活性、另一組模型預測腦穿透。計算能做的是把「哪些候選值得做」排出先後次序,「做了之後會怎樣」,答案仍在實驗那邊。公告把這條線畫在「假說」與「藥物」之間,算是替這類工具立了一個還不錯的示範。
對研究者來說,這些界線換算成一個實際問題:一小時的產出能不能直接接上自己實驗室既有的驗證流程。官方的答案藏在報告設計裡,來源、軌跡、風險評估都是為了讓下一輪實驗可以直接開跑,而不是讓計算結果直接變成結論。
Antigravity 本體是閉源桌面應用,但 Science plugin 對應的技能庫 google-deepmind/science-skills 在 GitHub 上以 Apache-2.0 授權公開,儲存庫在 5 月建立,一路迭代到現在。我翻了這個儲存庫的現況:目前有 40 個技能目錄,內容多半是資料庫連接器與文獻搜尋,跟化學直接相關的是 chembl_database 與 pubchem_database 兩個連接器,前者文件裡提到 SDF 分子檔可以交給 RDKit 處理、渲染引擎預設也是 rdkit。
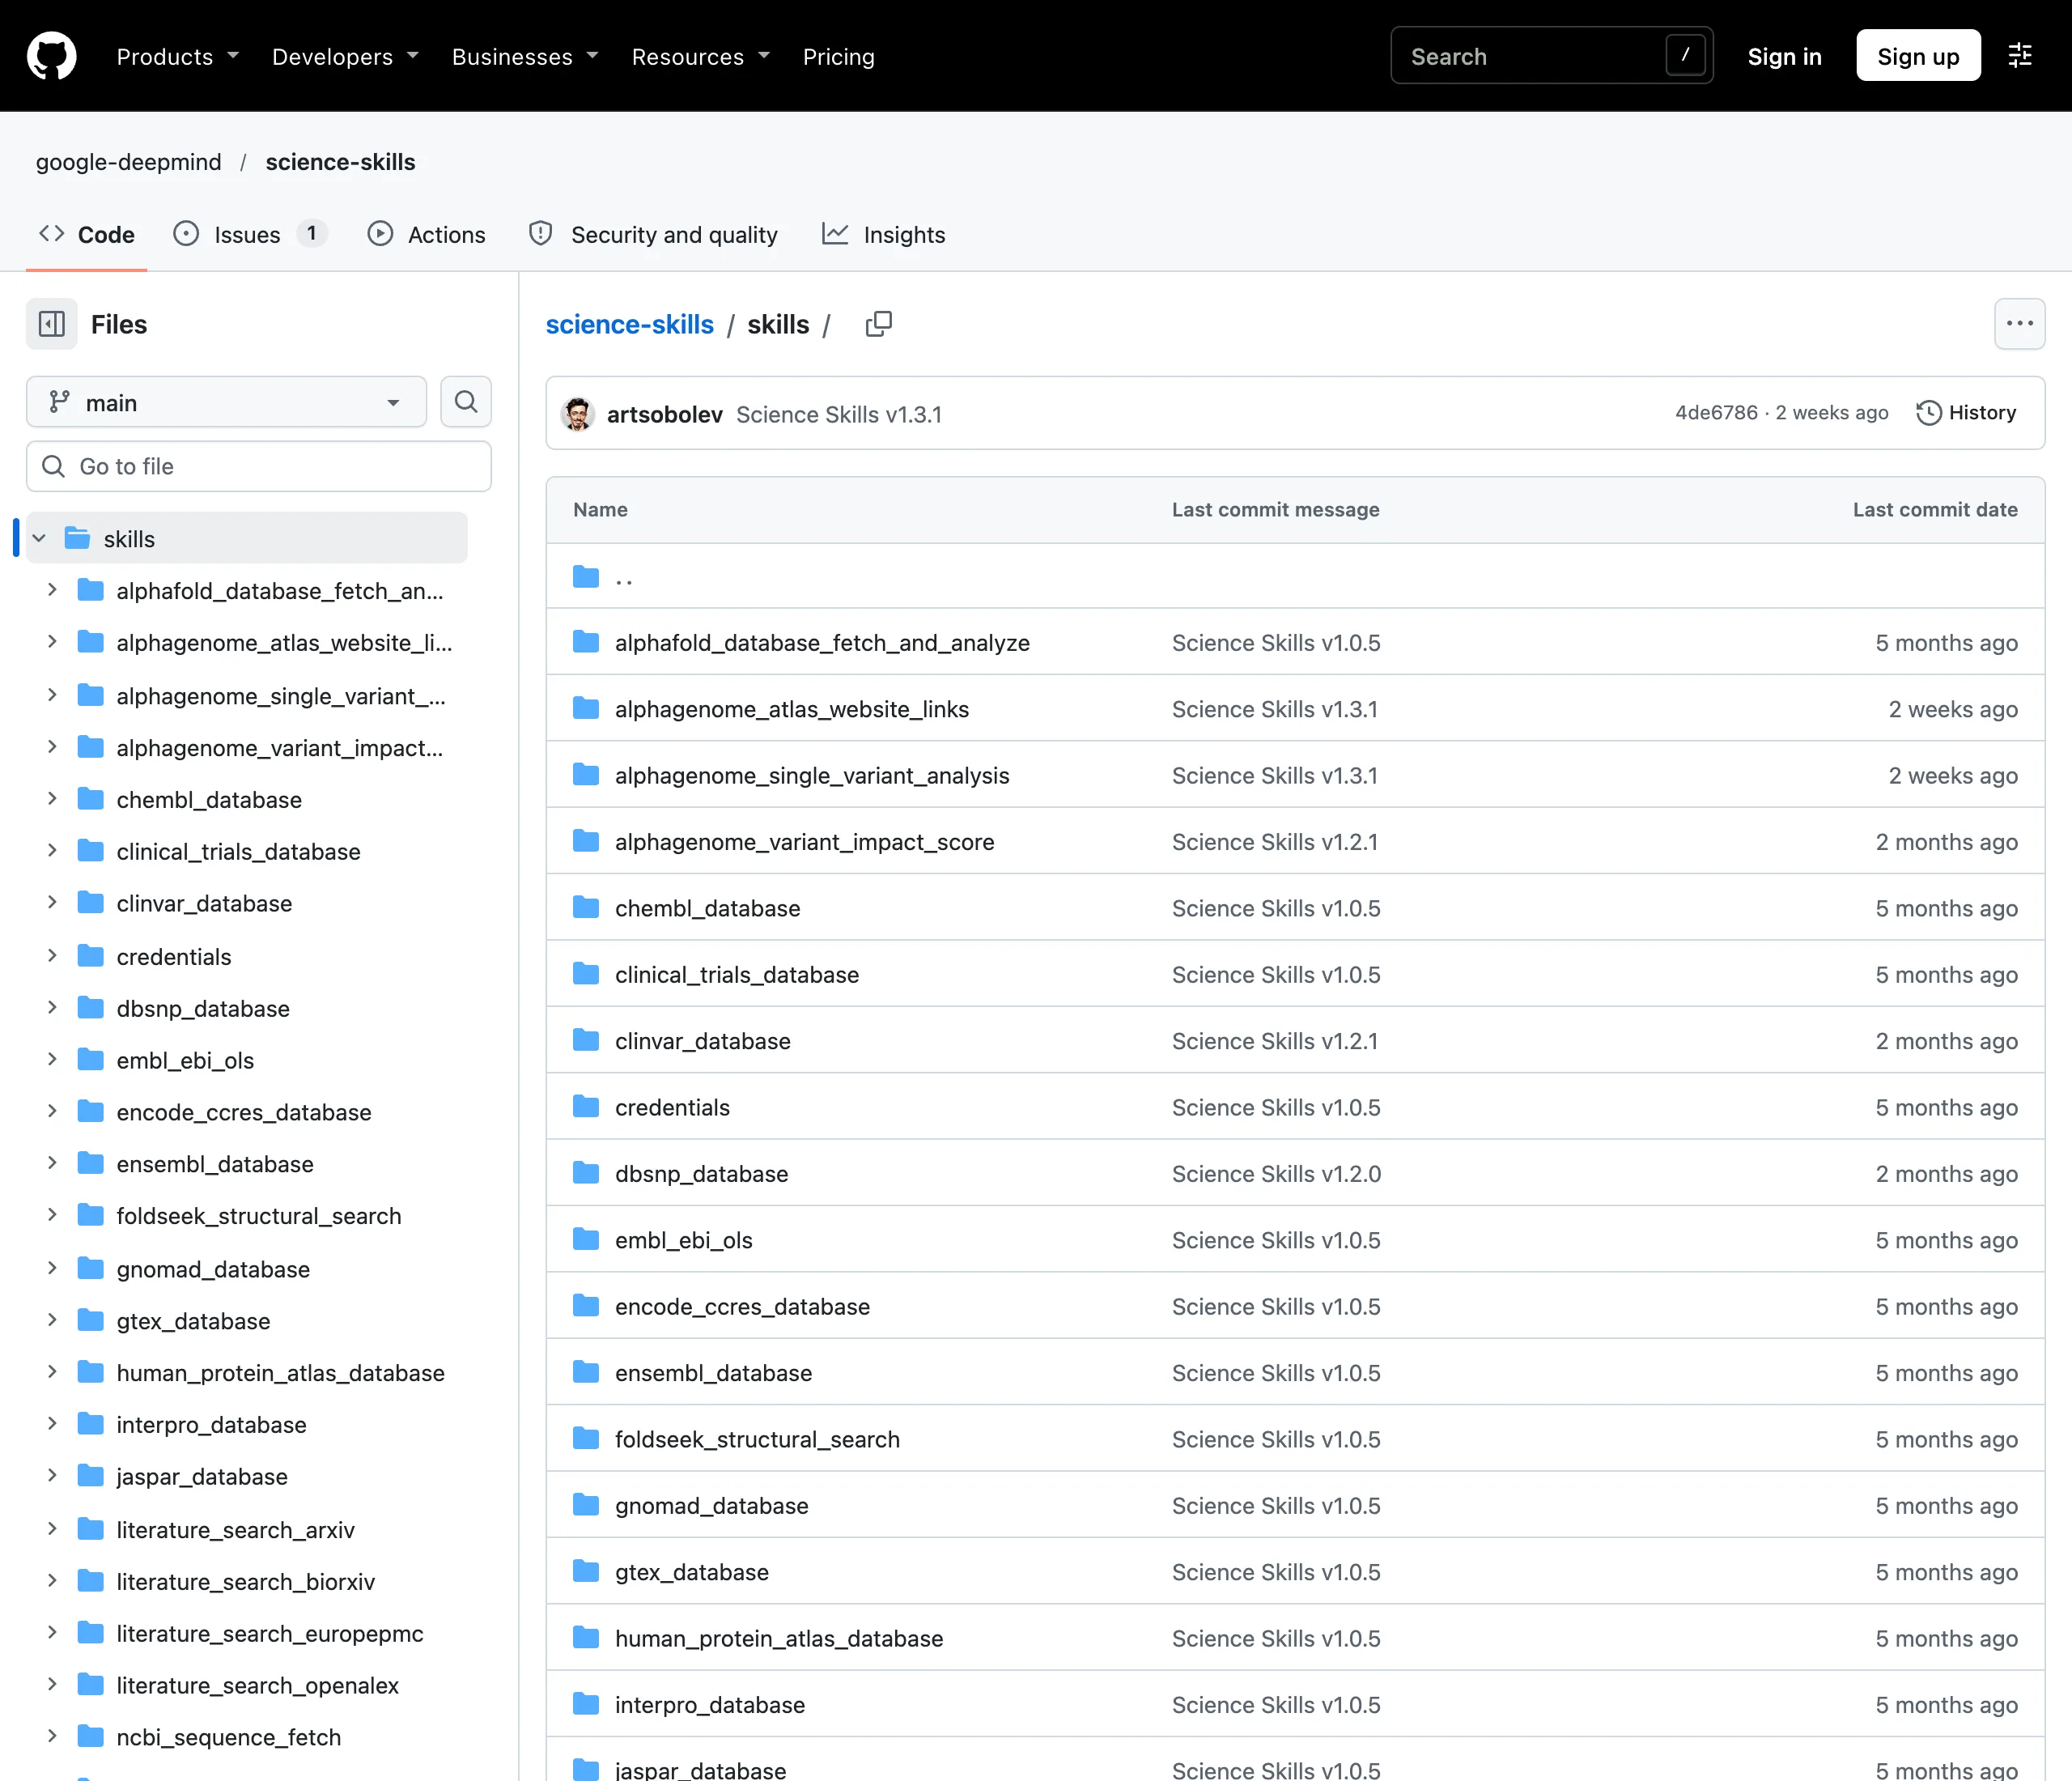
值得注意的是,公告主打的這套化學資訊工作流,在公開儲存庫裡沒有對應的技能目錄。儲存庫最後一次版本更新停在 10 月 23 日的 v1.3.1,早於 11 月 3 日的公告。這不影響技能在應用內可用,官方也沒有承諾開源這部分,但它劃出一條清楚的線:資料層的連接器可以核對,工作流層的編排邏輯目前核對不到。想確認「代理到底怎麼決定下一步」的研究者,現階段只能依賴應用內報告的軌跡紀錄。這條缺口值得盯著:如果之後儲存庫補上對應目錄,這套技能的可驗證性會往前一大步。
這也不是 Google 第一次在「公告與儲存庫同步」上出現時間差,稍早的 Elephant-Goldfish 外掛也出現過公告與儲存庫進度不同步的情況。對依賴開源元件的研究團隊來說,盯緊兩邊的落差是必要功課。
化學技能已隨 Antigravity 上線,並支援 Gemini CLI。使用路徑是下載 Antigravity 應用程式,從內建的 Customizations 市集安裝 Science plugin;企業用戶可以在登入時選「Use Business Account」,用 Google Cloud 憑證存取。
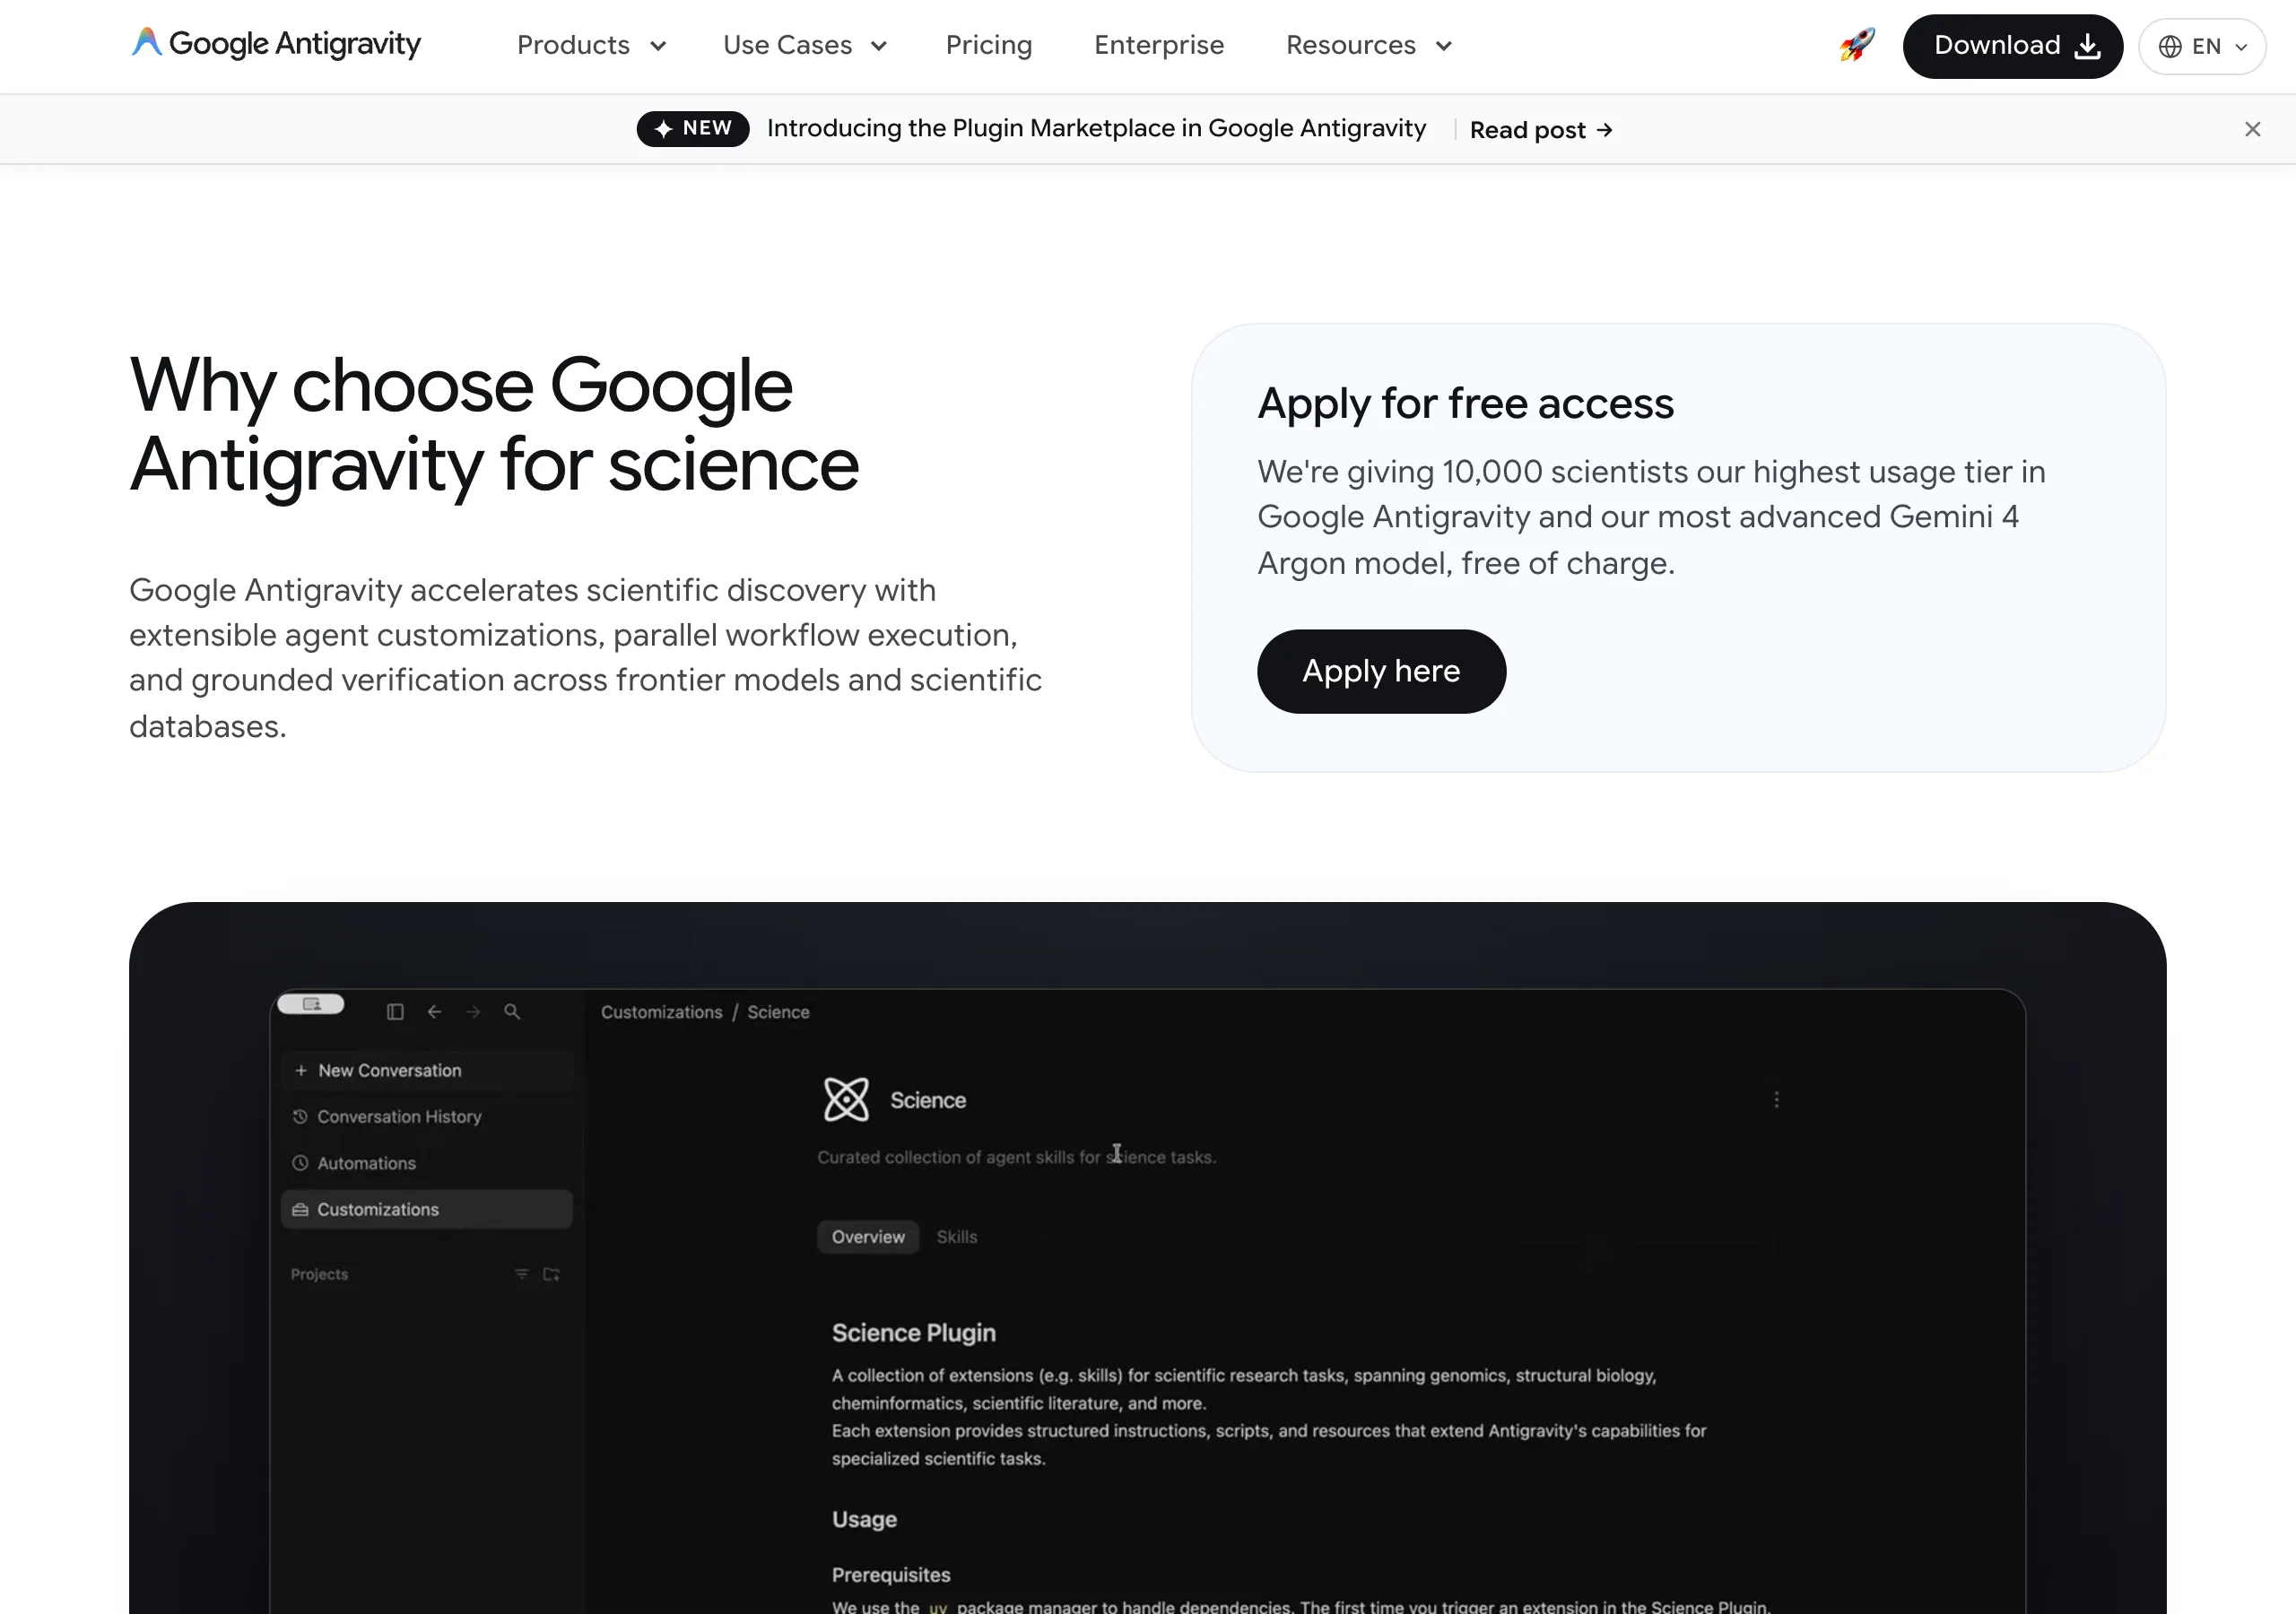
另一個入口是官方的科學家支援方案:Google 開放一萬個名額,獲選者免費使用六個月最高使用級別,Antigravity 的科學頁面載明這包含最先進的 Gemini 4 Argon 模型,採滾動錄取,並有資格、容量與遴選條件。名額數字聽起來大,但「最高級別加旗艦模型免費半年」對學術實驗室的成本結構是有感的數字,值得有計畫的團隊送件。同樣鎖定學術圈的還有 OpenAI 的 Rosalind 學術補助,兩邊都在用資源換研究場域的實測回饋;已經在用其他科研代理工作區的團隊,也可以把同一個題目丟進 Antigravity 做對照。
回到開頭的判斷:一小時的宣稱需要自己的案例才能檢驗,但分工設計與可回查性已經可以從文件判讀。已有化學專業與驗證流程的團隊,最穩的起手式是拿一個自己熟悉的分子系列重跑一次,看代理整理的資料能不能通過自家標準,這比相信任何示範影片都準。兩週後值得回頭看兩件事:儲存庫是否補上化學工作流的目錄,以及一萬個名額的實際錄取狀況。