TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

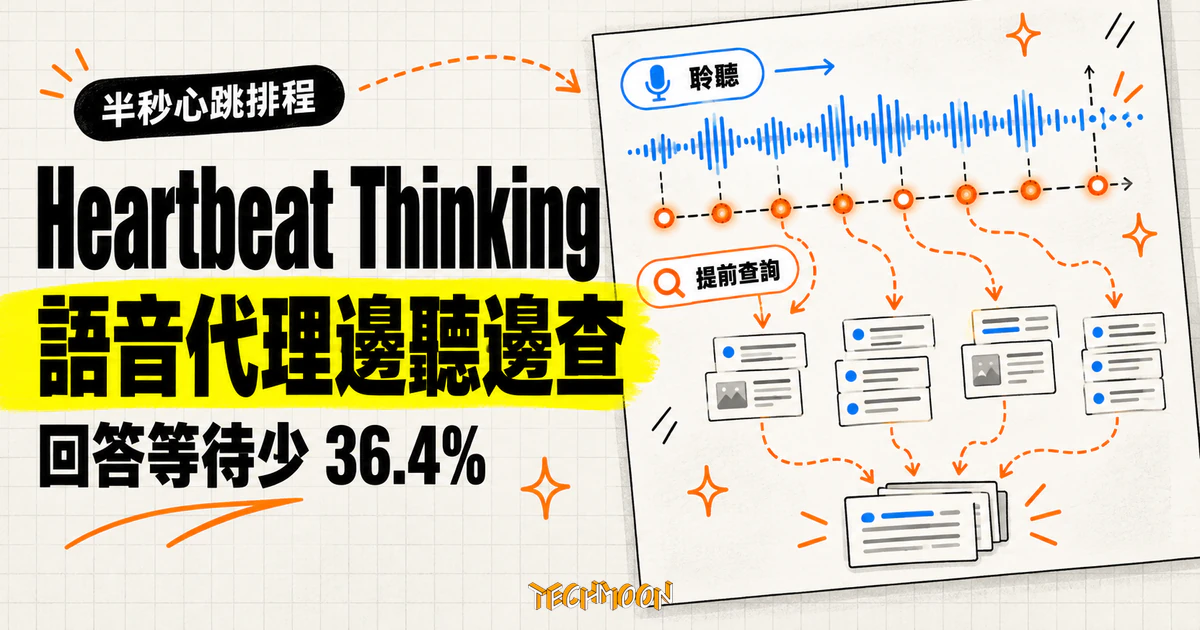
Ant International 研究團隊 2026 年 10 月 19 日在 arXiv 提出 Heartbeat Thinking:語音代理每 500 毫秒讀一次講到一半的逐字稿,提前發起查詢,新語音進來也不打斷已在跑的推理與工具。FDBench v3 上最終回答等待從 6.90 秒降到 4.39 秒(少 36.4%)、投機工具覆蓋率多 16 個百分點,但三個基準只有一個正確率上升,AudioCRAG 覆蓋率漲為三倍、正確率卻是五個系統最低。本文核對排程機制、完整數字與採用前該先量的指標。
用 AI 摘要這篇文章:
叫 AI 助理查一筆訂單,它偏要等你把話說完才開始動作。這是多數語音代理現在的預設行為:理解、查資料、回答全部串在一句話結束之後,使用者換來好幾秒的安靜。Ant International 的研究團隊在 2026 年 10 月 19 日把論文 Heartbeat Thinking: Speculative Reasoning and Tool Execution While Listening in Realtime Voice Agents 放上 arXiv(編號 2610.26233,全文以 CC BY 4.0 授權),挑的就是這段等待:讓代理在你還在說話時,就定時讀取講到一半的逐字稿,提前發起查詢,而且新語音進來時不打斷已經在跑的推理。七位作者全數隸屬 Ant International,這是企業研究團隊的方法論文,不是產品公告。
結果先講。在 FDBench v3 基準上,最終回答的平均等待從 6.90 秒降到 4.39 秒,少了 36.4%,也比測試中最快的級聯式系統 Pipecat(8.08 秒)低了 45.7%。但正確率並未全面上揚:三個基準裡只有 FDBench 的任務品質上升,另外兩個微降;其中一個基準的檢索覆蓋率漲超過原本的三倍,正確率卻是五個受測系統裡最低的。等待變短是真的,答案會不會變好取決於任務型態,這是論文摘要自己寫明的結論(benchmark-dependent)。
級聯式管線裡,語音辨識雖然邊聽邊產出逐字稿,後面的理解、工具呼叫與回答卻要等說話結束才依序開跑。論文測的三個級聯系統,最終回答平均落在 8.08 到 8.52 秒:Speech-to-Speech 是 8.39 秒,Pipecat 8.08 秒,LiveKit 8.52 秒。這三個都是現實中拿得到的組合:Pipecat 與 LiveKit 是開源的語音代理框架,Speech-to-Speech 是 Hugging Face 的開源專案,用開源模型組出端對端路線,論文拿它們當「你現在會怎麼做」的對照。原因不難理解:使用者說「幫我查訂單 12345 的出貨狀態」,前半句其實已經足夠發起查詢,系統卻把動作硬押到最後一個字之後。
要提前動作,既有做法分成兩類,論文直指它們共同的毛病。以語音區塊為界的生成,遇到新逐字稿就重來一遍;中斷式更新則直接砍掉正在跑的推理。兩者都可能把一個工具呼叫攔腰截斷,參數還沒生成就整個作廢,先前算掉的等於白算。計算時間被綁死在語音更新的節奏上,能提前完成的工作量自然有限。
論文的主要對照組是 SHANKS 風格的視窗思考(Window Thinking):照同樣的節奏觸發推理,但視窗關閉後才回來的結果一律丟棄。Heartbeat Thinking 的契約剛好相反:新的逐字稿進來,已經在跑的推理與已經派出的工具呼叫照樣跑完。語音更新從一道截止線,降級成單純的新資訊。
機制上,系統每 500 毫秒發動一次思考模型(論文稱 Thinker)的呼叫,最多容許兩個併發;名額滿了就跳過該次觸發,不排隊也不搶佔。每次發動讀兩樣東西:最新的部分逐字稿,加上一份記錄了已完成推理與工具結果的共享清單。思考模型可以決定不動作、只回一段推理,或帶著結構化參數發起工具呼叫;推理會先寫進共享清單,工具再以非同步方式派出,所以模型運算和工具執行得以重疊。後續發動可以拿前一次回來的結果補齊缺少的參數、接著發出依賴式呼叫;提示詞也明確要求,不要重複名稱與參數完全相同的待處理或已完成呼叫。
拿訂購流程想一遍這條規則的價值:使用者先唸出訂單編號,思考模型就能先查訂單;使用者後來補上「要改成送到公司」,下一次心跳讀到新逐字稿,新一輪發動去查地址規則,而前面那筆已經回來的訂單內容原地可用,不必重查。要是使用者中途改口換了訂單編號,舊查詢的結果只是留在清單裡不被採用,新的查詢照常出發,兩邊互不攔截。
要注意的是,思考模型讀的是文字逐字稿,不是聲音本身。語音代理該不該只看逐字稿、放掉聲音裡的其他線索,是另一條還在進行的爭論,這篇論文並沒有處理那一層。
實驗設定方面,論文用 Qwen3.6-35B-A3B 當思考模型,DeepSeek-V4-Flash(0731 版)當負責最終開口的應答模型(Responder),這個模型家族的後續版本我們先前介紹過。整套實驗跑在 NVIDIA H200 上;語音端採用 Qwen3-ASR-1.7B 搭配 Qwen3-TTS,辨識更新區塊同樣是 500 毫秒,與心跳間隔一致。
覆蓋率怎麼算,論文給了嚴格定義:投機工具覆蓋率(STC)衡量基準參考答案裡該有的工具呼叫,有多少已被提前完成、結果確實進到應答模型的上下文,而且應答模型不必重複呼叫。提前算了卻被丟掉,或答話時又重呼叫一次,都不算數。這比「系統有沒有一直在運算」嚴格得多,也是後面取捨討論的基礎。
偵測到說話結束,排程器停發新的思考呼叫,並取消所有還沒跑完的推理與投機工具任務,包括還在佇列裡的。應答模型拿到最終逐字稿、對話歷史、工具定義,加上組裝上下文那一刻的已完成準備快照;更晚回來的投機結果一律丟棄。它接著用 ReAct 流程,把這些準備對照完整請求檢查一遍:被後續話語推翻的解讀拒用,可用的結果直接重用,缺的呼叫在自己的流程裡補做。因為該做的都做了取捨,它不必等任何未完成的準備。
換句話說,提前計算有機會白費。使用者改口、補上條件,或者思考模型一開始就猜錯方向,那些已經跑完的查詢就是純成本。論文並沒有附上每通對話多耗多少運算的帳,這是任何團隊採用前要自己算的數字。
FDBench v3 專門測帶著停頓、改口這類真實說話雜訊的場景,這組有 100 段錄音、79 個情境、12 位說話者。延遲以每段對齊後的說話結束點為基準量測,句尾的純靜音不計入;事件先在每段錄音內平均,再讓每段錄音等權彙總,發生在說話結束前的以負值保留。Heartbeat 的正確工具呼叫平均在說話結束前 4.37 秒就發起,視窗思考是結束前 2.74 秒,三個級聯系統則落在結束後 2.45 到 3.52 秒才起步。最終回答的起點(排除先前的應聲招呼)平均 4.39 秒,對照視窗思考 6.90 秒、Pipecat 8.08 秒。投機工具覆蓋率從 34.67% 升到 50.67%,多了 16 個百分點,而且換用三種應答模型(DeepSeek-V4-Flash、Qwen3.5-397B-A17B、Qwen3.8-Flash-Next)重測,這個優勢都保持著。
放回產品脈絡看,4.39 秒仍說不上快。同樣講求即時的語音翻譯,早就把延遲壓到兩秒多當賣點;語音代理的回答等待要追上那個體感標準,還有一段路。
三個基準給出三種結局。SpeechFCEval 測語音函式呼叫,1,914 個樣本取自 ACEBench、BFCL 與 SmartInteract 五個任務組,正確率要求函式名稱與參數都對:視窗思考拿 67.95 分,Heartbeat 66.85 分,微降;但兩者都遠高於級聯系統的 52.85 到 58.66 分,提前準備在這個基準對正確率是加分。FDBench v3 的品質分從 72.0 升到 77.0,Pass@1 從 57.0 升到 65.0;不過完全不做事前計算的 Speech-to-Speech 拿 84.0,是五系統主對照裡的最高分。
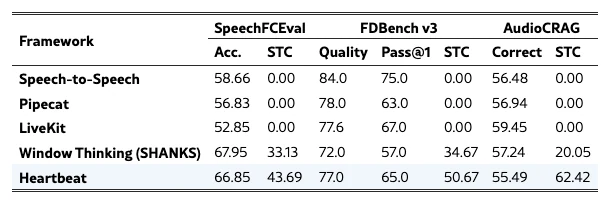
最反直覺的結果出現在 AudioCRAG。這個 1,312 個樣本的知識接地問答基準上,Heartbeat 的覆蓋率從 20.05% 衝到 62.42%,超過原本的三倍;正確率卻從 57.24 掉到 55.49,在五個受測系統裡墊底,低於視窗思考的 57.24,也低於 LiveKit 的 59.45。查得又早又多的系統,答案反而更不準。附帶一提,AudioCRAG 的覆蓋率定義跟前兩個基準不同,量的是「有多少樣本直接重用已完成的事前檢索、不必再查」;換句話說,六成以上的問題在說話結束前就已經拿到資料,答案的品質卻往另一個方向走。論文在分析裡自己補了一筆:FDBench 有 4.0% 的錄音,工具呼叫的參數完全正確,答案卻採用了錯誤或過時的結果。呼叫發得對不對,和結果用得對不對,是兩件事,後者正在變成新的瓶頸。
思考模型的選擇也在發揮作用。附錄的對照實驗把 Thinker 換人:Gemma-4-26B-A4B-it 在 SpeechFCEval 拿 68.58,反超視窗思考的 67.95;換成 Qwen3.5-9B 就只剩 59.05。排程讓可用的準備變多,準備的品質終究還是模型在決定。對想導入的團隊,這組對照的意義在於:排程層的改善要配上夠強的思考模型與夠謹慎的結果採用規則,只換任何一層都吃不到全部的好處。
Heartbeat 採用固定的 500 毫秒間隔與固定的併發上限,作者明說還沒探索依逐字稿變化或工具完成事件動態調整的自適應排程,而那種排程有機會在新資訊不多時少做白工。應答模型拿到的是組裝當下的快照,晚於組裝回來的工具結果直接被丟棄,執行時間變動大的工具特別吃虧;論文把晚期結果的增量遞送列為未來工作。延遲分析也只在 FDBench v3 上做過,換成其他工具負載會怎麼樣,目前沒有答案。
工程面還有兩個現實限制。論文沒有釋出程式碼或專案頁,全文出現的 GitHub 連結全部指向基準資料集與引用框架,所有數字只能回對論文裡的表格,無法自行重跑驗證。實驗又跑在 NVIDIA H200 上,半秒一次的思考呼叫加上最多兩路併發,放到高流量的生產環境,成本需要先試算。要追蹤後續也不難:這是 2026 年 10 月 19 日上線的 arXiv v1,值得隔一兩週看作者有沒有釋出 v2 或補上程式碼。
正在自建帶工具呼叫的語音代理、而且還停在級聯架構的團隊,是這篇論文最直接的讀者:從 8 秒級等待降到 4 秒級的降幅來自排程結構而非模型差異:主對照裡五個系統用的是同一套應答模型,而且整套機制用現成模型就能組出來。任務型態偏檢索問答的團隊要留意 AudioCRAG 的反例,導入前先量「結果被正確採用」的比例,而不只是提前完成的呼叫數。用託管語音代理服務的產品團隊短期不必動作,這是排程層的研究,離產品化還有距離。還要記得這套機制只對帶工具呼叫的代理有意義;若產品的語音互動以閒聊或固定回覆為主,聆聽期間沒有可提前的查詢,心跳排程只會多燒運算。至於一般使用者,能做的只有等,而這篇研究正是想把那段等待縮短。