TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

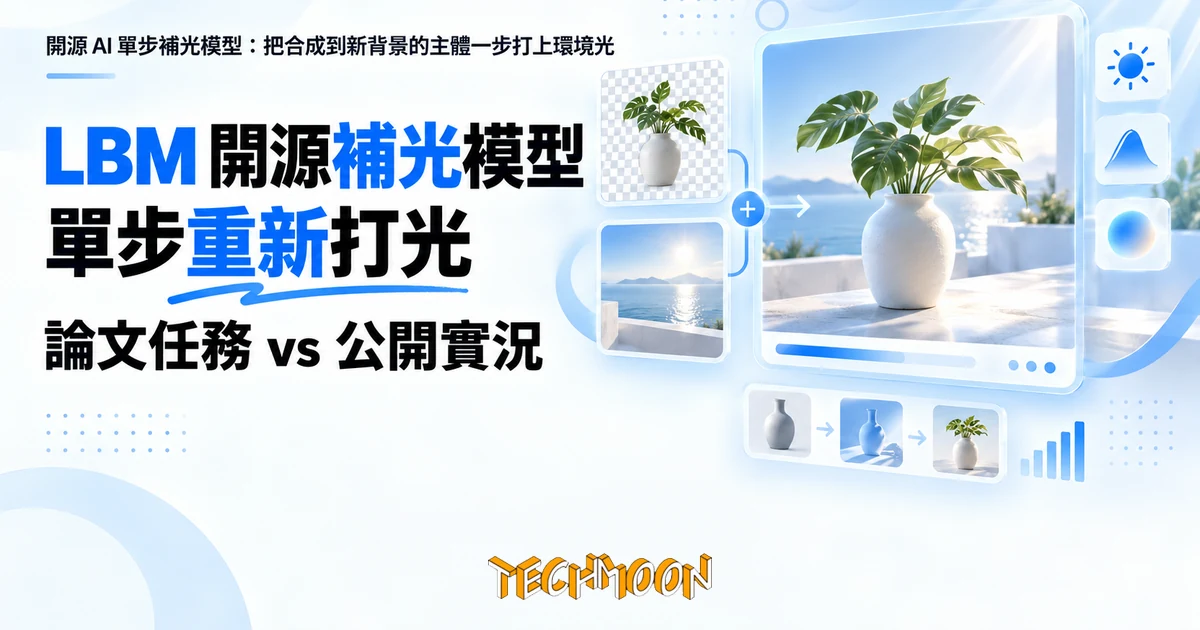
LBM(Latent Bridge Matching)是 Jasper 研究團隊開源、登上 ICCV 2025 的單步影像翻譯模型。實測它的免費線上 demo:上傳前景與背景,自動摳圖加補光,5 秒拿回環境光協調的合成照。文中同步對帳論文六種任務與實際公開的 demo、權重清單,說明流傳的「一鍵去除干擾對象」目前沒有對應的公開功能,並整理 CC BY-NC 4.0 授權限制與自架 5GB 權重的成本。
用 AI 摘要這篇文章:
我把一朵官方範例裡的粉白色非洲菊,跟一張昏暗餐廳的背景照一起送上 LBM 的線上 demo,5 秒後拿回一張被環境光重新打過的合成照。原圖裡那朵花像從攝影棚的燈箱裡剪下來直接貼上去,白得發亮、跟背景完全不講同一種光線;處理完之後,花瓣染上了餐廳的暖琥珀色調,靠窗那一側亮、背光那一側暗,連花莖都沉進了陰影裡。這是 LBM(Latent Bridge Matching)在做的核心工作:把你合成到新背景上的主體,一步重新打光。
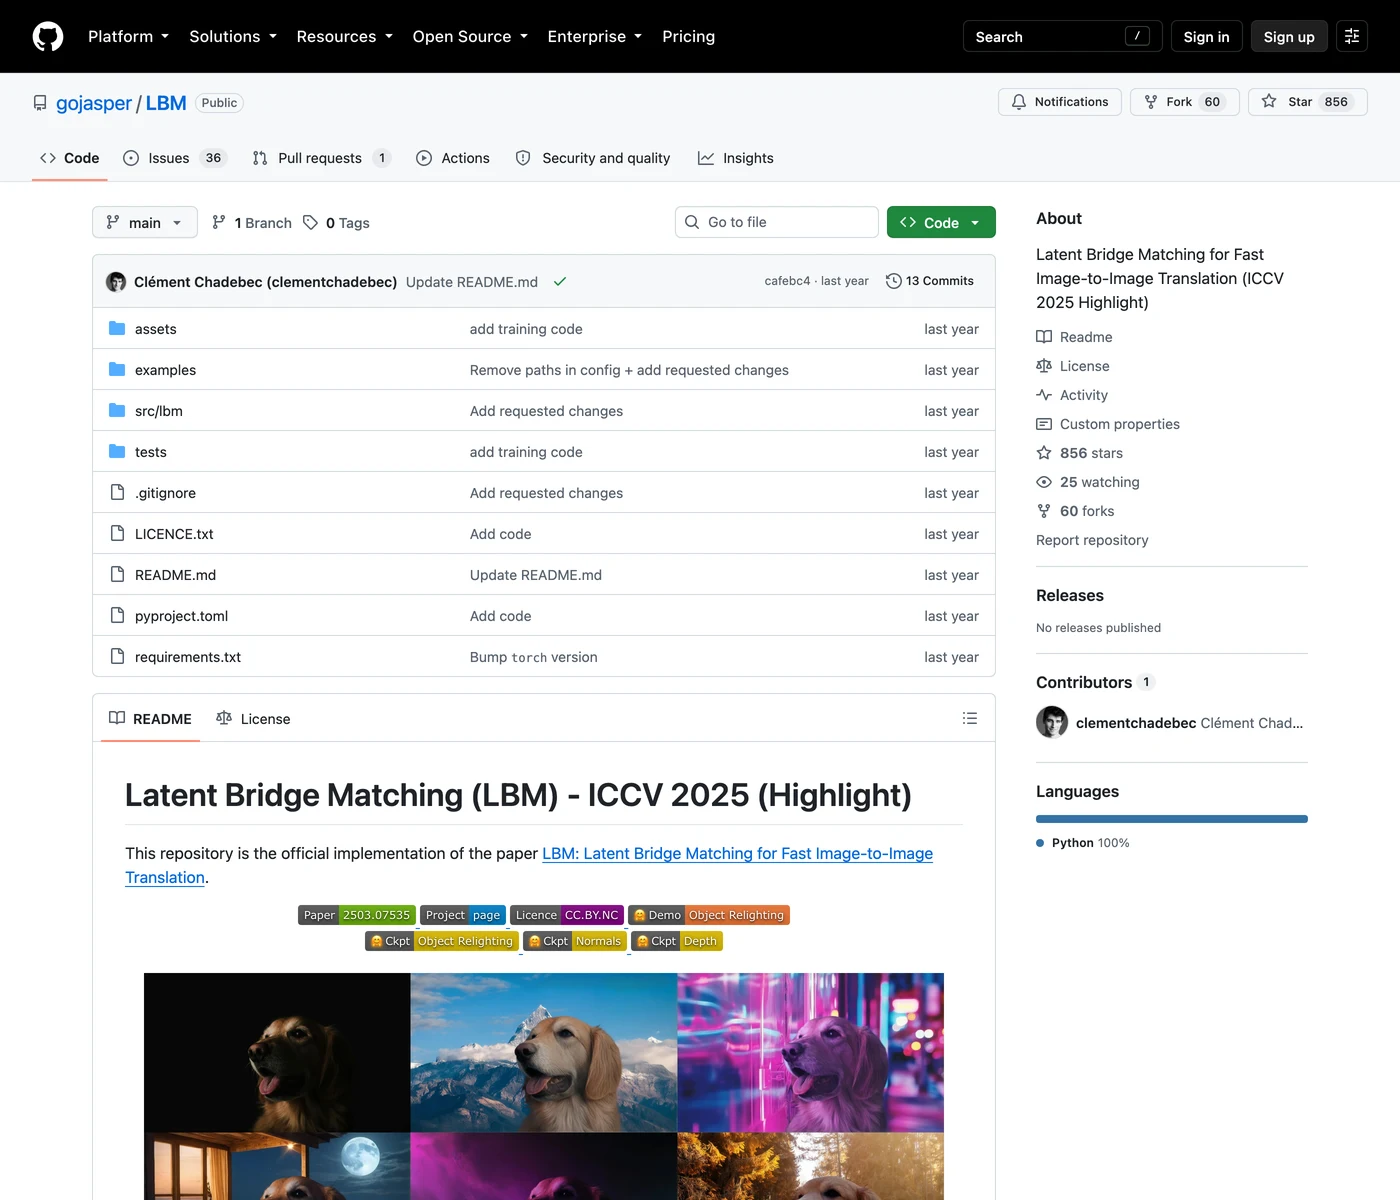
這個模型 2025 年 3 月由 Jasper 的研究團隊(gojasper)開源,論文登上 ICCV 2025,GitHub 上累積 856 顆星。Jasper 這家公司本業是 AI 寫作工具,研究部門跨足影像翻譯,論文作者是 Clément Chadebec 帶的四人小組。不過在動手玩之前,有一件事值得先講清楚:中文圈流傳的介紹多半用「一鍵去除干擾對象、智能調控光照」當標題,聽起來像一套完整的修圖工具。實際把它的公開發布面全部清點一遍之後,畫面不太一樣。官方宣稱驗證的影像翻譯任務有六種,但對外公開的線上 demo 只有一個,做的是物體補光;標題裡最吸睛的「去除干擾對象」,連模型權重都沒有放出來。
先把能用的部分用好,再決定要不要期待其他部分,這篇文章就照這個順序走。
LBM 的線上 demo 放在 Hugging Face Space 上,免註冊免安裝,打開就能用,頁面累積了 400 多個讚。介面很簡單:左邊兩個上傳框,一個放主體(前景)、一個放目標背景,按一下 Relight 按鈕,右邊就會回傳一張前後對照的滑桿圖。頁面下方還有一排官方準備的背景圖庫,點一下就能載入當背景,懶得自己找圖的時候很方便。
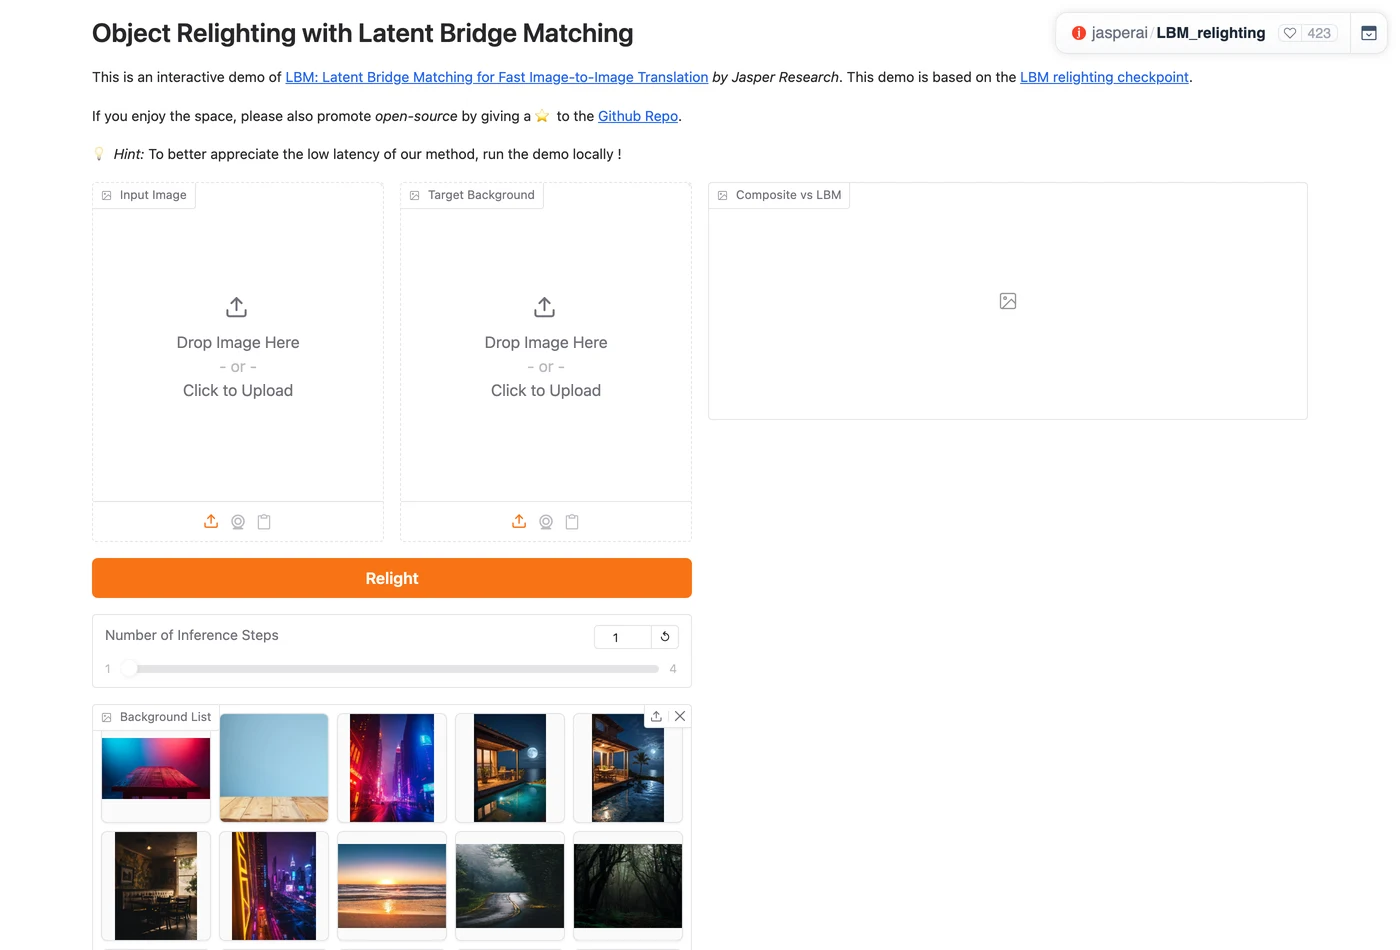
實際送圖進去跑,它背後依序做了三件事。最前頭是摳圖:demo 原始碼裡內建了 BiRefNet 這個去背模型,你上傳的前景會被自動摳出輪廓,不用自己畫遮罩。接著是合成:摳出來的主體被貼到背景圖上,這一步的產物就是那張「看起來很假」的合成圖,也是輸出對照裡的「之前」。最後才輪到 LBM 本體登場:把整張合成圖丟進模型,重新生成一張光影合理的版本。
我跑了兩輪。頭一輪用自己做的測試圖,一顆純紅色的橢圓形配深藍底,驗證它在最陽春的輸入上會做什麼:輸出裡的紅球被加上了從上方打下來的明暗漸層,多了一點球體感,背景幾乎不動。後一輪用官方範例的花朵與餐廳背景,這一輪從上傳到取回輸出計時 5 秒,效果就是開頭描述的那張:色溫被拉暖、受光面亮起、背光面沉下去,花的形狀和輪廓沒有跑掉。
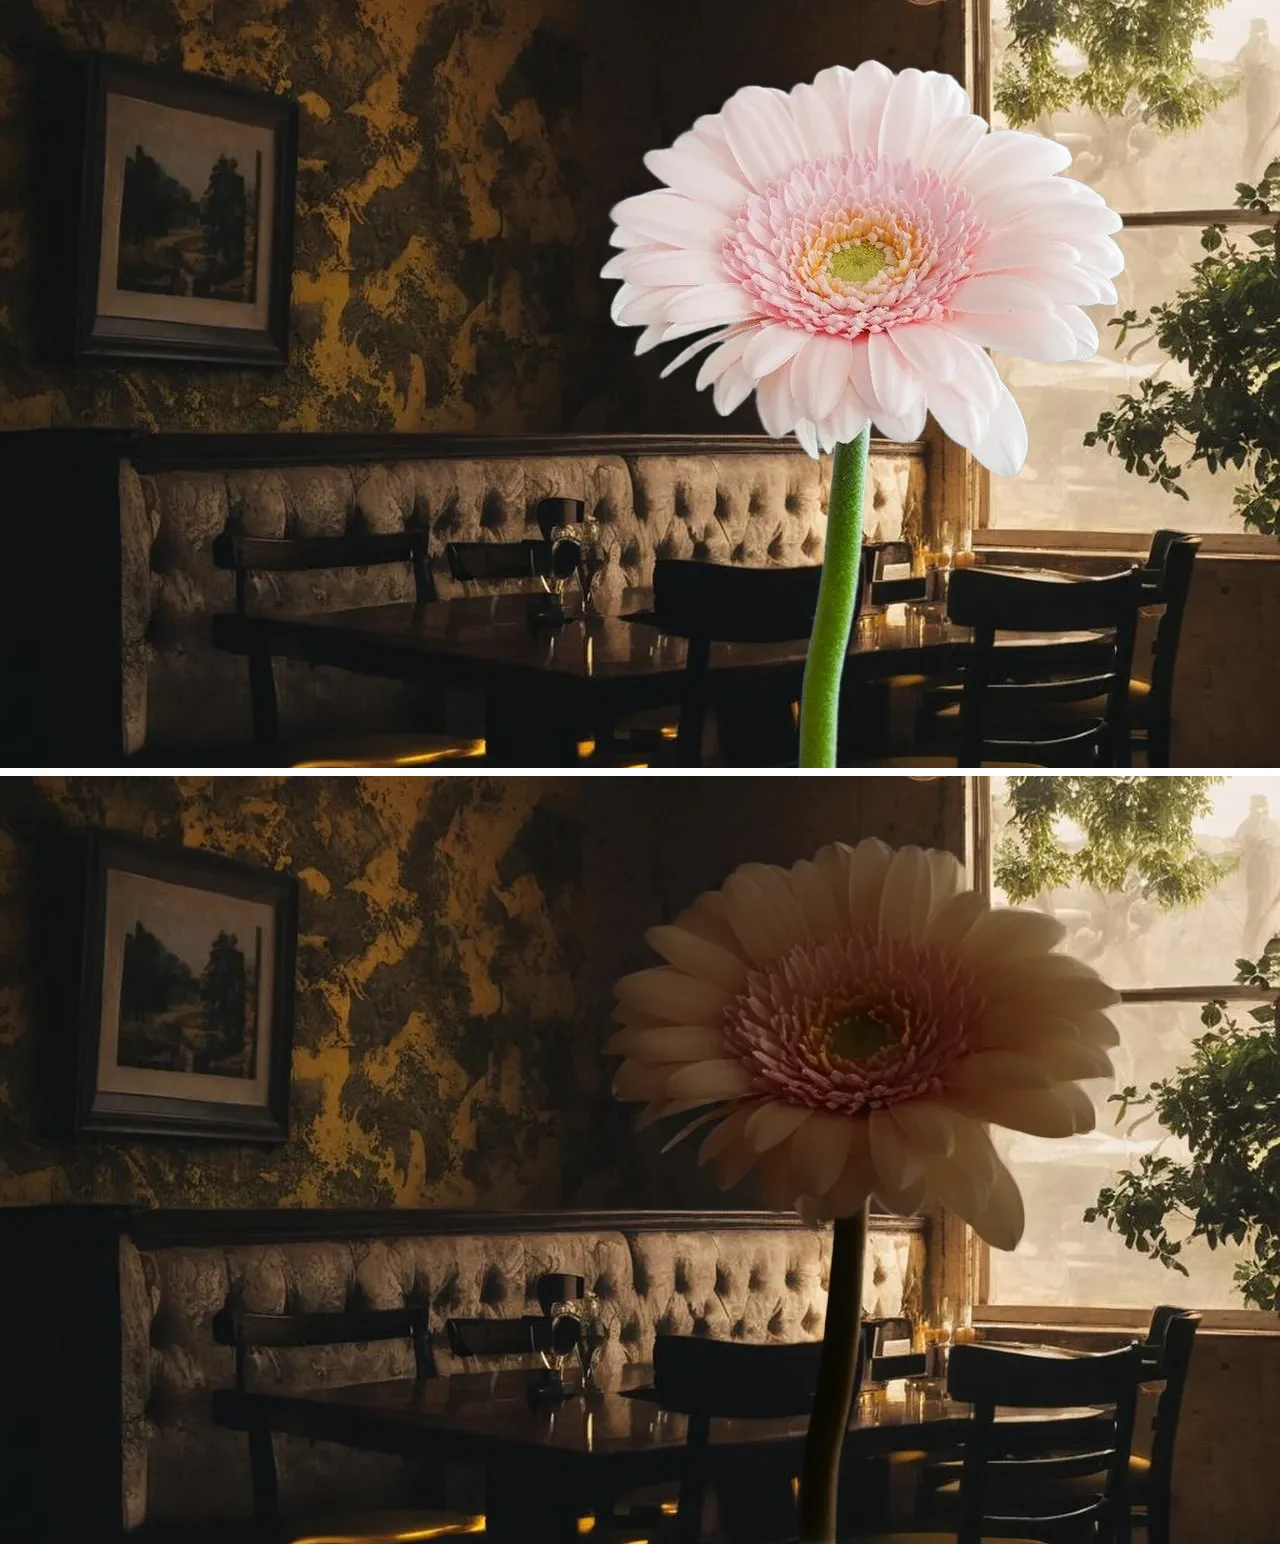
效果講完了,有兩個但書要老實說。其一,輸出裡花朵的整體亮度還是略高於場景,細看仍有一點「貼上去」的感覺,補光解決的是光線方向的協調,沒有把曝光差整個抹平。其二,這 5 秒是排隊加上傳輸的端到端時間,模型的「一步」只發生在中間某個瞬間,稍後會拆開講。
背後的算力也要交代一下。這個 Space 跑在 Hugging Face 的 ZeroGPU 免費額度上,用一張動態分配的 A10G 顯卡,閒置一段時間容器會休眠,下一位使用者喚醒時要等它冷啟動。我兩輪測試都沒有排到明顯的隊,但尖峰時段多人同時按按鈕,等待時間會浮動,這是所有免費 GPU demo 的共同宿命,拿它跟本機速度比較沒有意義。
不想自己準備素材的話,頁面預載了 7 組前後景配對範例,點一下就會自動填入並直接跑一輪,很適合第一次先按範例感受它的能力邊界。輸出的呈現形式是一個可以拖動的對照滑桿,左邊是未補光的合成圖、右邊是補光後的結果,拖中間的把手就能來回檢查邊緣與陰影接得乾不乾淨,這個小設計對判斷摳圖品質很實用。
LBM 論文的野心比 demo 大得多。摘要裡宣稱這套方法用單一步數在各種影像翻譯任務上達到 state-of-the-art,列舉的任務有物體補光、物件移除、深度圖與法線圖估計,外加一套條件控制框架,可以做可控補光與陰影生成;repo 的任務清單上還多列了一項影像還原。注意這些是作者宣稱的實驗結論,論文有論文的評測方式,不是產品功能保證。
把官方宣稱的任務跟公開放出的東西對照,落差就出來了:
| 官方宣稱的任務 | 線上 demo | 公開權重 | 實際狀態 |
|---|---|---|---|
| 物體補光 | 有(唯一一個 demo) | 有,約 5GB | 完整可用 |
| 深度圖估計 | 沒有 | 有,約 5GB | 要自己下載跑 |
| 法線圖估計 | 沒有 | 有,約 5GB | 要自己下載跑 |
| 物件移除 | 沒有 | 沒有 | 只有論文與示意圖 |
| 可控補光與陰影生成 | 沒有 | 沒有 | 論文 4.4 節,未隨程式碼釋出 |
| 影像還原 | 沒有 | 沒有 | README 清單提及 |
這張表不是我自己腦補的。Hugging Face 上 jasperai 帳號放的 LBM 相關模型就三個:補光、深度、法線,各約 5GB。GitHub 的 issue 裡也看得到別人撞上同一堵牆:2025 年 7 月有人開帖說論文裡的物件移除「像魔術一樣」,問能不能分享,沒有得到回應;2026 年 6 月另一個使用者追問論文 4.4 節的條件控制模型有沒有釋出計畫,還具體指出目前放出的補光權重是無條件版,同樣沒有下文。
所以「一鍵去除干擾對象」這個流傳最廣的賣點,現狀是:沒有介面、沒有權重、有社群在問、官方沒有承諾。如果你的需求是修掉照片裡的路人,現階段該看的是成熟的去背與背景移除工具那一條路,這條暫時別等。深度與法線這兩個有權重的任務反而值得開發者注意,只是得自己架環境,後面會算成本。
行銷文案裡的「一步」常常是修辭,這裡剛好是真的,而且能翻開原始碼對質。LBM 的生成函式裡,取樣排程器的雜訊強度被設成從 1 線性收斂到 1 除以步數,預設步數給 1 的時候,整條生成路徑就剩一次神經網路前向計算。對照一般擴散模型來回去噪 20 到 50 步的節奏,這是數量級的差別,也是 demo 敢直接掛在免費 GPU 額度上的底氣。
它憑什麼能一步做完?用一個比喻講:擴散模型是把一團雜訊慢慢雕成圖片,LBM 則是在兩群圖片之間架一座橋。訓練資料是成對的圖,一邊是合成圖(主體貼上去、光不對),一邊是目標圖(打好了光);模型把兩邊都壓進 Stable Diffusion XL 的潛在空間,在兩個潛向量之間畫一條帶隨機擾動的路徑,訓練神經網路預測這條路徑上的走向。學會之後,給它一張新的合成圖,它從這頭出發跨一步,就落在「打好光」那一側的分布裡。論文的說法是布朗橋,對應的配置檔裡那個 0.005 的橋接雜訊強度,就是留給多樣性的小小隨機性。
訓練端還有兩個可以對照的細節,都寫在放出來的配置檔裡。時間步不是全範圍亂抽,而是固定從 250、500、750、1000 這四個值裡均勻選一個,等於強迫模型把橋的前中後段都看熟。損失函式除了潛空間的比對,還會把預測的潛向量解碼回像素再算一次影像層的差距,等於用兩種尺度同時把關。
有個細節可以看出這套架構的自覺:demo 介面上那個推理步數滑桿,範圍給到 4,預設值是 1。官方自己也在 demo 頁面寫了一句提示,想體感它的低延遲,建議下載到本機跑。線上版排隊與傳輸的開銷,其實比模型本身的計算還重。
單步的代價也誠實講:那 5 秒裡真正屬於「一步」的只有一小段,前頭還有 BiRefNet 摳圖和 VAE 編碼,後頭有 VAE 解碼。單步省的是最貴的那段來回,不是整條管線。
這一節是實測與源碼對帳時挖到的小東西,都不難,但每個都會改變你怎麼用它。
先是尺寸。上傳的圖會被吸附到 11 種固定的長寬比解析度裡最接近的一種,過程是縮放加中央裁切,也就是說比例不吻合的照片,四周會被裁掉一圈。我的 640×640 測試圖回來變成 1024×1024;官方範例那組回來是 1280×768。有趣的是,demo 程式裡其實寫了要把輸出縮回原始尺寸的那行呼叫,但它沒有接住回傳值,對 PIL 的 Image 物件呼叫 resize 不會改動原圖,所以那行是無效程式碼,輸出就停留在吸附後的尺寸。變數名還把寬跟高標反了。這兩個小瑕疵很能說明這個專案的性格:研究程式碼,能用、誠實,但沒有產品級的打磨。要拿輸出回貼原圖工作流程的人,自己再縮放一次就好。
想要少裁一點,有個從吸附表反推回來的小技巧:先把圖自己裁到接近方形、5:3 或 3:5 這幾檔再上傳,吸附時的裁切量就會最小。橫幅 1:4 跟直幅 4:1 這種極端比例雖然也在表裡,但那兩檔的短邊只有 512,細節會先被壓掉一輪。
另一條性命線在儲存庫那頭。Space 的原始碼裡有一段啟動程序:容器每次冷啟動,都會現場從 GitHub 的 main 分支把 LBM 套件裝進來,跳過依賴以避免版本衝突。這代表 demo 跟 repo 是一條命的,儲存庫如果哪天被改名、刪除或 main 分支改壞了,demo 會跟著起不來。對把工具放進正式工作流程的人來說,這是單點依賴,值得知道。
還有摳圖這關你插不了手。BiRefNet 自動摳前景很方便,但 demo 沒有提供修正遮罩的介面,前景如果摳錯了邊,你只能在輸出裡看到結果,沒有中間可以救。頭髮、半透明、網狀這類難摳的主體,先有心理準備。
要把 LBM 用在商業用途的人,這節是重點。這個 repo 的授權檔寫的是 CC BY-NC 4.0,姓名標示加禁止商業使用,Hugging Face 上三個模型權重的授權欄位標的也是同一個。也就是說,接案修圖、客戶專案、任何收錢的用途,都不在授權範圍裡。
授權標示本身還有一個小混亂,順手記下。README 上的授權徽章文字寫 CC BY-NC,徽章連結卻指向 CC BY-ND 的條文頁;HF Space 那邊的 metadata 又標成 cc-by-4.0。三處不一致,但儲存庫裡那份完整的授權檔是 Attribution-NonCommercial 4.0 全文,以其為準,往商用方向解讀的空間不大。
如果你需要的是可以商用的補光方案,同一個賽道上有個更老牌的選擇:IC-Light,ControlNet 作者的控制光線工具,Apache-2.0 授權,8,500 顆星以上,用的是有文字指令的控制路線,代價是多步推理的等待。有個淵源值得一提,LBM demo 裡那批示範背景圖,官方註明就是取自 IC-Light 的儲存庫。兩者光譜很清楚:要商用彈性與生態,看 IC-Light;要嘗試單步新架構與 SDXL 潛空間的品質,LBM 的 demo 免費開著。
自架的成本也算一下。單一權重約 5GB,深度與法線各一個,全拿是 15GB 級的下載量;推論程式把裝置硬寫成 CUDA,沒有 NVIDIA 顯卡的機器跑不動;依賴是 torch 與 CUDA 版的整套套件。環境問題排除之後,用起來是一行指令的事:官方推論腳本指定模型名稱與來源圖,深度、法線、補光三選一,輸出直接落地。
對開發者來說,真正有吸引力的其實是那兩個沒有 demo 的權重。深度圖與法線圖是 3D 重建、遊戲素材、渲染管線的常用輸入,一般這類單目深度估計要嘛靠多步的擴散式模型慢慢磨,要嘛用快但細節較粗的傳統網路;LBM 把它放進 SDXL 級的潛空間又壓到單步,這個組合在「品質與速度都要」的場景裡有它自己的位置。想自己微調也有現成路徑,訓練範例以 Apple 的 Hypersim 室內場景資料集示範怎麼訓法線模型,資料以 webdataset 格式餵進去,改掉設定檔裡的 shard 資料路徑就能換成自己的資料。
專案的活躍度最後交代。13 個提交,第一筆落在 2025 年 3 月論文發表前後幾天,最後一筆停在 2025 年 7 月,內容是更新 README,此後 main 分支凍結,沒有發過任何 release;論文的修訂也停在 2025 年 8 月的第二版。但把它直接判死刑也不對:Space 到 2026 年 5 月還有維護紀錄,demo 現在也是活的。這是典型的學術開源節奏,程式碼與論文隨發表而結晶,之後就不再滾動。要期待的是它不要壞,別期待它長新功能。
它到底能不能幫我把照片裡的路人修掉?
現在不能。物件移除只存在於論文實驗裡,沒有 demo、沒有權重,GitHub 上有人問了也沒有官方回應。流傳的中文介紹把這點寫成主要賣點,是照著論文任務清單想像出來的功能表。想修掉路人,現階段用支援內容感應填充的線上修圖軟體比較實際。
拿來接案或商業專案可以嗎?
不可以。程式碼與模型權重都是 CC BY-NC 4.0,非商業授權,姓名標示義務也一樣要守。個人練習、研究、作品集沒問題;牽涉收費的交付,換 Apache-2.0 的 IC-Light 之類可商用方案。
不想下載 5GB,最好的用法是什麼?
就用線上 demo,它就是官方開給所有人的完整入口:前景、背景兩張圖,按一次按鈕,5 秒左右拿結果,不用註冊,摳圖也是自動的。要留意的只有兩件小事,輸出尺寸會被吸附到固定比例,以及非標準比例的照片邊緣會被中央裁切。
一句話收攏:LBM 目前是一篇論文附贈的 demo,把「主體合成後重新打光」這一件事做到了免費、免安裝、單步可用。做合成創作,或電商那種先去背再換場的素材製作,這類人現在就值得把 demo 加進書籤,尤其你的痛點是「貼上去很假」的光線違和感。如果你的需求是移除物件、商用授權或 API 穩定性,這條線先放著,等它放出對應的權重或換一條路。
至於它代表的技術方向,值得多看一眼。影像翻譯被壓縮到一次前向計算,意味著這類原本要靠多步擴散硬撐的任務,正在變成可以即時回應的互動操作。LBM 補的是光,同一套橋接思路下一個補的可能是別的。