TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

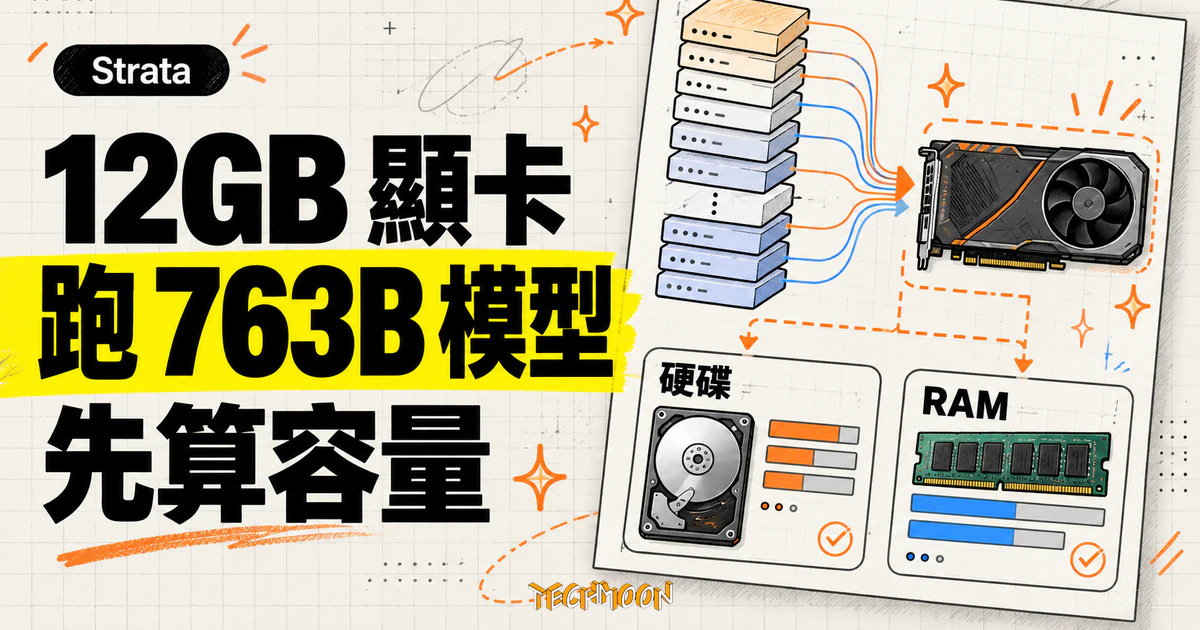
開源推論引擎 Strata 兩天內連發三版,把 763.2B 參數的 DeepSeek V4.1 Flash 帶進 12GB 顯卡的消費級電腦。本篇用官方文件算清真實門檻:模型檔下載 239 到 274GB、建議保留 245GB 以上 NVMe 硬碟、系統記憶體實務門檻約 46GB;2.00 量化組基準保留 100.0% 但困惑度上升 15.5%,而 llama.cpp 尚未支援,這些 GGUF 目前只有 Strata 跑得動。
用 AI 摘要這篇文章:
開源本機推論引擎 Strata 在 2026 年 10 月 24 日到 25 日之間連發三個版本,把 763.2B 參數的 DeepSeek V4.1 Flash 裝進消費級電腦:10 月 24 日的 0.2.4 讓命令列介面先跑起來,10 月 25 日的 0.2.5 把模型選單帶進桌面 App,同日稍晚的 0.2.6 再對大記憶體機器提速。這次能跑的模型,是 DeepSeek 在 10 月 17 日放出的 V4.1-Flash-1017 快照;ISTA-DASLab 接手量化,10 月 23 日交出三組 2 位元等級的 GGUF 檔;Strata 負責把它們接到一張消費級顯卡上。從模型快照發布到本機可執行,整條鏈只走了七天。
「一張 12GB 顯示卡就能跑」是這波更新的招牌宣稱,出處也夠硬:ISTA-DASLab 的模型卡與 Strata 官方文件都明寫這些版本在單張 12GB VRAM 的顯卡上可執行,Strata 文件還附了 RTX 5070 12GB 的實測數字。不過同一批文件也攤出了另一份帳單:模型檔要下載 239 到 274GB、安裝前建議保留 245 到 280GB 可用硬碟,系統記憶體低於約 40GB 時官方自承「未測試且會慢」。顯示卡只是入場券裡最便宜的一聯,下載前真正要核對的是 SSD 剩餘空間與系統記憶體。
Strata 本身是 2026 年 9 月下旬才開張的開源專案,MIT 授權、C++ 主體,靠「把 Qwen3.8-Flash-Next 裝進任何消費級硬體」的定位一個月累積約 3.3 萬顆星。這波 DeepSeek 支援的起點,是作者 Niko Veit 在 10 月 24 日台灣時間上午 11:30 的宣布推文:DeepSeek V4.1 Flash 現在能在 64GB RAM 的機器上用 Strata 跑起來,量化檔由 ISTA-DASLab 的研究員製作。推文三天內累積約 3,100 個讚,量化檔倉庫的下載量在同期衝破 41 萬次,熱度是實在的。模型本身的架構與雲端定價,可以先看先前整理的 DeepSeek V4.1-Flash 發表解析;這篇聚焦本機執行這條路要付出什麼。
前後差異用版本看最清楚。到 0.2.3 為止 Strata 只認 Qwen 家族;0.2.4 的發布說明直接以 DeepSeek V4.1-Flash in the Terminal 為題,當時只有命令列能用,說明裡也明說 Mac 還不支援;0.2.5 起桌面 App 的模型選單列出三組官方尺寸,並新增 Faster 與 Full quality 兩種速度選擇;0.2.6 補上大記憶體快取與 Windows 解除安裝器。對一般使用者來說,分水嶺是 0.2.5:從這版起不必碰命令列。
值得記下的工程細節是引擎拆分:DeepSeek 用的不是 Qwen 那套引擎,而是獨立的 strata-dsv41 套件,從 Project Maya 的 maya-ds4 移植而來(MIT 授權),安裝在另一個資料夾、走簽章更新的發布通道,官方特別強調 Qwen 引擎的檔案完全不會被動到。已經在用 Strata 跑 Qwen 的人,這次更新對你現有環境是零干擾;要不要多養一個 250GB 級的模型,才是真正的決定。
速度在同一週內被推了兩輪。0.2.5 解除了 RAM 存放區 48GB 的舊上限,讓 CPU 一邊從 SSD 讀還沒載入的專家、一邊運算手上已有的部分,官方量到 RTX 5070 機器快 13.5%、RTX 3060 機器快 11 到 15%;0.2.6 更進一步,當記憶體塞得下全部 CPU 側專家時就直接整批載入,單張 R9700 的工作站在 2.00 組程式任務上從每秒 24.5 token 推到 27.6,Windows 端還會把分頁檔空間一併算進可用量,避免小分頁檔的機器被硬推進磁碟分頁。另外有個 Faster 模式,把每個字原本要活化 6 個專家改成取 5 個,官方在 RTX 5070 量到解碼快 16%,並將它設為 16GB 以下顯卡與內顯機器的預設值。
Faster 的取捨值得單獨記一筆:官方對它的描述是「通常察覺不到的小幅品質變化」,這是用每字取用專家數下降換來的加速,自帶品質代價。追求完整品質的使用者要在設定裡主動切回 Full quality,兩種模式的差異會隨任務類型浮動,文件並沒有給出全面的品質對照。
支援範圍官方寫得很具體:NVIDIA GeForce RTX 30、40、50 系列,Windows 與 Linux 都行;Linux 上另有 AMD Radeon AI PRO R9700 一條路。反向看更重要:Mac 目前沒有 DeepSeek 引擎包,0.2.5 的 Mac 安裝檔只內建 Qwen 用的 Metal 引擎,作者在 10 月 24 日的宣布推文裡說 Mac 支援「當天稍晚」就到,但到 0.2.6 為止還沒兌現;Strix Halo 在 0.2.5 的速度實測與 Faster 模式說明裡出現過,但 README 的 DeepSeek 支援清單至今沒有它。承諾與現況之間的落差,購買或等待決策前要先對齊。
還有一個容易被副檔名騙到的限制:模型卡在 10 月 23 日明寫 llama.cpp 尚未支援 DeepSeek-V4.1,對應的 PR 還在草案階段。這代表這三組 GGUF 目前只有 Strata 跑得動,LM Studio、Ollama 這類建立在 llama.cpp 上的工具還開不了。想在熟悉工具鏈裡使用的人,等待 llama.cpp 支援是唯一路徑,時間表沒有人給得出來。
不過「只能用 Strata」不代表只能用它的聊天窗。Strata 在本機開出 OpenAI 與 Anthropic 兩種相容 API 端點,Claude Code、Codex CLI 這類工具都能指過去,官方提供 strata connect 指令自動產生各工具的設定說明。思考模式的強度也能用 reasoning_effort 參數調,從 none、low、medium、high 到 max 共五檔,預設 high。兩個本版限制要先知道:並行請求與圖片輸入在這個版本都還不支援,會被忽略並跳警告;模型的思考模式預設開啟,想要純回答得在請求裡明確關掉。
這個模型每層有 384 個路由專家、每個 token 只活化其中 6 個,40 層合計 15,360 個專家,旁邊還掛一張 200GB 級的 n-gram 查找表,官方稱為 Engram,量化後 111GB。稀疏活化代表同一個瞬間真正需要的權重很少,這是 12GB 顯卡裝得下 763B 模型的前提;Strata 做的事,是把「裝不下的部分」安排到對的位置。
以官方文件對 Q8 全套的配置來說:attention 與 dense 權重共 16.8GB,全部進顯示卡;路由專家共 288.8GB,塞得進顯存的進顯卡,其餘交給 CPU 運算、直接從模型檔原地讀;Engram 表放 SSD,模型每輸出一個字就讀其中幾行。官方在四張 R9700 的工作站上給了一組實測配置:6,197 個專家(116.5GB)進顯存、9,163 個(172.3GB)靠系統記憶體快取,而 strata launch --plan 會用同一套邏輯為你的顯卡與 RAM 算出分配計畫,下載任何檔案前就能先看。2 位元量化把每一層都壓小,12GB 顯卡因此裝得下 dense 加一部分專家,剩下的專家靠系統記憶體快取與 SSD 補位。這也是官方特別註明「模型檔請放在 NVMe 上」的原因:慢碟拖慢的每一個字,都會直接反映在輸出速度。
量化本身也有講究。ISTA-DASLab 用的組合是 GSQ(Gumbel-Softmax 量化)加 RCO(黎曼約束最佳化):前者讓每個張量在低位元下仍保住精度,後者在總檔案大小的預算下,依每個張量對誤差的敏感度分配不同的位元數。白話說就是「重要的地方給多一點位元、不重要的給少」,產出仍是標準 GGUF。三組的密度分別是 1.75、2.00、2.25 位元,對應 llama.cpp 家族慣用的 IQ1_M、IQ2_XXS 與 IQ2_XS 量化名稱。
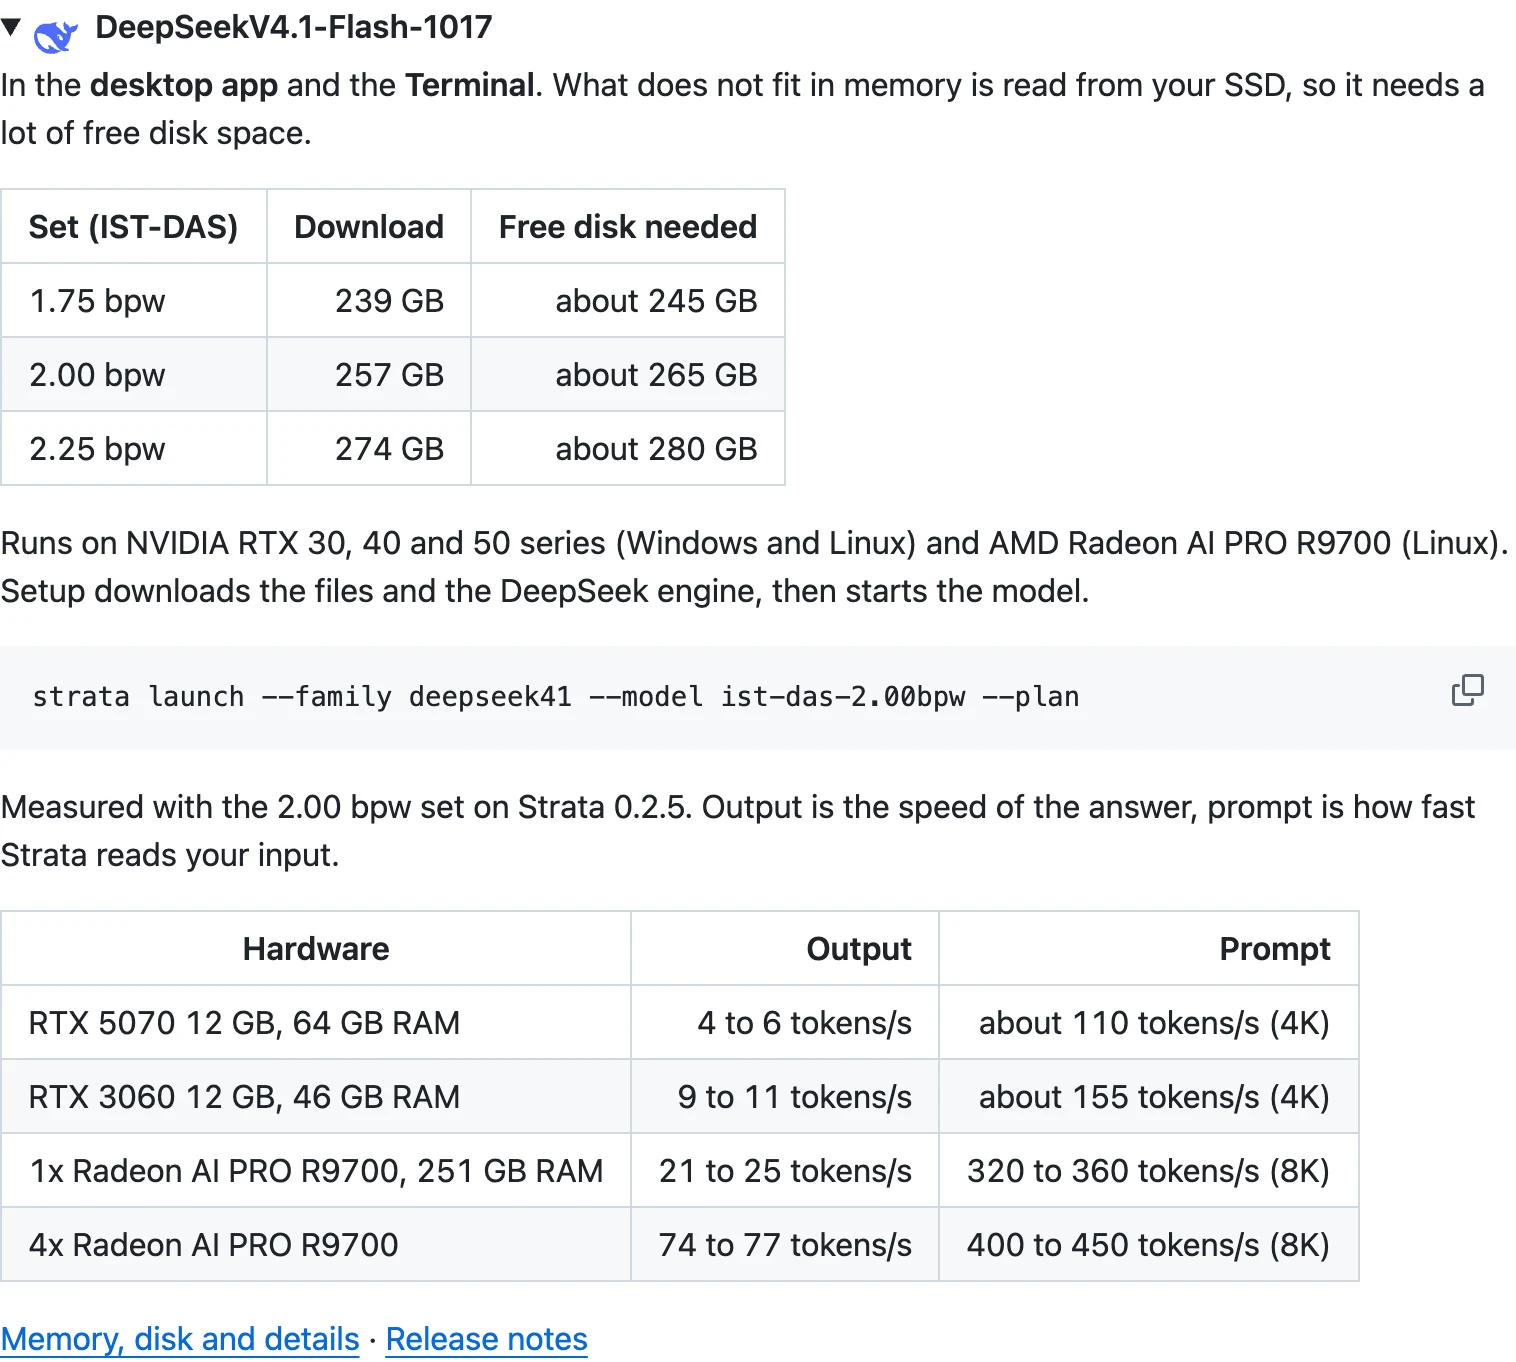
| 組合 | 下載量 | 建議可用硬碟 |
|---|---|---|
| 1.75 bpw(IQ1_M) | 239 GB | 約 245 GB |
| 2.00 bpw(IQ2_XXS) | 257 GB | 約 265 GB |
| 2.25 bpw(IQ2_XS) | 274 GB | 約 280 GB |
三組共用同一張 111GB 的 Engram 表與 8GB 的 DSpark 草稿模型,抓過 2.00 組之後這兩份已經在本機,換別組只需要補下載差額;三組全裝官方估計共 533GB。下載前的兩道檢查行為不同:引擎未就緒時,安裝程式會在抓任何大檔前用一段白話說明並停住;硬碟或記憶體不足則只警告、不阻止,把決定權留給你。
記憶體的底線官方也寫得直白:低於約 40GB「未測試且會慢」,安裝程式會警告但不阻止。實測速度表裡最便宜的組合是 RTX 3060 12GB 加 46GB RAM,也就是說系統記憶體的實務門檻大約落在 46GB 這一檔,先確認主機板上還有沒有插槽與預算可擴充。與其糾結顯卡要買多新,把預算先留給記憶體與 SSD,對這個工作負載的回報更直接。
Strata 文件附了四種機器的實測(2.00 組、0.2.5 版):
| 機器 | 輸出速度 | 讀取提示 |
|---|---|---|
| RTX 5070 12GB、64GB RAM | 每秒 4 到 6 token | 約 110 token/s(4K) |
| RTX 3060 12GB、46GB RAM | 每秒 9 到 11 token | 約 155 token/s(4K) |
| 單張 R9700、251GB RAM | 每秒 21 到 25 token | 320 到 360 token/s(8K) |
| 四張 R9700 | 每秒 74 到 77 token | 400 到 450 token/s(8K) |
最反直覺的一行是 RTX 3060 比 RTX 5070 快:較舊、較便宜的顯卡,配上較少的系統記憶體,輸出速度反而是對方的兩倍上下。官方沒有解釋這組對比的成因,但機制上不難理解:瓶頸落在整台機器上,顯卡只是其中一環,SSD 讀取速度、記憶體頻寬與配置方式都會改變結果,文件也明說慢碟會拖慢每一個字。評估自己機器時,拿顯卡型號查天梯沒有意義,直接看官方對應配置的實測比較準。
每秒 4 到 6 token 的體感要先說明:相當於一分鐘產出兩三百字中文的閱讀量,讀一個長回答要等上一段時間,跑批次程式任務還能接受,拿來當日常互動助理會考驗耐心。讀取提示的速度(每秒 110 到 155 token)決定長文件貼進去後要等多久才開始回答,4K 提示半分鐘上下會動起來,這對代理工作流的體感影響不小。文件裡另一個細節是預設 context 只有 8192 token,桌面 App 對 DeepSeek 直接固定 8K,而模型基底規格是 1M。長文件分析或多輪代理工作流在這個版本上會先撞到 context 牆,這個檢查點出在本機組態,與模型能力無關。
品質有兩份官方量測,量的是不同的東西。模型卡的基準測試(AIME25、GPQA-Diamond、LiveCodeBench v6,reasoning effort 50)裡,2.00 組三項分數與原版完全相同,task average 保留 100.0%;2.25 組 99.8%;最小的 1.75 組 98.7%。單看這張表,量化幾乎無傷。
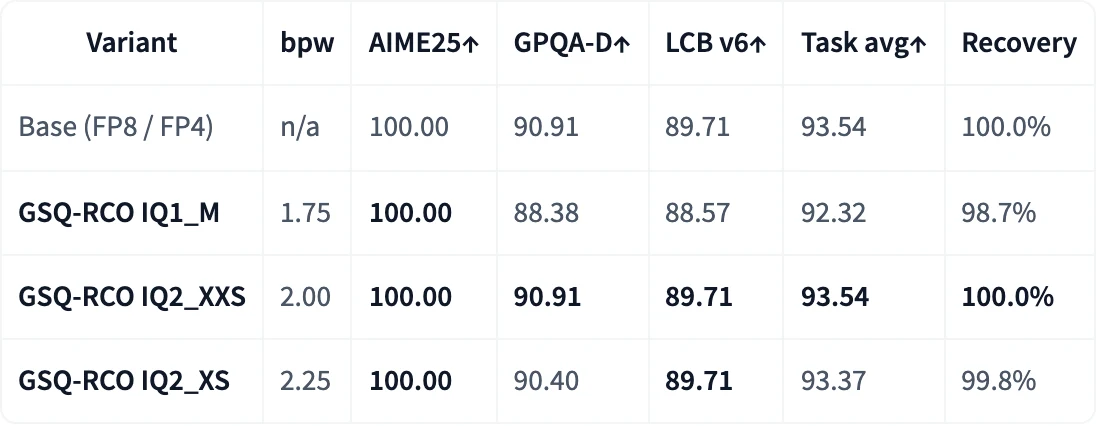
Strata 文件自己補了另一種量法:對照原模型的輸出分布,2.00 組的 KL 散度 0.170、困惑度上升 15.5%(程式任務上升 8.6%、代理任務 5.3%);2.25 組 KL 0.107、困惑度上升 7.3%。1.75 組整體困惑度上升 21%,其中一般英文散文項上升到 53%,是三組裡最明顯的弱點。兩份量測並不矛盾:基準分數回答「會不會做對題目」,分布量測回答「每個字選得像不像原版」。對程式與代理任務,2.00 組的取捨相當划算;對長文寫作有要求的話,差距明確指向 2.25 組,代價是多 17GB 下載量。
按硬體分流最實際。手上有 RTX 30 到 50 系列顯卡、NVMe 硬碟夠空、系統記憶體 46GB 以上的 Windows 或 Linux 使用者,現在就能下載 2.00 組試跑,strata launch --family deepseek41 --model ist-das-2.00bpw --plan 這條指令會先顯示模型在你機器上的配置計畫,不動任何檔案,適合當作下載前的檢查。硬碟或記憶體吃緊的人退到 1.75 組,但對散文品質要有心理準備。Mac 使用者與其他 AMD 卡使用者,這版先跳過;習慣 LM Studio 或 Ollama 的人,等 llama.cpp 支援落地再說。只想偶爾問答的人,雲端 API 的成本結構仍然比 250GB 硬碟加上等待時間划算;想先確認自己機器跑不跑得動其他模型的,可以參考 ThinkInAI 的相容性檢測做法。
未確認的事項也要列清楚:Mac 與 Strix Halo 的支援時程,官方在 10 月 24 日推文承諾「當天稍晚」,到 0.2.6 還沒有出現;llama.cpp 的支援 PR 何時合併沒有時間表;實測速度全部出自官方文件,本篇未另行安裝驗證。這個專案的版本節奏是每天多版,本文數字以 2026 年 10 月 25 日的 0.2.6 與同日文件為準,閱讀時若已隔數週,建議回官方文件核對最新數字。
一句話收尾:這個 763B 模型第一次有了 12GB 顯卡等級的本機執行路徑,而這條路的門票是硬碟與記憶體,不是顯卡。下載之前,先確認那顆 NVMe 的剩餘空間。