TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

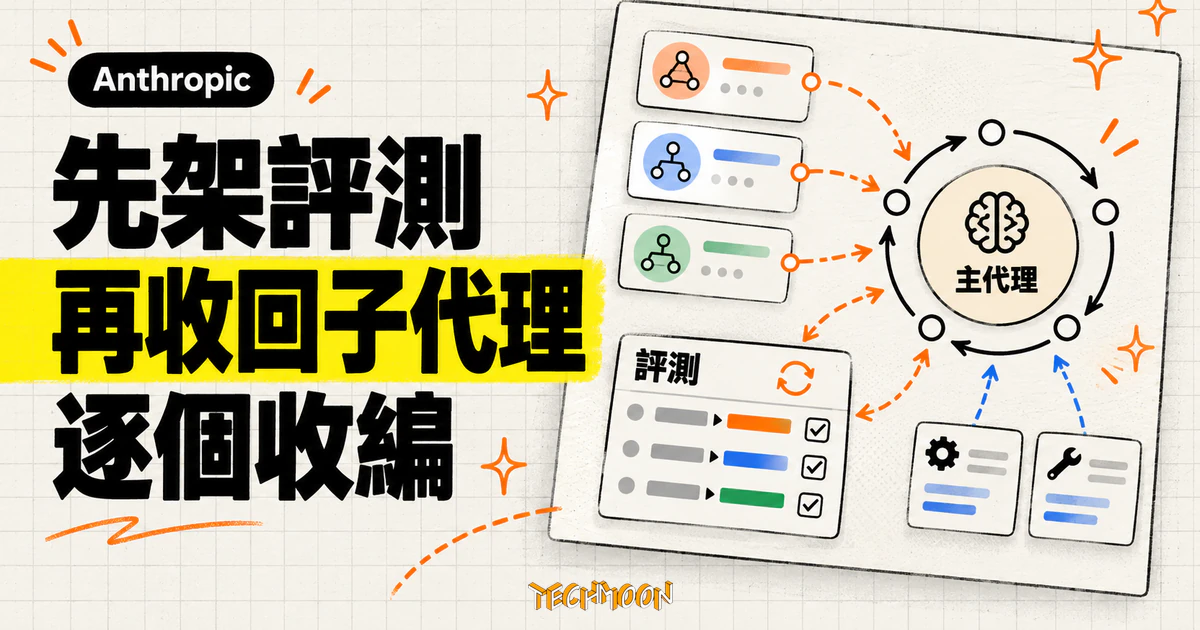
Anthropic 的 Applied AI 團隊在 2026 年 10 月 22 日的官方文章建議企業把路由、規劃器與領域子代理收回主代理迴圈,改用技能檔與工具搜尋按需載入。本文把配套開源的 single-agent-loop-kit 抓下來實跑離線測試、重新彙算官方收錄的兩輪 claude-opus-5 評測紀錄:退貨折疊後完成率 92% 升到 96%、延遲降近三成,但輸入 token 不減反增,診斷工具化那輪完成率反而從 94% 掉到 91%。整併不是穩賺,官方賣的是先架評測、一次收一個、看哪些任務翻盤的量測流程。
用 AI 摘要這篇文章:
2026 年 10 月 22 日,Anthropic 在官方網站發布工程文章《Building agents: When to fold subagents into your main agent loop》,作者是技術團隊成員 Diane Sarkis。建議本身一句話就能講完:企業代理裡那些負責分派任務、規劃流程或處理特定領域的子代理,現在值得考慮收回主代理迴圈,改用技能檔(skills)與工具搜尋(tool search)按需載入。配套的開源遷移套件 single-agent-loop-kit 早在一週前(10 月 15 日)就已建立,文章發布前一天完成唯一一次提交。
看到這種消息,實際在顧代理系統的開發者大概會想問三件事:我的子代理到底該不該留?收回去真的會變快變省嗎?怎麼收才不會收出新的 bug?這三題官方文章都有回答,而遷移套件裡還留著兩輪真實評測的原始紀錄。我把套件完整抓下來、跑通它的離線測試、重新彙算那兩輪紀錄,得到的數字比文章的敘述更具體,其中一個失敗樣本正好就是官方在文章裡警告過的型態。
文章的經驗來源是 Anthropic 的 Applied AI 團隊協助企業部署代理的實戰。他們觀察到一個反覆出現的模式:把路由(router)、規劃器與領域子代理收回主迴圈之後,系統反而變單純了。官方的比較說法是,跨多個企業部署的對照中,帶技能檔的單一代理在品質上經常勝過「一段提示詞打天下」和「子代理分工」兩種設計,而且每次任務的成本與延遲常常更低。注意這是官方的宣稱,原始對照資料並沒有隨文章公開。
兩個量化線索值得記下,但同樣屬於官方敘述的匿名案例:一家公司的對外代理塞了十二個專家子代理,結果品牌口吻難以維持一致,延遲也傷了體驗;另一家客戶拿多代理框架和單代理迴圈對跑,後者 runtime 快了大約 2 倍。
為什麼大型組織特別容易把代理蓋成一棟危樓?文章列了五種失敗模式,每一種都源於「各團隊各蓋各的」:
文章裡最直白的一句吐槽:太多企業讓每個團隊或每種問題類型都有自己的子代理,代理架構長得跟組織圖一樣,這是 Conway’s law 活生生在上演。
受影響的族群很明確:在 Claude Platform 或用其他框架自建多代理系統的開發團隊。反過來說,還沒開始用子代理的人不在遷移對象裡,套件文件明說這種情況直接從單一迴圈起步就好,邊做邊按測試結果加技能檔和工具。一般終端使用者不會感覺到任何變化。
官方保留了子代理的三個正當使用時機,原文寫得相當節制:
1. 單一迴圈因為上下文膨脹出現可量測的效能退化;
2. 多個任務需要平行處理,而且每個任務用完即丟的乾淨上下文很有價值;
3. 單一代理選不好該用哪個工具,或系統提示詞裡的指令互相衝突。
抽象條件要怎麼變成可以照做的判斷?遷移套件內建的範例系統剛好示範了一次完整盤點。這個叫 support-desk 的範例是一家虛構家電零售商的客服代理:一個路由加上六個專家子代理(訂單、出貨、退貨、帳戶、理賠、裝置診斷)。套件的審計步驟對七個角色逐一給出判定,五種結局各佔其位:
這張判定表比任何架構原則都實用:收不收,判斷依據是耦合度、token 流量與提示詞所有權,組織圖只是干擾。
套件最難得的部分,是它把兩輪真實評測的原始紀錄直接收在 repo 裡,任何人都能重算。第一輪在 2026 年 10 月 8 日執行,模型用 claude-opus-5,12 個任務各跑兩次。遷移只做一件事:把退貨子代理折成技能檔。我重新彙算的結果:
| 指標 | 遷移前(路由+六專家) | 遷移後(退貨折入) |
|---|---|---|
| 任務完成率 | 22/24(92%) | 23/24(96%) |
| 平均延遲 | 27.3 秒 | 19.4 秒 |
| 模型呼叫次數 | 152 | 116 |
| 輸出 token | 36,941 | 25,235 |
| 輸入 token | 435,707 | 436,880 |
完成率上升、延遲降近三成、模型呼叫少 36 次,輸出省了三成。但有個細節多數轉述不會提:輸入 token 不減反增。折疊把退貨流程收進主上下文,代價是主代理每次都要多讀一點東西。這樁買賣沒有穩賠或穩賺,只有資源的重新分配。
第二輪更有意思。10 月 9 日的執行換成把診斷子代理改為工具呼叫,17 個任務各兩次:完成率從 94% 掉到 91%,平均延遲只從 30.8 秒小降到 28.3 秒,輸入 token 從 522,817 增到 538,293。同一個套件、同一批人、同一個範例系統,另一個方向的改動就沒賺到品質。官方文章用 frequently 和 often 這種保守措辭,看完原始紀錄會明白為什麼。
第一輪遷移後的 24 次執行裡,唯一失敗的樣本正好是文章警告的型態本人。任務 t01 問的是訂單 5002 的狀態,遷移後的某次執行裡,主代理自己拿著訂單查詢工具就作答了,沒有去問出貨專家,於是漏掉了送達日期,回答顧客「系統裡還沒有預計送達日」。那次執行只花 6.84 秒,是全部 48 次執行裡最快的一次,而且同一任務另一次執行是正確的。速度快掩蓋了流程破洞,而且這個洞兩次執行只出現一次,單跑一次評測根本抓不到。這是「改完要比對哪些任務翻盤、而且每個任務要跑多次」最具體的立論證據。
單代理路線也有自己的工程邊界,官方給了幾個數字:系統提示詞裡的工具定義超過 30 到 50 個之後,工具選擇會開始退化,所以工具要按使用者意圖分組,不要一個 API 一個工具;他們為了先進模型把 Claude Code 的系統提示詞砍掉超過 80%,其中一部分就是靠技能檔與工具的漸進式揭露;模型能力本身也在變,Opus 5.5 與 Fable 5.1 已經不能關閉思考模式,模型邊做邊自我檢查,某些框架層的輔助變得多餘。
官方遷移方法從評測開始,架構改動排在後面。沒有現成評測的話,十個黃金範例就足以起步;比較理想的結構是一個中央小組持有端到端的共用評測集,各領域團隊為自己的技能檔附上小型評測。計分方式也有講究:先用評分表(rubric)給代理的最終回覆打等級,追蹤答題品質;還有編排器的階段要同時追路由準確率,收編之後改查「代理有沒有載入對的技能檔、呼叫對的工具」。有了分數之後,一次只收一個子代理,比對前後表現,而且不要只看總分,要看哪些任務翻盤了。每次改動前,確認評測裡涵蓋了生產環境會連續觸發的每一條代理鏈,第一輪實測就曾經漏掉「帳戶接退貨」這條鏈,事後才補上專門的檢查腳本。如果內部系統難以重播、使用者行為難以模擬,官方分享過一個內部做法:在重要事件上記時間戳,之後就能重播事件當成定向評測來跑。
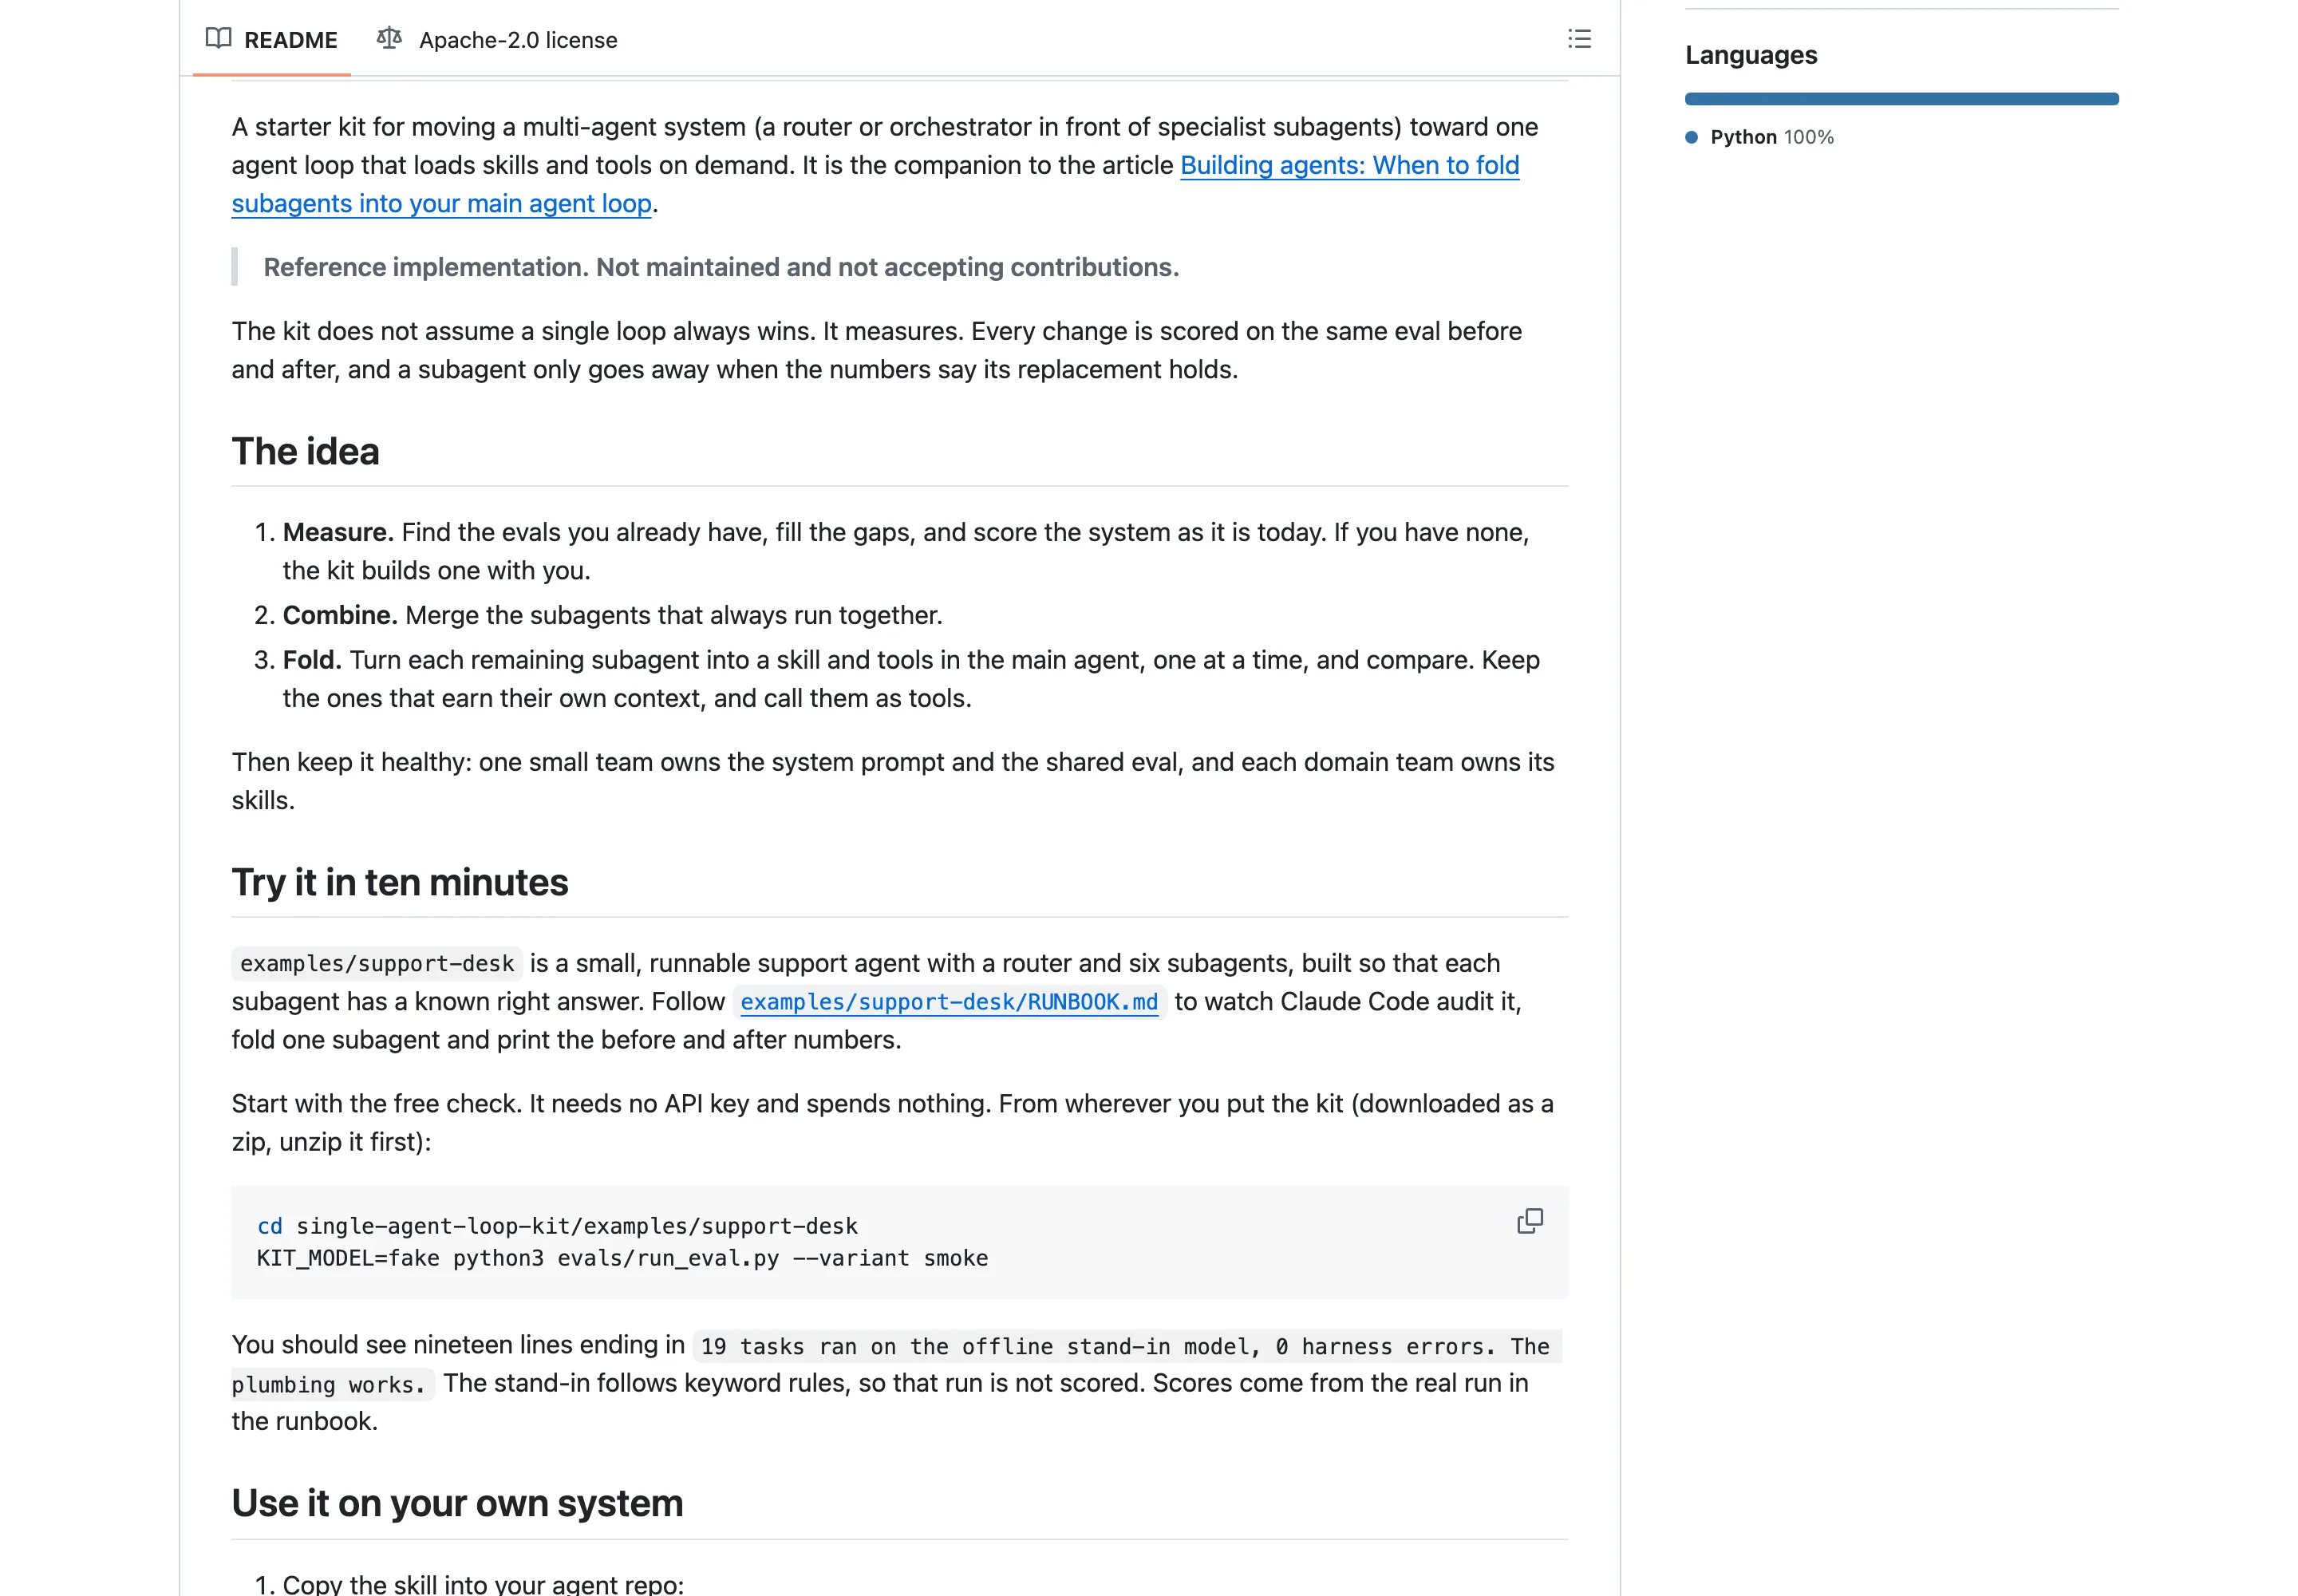
遷移套件把這套流程做成六個步驟:盤點判定、建立基準、合併、折疊、工具化、收尾維護。每步之後都會暫停下來給你看發現與建議,付費執行前會先估 token 用量。我在自己的機器上跑了它的離線煙霧測試,不需要 API key、零花費,19 個任務全部執行完畢、0 個框架錯誤;這輪用關鍵字規則的替代模型作答,不計分,只證明管線是通的。README 裡有句話把整套哲學講得很白:沒有分數的遷移,只是各說各話的意見。
分工怎麼變,官方文章寫得明白:各領域團隊的擁有權從「一個代理」移轉成「一份技能檔加幾個工具」,系統提示詞與端到端品質集中到一個小的中央小組手上。至於這對組織的實際意義,是我的推論:代理數量做減法的同時,中央團隊的把關責任正在做加法。至於要不要跟上這套做法,可以參考同一時間其他多代理路線的發展,像 Cursor 把協調代理常駐調度子代理、Sakana AI 讓模型組團自我監督,以及 OpenAI Agents API 的代管框架,多代理與單代理各自匹配不同的工作形態,無須當成信仰之爭。
幾個重要未知要先講清楚。企業部署對照的原始資料沒有公開,品質、成本、延遲的改善幅度只能當官方宣稱看。套件本身在 README 明言是參考實作,不維護、不收貢獻,issue 與 pull request 都沒人監看;合併與收尾兩個步驟、範例的完成版單迴圈、以及任何非範例系統,都沒有在真模型上跑過,兩輪紀錄也都出自一人一模型。想在生產系統上用,先做好自己扛的心理準備。
官方也在文章結尾自己提醒:模型在演進,最佳實務跟著演進,任何一種架構都不比它背後的原則重要,也就是量測、一次改一樣、留下撐得住檢驗的。這篇的保存期限大約到 Anthropic 發布下一篇代理架構文章、或這個套件出現新提交為止,建議一個月後回來看一次有沒有翻案。社群上已經有人把這篇讀成「代理架構的重大轉向」,對照官方小心翼翼的措辭,更像是一家模型公司把自己踩過的坑整理成可量測的遷移方法,賣的是流程,不是新的信仰。