TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
Scira 是 AGPL-3.0 開源的 AI 搜尋引擎(前身 MiniPerplx),不登入就能搜,程式層匿名額度是 7 天 25 次滑動視窗。實測三輪匿名查詢全數完成,每輪展開 3 到 6 個步驟、15 到 24 個來源,答案逐句附引用。Pro 每月 15 美元、Max 每月 60 美元;自架要 49 個環境變數,公開 repo 停在 2026 年 3 月,最新模型只在託管版上。
用 AI 摘要這篇文章:
Scira 是一套開源的 AI 搜尋引擎,問它一個問題,它會自己把問題拆成多個子查詢、上網找資料,最後給你一份逐句標註來源的答案。它的前身叫 MiniPerplx,2025 年 1 月改名,現在的入口是 scira.ai。我用無痕瀏覽器連跑三輪真實查詢,全程沒有註冊帳號,三輪都完整跑完:分別展開 4 個步驟 24 個來源、3 個步驟 15 個來源(39.2 秒收工)、6 個步驟 21 個來源。這篇把「直接匿名用、辦帳號付費用、自己架一套」三條路的真實代價一次攤開。
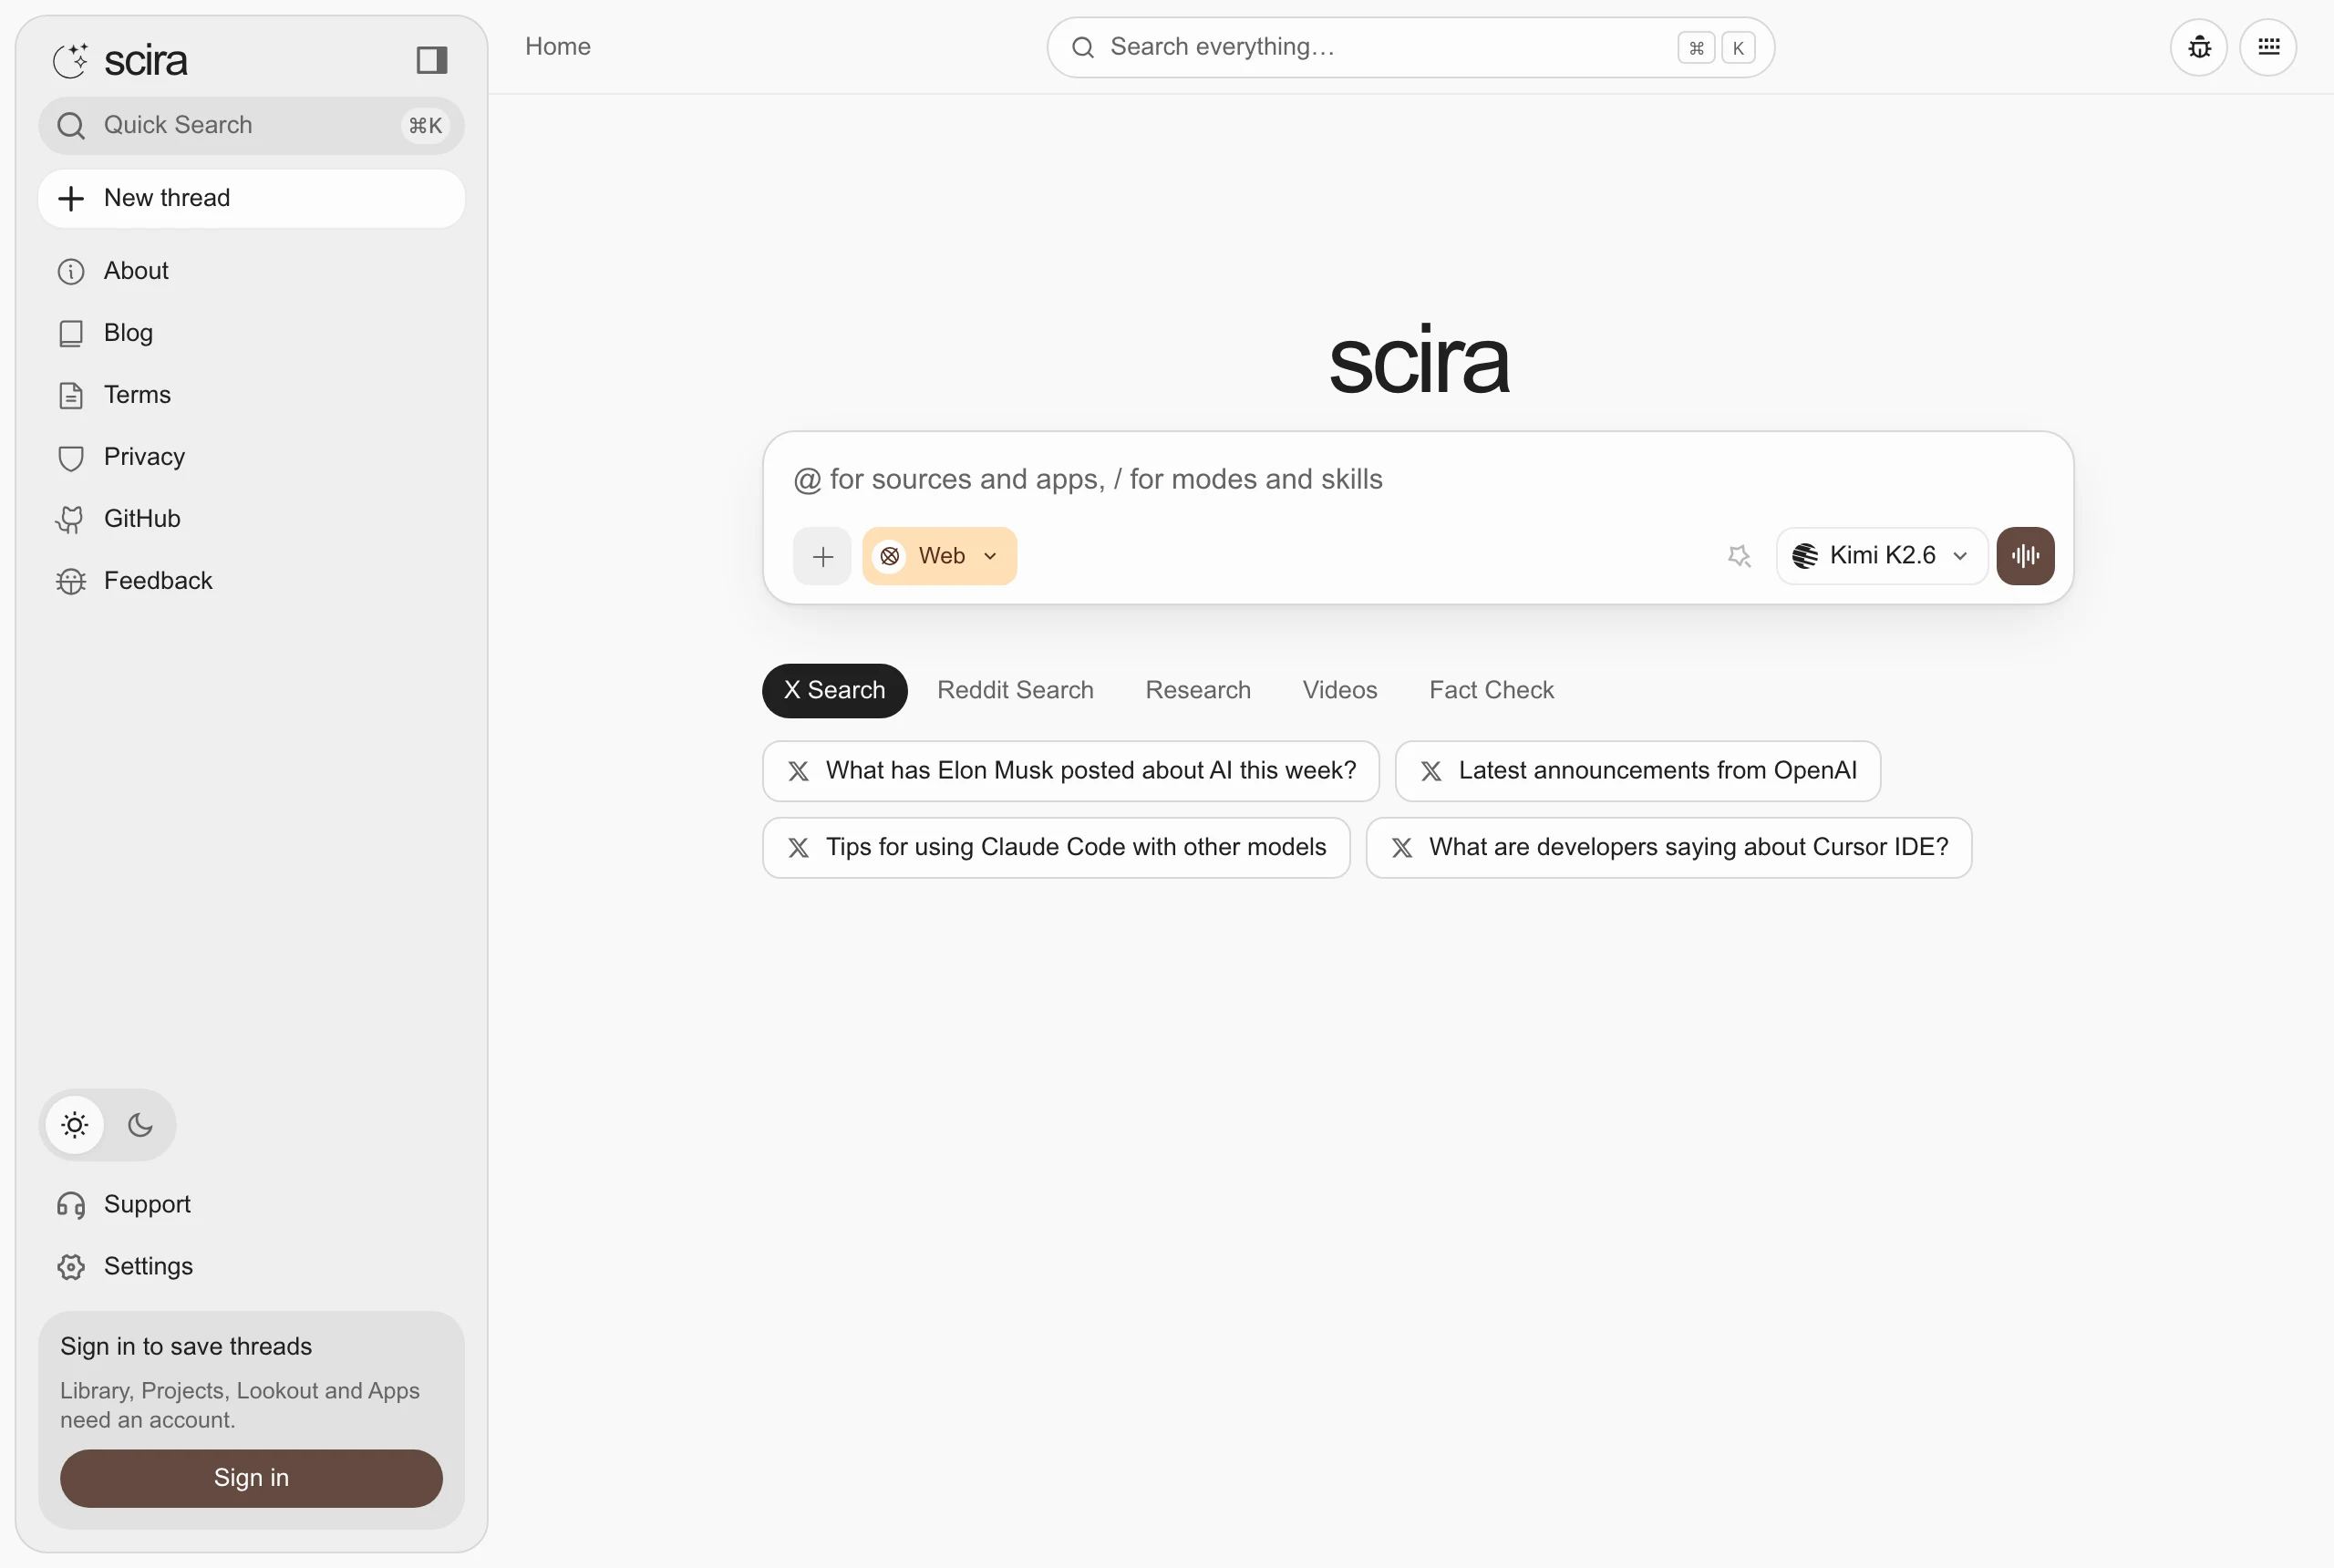
大多數 AI 搜尋引擎在搜尋框前面先架一道登入牆,Scira 沒有。打開 scira.ai,頁面中央就是輸入框,旁邊掛著來源選擇器(預設 Web)、模型選擇器與語音輸入鈕;輸入框下方一排模式分頁(X Search、Reddit Search、Research、Videos、Fact Check),再往下是四個現成的建議提問。側邊欄底部只有一塊登入提示(Sign in to save threads),但不登入照樣能搜。
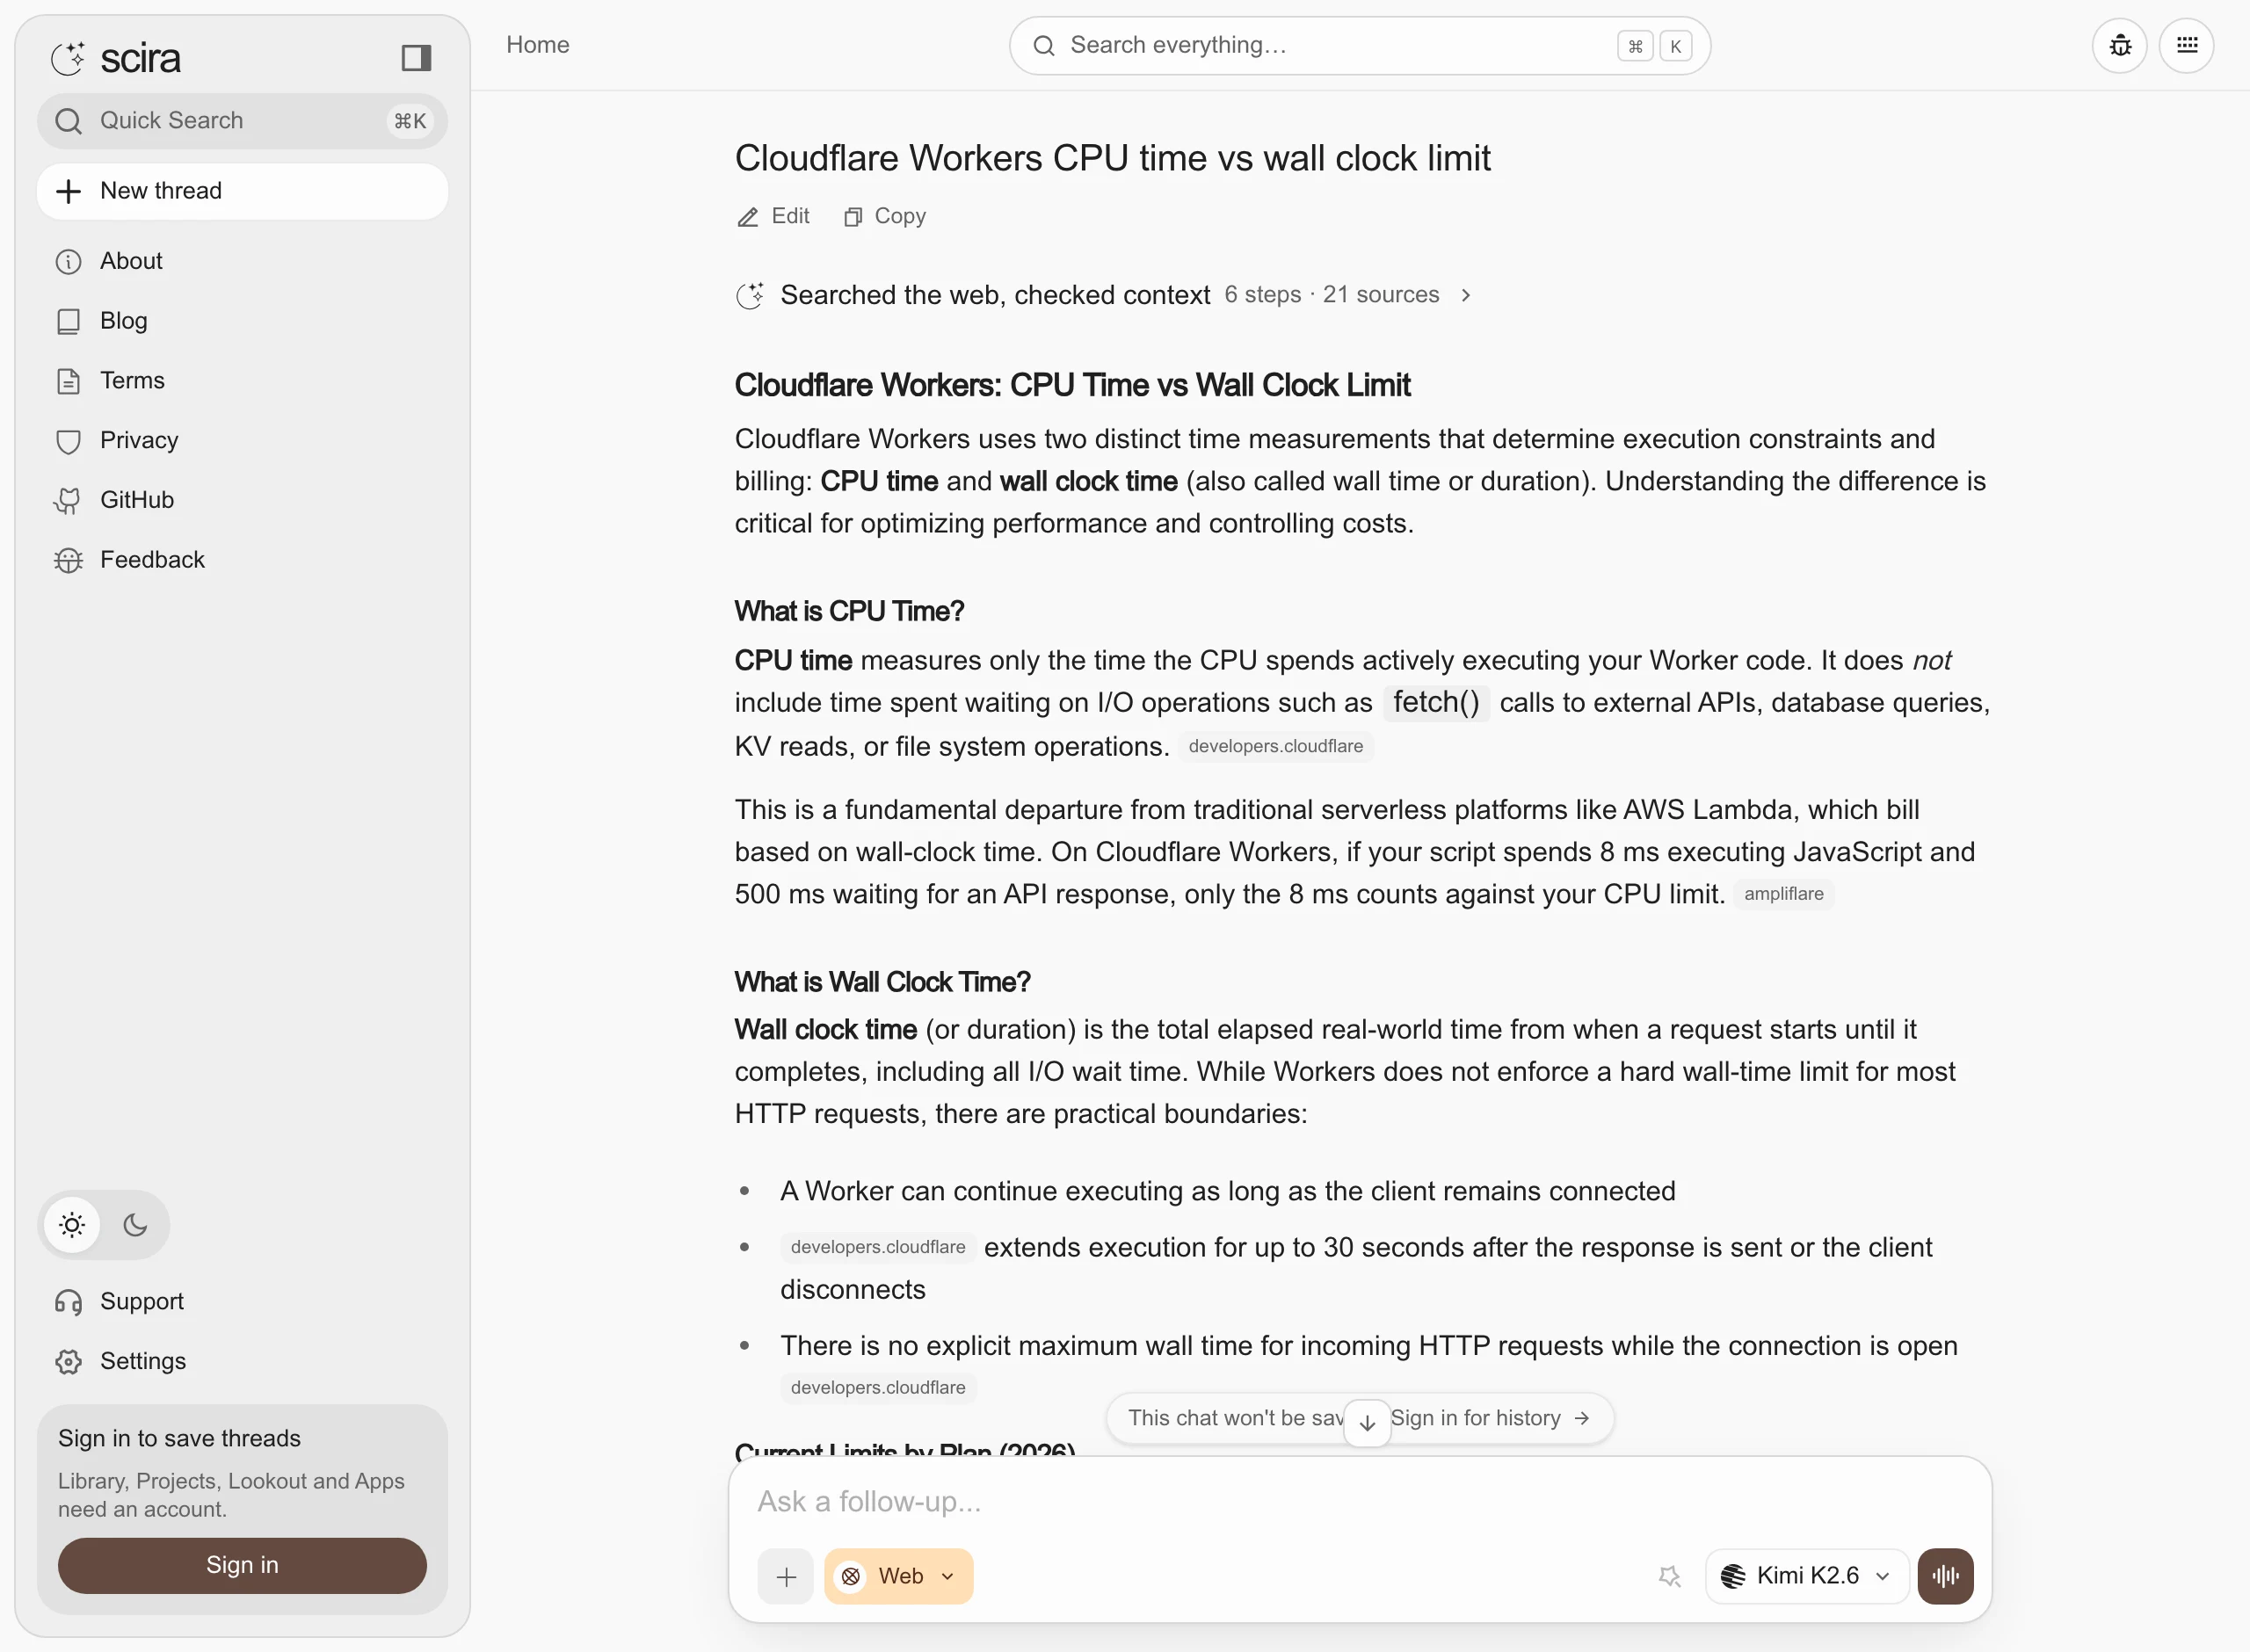
我拿同一類技術問題(Cloudflare Workers 的 CPU 時間限制與實際耗時怎麼計費)分三次送進去,三次都拿到結構完整的答案:先給執行摘要,再分節說明,結尾附重點整理與四個延伸問題建議。每個關鍵句子後面掛著可點的來源標籤,以我這組查詢來說,看得到的來源標籤多數是 developers.cloudflare.com 這類第一手文件。畫面會明確寫出「Searched the web, checked context」與「3 steps · 15 sources」這樣的執行紀錄,答案末尾直接標模型名稱與耗時:Kimi K2.6 · 39.2s。
側錄下來的網路請求乾淨得出乎意料:一輪搜尋觸發約 132 到 135 個請求,除了 scira.ai 自己,唯一的外部呼叫是 kv.better-auth.com 這個身分驗證服務的 identify 請求。搜尋當下沒有廣告、沒有第三方分析腳本在跑。附帶一提,「匿名」指的是沒有帳號,不代表零外部連線:那個 identify 請求就是帳號系統 Better Auth 的託管服務發出的。
三輪之間還有一個值得記下的差異:同一個主題,三次跑出來的步驟數從 3 到 6、來源數從 15 到 24 都有,代表它每次的規劃會隨著子查詢展開調整,不是固定的模板;但答案的結構很穩定,都是「執行摘要、分節說明、重點整理、延伸問題」四段式。
匿名狀態的代價也寫得很明白:答案完成後,畫面下方浮出一句「This chat won’t be saved · Sign in for history」,這輪對話不會被儲存,換個分頁就沒了。要歷史紀錄,就得辦帳號。
如果你照著兩年前的教學找到 mplx.run 這個網址,現在輸入後會自動轉址到 scira.ai,不用再猜它是不是關站了。GitHub 專案在 2025 年 1 月 12 日有一個提交,訊息就叫「Rebranding to Scira」,開發者 Zaid Mukaddam 的個人簡介也寫著「founder @ scira.ai」。
這段改名史對讀者的實際意義只有一個:不管你看到的是新名字還是舊名字,指的都是同一套東西。從舊名字也看得出它的出發點:極簡版的 Perplexity,連命名都直接借了對方的辨識度。專案 2024 年 8 月開張,靠這個定位累積到超過 11,900 個星標、近 1,500 次 fork,777 個提交,今天仍然是同類開源專案裡聲量最大的幾個之一。
實際跑一輪,流程是看得到的。送出問題後,畫面先顯示它把問題拆成幾個子查詢,接著各查詢分頭檢索,最後收斂成答案。以我的第三輪為例,它跑了 6 個步驟、動用 21 個來源。官方產品頁把這套流程歸納成四步:規劃、檢索、引用、行動,並宣稱兩個來源說法不一致時會把兩邊並列呈現,不替你挑邊;我在三輪實測裡沒有特別遇到衝突場景,這點當官方說法參考就好。
對應到 repo 的設計,是 17 種搜尋模式與 28 個內建工具。模式涵蓋一般網頁、X、Reddit、學術、GitHub、加密貨幣、預測市場、YouTube、Spotify 等,其中連接器搜尋、記憶、語音與 XQL 查詢四種掛在 Pro 方案下;工具則從天氣、航班、地圖、匯率、電影資料庫到 Python 程式碼沙箱都有。X 搜尋這條線特別值得一提:README 寫明 X 貼文檢索用 xAI 的 Grok 模型,輸入框下方那排模式分頁也把 X Search 放在最前面,看得出它把即時社群搜尋當主力賣點之一。你可以把它理解成一個會自己排程的搜尋助理:模型決定要查什麼、用哪個工具查,查完再讓各來源互相印證。
官方各頁面的數字有小幅漂移,引用時留意:repo 的 README 列 17 種模式,about 頁寫「18 種內建模式」,條款頁寫免費方案含 13 種搜尋模式(17 減 4 種 Pro 專屬剛好對上 13,但 about 的 18 就對不起來了)。量級一致,細節不一致,這種小漂移在快速迭代的專案裡很常見。
工具箱兩年間也換過血。以現行 README 來看,程式碼沙箱用的是 Daytona,翻譯交給 AI 模型處理,早期版本倚賴的亞馬遜商品搜尋已經不在清單上(git 歷史裡還找得到 E2B 沙箱的舊提交)。所以你在舊文章裡看到的任何功能列表,都該以 repo 現況為準。
另外兩個 2026 年才出現的入口:6 月的官方部落格發了 iOS App 與命令列工具,9 月初又發了「Scira 2」更新文。它已經從一個網頁玩具,長成有手機端、命令列與排程研究(Lookouts,會定期跑研究並寄信給你)的產品線。應用串接(MCP)則是現在的主打:官方列了 Notion、GitHub、Vercel、Stripe、Slack、Linear、Figma 等一百多個可接的應用,接上之後它們的工具會進到搜尋流程裡;任何會寫入資料的動作先徵求同意才執行,這是官方的設計宣稱,我沒有實測這一層。
順手把依賴地圖攤開,你會更清楚它「免費」的底層是什麼:網頁檢索並行用 Exa、Firecrawl、Parallel、Tavily 四家服務,YouTube 字幕走 Supadata,天氣用 OpenWeatherMap 加 Open-Meteo,地圖用 Google Maps,金融資料靠 Valyu 與 CoinGecko,物件儲存放 Cloudflare R2,限流與快取用 Upstash。託管版這些成本全由站方吸收;自架版的話,這張地圖上每一段都要換成你自己的金鑰。
Scira 的定價頁寫「免費方案一天 3 次搜尋」。但把原始碼抓下來看,匿名的額度是另一套機制:lib/rate-limit.ts 對未登入使用者設的是滑動視窗限流,7 天內 25 次請求,由 Upstash Redis 在伺服器端計數。換算下來平均一天超過 3 次,它以七天為週期滾動遞補,沒有每天歸零重算的設計。
要注意這 25 次/7 天是開源版程式碼裡的設定,線上版實際額度無法從外部驗證,我只能確認自己連跑三輪都沒被擋。兩種額度並存:不登入的訪客依開源版推算約 25 次/7 天;辦了免費帳號走 3 次/日的正式額度,而且對話會被儲存、有搜尋歷史,搜尋範圍照定價頁的寫法是 Web、Reddit、X、YouTube 四類。按開源版的設定換算,匿名額度一個月大約可用 100 次出頭,免費帳號一個月約 90 次,其實在同一個量級;差別在帳號有歷史紀錄與模式支援,匿名有彈性但什麼都不留。追問算不算一次搜尋、匿名額度何時歸零重算這類細節,官方沒有文件寫明,我只能確認自己連跑三輪都沒被擋。
還有一個實作細節值得知道:匿名限流是以 IP 計數(原始碼裡的 getClientIdentifier 直接拿代理轉送標頭裡的 IP 當鍵值)。也就是說,公司或家裡共用同一個對外 IP 的所有裝置,吃的是同一份 25 次/7 天額度;用行動網路熱點分享的場景要特別留意。
免費層的模型也有線索可循:我實測時匿名預設的是 Kimi K2.6,這是相對新的開放權重模型,走的是便宜高效的路線;Claude、GPT、Gemini Pro 這些高階模型的額度池,全在付費牆內。想先試手感,匿名額度比你想的寬鬆;要當日常工作引擎,才需要考慮帳號與付費。
「開源、可自架」是 Scira 最響亮的招牌,但把它真正架起來之前,有三筆帳要先算清楚。
金鑰是最先撞上的一筆。.env.example 列了 49 個環境變數:模型類要 OpenAI 與 Anthropic 的金鑰(README 明列必填),網頁搜尋要 Exa,X 搜尋靠 xAI;天氣、地圖、電影、航班、語音合成、Spotify 各自要對應服務的金鑰;登入要走 OAuth 的話,GitHub、Google、X 三組 client id 與密鑰也填好填滿。基礎設施同樣自己來:PostgreSQL 資料庫、Redis、Blob 儲存 token。部署路徑有三條:Vercel 一鍵部署鈕(環境變數清單一口氣帶三十多個)、Docker Compose(只包應用本體)、或本機 Node 直跑(要裝 bun 套件管理器)。等於說自架版要照著菜單採買零件再組裝,跟線上體驗是兩種東西。
版本落差是更隱形的一筆。公開 repo 的 main 分支,最後一次程式碼提交停在 2026 年 3 月 20 日,之後只有 README 換贊助版位;整個 2026 年 repo 只有 9 個提交。但線上服務顯然還在動:官方部落格 6 月發 iOS App 與 CLI,9 月初發 Scira 2。更直接的證據是模型清單:我實測時匿名預設模型是 Kimi K2.6,定價頁列著 GPT 5.6、GPT 6、Claude Opus 4.7、Qwen 3.7 Max,這些在公開 repo 的 models.ts 裡全部查無此名(repo 裡最新的同系列是 Kimi K2.5 與 GPT 5.4)。也就是說,最新的引擎只在託管版上,自架拿到的是一份落後半年的快照。
授權是第三道關。LICENSE 是 AGPL-3.0,自己關起門用沒問題;但改了原始碼又對外提供服務,就有公開原始碼的義務。想拿它做商業整合,這條先讀完再動工。
Scira 的付費設計走額度池路線,兩個等級的差別主要落在模型配額,功能面大部分相同,Max 另外獨享 AI 圖片生成與限量預覽的 Scira Agent。
Pro 每月 15 美元:搜尋無上限、全部基礎模型、Claude Haiku 4.5 不限量,Sonnet 4.6 每月 150 則、Opus 4.7 每月 30 則,OpenAI 系(GPT 5.4、5.6、6 Luna)共用每週 100 則的池子,外加 PDF 上傳、語音模式與 MCP 應用串接。學生信箱驗證後每月 9 美元(結帳時比對信箱網域),印度區走購買力平價定價 1,390 盧比。
Max 每月 60 美元:所有 Claude 模型共用每週 80 則的池子、Gemini 3.1 Pro 每月 80 則、Qwen 3.7 Max 每週 40 則,加上 AI 圖片生成與限量預覽的 Scira Agent。印度區 5,990 盧比。
重置節奏:每日搜尋在你的時區午夜重置,模型額度按週或按月重置,帳號頁看得到用量。
幾個誠實的提醒:條款寫明訂閱不可退款,取消後權益留到計費週期結束;隱私政策說得直接,你的訊息會送到他們的伺服器與推理供應商(供應商不留存提示用於訓練是官方說法,外部無法驗證);條款的準據法只寫「Scira AI 所在地的法律」,沒指明司法管轄區,聯絡管道是創辦人本人的 [email protected] 信箱。它是個人工作室等級的營運,付費前把這幾點放進考量。
這篇的實測邊界要說清楚:我跑的是匿名層,付費層的模型額度、語音模式、MCP 應用串接、Lookouts 排程研究都沒有實際訂閱驗證;自架也只讀了部署清單與原始碼,沒有真的開一台機器架起來。答案品質只抽了技術類查詢,換到醫療、法律或時事題,檢索與引用的表現可能不同。官方宣稱的規模數字(累積 500 萬次以上搜尋、10 萬人以上使用)也無法從外部核實,當行銷數字看就好;支付面倒是有兩個可以安心的小地方:官方說不儲存卡號,帳號刪除可以透過 iOS App 或寫信辦理。
維護訊號要兩面看。GitHub 議題區目前 27 個開啟項目(含合併請求),最近更新的兩個 issue(不含合併請求)分別停在 9 月與 6 月,都沒有留言討論;repo 程式碼近乎停更,但服務端持續出貨,開源版與商業版已經是兩條線。自架者要認清:你架的是開源那條線。
自架還有兩個小發現。.env.example 要你填的 PostHog 金鑰,整個程式碼裡找不到任何使用者,屬於死設定,填了也沒作用;前端倒是掛著 Vercel Analytics 元件,介意遙測的人要自己拔掉。
如果你只是偶爾要一份帶來源的整理,依開源版推算的匿名額度大約每週 25 次,連帳號都不用辦,現在就能用。每天都要查資料、需要對話歷史與更強模型的人,Pro 的 15 美元在同類服務裡不算貴,學生再砍到 9 美元。如果你想要完全自己掌控的版本,要先接受你架的是 2026 年 3 月的快照、要自己張羅 49 個環境變數與整套基礎設施,而且 AGPL 的義務跟著你。
同為開源的 Gemini Search 走的是另一條極簡路線,一支金鑰就能自架但引擎已經過時;偏好本地研究流程的話,Local Deep Research 把整個研究流程收進本機跑;Perplexity 可攜版 則代表閉源陣營的另一端。想看更大盤的開源 AI 工具地景,可以從 Awesome Open Source AI 清單找起。Scira 的位置剛好在中間:雲端版開箱即用,開源版留給願意組裝的人。