TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

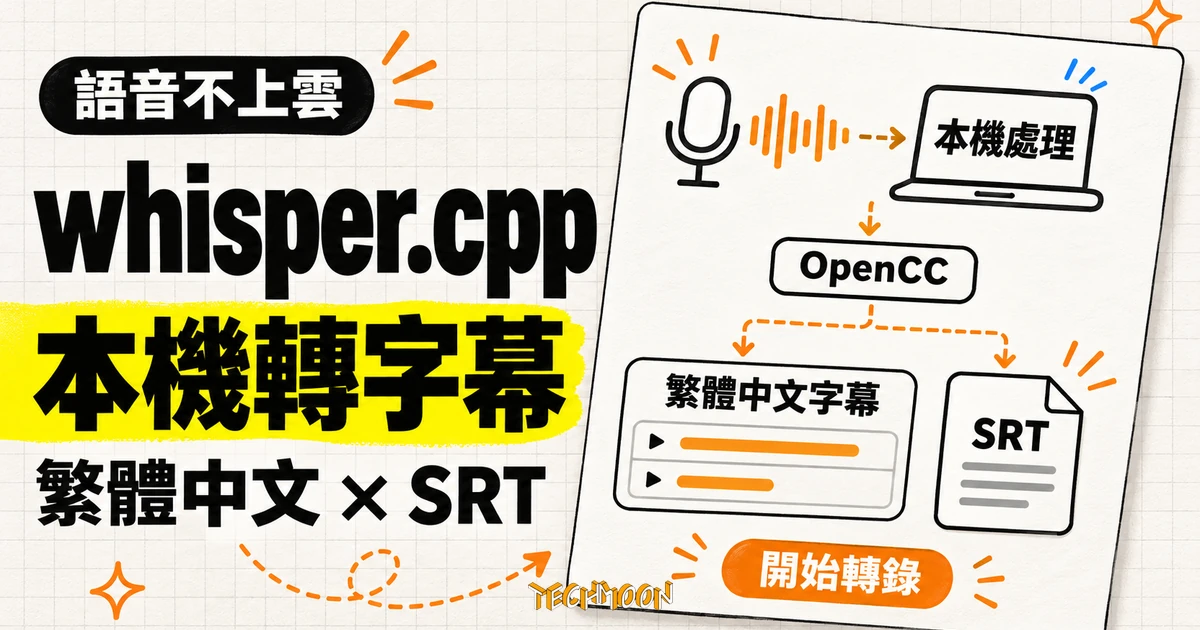
whisper.cpp 原始碼已在 2026 年 11 月 18 日推進 v1.9.6,底層 ggml 同週升上 1.0.0;v1.9.5 以來修正字幕結束時間超出音檔長度與 flash attention 填充分心的問題。在 Apple M4 Max 實際編譯跑通繁中轉錄與 SRT 輸出,整理模型大小對照、簡繁輸出行為與靜音幻覺的參數圍堵。
用 AI 摘要這篇文章:
想把會議錄音變成逐字稿,又不想把音檔送上雲端的人,多半會遇到 whisper.cpp 這個名字:OpenAI 的 Whisper 語音辨識模型,配上社群用 C/C++ 重寫的推論引擎,在 GitHub 上有超過 5.5 萬顆星,MIT 授權,可以在自己的電腦上離線轉錄。它的原始碼在 2026 年 11 月 18 日把版本號推進到 v1.9.6,底層的張量運算庫 ggml 也在同一週升上 1.0.0。這波更新對本機使用者的意義不在速度,而在輸出的正確性:字幕檔的最後一段不會再顯示超出音檔總長的時間,開啟 flash attention 之後的辨識品質疑慮也被收掉了。
我在 Apple M4 Max 上把 master 分支實際編譯跑了一遍,用 macOS 內建的繁中語音合成產生測試音檔,從編譯、轉錄到輸出 SRT 字幕走完整流程,也驗證了幾個長期困擾繁中使用者的坑。以下是這波更新的內容,加上一份目前走得通的本機轉錄路線。
先把時間軸講清楚。whisper.cpp 最近一次正式發布是 2026 年 10 月 6 日的 v1.9.5,屬於維護性版本,主要把 ggml 升到 v0.26.0。之後一個多月,開發都發生在 master 分支與每天自動產出的 nightly 版(11 月 20 日的最新 nightly 編號 b5907)。
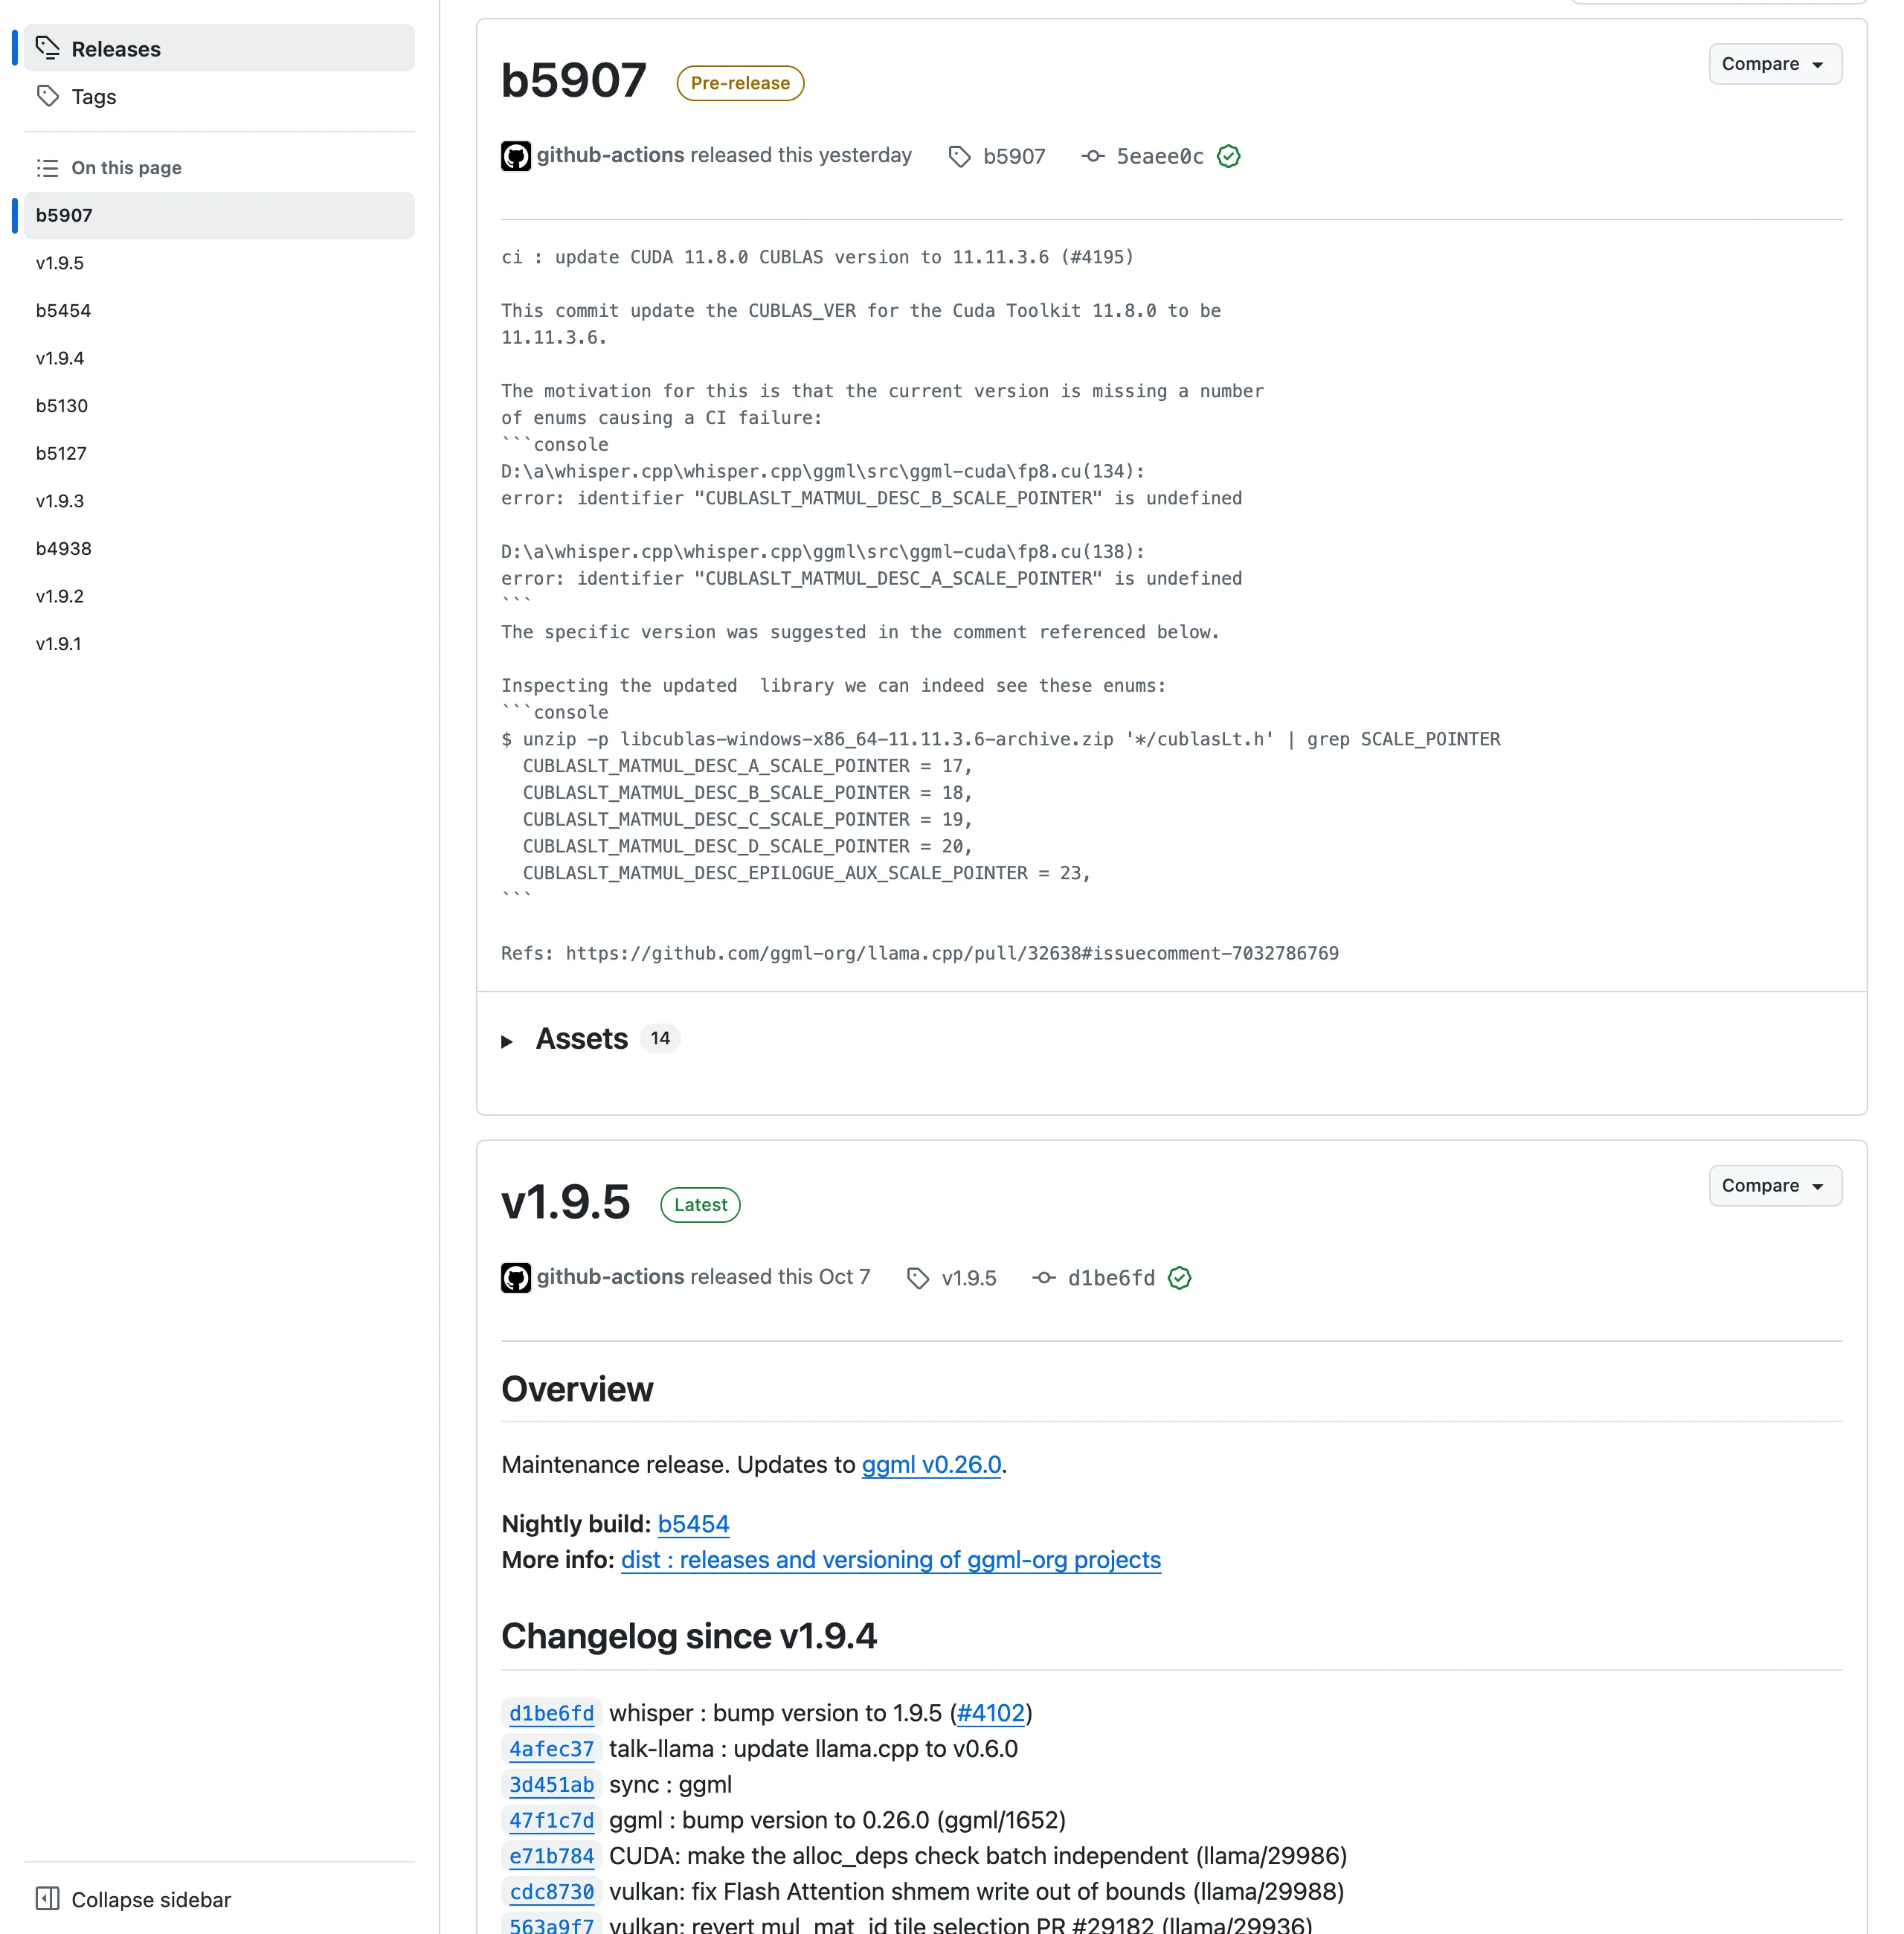
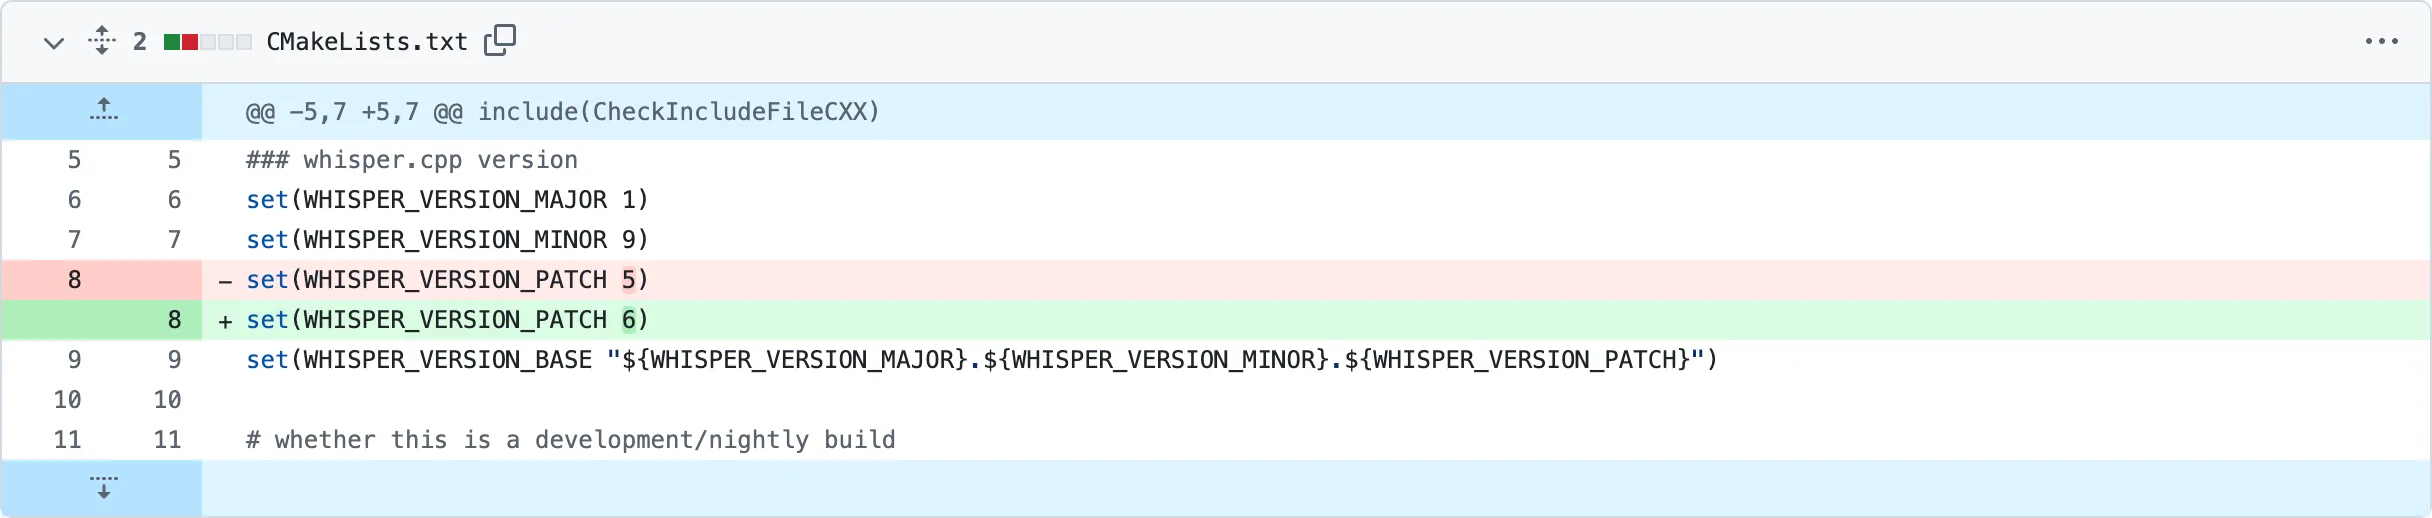
11 月 18 日,PR #4188 把 CMakeLists.txt 裡的版號從 1.9.5 改成 1.9.6。我編譯的 master 在執行時自報版本為 whisper.cpp version: 1.9.6-dev。也就是說,1.9.6 的程式碼已經定版,但截至 11 月 22 日,GitHub 上還沒有 v1.9.6 的標籤與正式 release 頁。想嚐鮮得自己編譯 master;要跟著正式版走的人,目前仍是 v1.9.5。ggml 專案體系的版號節奏是「穩定版 v1.9.x 加每日 nightly 編號 b 開頭」,release 說明裡固定附 nightly 連結,這套節奏已經跑了一年多,不貼標籤不代表開發停擺,只代表官方還沒打算凍結這一版。
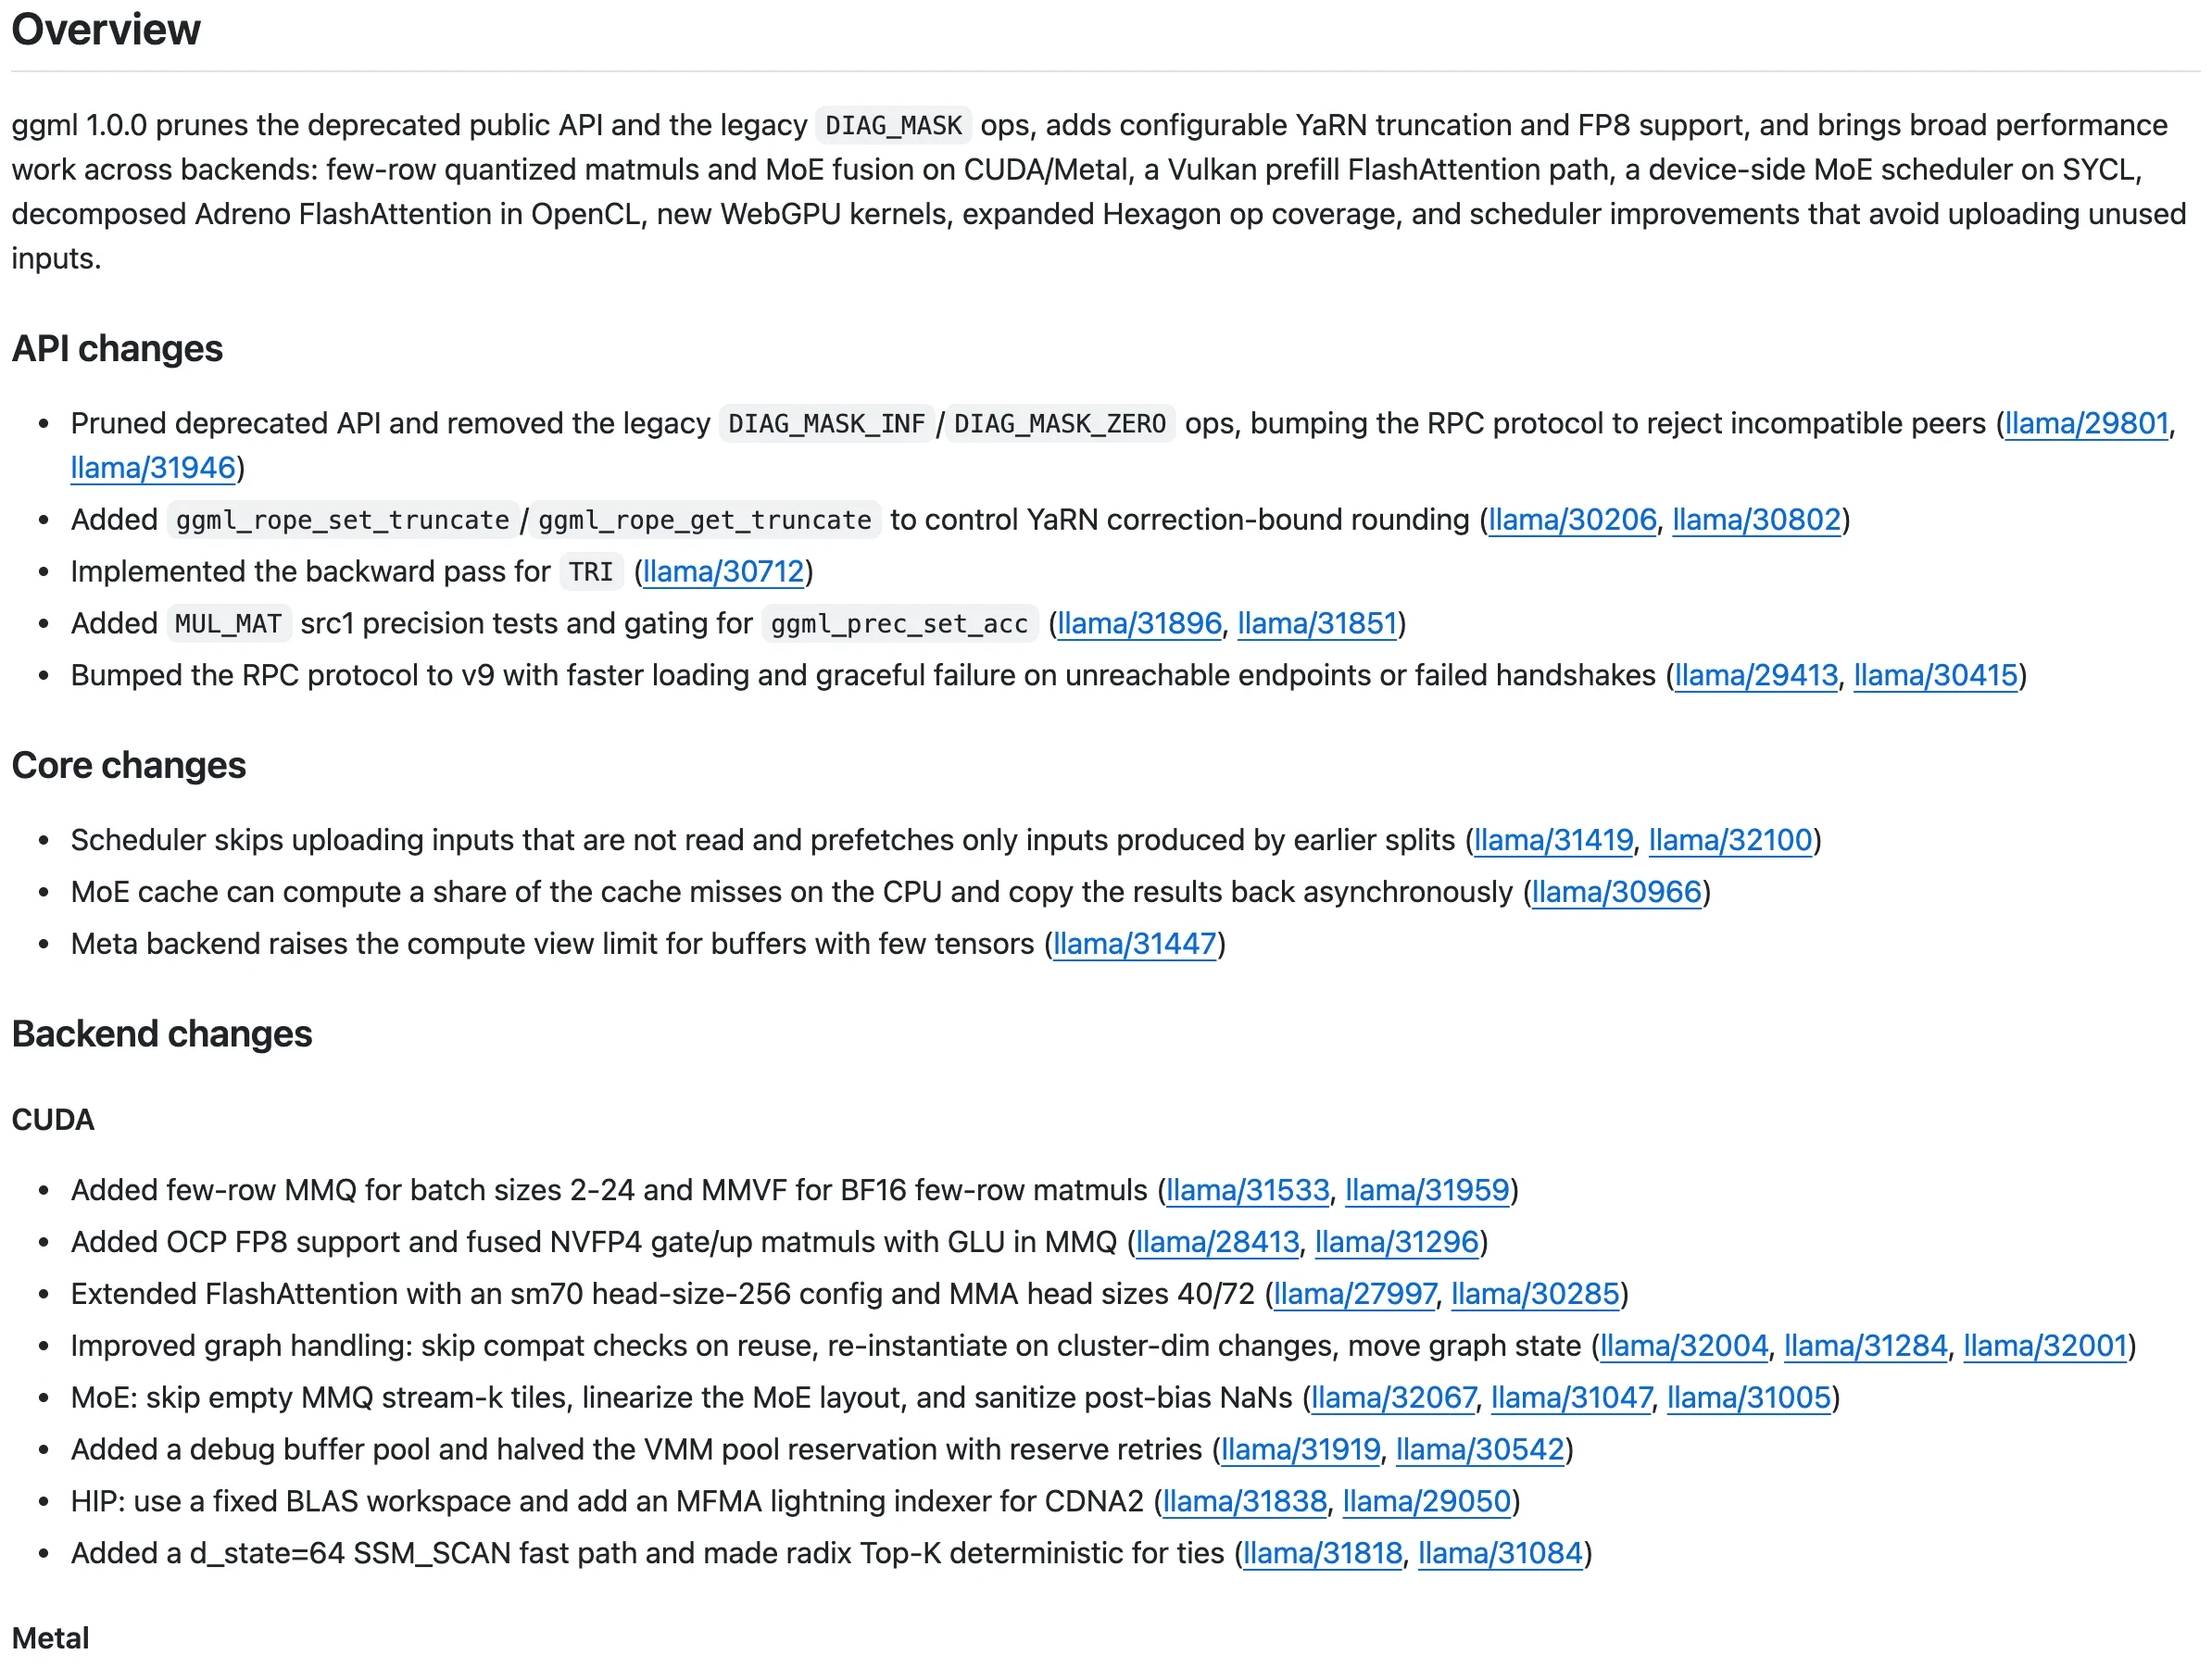
底層的變動比版號本身更值得注意。ggml 這個被 whisper.cpp 與 llama.cpp 共用的推論後端,在 11 月 13 日發布 v1.0.0,內容包括清理棄用的公共 API、移除舊的 DIAG_MASK 操作,以及把 RPC 協議升級版本號,升級後會直接拒絕與版本不相容的節點連線。whisper.cpp 在 11 月 17 日把這版 ggml 同步進來。對單機使用者,這次同步感受不到差別;但如果你透過 ggml 的 RPC 後端把運算分散到多台機器,新舊版本混用的叢集會連不上,升級必須兩端一起動。
從 v1.9.5 到現在,真正影響轉錄輸出的修正有兩個,都跟正確性有關。
其一是字幕時間軸。11 月 6 日合併的 PR #4137 把每段文字的結束時間限制在音檔實際長度以內。改動很直接:解碼時計算 audio_len(由取樣數換算的音檔長度),所有段落的結束時間戳都加上 std::min(..., audio_len) 的夾擠。在此之前,某些錄音的最後一段 SRT 會出現比音檔總長更晚的結束時間,剪輯軟體匯入後字幕會懸空掛在時間軸外面。我用 8.7 秒的測試音檔輸出 SRT,最後一段結束在 00:00:08,560,落在音檔長度 8.739 秒之內,行為與修正一致。
其二是 flash attention 的準確度。10 月 29 日合併的 PR #4127 修掉一個細節問題:whisper 的編碼器與交叉注意力在用 flash attention 計算時,注意力會「看到」為了湊整批而填充進去的 K/V 內容,修正後改用實際的上下文長度。這件事現在特別重要,因為 whisper-cli 的說明文件顯示 -fa flash attention 已經預設開啟,不想用的人要明確加 -nfa 關掉。預設值與修正搭配,等於把這條快速路徑的品質疑慮補起來。
其他變動偏向周邊:伺服器模式支援 Unix domain socket、VAD 把音檔全濾掉時語言偵測不再出錯、Windows on ARM 的編譯問題修正。單機轉錄的使用者大概碰不到,但如果你在 Windows ARM 機器上編譯老是失敗,這批修正是升級理由。不確定自己手上是哪個版本的話,whisper-cli 有 --version 參數,一行就知道;用套件管理器或別人包好的 Docker 映像裝的,版本往往落後官方版號好幾個月,對照 release 頁再決定要不要換成自己編譯。
流程照官方快速上手走。環境需要 Git、CMake 與編譯器,下載原始碼與模型需要網路,之後轉錄全程離線:
git clone https://github.com/ggml-org/whisper.cpp.git
cd whisper.cpp
sh ./models/download-ggml-model.sh base
cmake -B build
cmake --build build -j --config Release
音檔格式有個官方文件自己都不太一致的細節:whisper-cli 的說明訊息寫著支援 flac、mp3、ogg、wav 四種輸入,但主文件仍提醒「目前只保證 16-bit WAV」。穩妥的做法是先統一轉成 16 kHz、單聲道、16-bit 的 WAV,會議錄音常見的 m4a 也不例外:
ffmpeg -i meeting.m4a -ar 16000 -ac 1 -c:a pcm_s16le meeting.wav我用 macOS 內建的 Meijia 語音合成產生了一段繁中語音當測試音檔,內容是「明天上午十點,我們在員工餐廳旁的會議室討論年度預算,請記得攜帶筆電和簡報檔案」,長度 8.7 秒。跑 base 模型,首次執行含 Metal shader 編譯花了約 4.7 秒,之後同一段音檔 0.3 秒內轉完,速度不是瓶頸。對速度敏感的人可以調 -t 執行緒數;解碼端預設走 beam size 5 的搜尋,搭配溫度 fallback(解碼器沒把握時逐步提高取樣溫度重試),這組預設對安靜的人聲已經夠用,極端錄音品質再往下調。
最容易踩的坑在這裡就出現了。whisper-cli 的 -l 語言參數預設是 en,不是自動偵測。我故意不加參數直接跑,中文語音被強制當英文解碼,輸出一段流暢但半真半假的英文:「We will discuss the annual budget of the meeting in the park tomorrow at 5pm. Please remember to press the bell…」。它甚至聽懂了「年度預算」與「會議」,只是被硬拗成英文句子。中文音檔一定要帶 -l zh:
./build/bin/whisper-cli -m models/ggml-base.bin -f meeting.wav -l zh -osrt加上 -l zh 之後,這段樣本逐字全對:「明天上午10點,我們在員工餐廳旁的會議室討論年度預算,請記得攜帶筆電和簡報檔案。」但別急著放心。我另外測了一段提到季別與樓層的語音,同一個 base 模型就把「會議室」聽成「會議是」、「簡報」聽成「檢報」。同音字替換是中文語音辨識的典型錯誤,出現與否取決於說話清晰度與上下文,換更大的模型會減少,但不會消失。
-osrt 會在旁邊生成 SRT 字幕檔,另外還有 -ovtt(WebVTT)、-olrc(歌詞)、-ocsv、-oj(JSON)等格式,逐字稿與字幕可以一次一起出。做字幕有幾個順手的參數:-ml 限制每段最長字數,段落切分更貼近字幕閱讀節奏;-sow 改以詞為單位切分;--print-confidence 在輸出標上信心度,低信心段落直接列成校對清單。字幕時間軸想更細的話,-dtw 參數可以對齊到 token 層級的時間戳,做雙語字幕或卡拉OK式字幕時用得上。所有選項跑 ./build/bin/whisper-cli -h 都查得到。
官方文件給的帳是兩欄式的,磁碟空間與執行記憶體不是同一個數字:
| 模型 | 磁碟 | 執行記憶體 |
|---|---|---|
| tiny | 75 MiB | 約 273 MB |
| base | 142 MiB | 約 388 MB |
| small | 466 MiB | 約 852 MB |
| medium | 1.5 GiB | 約 2.1 GB |
| large-v3 | 2.9 GiB | 約 3.9 GB |
| large-v3-turbo | 1.5 GiB | 官方表未列 |
| large-v3-turbo-q5_0 | 547 MiB | 官方表未列 |
幾個選法上的判斷。名稱帶 .en 的是純英文版,中英混合的會議直接選多語版。tiny 到 small 適合即時聽寫與長時間批次處理;large-v3-turbo 是蒸餾後的變體,Hugging Face 上的模型檔標註總參數量 8.09 億,檔案只有 large-v3 的一半出頭,官方把它列在下載腳本的預設選項裡,多數場景的精度與速度取捨它已經是好選擇。空間吃緊可以再壓:whisper.cpp 內建 quantize 工具,一行指令把原版模型轉成 q5_0 量化版,547 MiB 的 turbo-q5_0 就是這樣來的。./build/bin/quantize models/ggml-large-v3-turbo.bin models/ggml-large-v3-turbo-q5_0.bin q5_0,轉換一次幾分鐘,之後每次轉錄都吃量化版。
我的實測只代表 M4 Max 這台機器:base 模型轉 8.7 秒音檔的速度遠高於即時。Apple Silicon 上還有一條官方宣稱的路徑:開 Core ML 支援後,編碼器可跑在神經網路引擎(ANE)上,官方給的數字是比純 CPU 快三倍以上。這是官方文件的自述數字,我這次沒有另外儀測。如果你要問的是「我這台電腦跑不跑得動」、「該不該為了轉錄買顯卡」這種硬體帳,Xeon 6 白皮書分析把模型檔大小、記憶體地板與併發分流算得更細,單機聽寫與多併發服務的分流判斷可以直接套用。
繁體中文使用者真正在意的幾件事,參數能解決一部分,剩下的要靠流程。
字體沒有保證。 我的真實語音樣本輸出繁體,但同一支程式、同一個模型,餵它十秒純靜音,它幻覺出四段重複的文字,而且以簡體輸出(「我沒想到你會做的事嗎」這個等級的句子)。字體連同用字一起由解碼器決定,你能影響它,不能指定它。社群的慣用手法是 --prompt 塞一句目標字體的句子當初始提示,whisper.cpp 的 issue 追蹤這件事追了三年(#1450、#788,上游原始討論串是 OpenAI Whisper 倉庫的 #277)。我實測 --prompt "以下是繁體中文的逐字稿,使用全形標點與國字數字。",效果是真的但不穩定:一段樣本的「3點」被改成「三點」,另一段的「10點」紋絲不動。這與 issue #788 標題裡「not works stable」的自述一致,提示影響的是傾向,不是規則。
所以要輸出穩定的繁體,務必再加一層決定性轉換。OpenCC 是 Apache-2.0 授權的簡繁轉換工具,在 GitHub 上超過一萬顆星、仍在維護,npm 與 pip 都裝得到命令列版本。關鍵在設定檔選 s2twp:它做的是「簡體到台灣繁體」的片語級轉換,不只換字,還把大陸用詞換成台灣慣用語。這層是規則式轉換,結果可預期、可重現,跟解碼器的機率輸出是兩回事。
幻覺要靠參數與 VAD 圍堵。 剛才的靜音測試就是官方文件警告的場景:對著音樂或靜音,解碼器會生成流暢的假句子,「重複整行」是典型症狀,官方文件還點名這種假句子常以中日韓文字出現,就算全片沒有半句中文也一樣。官方建議的組合包括固定 -l 語言、-sns 抑制非語音 token、-nf 關掉溫度 fallback、收緊 -et 與 -lpt 兩個信心門檻。我把 -sns -nf -et 1.0 疊上去重跑靜音,幻覺段變少、變晚,但沒有歸零,這個樣本仍然漏出四段短句。更根治的路是 VAD(語音活動偵測):官方提供下載腳本抓 Silero VAD 模型(sh ./models/download-vad-model.sh silero-v6.2.0),執行時加上 --vad -vm 指定模型,先把非語音段切掉再送解碼。根本不進解碼器的音段,就無從幻覺。會議錄音有大量停頓與片頭音樂的,這層值得開。
同音字與專有名詞只能人工回聽。 「會議是」與「檢報」這種錯誤,任何參數都救不了,因為模型聽到的聲音就是那樣。人名、公司名、數字金額這些會被引用的內容,對著音檔抽查回聽是唯一可靠的驗證。標點也一樣:我的繁中輸出全部是半形逗號,直式排版或正式文件要再跑一次標點轉換。這也是為什麼自動字幕可以拿來當草稿,不該直接當成品。
v1.9.6 的正式 release 何時貼標籤,官方沒有給日期,nightly 每天在出,盯著 releases 頁面最準。ggml 1.0.0 的 RPC 協議拒絕舊節點,混版本叢集的實際陣痛要等更多部署案例才看得出規模。上游的 OpenAI Whisper 倉庫本身則處於靜態:11.3 萬顆星,最近一次推送停在 2026 年 8 月 31 日,沒有新模型、沒有新 release,模型端的演進現在都發生在 v3-turbo 之後的蒸餾與量化變體,而推論端的新花樣,即時串流(stream 範例)、網頁版(whisper.wasm)、Neovim 整合、HTTP 伺服器模式,全都長在 whisper.cpp 這側。
授權與專案狀態:whisper.cpp 與 OpenAI Whisper 都是 MIT 授權,商用沒有障礙。文中的版本、星數與模型大小以 2026 年 11 月 22 日查核為準;12 月中再查一次 releases 頁面,就能知道 v1.9.6 正式出了沒。
如果你要的是把影片或長錄音批次丟上去的現成工具,而不是命令列,之前介紹過的 YouTube 影片逐字稿工具與自架 Whisper API 的 GPU 實測走了不同的包裝路線;日常聽寫輸入則可以看 QuQu 這類以 Whisper 為引擎的本機語音輸入工具。引擎同一顆,差別在你想要多少控制權。