TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

LLM 教育者 Sebastian Raschka 在 11 月 15 日免費公開位置編碼七節圖解教學,從 GPT-2 的位置向量講到 RoPE 旋轉與 PyTorch 實作,並用他自己的架構圖庫統計 2026 年模型的位置編碼選擇:全 RoPE 仍最多但連續下滑、RoPE 模型中 partial RoPE 過半、RoPE 與 NoPE 混合增加。本文對照模型設定檔與三篇論文核實關鍵數字,整理學架構與選模型兩種讀者的取用方式。
用 AI 摘要這篇文章:
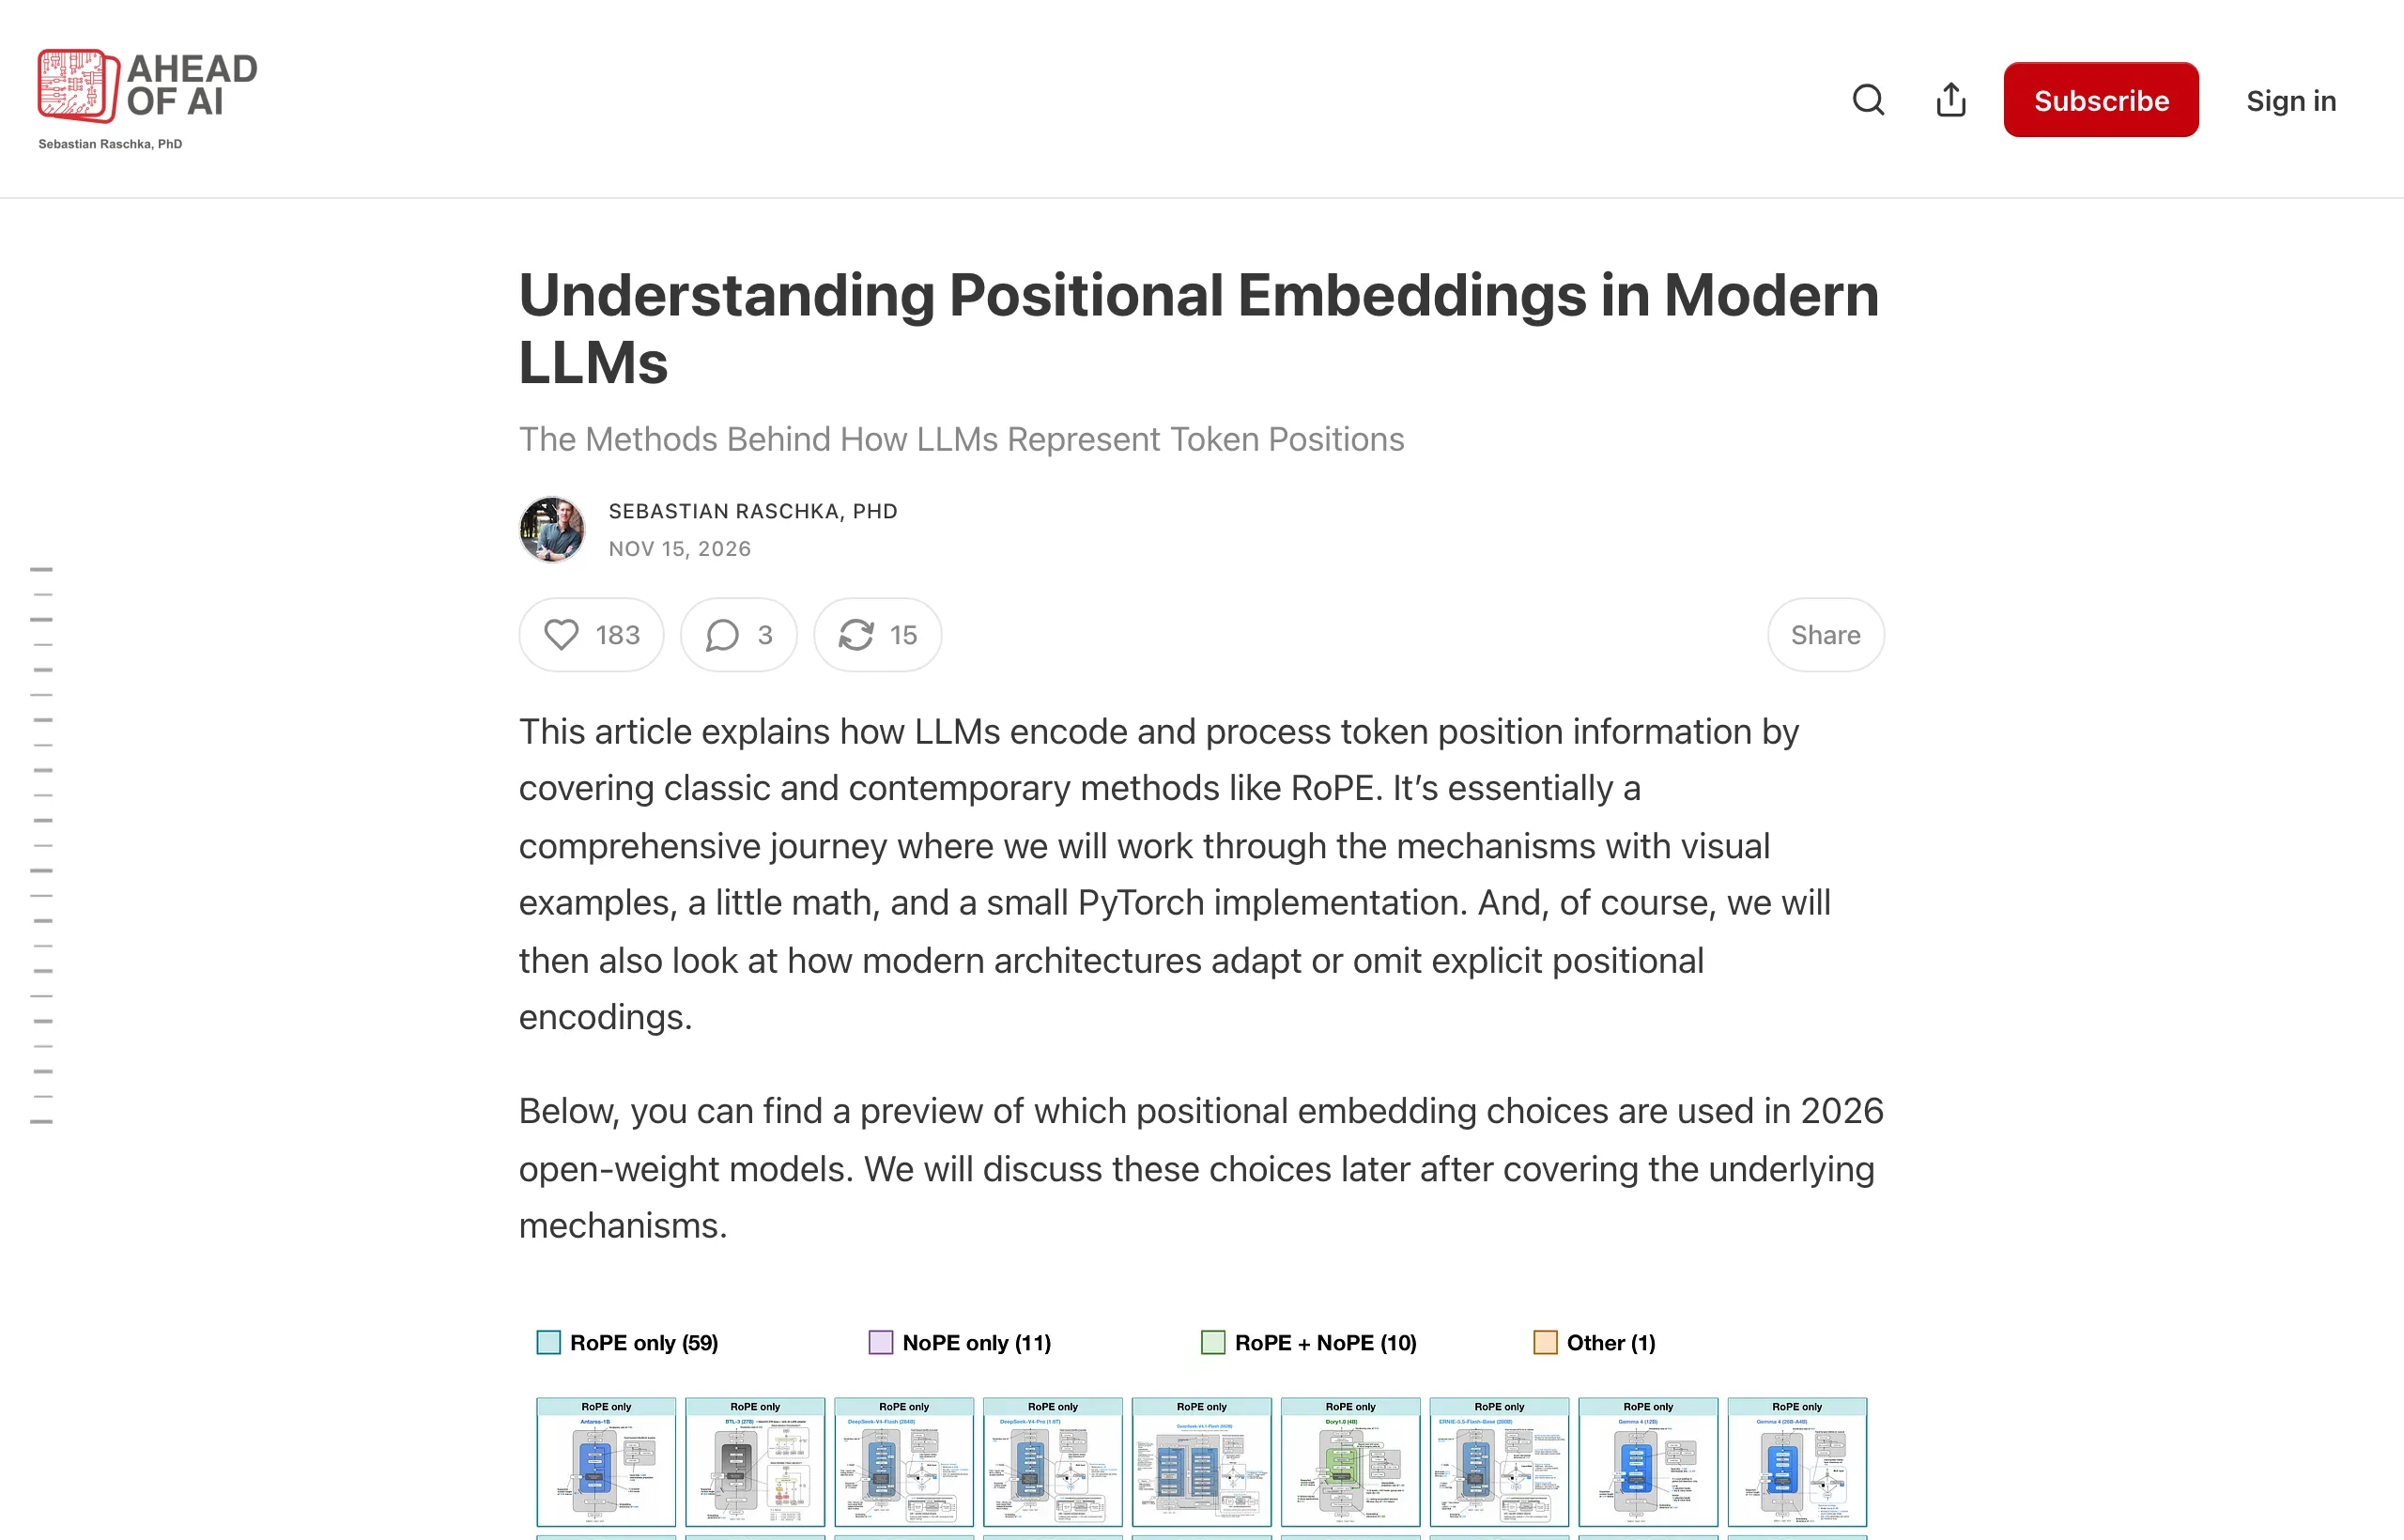
2026 年 11 月 15 日晚間(台北時間 20:10),以《Build a Large Language Model (From Scratch)》一書與 Ahead of AI 部落格聞名的 LLM 教育者 Sebastian Raschka 免費公開長篇教學《Understanding Positional Embeddings in Modern LLMs》,用七節篇幅、大量圖解、少量數學與可以直接執行的 PyTorch 範例,把語言模型怎麼「看見」詞序這件事從頭講了一遍,一路講到 2026 年各家開放權重模型實際採用的位置編碼選擇。
位置編碼是長上下文時代最容易被略過的基礎零件。模型介紹常停在「支援百萬 token」,但位置訊號怎麼進到注意力、為什麼 2026 年的新模型開始只旋轉一部分特徵、甚至某些層完全不放位置編碼,多數產品文件不會告訴你。這篇教學剛好補上這一層,而且附了一份別人給不了的東西:Raschka 用自己維護的模型架構圖庫統計出的 2026 位置編碼趨勢。
對台灣讀者,這篇報導整理教學的內容地圖、幾個可以獨立核對的數字,以及學架構與選模型兩種讀者各自該抓的重點。
Raschka 在開頭自述這篇的由來:他原本在準備今年的 LLM 架構趨勢總整理,寫著寫著發現位置編碼這塊自己從來沒寫過,而讀者敲碗 RoPE 教學已經很多年,於是把塵封的舊草稿翻出來,整理成獨立的一篇,讓之後的趨勢文有地基可以引用。
全文七節,結構是:位置訊號在哪進入模型、加在輸入端的絕對位置向量、用旋轉編碼相對位置的 RoPE、旋轉頻率怎麼算、RoPE 的 PyTorch 實作、現代架構的位置編碼選擇,最後是結語。教學全文免費公開,網頁版左側還帶導覽列。他也在開頭誠實提醒:這篇比他平常的文章技術得多,假設讀者已經理解注意力裡的查詢(query)、鍵(key)、值(value);不熟的人可以先看他的自注意力教學,或者他的書《Build a Large Language Model (From Scratch)》。已經懂位置嵌入的讀者,他建議直接跳到第六節看 2026 年架構怎麼選。
已經在學 LLM 架構、想先補中文基礎的讀者,也可以搭配浙大出版的《大模型基礎》免費中文教材一起看,那本書同樣從注意力與嵌入講起。
順帶一提,他這次同時宣布開始試用 Substack 的訂閱加值制度(perks),把架構圖庫的圖檔匯出與詮釋資料開放給付費支持者取用,對於拿他的圖做簡報或教學的人是個新的授權管道。
Raschka 的原文例子是兩隻狐狸:The red fox jumps over the gray fox(紅狐狸跳過灰狐狸),把 red 與 gray 對調,跳與被跳的對象就換了人。兩個 fox 切出來的 token 相同、初始嵌入相同,如果注意力只看內容不看位置,這兩句話在模型眼裡沒有差別。
讓模型分得出先來後到,多年來有幾條主要路線。最早的路線是 GPT-2 的做法:替每個位置學一個向量,直接加到那個位置的詞嵌入上,在進入第一層轉換器之前就混好。GPT-2 準備了 1,024 個位置向量,上下文要拉長就得擴表。Raschka 試算給了一個具體感受:GPT-2 Medium 的位置嵌入在 1,024 位置只佔全部權重的 0.30%,但如果照現在常見的十萬級上下文去擴,位置嵌入會膨脹到超過模型總權重的 22%,非常不經濟。
2017 年原始 Transformer 的做法是位置向量改用固定的正弦與餘弦函數產生,同樣加在輸入端。當年論文的假說是:固定偏移 k 之後,位置 2 到 5 與位置 102 到 105 都差 3 格,這 3 格對應到同一個確定的旋轉,注意力因此容易學會「往前三格」這類相對關係。固定公式的好處是任何位置都算得出值,不需要為新位置學新參數;但算得出來只代表數值有定義,不代表模型在訓練時沒見過的長度上表現會好。
現在的主流則是 RoPE(Rotary Position Embedding,旋轉位置編碼),Su 等人 2021 年在 RoFormer 論文提出。位置不再碰輸入端的嵌入,而是在每次計算注意力時,按各 token 的位置旋轉查詢與鍵,值向量維持原樣,相對距離因此直接進入查詢與鍵的點積。附帶一提,2026 年的開放權重模型 Inkling 走了另一條支線,用學習出來的相對位置偏置直接加在注意力分數上,這個概念可以追溯到 2019 年的 T5,後面會再回到它。
RoPE 的旋轉以「成對」為單位:注意力頭裡的特徵兩兩配對,每一對按自己的頻率轉。頻率公式是 θ = b 的 −2i/d 次方(i 是配對編號、d 是頭維度),原論文取 b=10,000,一個 128 維的頭因此有 64 對特徵。可以把這想成一組轉速不同的指針:有的指針每前進一格就轉很多,有的幾乎不動,於是同樣的距離能用多種尺度參與比較。
這些旋轉角度的餘弦與正弦值非常便宜:1,024 個位置、128 維的頭,兩張表各是 1024 乘 64 的大小,所有注意力頭共用,整個模型算一次就能一路重複用。Raschka 說這表便宜到存進權重檔都嫌浪費。
相對距離怎麼影響注意力分數,他的玩具算例很好懂:假設每前進一個位置轉 20 度,位置 5 的查詢轉了 100 度、位置 2 的鍵轉了 40 度,兩者相差 60 度,點積是 26 乘以 cos(60°),等於 13。把鍵移到位置 3,相差變成 40 度,點積跳到大約 19.92。距離一變,注意力分數立刻跟著變,前後關係就這樣進了計算。
RoPE 最常被引用的性質是共同平移不變:兩個 token 一起往後移(例如句子前面加了 100 個 token 的系統提示),兩邊各多轉相同的角度,角度差不變,點積也不變。相對關係不受前綴長度影響,這是它取代絕對位置向量的核心賣點。
但 Raschka 特地用圖說標出這條性質的前提:查詢與鍵在旋轉之前的數值要固定。真實模型裡,新增的前綴會改變每一層注意力看到的內容,查詢與鍵的數值也會跟著變。數學上的平移性質,不能推成「加長提示之後回答完全一樣」。
這也是整篇教學最值得帶走的分界線:頻率公式對任何位置都有定義,但「算得出」與「學得好」是兩件事。模型能不能用好更長的文件,取決於訓練時見過的長度與實際測試。看到上下文視窗的數字時,先分清楚那是允許輸入的上限,還是每個角落都同樣可靠的保證。真要把上下文拉到千萬 token 級的訓練,第一個碰到的難題就是記憶體怎麼分攤,這與位置方法能不能延伸同屬工程現實。
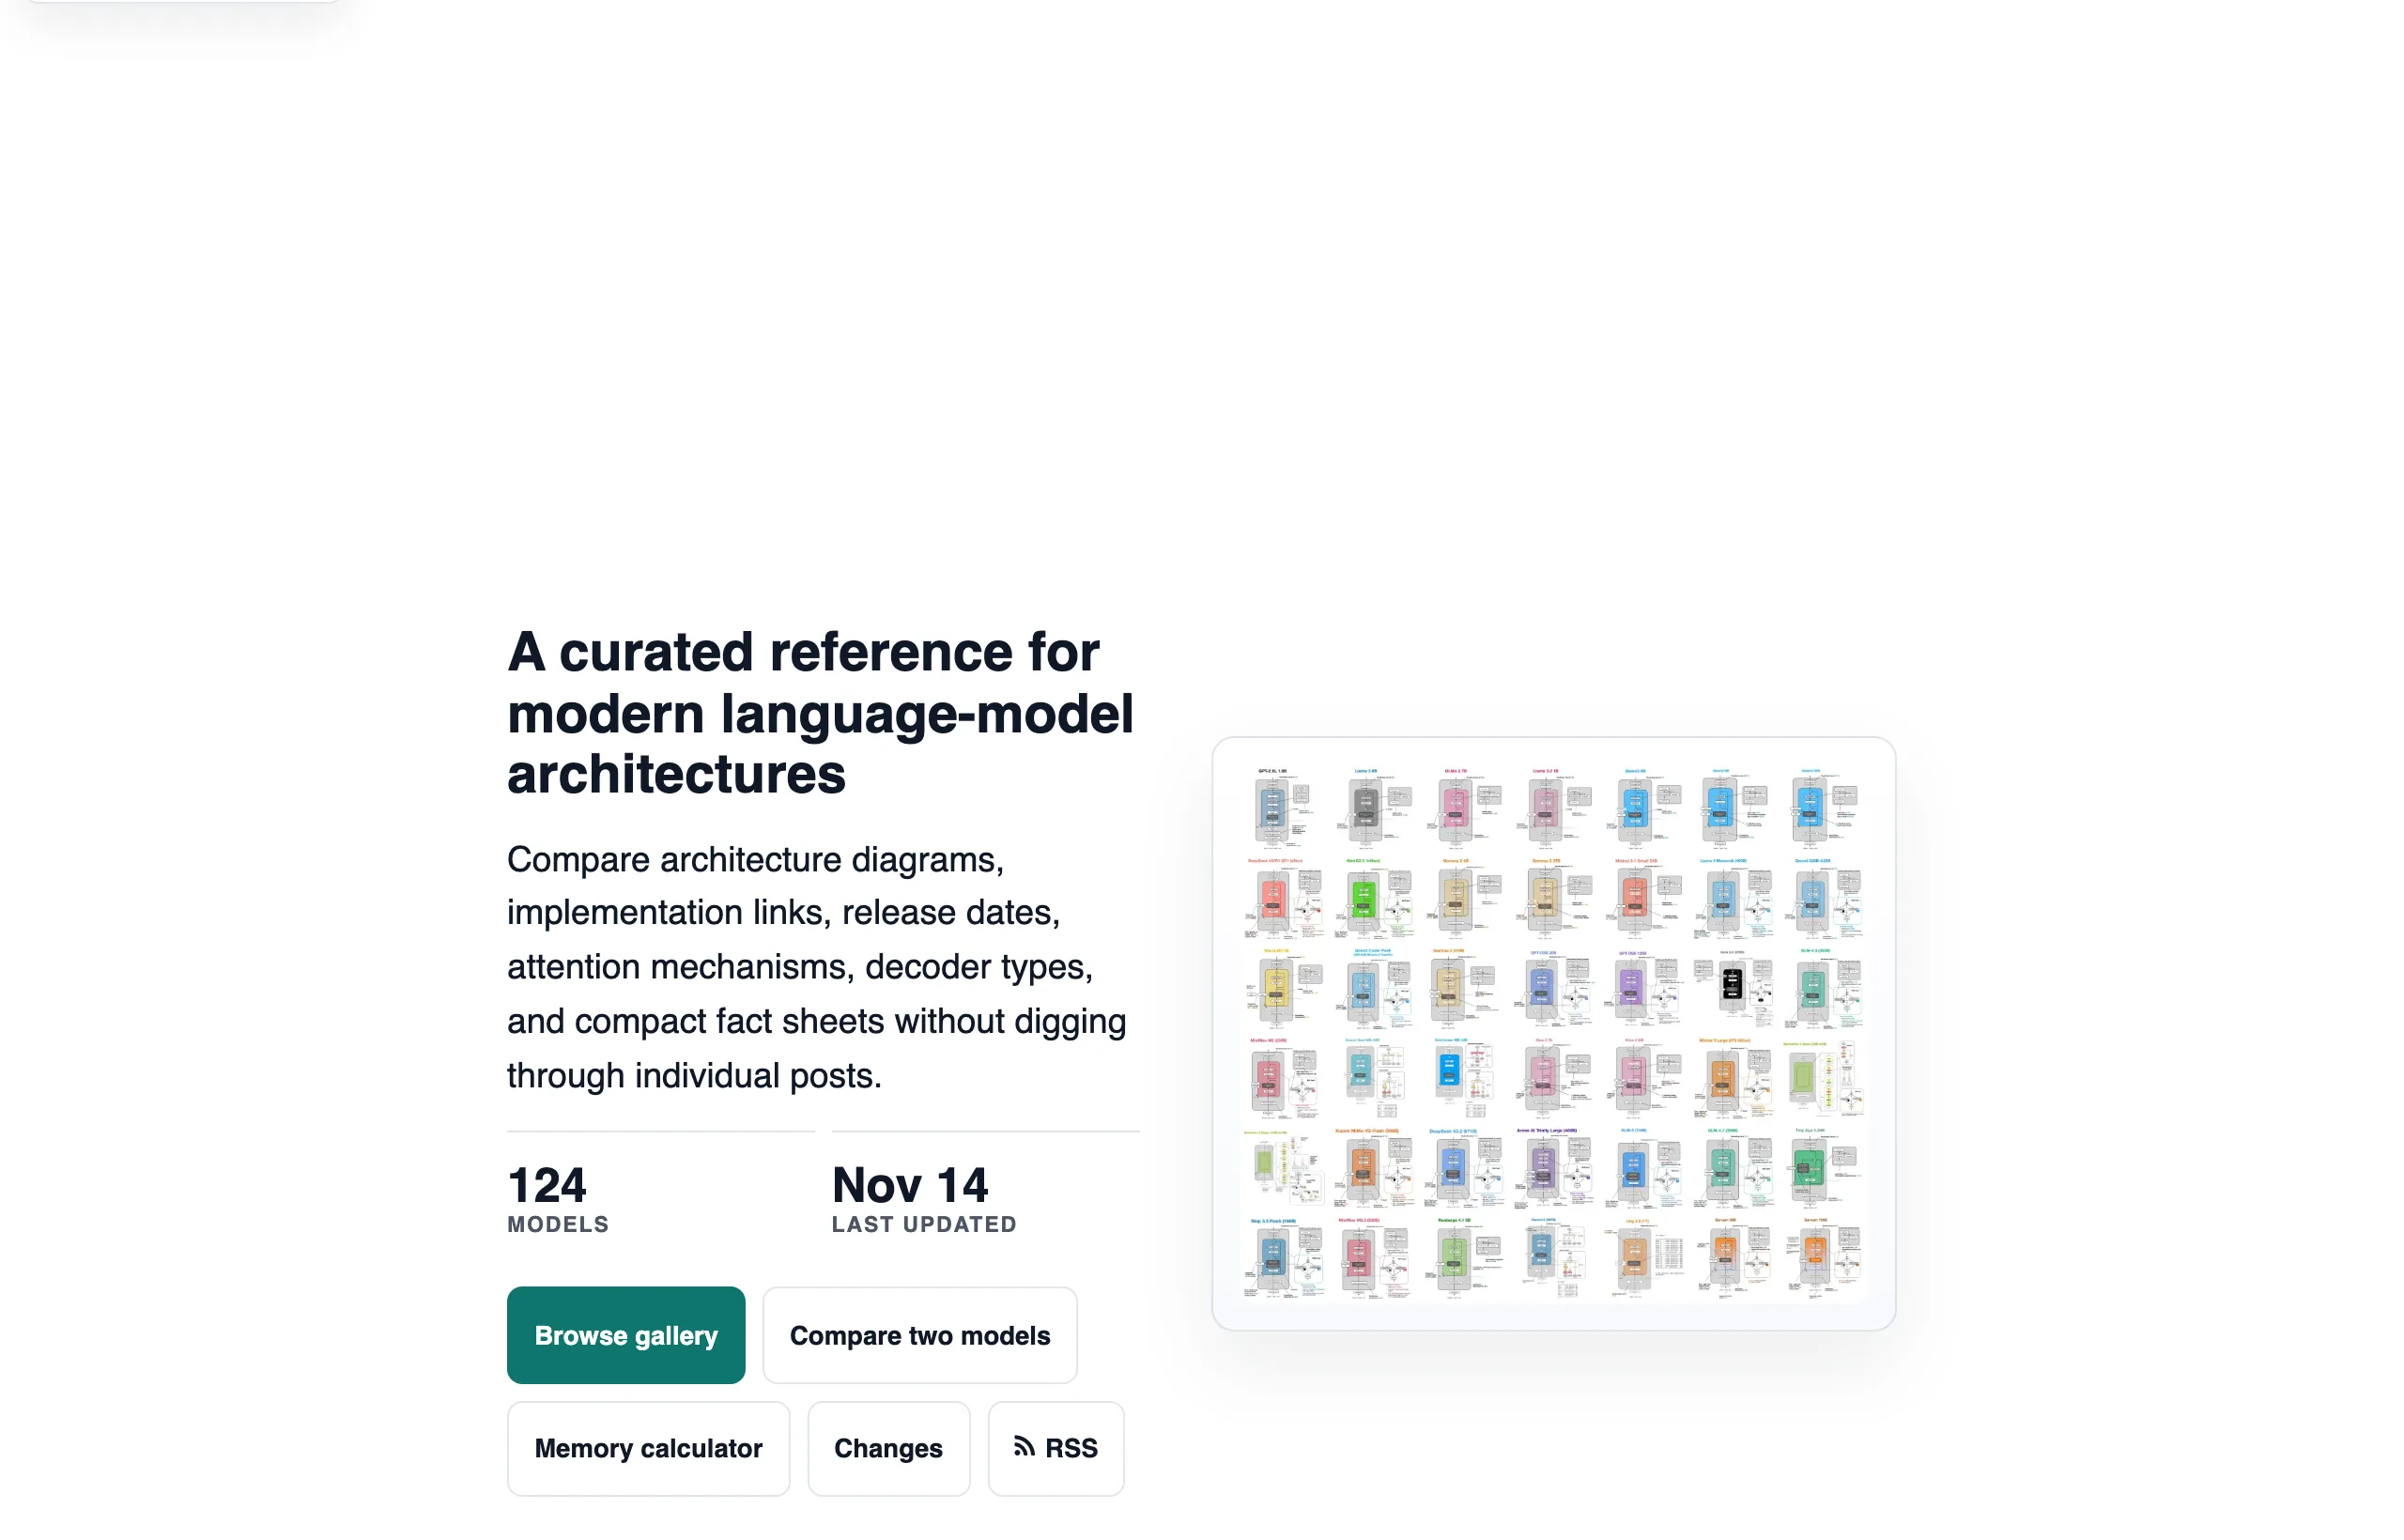
教學第六節是最有新聞性的一段。Raschka 把他維護的 LLM Architecture Gallery(收錄 124 張模型卡,11 月 14 日更新)裡的模型卡按發布日期分組(每張卡計一次),比較 2025 年與 2026 年前後兩批。幾個結論:每個 softmax(把注意力分數正規化成權重)注意力層都完整使用 RoPE 仍是最常見的選擇,但佔比從 2025 到 2026 連續下滑;在用 RoPE 的模型裡,只旋轉部分特徵的 partial RoPE 從少數派變成兩個 2026 分組的多數;RoPE 與 NoPE(無顯式位置編碼)混合使用的模型在增加;只用 NoPE 的條目全部是循環混合架構;完全不靠 softmax 注意力的 xLSTM,以及用學習偏置的 Inkling,另成一類。他也老實說,這些群組還小,趨勢會不會延續難講。
具體模型可以對照公開設定檔核對:
| 模型 | 位置做法 | 可核對的設定 |
|---|---|---|
| MiniMax-M3 | 每個 128 維頭只旋轉 64 維(partial RoPE) | config.json:head_dim 128、rotary_dim 64、位置上限 1,048,576 |
| SmolLM3(3B) | 36 層裡每 4 層跳過 1 層 RoPE | config.json:no_rope_layers 陣列以 1,1,1,0 循環 |
| Inkling(975B) | 學習式相對位置偏置加在注意力分數上 | Raschka 教學的解說;Thinking Machines 頁面標示 975B |
partial RoPE 的帳值得攤開。對照 Hugging Face 上的設定檔,MiniMax-M3 確實是每個 128 維的頭只旋轉 64 維。省下來的是餘弦與正弦表:Raschka 試算,支援一百萬位置的表在 BF16(16 位元浮點)存放從 64 欄砍到 32 欄,省 0.134 GB;改用 NVFP4(4 位元浮點)存再壓到 0.038 GB。但鍵值快取(KV cache)存放的仍是完整的鍵與值,記憶體的大頭一點都沒動;真要壓長上下文的記憶體,得從 KV 快取與硬體協同設計下手。
品質端也有新證據。2026 年 3 月的論文《Fractional Rotation, Full Potential?》(Khan 等)用 1B 到 8B 的模型做實驗,發現每頭只旋轉大約 10% 的特徵,訓練損失與基準成績常與全 RoPE 相近,但全 RoPE 在部分評測仍然較好。Raschka 的評語寫得很直白:partial RoPE 不太值得(hardly worth it)。
NoPE 這個名字指的是沒有顯式位置編碼,但它不代表模型不知道順序。因果遮罩(每個位置只能看自己與之前的 token)本身就攜帶順序訊號,Raschka 給了一個可推導的例子:某個值特徵只在第一個 token 上是 1,在均勻注意力下,每個位置的輸出就是 1 除以可見前綴的長度,後面的層可以拿它當位置訊號用。拿他的狐狸句當例子:The 這個值特徵讓 fox 位置的輸出是 1/3,讓 jumps 位置的輸出是 1/4,越後面越小,這就是一個現成的位置刻度。2023 年的 NoPE 論文(Kazemnejad 等)用 107M 的小模型在十項任務上做長度外推實驗,NoPE 綜合排名第一,贏過 RoPE;另一個 1.3B 的程式碼模型也能外推到訓練長度之外,只是最長的測試點上表現變差。
SmolLM3 的選擇是混合式:3 層用 RoPE、第 4 層跳過,循環 36 層。官方在模型說明裡提過,這個每四層跳一層的模式改善了長文表現。同理,某一層跳過旋轉時,位置訊號仍會從前面的層傳下來,理解設定時要沿整條運算路徑看。
至於 Inkling,這個 975B 的開放權重模型在滑動視窗與全域注意力層都用學習式相對位置偏置:算出查詢與鍵的縮放點積後,依「鍵在查詢前面幾格」與查詢的隱藏狀態算出一個偏置值,加進分數再做 softmax。用狐狸句來說,查詢在位置 5、鍵在位置 2,模型就用這三格的間距加上查詢內容,決定這個分數要往上加多少。這不是新發明,T5 在 2019 年就用過簡化版。位置訊號不一定要靠旋轉,直接調整分數也是一條活路,而 Raschka 預測 2027 年可能出現更多這類設計。
正在學架構、會碰程式碼的讀者,直接進教學第五節:RoPE 的 PyTorch 實作從頻率表、旋轉函數到放進因果注意力一步不缺,另外他還有 Qwen3 從零實作的完整 notebook 可以對照。這裡有個容易踩的坑值得先記住:特徵配對有兩種約定,主流實作用前後半配對(split-half),RoFormer 原論文與 LLaMA v1 用相鄰配對(interleaved)。兩者在數學上等價,把特徵順序重排(例如 1,2,3,4,5,6,7,8 排成 1,5,2,6,3,7,4,8)之後點積完全相同;但模型權重是照其中一種訓練出來的,直接套用到原始向量會算出不同的注意力分數,改設定或換引擎前先對照訓練時的配對方式。
主要在挑模型、不寫程式的讀者,把位置編碼當理解視角就好,不必當成排名依據。看到 NoPE 不必直接判死,看到 partial RoPE 別期待它省記憶體,看到百萬上下文的宣稱先問那個長度被驗證過什麼。想自己驗,一個樸素的做法是:準備一份有明確答案的長文件,第一輪只給需要的段落,第二輪在前後塞進干擾內容、保持答案位置不變,觀察模型是否還能找對。真正影響體驗的是你自己的文件在該模型上的表現,連同等待時間與費用一起看;若縮小來源仍能答對,就沒有必要為了用滿上限而餵進不相關內容。
最後是回查點。LLM Architecture Gallery 是活頁面,統計會隨新模型進場更新;Raschka 也預告年度架構趨勢文正在路上,屆時回頭對照這篇的趨勢數字最自然。他自己的預測是:RoPE 到 2027 年仍會是主流位置編碼,Inkling 式的學習偏置設計可能變多。