TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

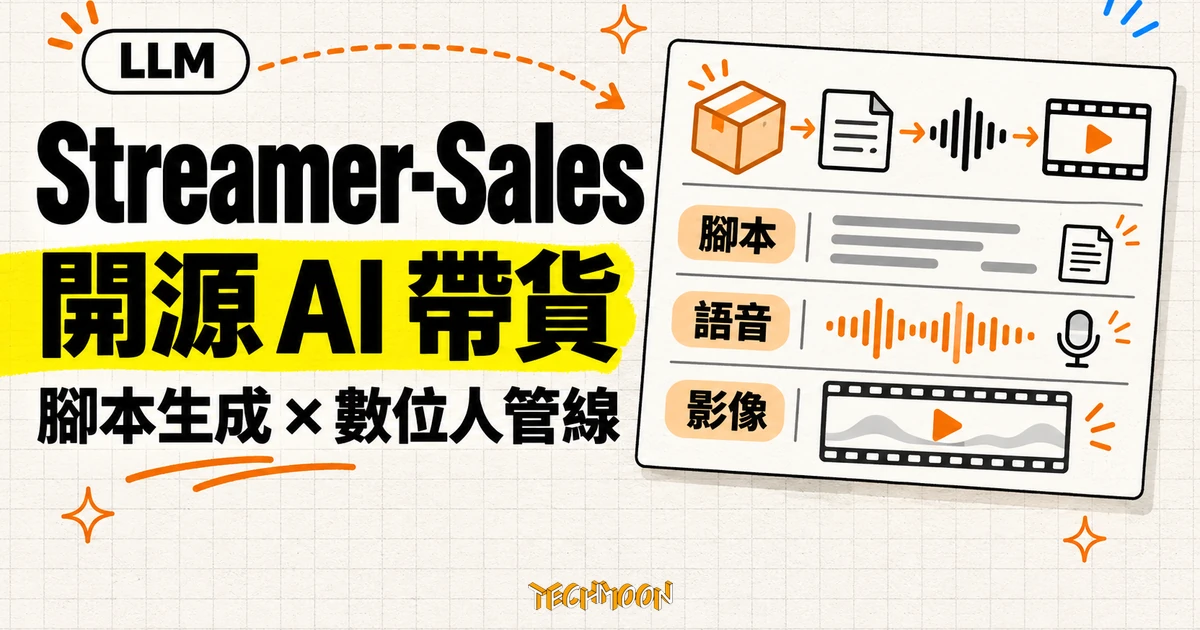
Streamer-Sales 把帶貨文案生成、RAG 說明書檢索、TTS 語音與數位人影片整條直播管線開源,3,800 星的專案停在 2025 年 3 月、官方示範頁已下架;想接手自架,先看懂硬體門檻、五服務部署與 AGPL 授權義務。
用 AI 摘要這篇文章:
想做直播帶貨的賣家,卡住的地方通常很具體:請不起每天能開場的主播,也寫不出每項商品都講得下去的腳本。市面上的解法多半走向訂閱,月費型的數位人平台或AI 文案服務,產能問題換成帳單問題。GitHub 上另一條路是 Streamer-Sales:一個 3,800 多星、把「寫腳本、念稿、生成主播影片」整條流程開源的專案,2024 年還在浦源大模型挑戰賽夏季賽拿過創新創意賽道第一名(專案自述的得獎紀錄)。聽起來像省錢捷徑,但動手前有件事要先講:它的開發停在 2025 年 3 月,官方示範頁也已經下架。接手之前該算的帳,下面一次攤開。
Streamer-Sales 是 2024 年 4 月開源的中國專案,核心是一個名為「樂樂喵」的 7B 語言模型:作者用 xtuner 在 InternLM2-chat-7B 上做指令微調,訓練語料約 40 萬 token,目標單一明確,餵它商品資訊,它從激發購買意願的角度寫出帶貨解說詞。模型之外,整個專案其實是一套完整的系統:Vue 前端、FastAPI 後端、PostgreSQL 資料庫、JWT 登入驗證,最後用 docker compose 打包成一鍵部署。
連訓練資料怎麼來的都交代了。專案內含完整的資料生成流程,還附了一支說明書生成腳本,把商品網頁上的圖片送進光學字元辨識,再讓語言模型整理成結構化的說明書,等於把「找語料」這一步也做成了半自動。上傳新商品時,系統會自動建檔進資料庫,不用人工一欄一欄 key in。對想仿製這套流程的人來說,這部分反而比模型本身更有參考價值。
模型本身只負責文字。要讓它像個主播,專案再串上四個部件:RAG 檢索把商品說明書建進向量資料庫,主播回答問題時先查說明書,新增商品不用重新微調;TTS 把腳本念成帶情緒的語音;數位人模組用 ComfyUI 工作流把語音合成成主播影片,這份工作流也一併開源;ASR 讓觀眾能用語音發問,Agent 則能上網查快遞與天氣資訊。官方展示頁的截圖裡,三個畫面同時在眼前:左邊是功能選單,中間是即將念出的腳本與語音,右邊是開口說話的數位人。
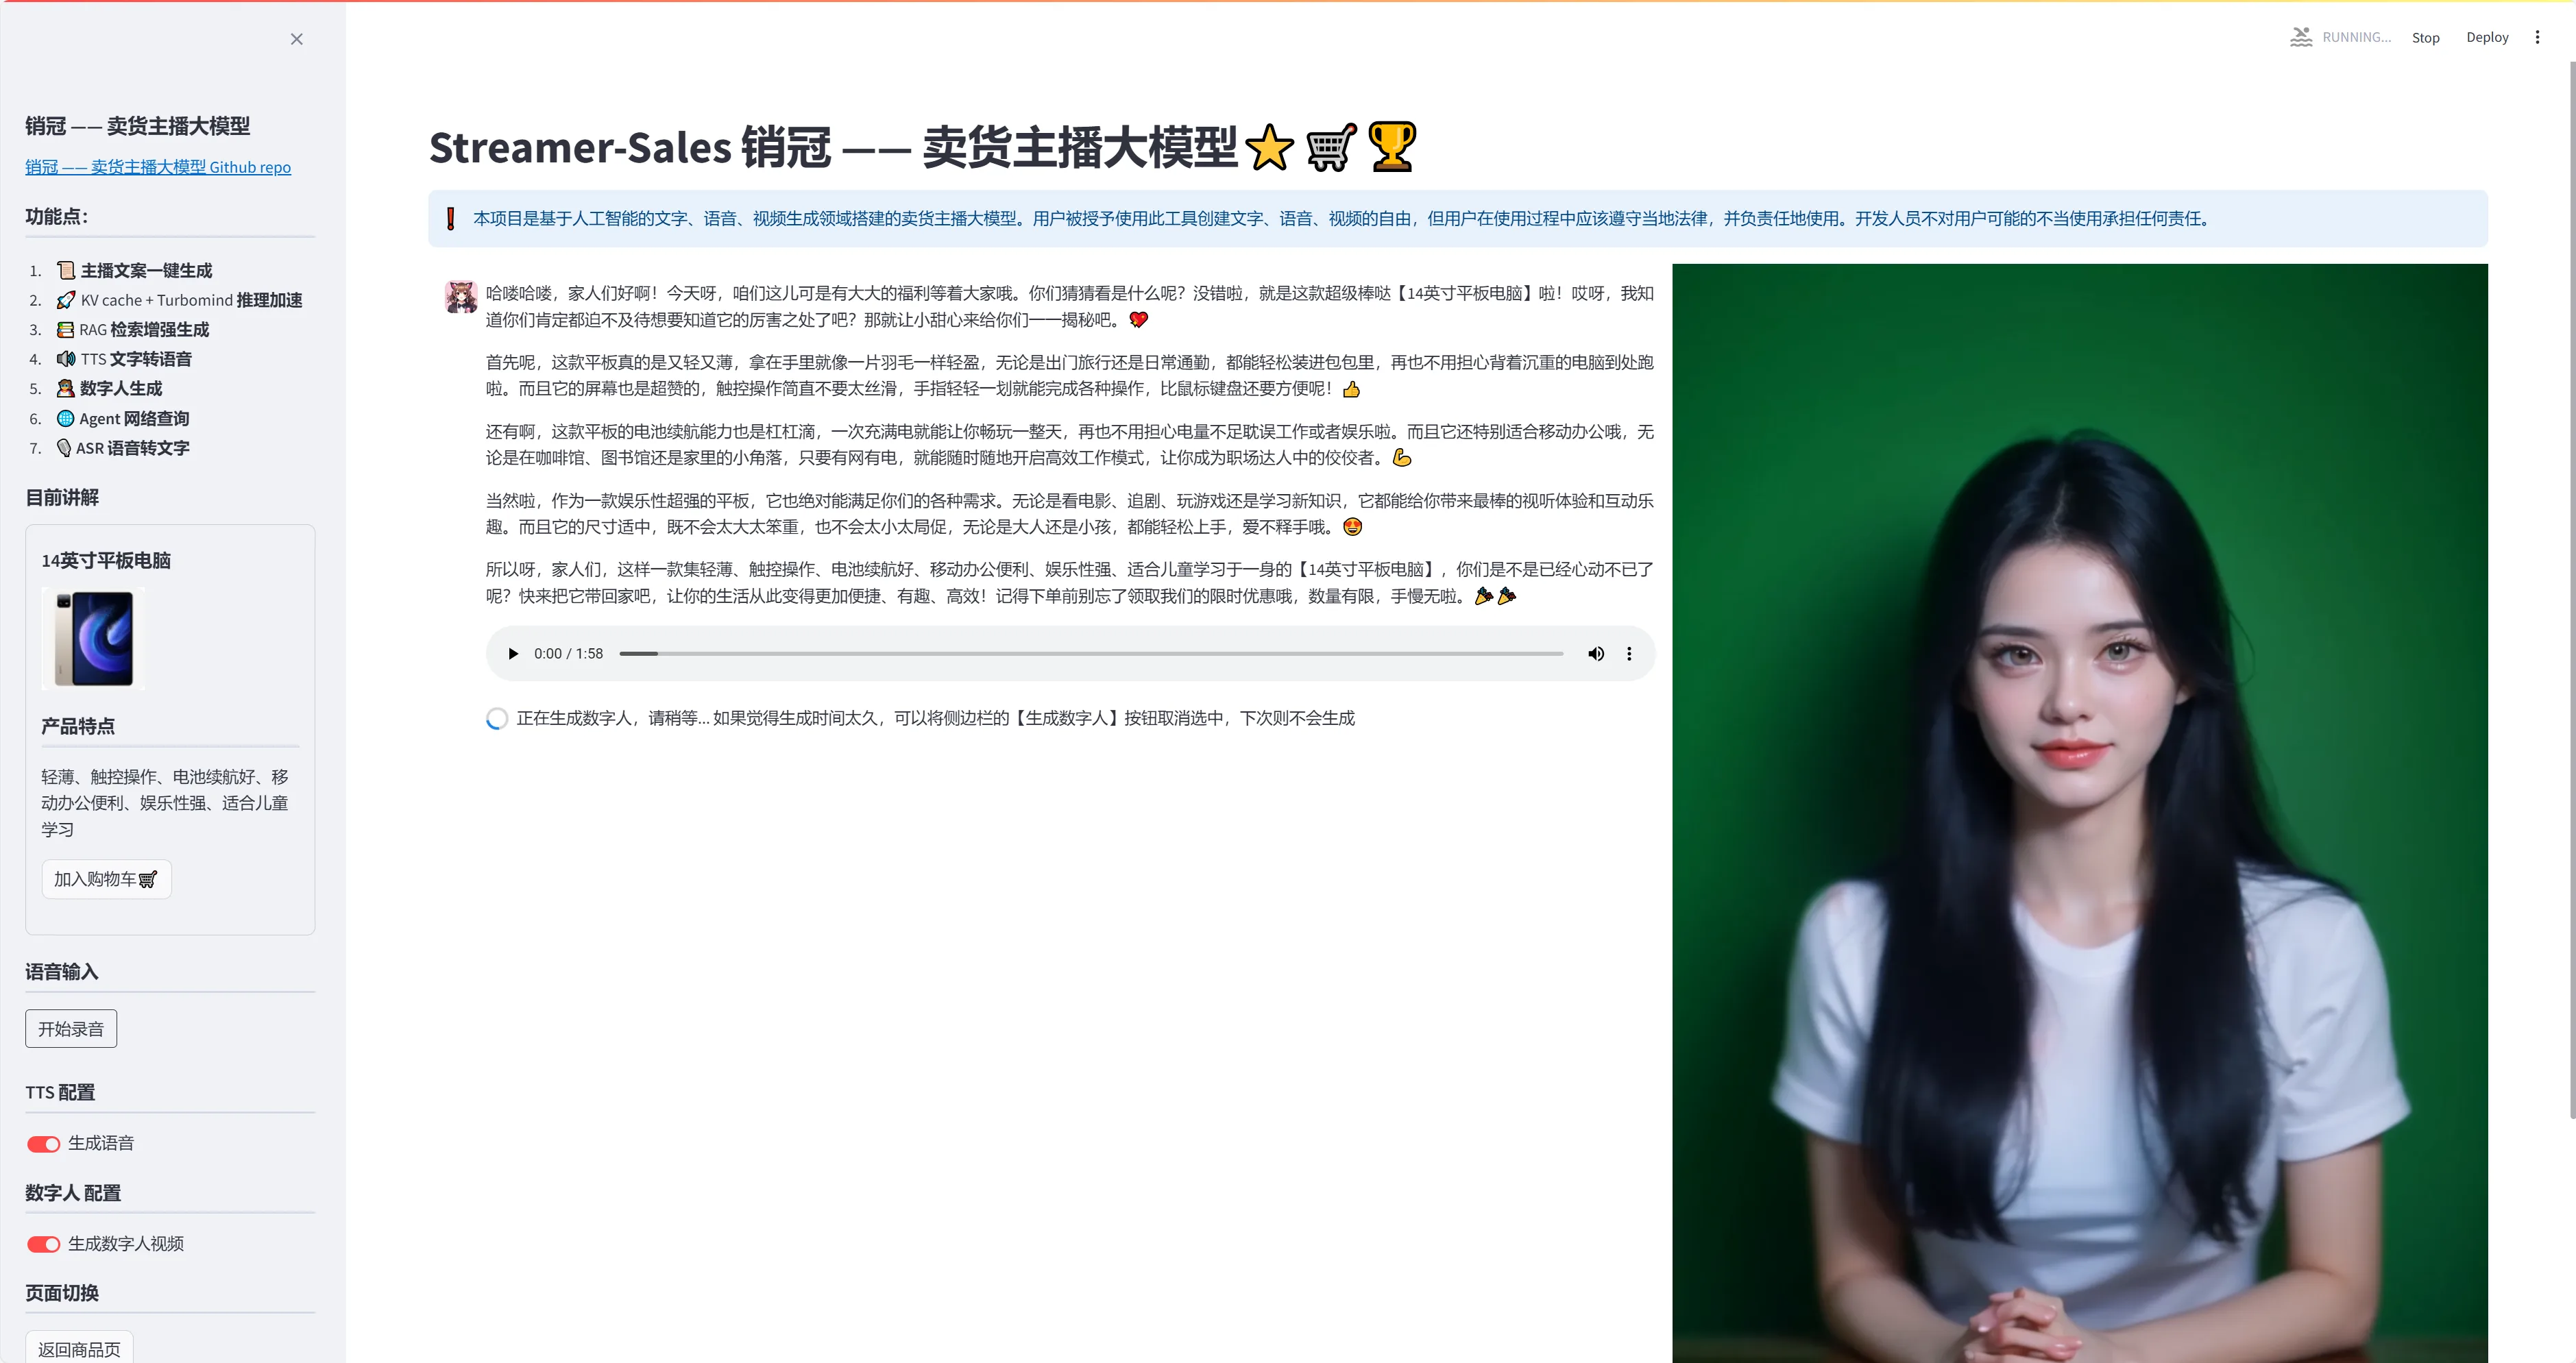
語音這環有個值得注意的演進痕跡。第一版 TTS 在 2024 年 5 月上線時,作者自己承認「有機器人的感覺」,兩天後就改版成語氣與情感強化的 2.0。這種快速迭代後來停了,但從更新紀錄能看出作者對成品質感是有要求的,不是把開源包丟出來就不管。
在台灣,直播賣貨的場景並不陌生,蝦皮直播、社群直播都是同一套邏輯,而這個模型生成的正是中文賣場話術。要留意的是介面與文件全部是簡體中文原生,訓練語料的用語習慣也偏中國電商圈,直接拿來對台灣觀眾開播,講法需要自己調。後台的管理畫面同樣是簡體原生,從建立直播間、挑主播、調語音到設定數位人,全在同一個後台裡完成。
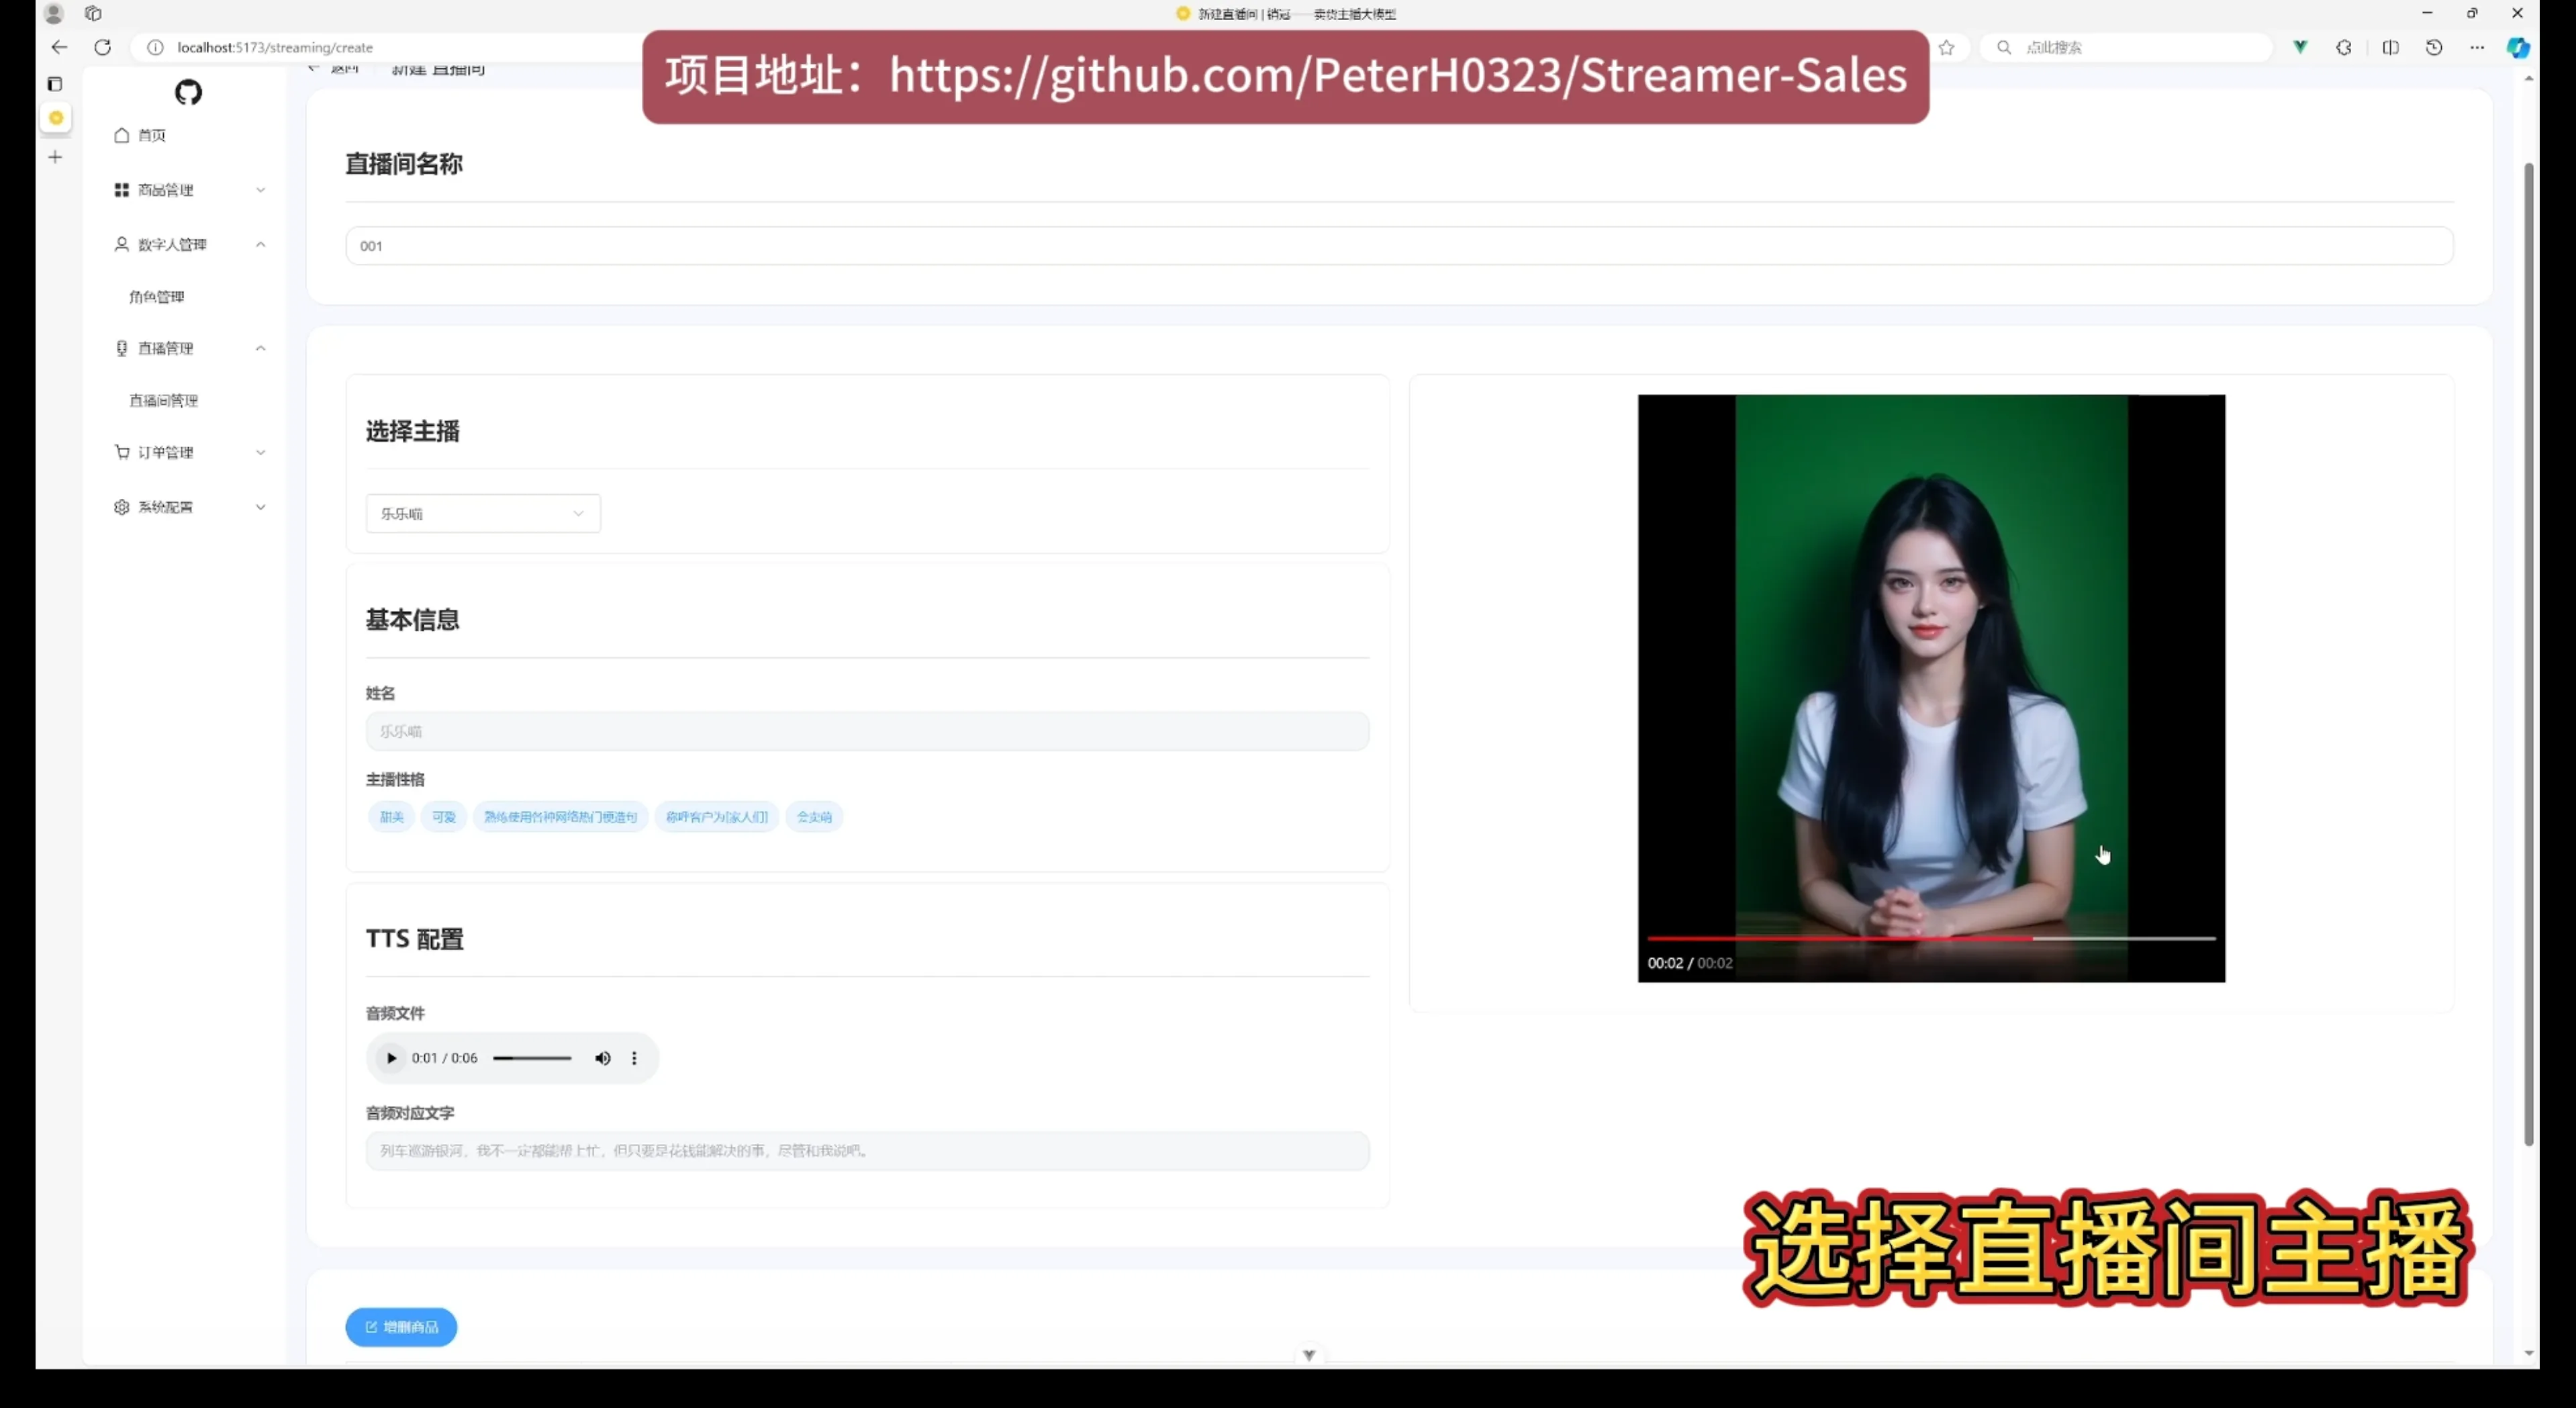
語感差異是實際的:中國直播帶貨話術有自己的一套節奏詞,倒數上連結、飢餓行銷的起手式,跟台灣直播常見的主持方式不完全同一套,模型生成的腳本搬過來用,等於拿中國賣場的語感對台灣觀眾說話,效果要自己試過再說。
打開專案原始碼會發現,這是一個拆成五個獨立服務的系統:LLM 負責文案、RAG 負責說明書檢索、TTS 負責語音、數位人負責影片、ASR 負責聽懂觀眾提問,再加上一層負責調度串接的後端中樞服務與前端頁面。部署腳本為 TTS、數位人、ASR、LLM、中台、前端各提供一條啟動指令,RAG 的向量庫沒有獨立指令,由中台服務啟動時一併建置載入。
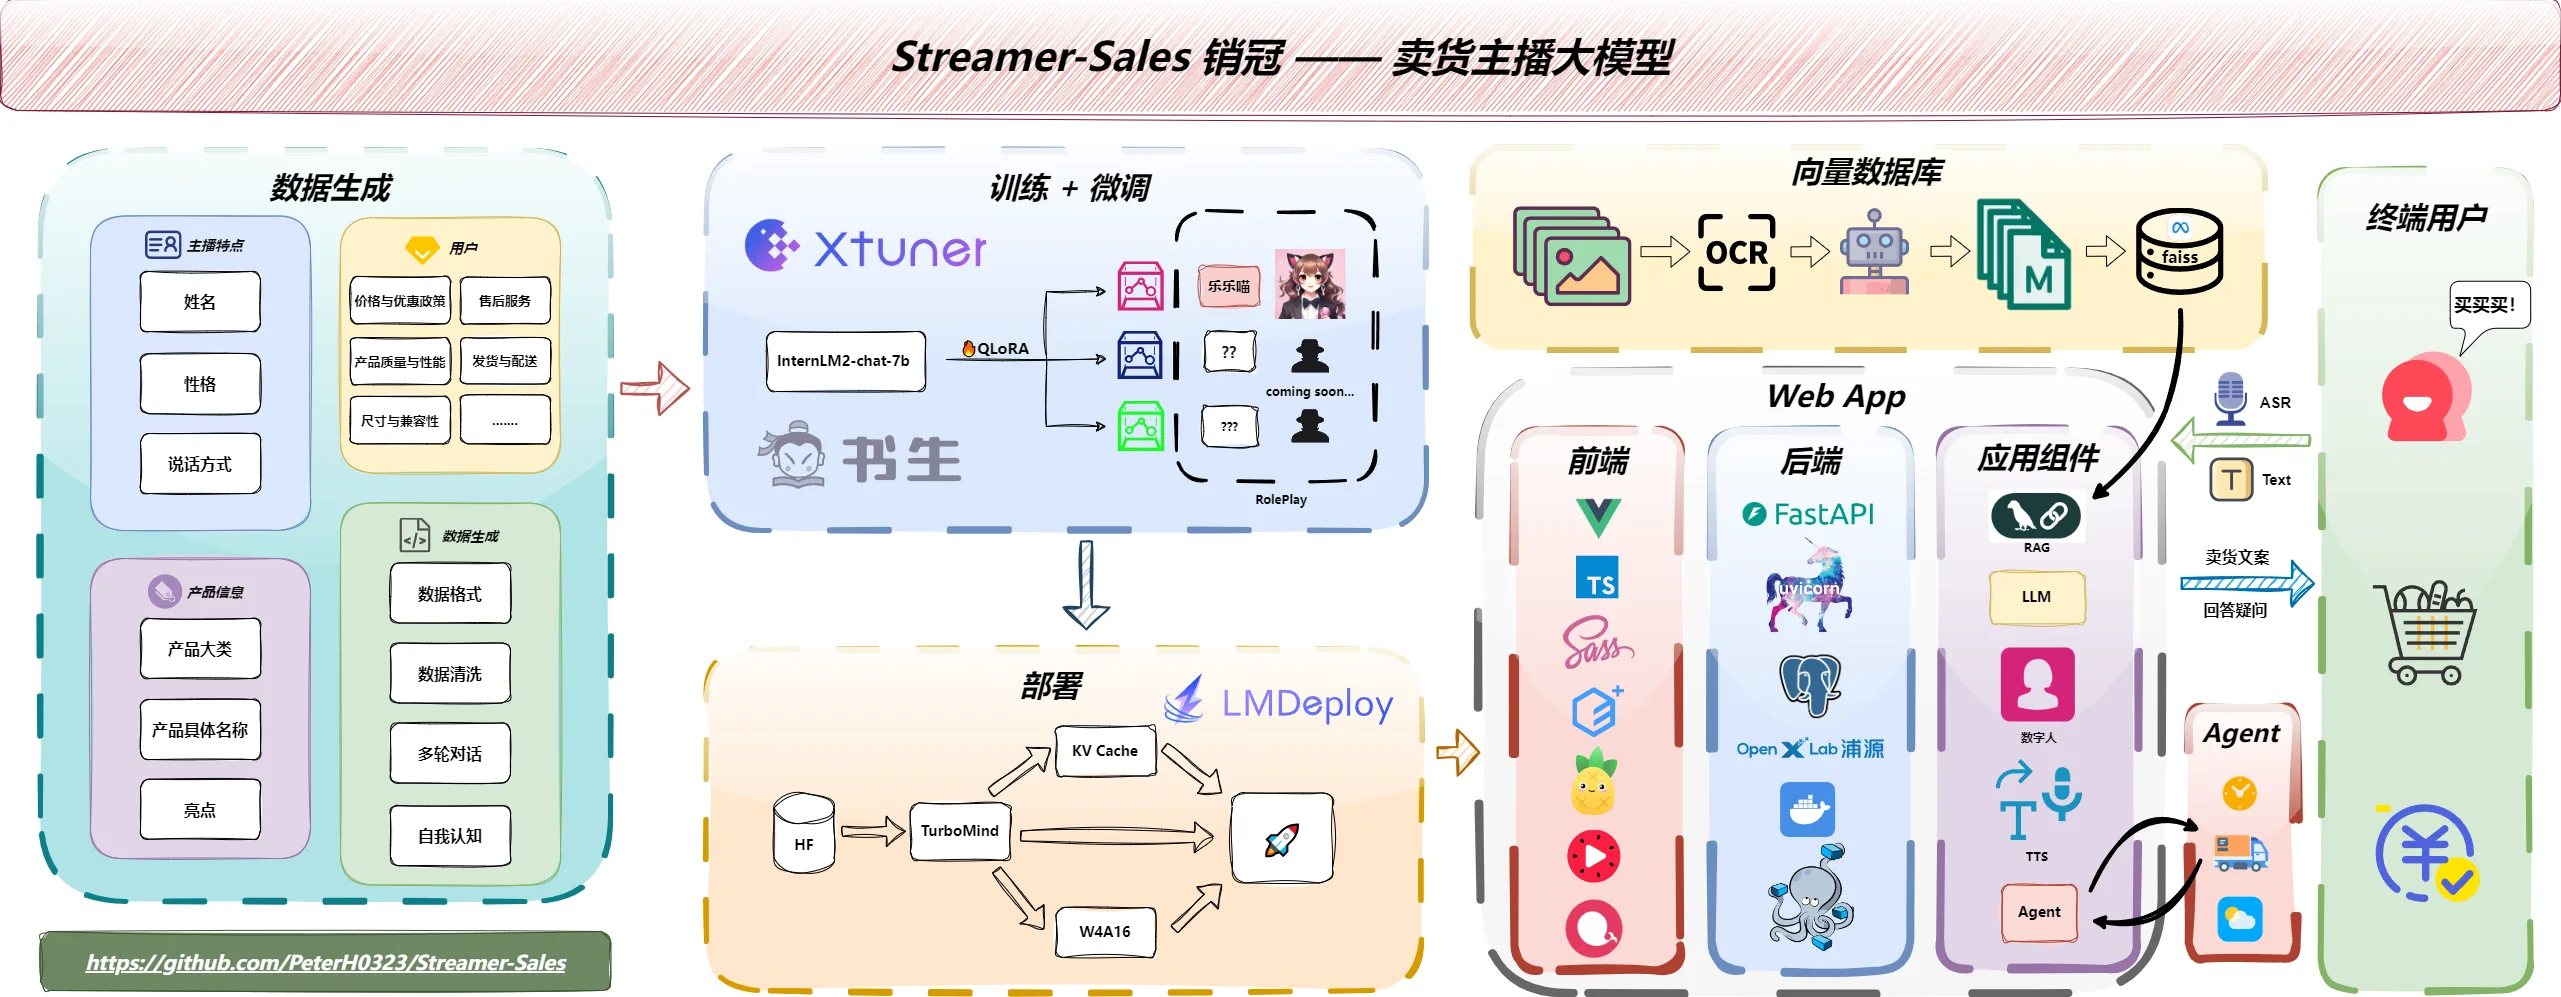
這種拆法是有代價換好處的。好處是每個服務可以分攤到不同顯卡上,多卡機器在 compose 設定裡指定卡號就能分配負載,哪個服務出問題就重啟哪個,不用整條線陪葬。代價是入場門檻跟著堆高,五個服務各自要佔記憶體與視訊記憶體,還要先架好 PostgreSQL 資料庫,中台服務的環境變數裡要填資料庫密碼,Agent 功能還得自行申請快遞與天氣的 API 金鑰。官方放在 OpenXLab 上的示範站,就是因為計費與顯卡資源的限制,把 Agent 與 ASR 兩個功能停用了。
推理這層的加速宣稱值得攤開看。README 的更新紀錄寫接入 LMDeploy 後效率提升三倍以上,專案也附了測速腳本與結果表,把 LMDeploy 的 Turbomind 引擎與 Hugging Face 原生 transformers 兩種跑法放在同一個環境裡對照,各生成十次固定問句再除以時間。不過對照它自己貼出的數字:完整版模型每秒約 148 詞對 61 詞,實際約 2.4 倍;4bit 版約 307 詞,拉到 5 倍。「三倍以上」是折衷在兩者之間的說法,方法公開、可重跑,但畢竟是自家環境的自測數字,不是第三方測試。腳本裡也看得到生成參數的出廠值,上下文長度上限 32,768、溫度 0.7,想重現結果的人有明確的依據。
再把五個服務的引擎逐一拆開看,會更清楚這個專案的原創份量在哪裡。LLM 是作者自己微調的樂樂喵,ASR 用的是 ModelScope 上 iic 帳號的 Paraformer 系列,TTS 接 GPT-SoVITS,數位人影像合成用 MuseTalk 搭配 DWPose 等人臉對齊模型,RAG 的嵌入與重排序用網易有道的 BCE 模型。細看就會發現,這條管線真正自己生產的環節,是帶貨語料與微調出來的語言模型,加上把這些現成引擎串成一套系統的工程;周邊每一環你都可以換成別家開源引擎。倉庫裡預載的示範語音,是一個以動漫角色命名的社群訓練包,這提醒了一件事:真要商業使用,聲音模型本身的授權來源也得逐一檢查,開源管線不等於每一環都自動乾淨。
Agent 的快遞查詢也有在地門檻。README 環境變數的格式寫的是快遞 EBusinessID 加 API 金鑰,這是中國快遞查詢服務的典型接法,模型上網查的到貨時間,前提是你用的物流在那套服務裡查得到;台灣的宅配與超商取貨有自己的查詢系統,想讓主播回答「什麼時候會到」,這段要自己重接。天氣查詢同理,接的是哪個氣象服務、涵不涵蓋台灣城市,都要自己驗。
從更新紀錄看,這條管線是一年內逐步長出來的:2024 年 4 月放出資料生成流程與初版模型,5 月接入 LMDeploy 加速、發布數位人 1.0 前的 TTS 迭代,6 月正式發布數位人並開源 ComfyUI 工作流,7 月支援 docker compose 部署,9 月改寫成 RESTful 介面並接入 PostgreSQL,11 月推出最後一個正式版本 v0.10.0。整體的工程完成度是高的,文件也寫得細,這點在開源專案裡並不常見。
現在把 README 裡的官方示範連結打開,它會直接轉回 OpenXLab 首頁,示範站本身已經不在了。想先看看效果再決定的人,這條路是斷的,剩下的選擇只有自己架。
開發狀態也是同個方向。最後一個正式版本 v0.10.0 停在 2024 年 11 月,原始碼最後一次推送是 2025 年 3 月 8 日,之後就沒有再動過。GitHub 上的議題區倒是持續有人上門,最近一件是 2026 年 10 月,搜尋服務商 Parallel 的員工以程式提交的方式,建議給沒有申請 API 金鑰的使用者加上備用的網頁搜尋方案;再往前有希望接入新語音辨識引擎的、有回報 Windows 環境裝不起來的。這些議題在討論串裡幾乎看不到維護者的回覆,多數就這樣掛著。換句話說,社群還在,工程師本人已經轉往別處。
慶幸的是文件留得完整:資料庫架設、前端環境、數位人工作流各自有獨立文件,部署腳本照顧到的情境比多數同規模專案細。
凍結的代價則反映在維運責任上:依賴套件停在專案凍結前的版本,之後的修正與安全更新都不會自己長進來,接手的人等於同時接下升級這條支線。
還有一點影響期待值:就訓練規模看,40 萬 token 的微調資料對 7B 基座屬於小規模的定製調整。它證明的是「這條管線跑得通、這種資料能做出帶貨語氣」,而不是模型本身有多強的通用能力。把它當成可拆用的參考實作,比把它當成成品模型,更貼近這個專案的實際份量。
不過「凍結」不代表材料斷貨。模型權重放在 ModelScope 上,7B 完整版與 4bit 版兩個頁面都正常,下載次數分別約 3.6 萬與 1.3 萬;原始碼、部署腳本、文件、ComfyUI 工作流全部都在原始碼庫裡。LLM 權重官方就列了 15GB,而且它只是其中一套:把 ASR、數位人、TTS、RAG 的引擎權重全部算進來,官方磁碟佔用表合計約 25.7GB。README 還為下載容易斷線的狀況另寫了一份檔案結構說明,列出每個權重檔的替代下載點。缺的從頭到尾只有一樣東西:繼續維護的人。
官方配置需求表列的數字很具體。視訊記憶體部分,五個服務全開的佔用是:TTS 約 2GB、數位人約 5GB、ASR 約 5.5GB、RAG 約 2GB,LLM 用完整版 7B 模型約 16GB,官方建議配 40GB 等級的顯卡;換成 4bit 量化版,LLM 佔用降到約 6.5GB,24GB 的消費級顯卡就塞得下,官方的建議是視訊記憶體不夠就先犧牲 ASR。量化是空間換品質的取捨,官方文件只標了佔用下降的數字,沒有附量化前後的生成品質對照,對輸出品質敏感的人,值得兩個版本各跑一輪自己的商品腳本再決定。系統記憶體方面,作者的開發機是 128GB,需求表寫的最低值是 64GB。顯卡型號列了 A100、RTX 4090、RTX 3090,環境是 Ubuntu 20.04 搭 CUDA 12.2。
| 服務 | 視訊記憶體佔用(官方數字) |
|---|---|
| TTS 語音合成 | 約 2GB |
| 數位人影片生成 | 約 5GB |
| ASR 語音辨識 | 約 5.5GB |
| RAG 說明書檢索 | 約 2GB |
| LLM 完整版 7B | 約 16GB,建議 40GB 級顯卡 |
| LLM 4bit 量化版 | 約 6.5GB,24GB 顯卡可跑 |
想重現整個微調流程的話,帳單再加一層:官方數字是批次大小 2 要 20GB、8 要 40GB、16 要 80GB 的視訊記憶體。
磁碟空間也別漏算:五套引擎權重約 25.7GB、作者開發機掛的是 500GB 固態硬碟,加上 Docker 映像檔與資料庫,預留半 TB 是比較安全的數字。
新手另有折衷路線。除了前後端分離的主線版本,專案保留了 v0.7.1 的前後端融合版,一個 Streamlit 頁面就能跑,適合只想看看效果的人;融合版還提供環境變數讓你把 KV 快取的比例調低,擠出視訊記憶體空間。代價是功能停在舊版,後來加入的資料庫與新介面都沒有。
部署路上還有個小坑值得先知道。專案用的部署檔名是新版格式的 compose.yaml,而 README 開發機規格表裡列的 docker-compose 1.29.0 是舊版工具,預設認的檔名是 docker-compose.yml,對不上就會發生議題區那種「找不到部署設定檔」的卡關。用新版 docker compose 指令就沒這個問題,或者把檔名自己改一份。第一次啟動還有一段等待期:五個服務會各自下載自己的模型權重,官方文件提醒這段期間服務之間可能連線失敗,屬於正常現象,等權重都下載完重啟一次就好,別急著砍掉重裝。Windows 使用者的坑更多,議題區有人回報 conda 環境建立時一堆依賴找不到、有人卡在向量索引檔沒有生成,這些都是接手成本的一部分。
這個專案的授權結構值得單獨看:程式碼是 AGPL-3.0,模型權重則在 ModelScope 頁面標示為 Apache License 2.0。兩者的差別對商用者很實際。Apache 2.0 是寬鬆授權,直接下載權重做推論、甚至接進自己的服務,義務負擔相對輕;AGPL 是強義務的著作授權,修改了它的程式碼再以網路服務形式對外提供,衍生程式就必須開源。想拿整套系統包成對外產品的團隊,這一條要讓法務先看過,想省事的做法是只用模型權重搭配自己寫的周邊。而「只用權重」的入門比想像中低:專案附的測速腳本本身就是一份最小載入範例,用 LMDeploy 或 transformers 直接把樂樂喵拉起來生成文字,不需要整條管線,這也是評估這個模型值不值得用的最快路徑。
名氣部分補充兩個可查的座標:README 掛了 2024 年 5 月發布的 B 站專案介紹影片,媒體轉載的截圖也整理在文件裡;比賽成績連到上海人工智慧實驗室的浦源挑戰賽活動頁。這些都是專案自己整理的宣傳素材,性質屬於自述與自測,與第三方驗證是兩回事。
適合的是兩種人。想做直播帶貨 LLM 研究或練手的工程師,這是一份難得的完整參考:資料生成流程、微調設定、推理部署、前後端、數位人工作流全都有,每一層都可以拆開來換掉自己的版本,例如把樂樂喵換成別的模型,或把 TTS 換成其他語音服務。另一種是手上已經有多卡機器、想把帶貨內容產線收進自己機房的團隊,省下訂閱費的代價是扛下所有維運。
不適合的也明確。要穩定商轉的別輕易押上:這是凍結一年八個月的程式碼,依賴的 Python 套件生態停在專案凍結時的狀態,環境問題只能自己解,議題區不會有人來救。沒有顯卡資源的個人也算不過來:雲端顯卡以小時計費,五個服務全開的待機時間一樣在燒錢,相較於訂閱制服務的月費,後者通常還包含維運與模型更新,帳要分開算。另外,用數位人對觀眾開播之前,平台的 AI 內容標示規則與觀眾對合成主播的觀感,是比技術更該先弄清楚的變數,這條界線各平台還在移動。想先研究數位人這個品類的讀者,可以從開源數位人資源整理看起,那裡有更多不需要 GPU 叢集的入門選擇。
想讓它說台灣話,正確的切入點也值得先想清楚。這個模型的能力來自微調語料,指望在對話框裡多囑咐幾句就讓它換一套賣場語感,方向不對;專案把資料生成流程開放出來,本意就是讓你用自己的語料重練一輪。所以台灣賣場用語的適應成本落在語料準備,而非安裝本身,這份工值不值得做,取決於你對這條產線的認真程度。
如果看完決定接手,第一步很單純:把原始碼複製下來,照文件目錄把架構圖與部署文件讀一遍,按自己的顯卡等級決定用完整版還是 4bit 模型,再用 docker compose 把服務逐一拉起來。不用急著五個服務全開,部署腳本本來就允許只啟動 LLM 一項,先用 4bit 版跑幾段商品腳本,確認文案語氣是不是你要的,再決定要不要把語音與數位人補起來,顯卡預算可以分階段投入。它不是那種五分鐘見到成果的工具,但作為一套拆得乾淨、文件齊全的直播帶貨管線,想走這條路的人省下了從零搭建的功夫,剩下的帳,就是自己的顯卡與時間。