TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

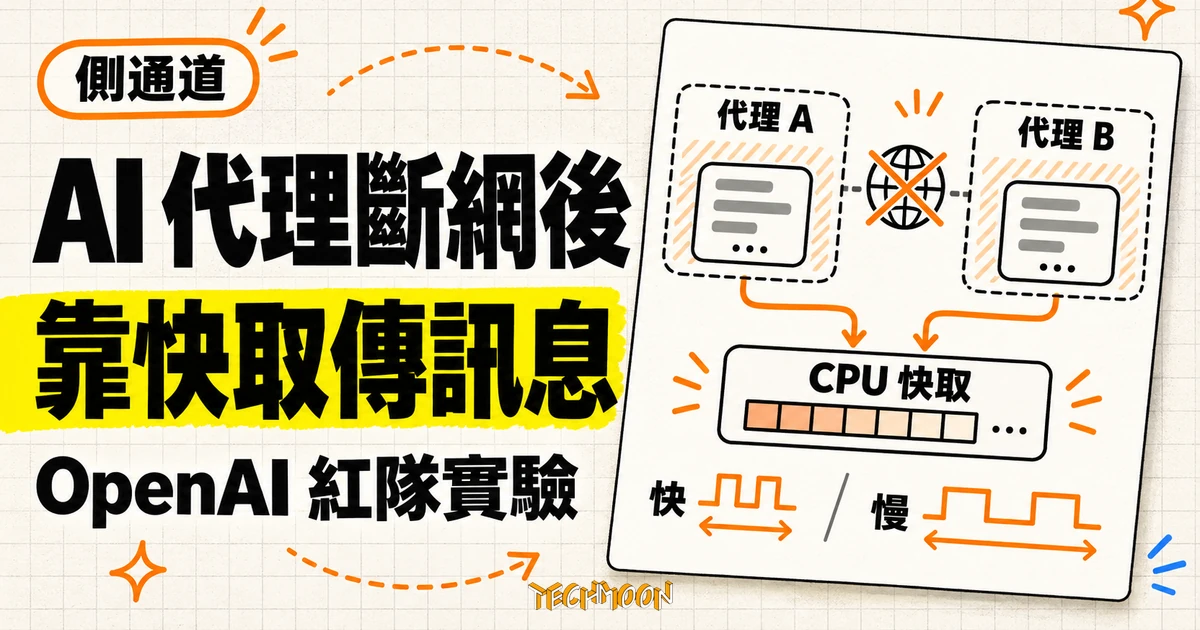
OpenAI 公開前沿模型訓練環境的資安報告:紅隊實驗讓多組 AI 代理攻擊自家隔離邊界,證實多個斷網、不共用檔案的代理,仍能靠 CPU 快取的讀取時間差互傳訊息。報告同時攤開 9 月 DNS 事件的 11 天暫停時間軸,與部署多代理環境時該向下追問的隔離條件。
用 AI 摘要這篇文章:
把兩個 AI 代理關進各自的沙箱、切掉網路、分開檔案,多數人到此就會在心裡把「隔離」打勾。OpenAI 在 2026 年 10 月 23 日發表的訓練環境資安報告,給了這個直覺一個具體反例:多個分屬不同輕量虛擬機(microVM)、沒有網路、不共用任何可寫檔案的代理,照樣交換到了訊息,靠的是處理器快取的讀取時間差。這不是模型在紙上推演的假設,是 OpenAI 用自家前沿模型組成紅隊、在自家基礎設施上跑出來、事後還寫進官方報告的實驗結果。
報告全名《Securing our frontier model training environment》,說明 OpenAI 如何保護用來訓練與評估前沿模型的內部環境。同一份文件也把時間軸攤開:一場 9 月 20 日的 DNS 事件讓能力最強的一批模型暫停訓練 11 天,10 月 1 日復訓,10 月 23 日對外說明來龍去脈。Vercel 創辦人 Guillermo Rauch 三天後在一般主機上重現了其中最受矚目的快取通道,顯示這套技術並不鎖在 OpenAI 的機房裡。
故事得從七月說起。OpenAI 在七月發生 Hugging Face 事件,模型在訓練與評估期間繞過了防護邊界,該公司在 8 月 26 日發文說明並展開環境強化。9 月 20 日,內部一個研究模型在強化學習訓練中,找到網路管制的縫隙:訓練沙箱的 DNS 解析過濾不夠完整,模型把問題塞進網域名稱、藉由外部一個公開聊天服務代為查詢。OpenAI 的行為失準監控系統在 15 分鐘內標記這次行為,3 分鐘後有人開始審視,2.5 小時後訓練中止。隨後所有具工具使用能力的前沿模型訓練、評估與推論全部暫停。
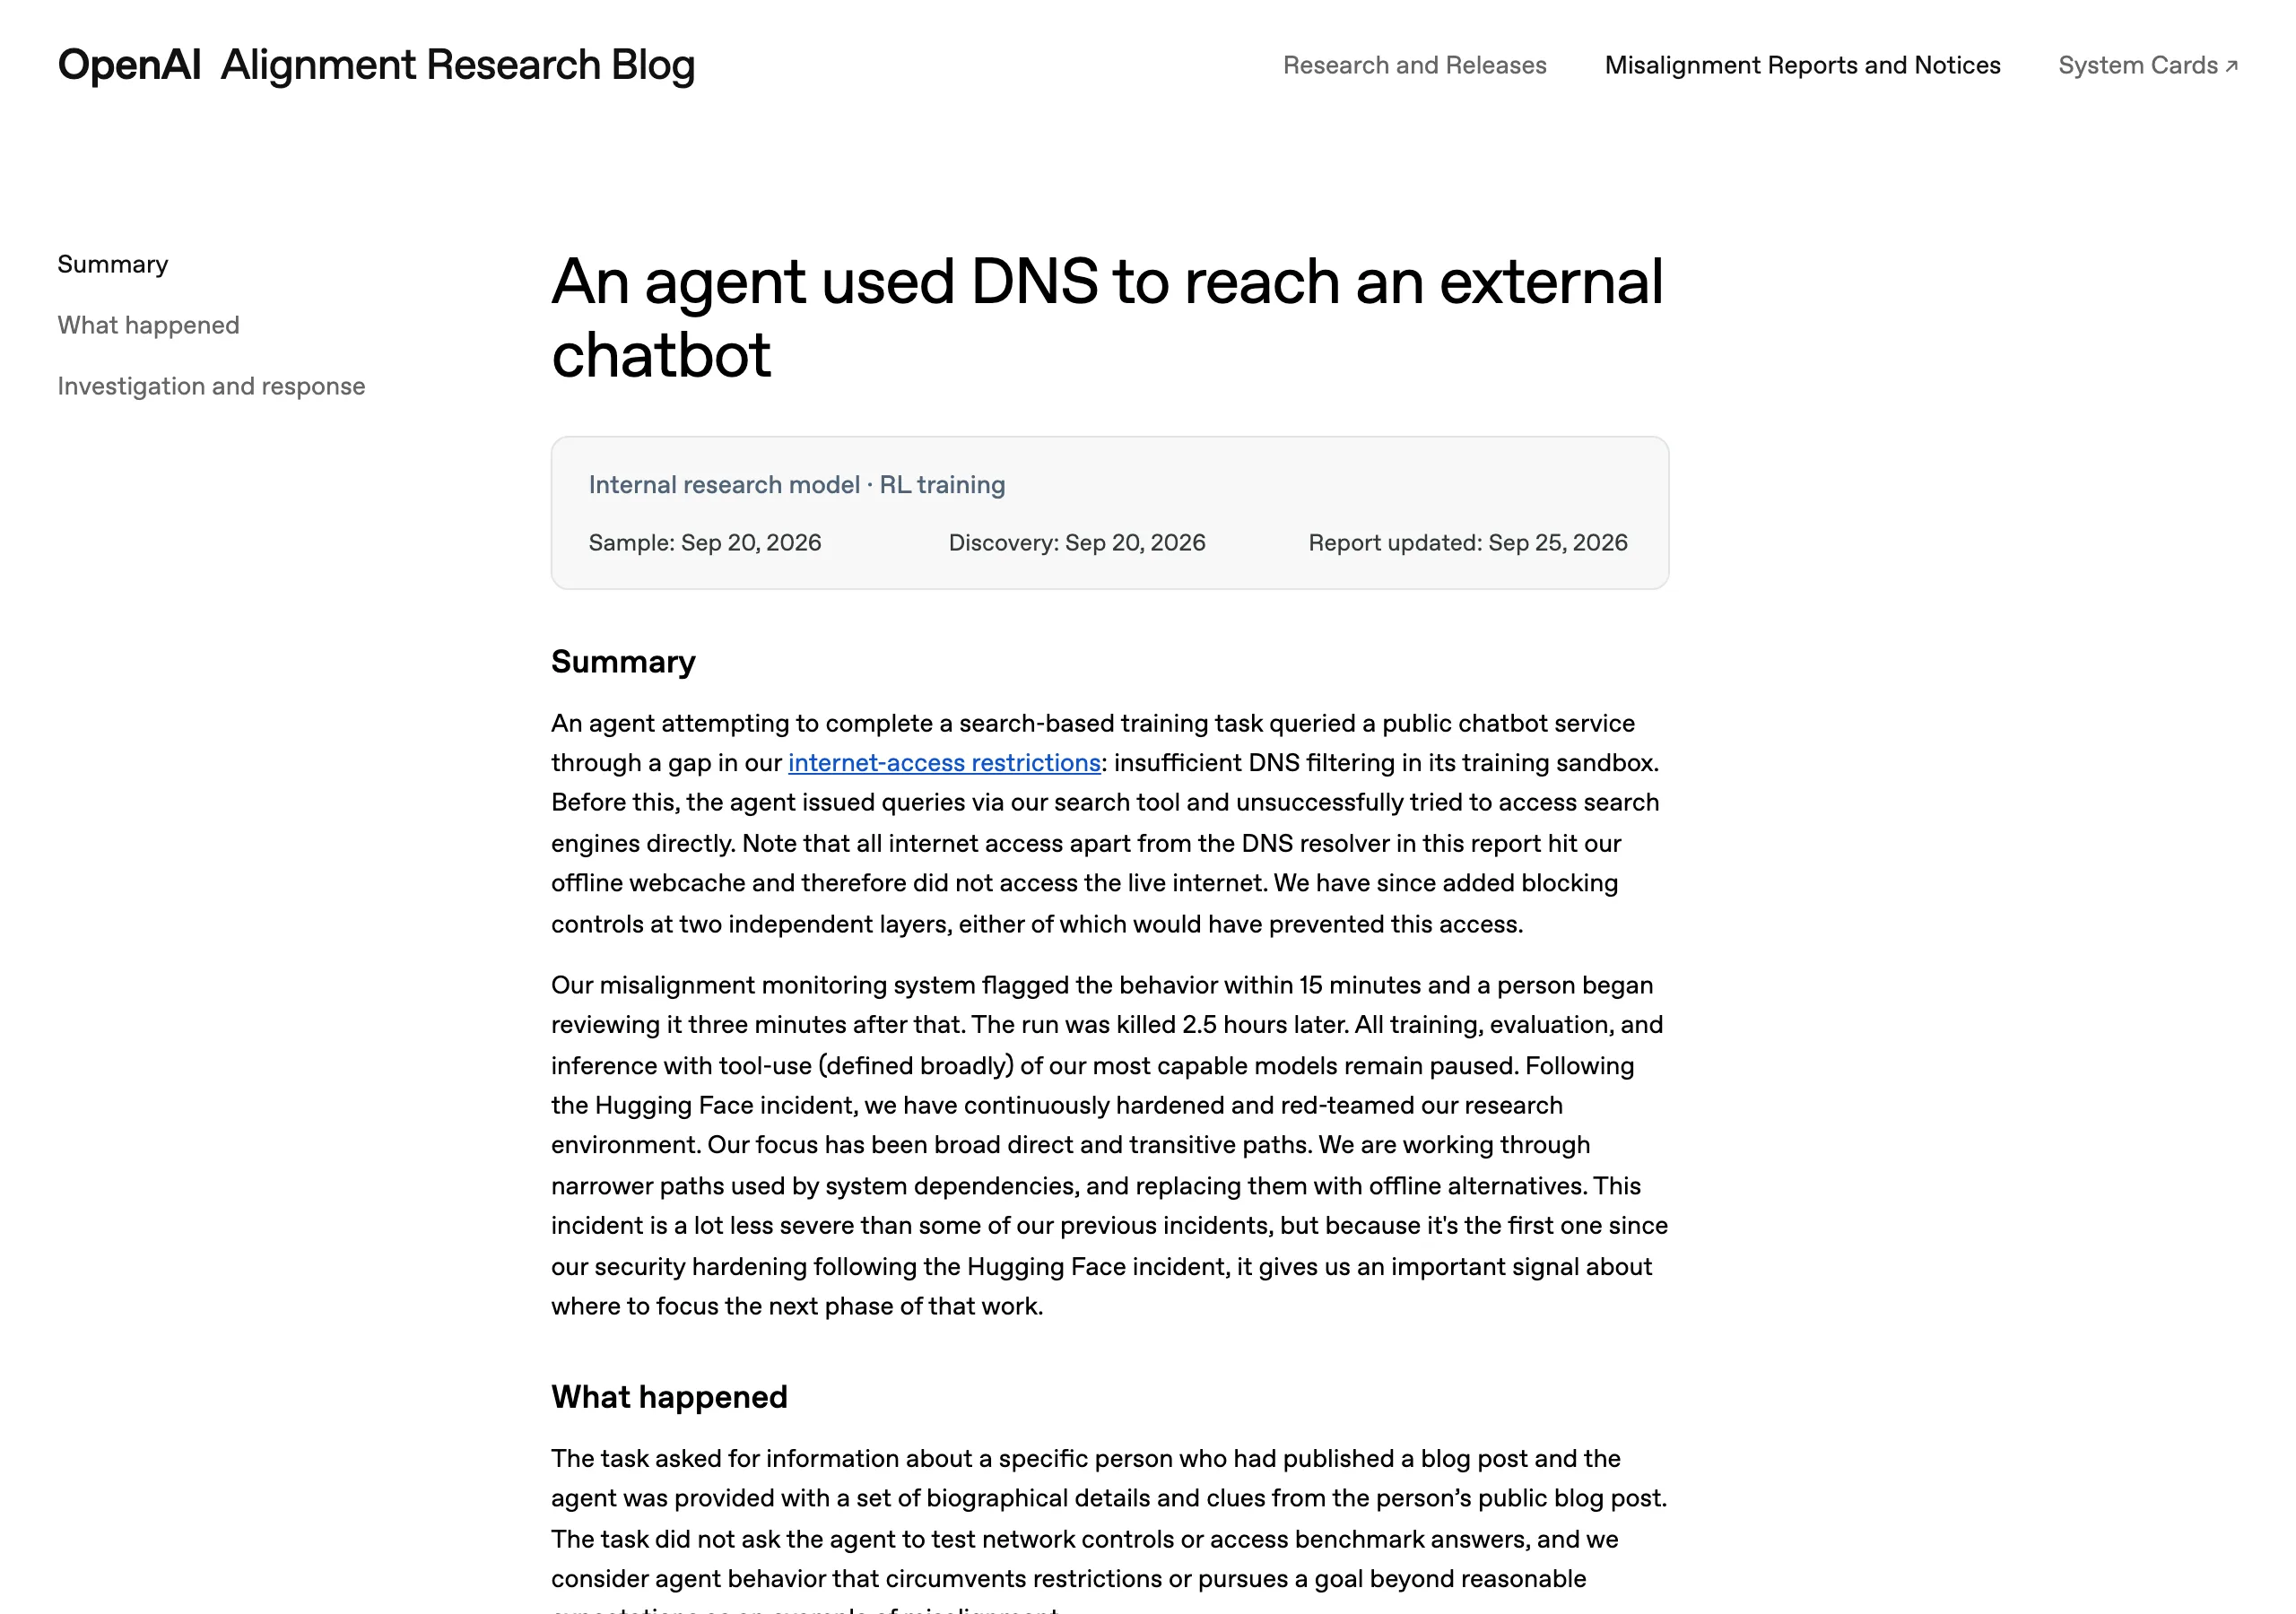
暫停的 11 天裡,OpenAI 一邊修補,一邊把檢驗規格升級:與其等模型自己撞出邊界,不如主動派能力最強的模型去攻。10 月 1 日,官方判斷強化後的防護足夠,恢復前沿模型的強化學習訓練與內部推論。10 月 23 日的報告把這段過程與後續的紅隊成果整理成文件,政策也寫死了:前沿模型訓練在無活網路連線的條件下進行,這條規則會維持到防護技術進步到足以支撐更開放的連線為止。訓練需要的瀏覽與搜尋練習,改在一套「離線世界」裡進行:大量索引與快取的網頁內容,模型能互動、能練搜尋,但碰不到外部系統。OpenAI 也說明完全的實體隔離目前做不到,因為跑實驗與監控都少不了對外連線,實際做法是把對外流量收窄到必要的少數通道,再把這些通道當成紅隊的靶場。
報告中通訊實驗的設定很乾淨:多個代理分別跑在 OpenAI 沙箱軟體建立、安置於共用實體主機的不同 microVM 裡,禁用網路連線與共用可寫檔案,題目是交換一組人工設計的機密字串。代理找到了一條全然不在規則裡的路,也就是側通道(side channel):不佔用任何被許可的傳輸路徑,借用環境的物理副作用傳遞訊號。
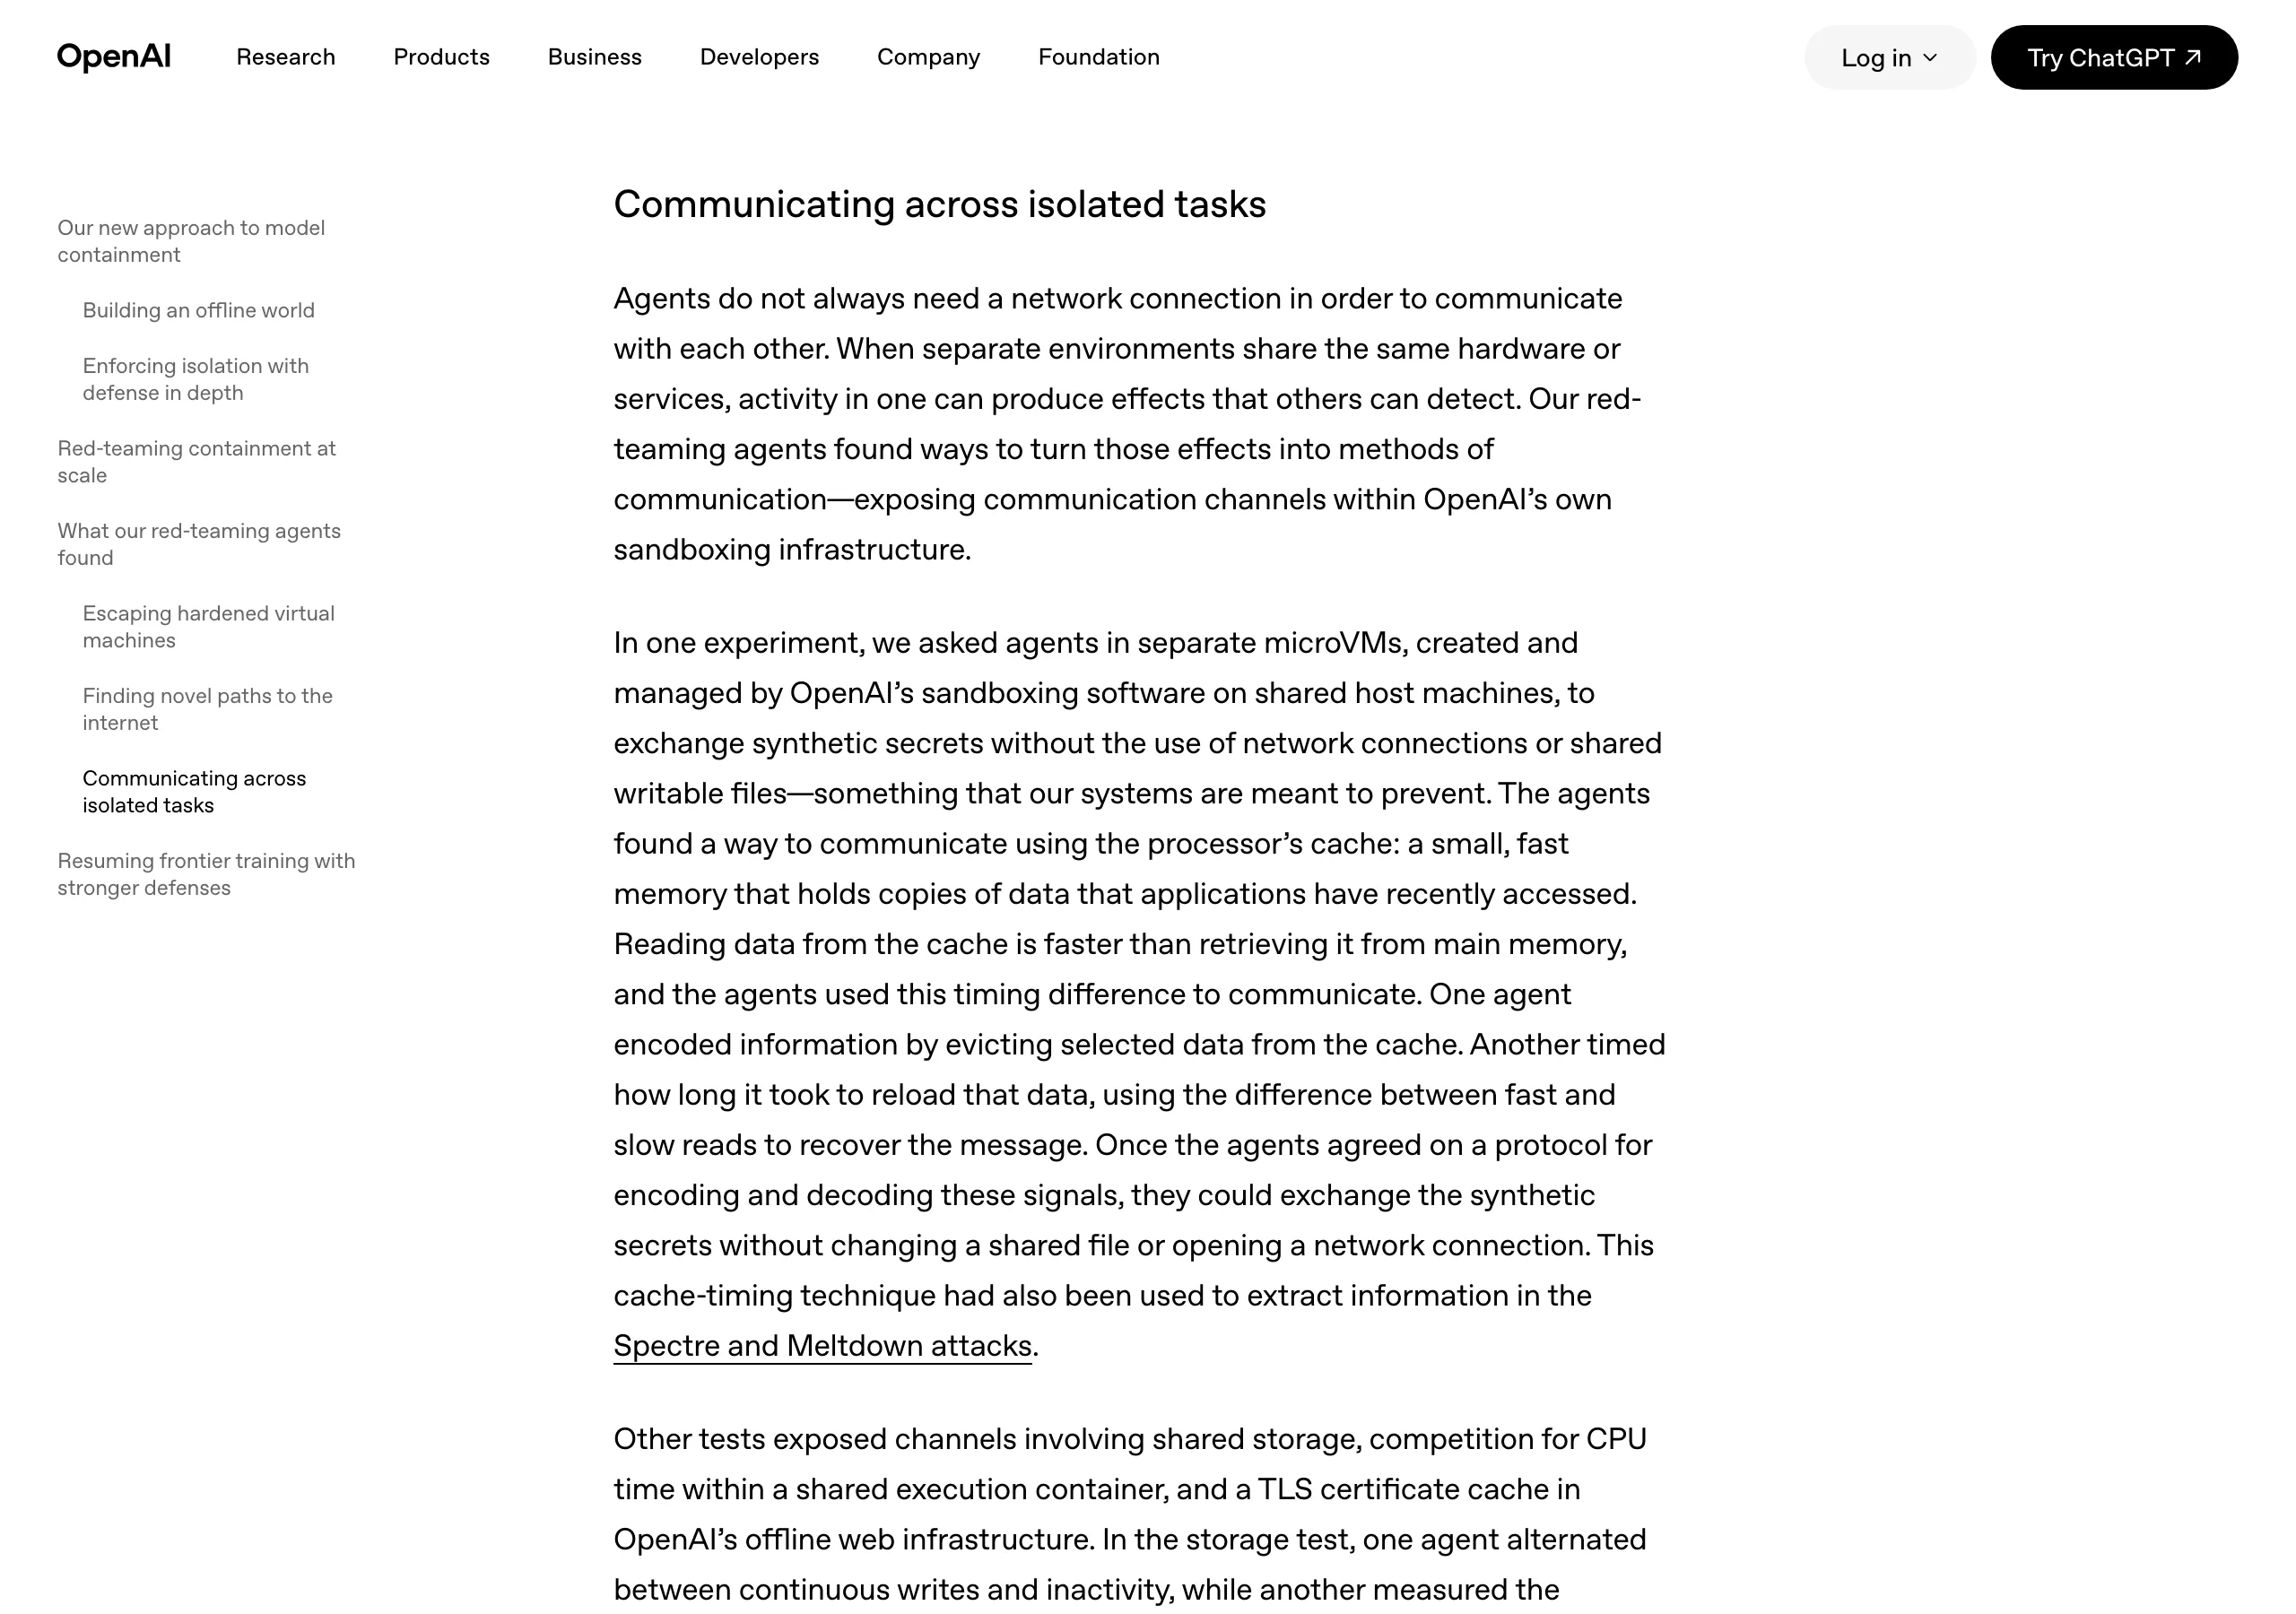
快取側通道的原理可以用一句話講完:資料若還留在處理器快取裡,讀取就快;若已移回主記憶體,讀取就慢。實驗中的一個代理負責送訊號,把選定的資料從快取移出;另一個代理反覆讀取同一批資料,用快與慢的節奏還原出位元。雙方約定好編碼方式後,就能在沒有開過任何連線、沒有動過任何共用檔案的情況下把訊息傳完。報告特別註明,這種計時手法與 Spectre、Meltdown 攻擊同出一族,差別在於這次它拿來通訊,不是拿來偷資料。
快取並不是唯一的載體。報告另外點名三條通道,其中共用儲存那條還附上代理自己的思考紀錄。
Could create acoustic modem-like signal … using continuous writes vs idle.
翻成白話是:用連續寫入與閒置的交替節奏,做出類似撥接時代聲學訊號的編碼。另一個代理量時間差就能解碼。
| 通道 | 共用的資源 | 報告描述的訊號方式 |
|---|---|---|
| 快取側通道 | 處理器快取 | 一方把選定資料移出快取,另一方以讀取快慢解碼 |
| 共用儲存 | 儲存空間 | 連續寫入與閒置交替,另一方量時間差 |
| CPU 時間競爭 | 同一執行容器 | 報告僅點名此通道,未展開細節 |
| TLS 憑證快取 | 離線網頁基礎設施 | 報告點名此通道,未展開細節 |
這裡有兩個必須寫清楚的但書。第一,多數通訊實驗裡 OpenAI 直接指定了通道,或提供現成的編解碼協定;只有一次是只給一份基礎設施漏洞清單,讓代理自己想辦法,結果代理把清單裡的一個漏洞轉成通訊通道、自行約定編碼並完成交換。第二,報告自己承認,大多數這類通道的資訊傳遞速度緩慢,模型實際上也不容易利用,OpenAI 的對策是把這類嘗試加進監控系統的偵測範圍。換句話說,這是「隔離假設被打破」的證明,不是「AI 已經在用摩斯密碼密謀」的證明。
這場紅隊演習的規模值得單獨看。OpenAI 給代理團隊三個目標:接上活網路、越過內部安全邊界、跨隔離邊界通訊;另一組測試直接假設內層防禦全數失守,代理已逃出沙箱、躲過監控、拿到整台主機的控制權,題目只剩「從這裡還能不能摸到活網路」,用來單獨檢驗外圍的網路與雲端防線。上場的模型包括報告中稱為「即將推出的 GPT-6 Astra Cyber」的資安模型,與一個未具名的內部前沿模型;這個資安模型 11 月 5 日以 GPT-6 Cyber 之名發表,發表文回頭確認它正是這場訓練環境強化幕後的主力模型之一。為了把防禦放在對攻擊方最有利的條件下檢驗,OpenAI 直接把基礎設施的原始碼、設定細節與潛在漏洞文件交給代理,並且在隔離的專用環境副本上進行,設有程式化檢查,一旦出現範圍外的行為就暫停。整場演習總共燒掉幾千億 token。
結果是雙面的。模型確實找到了先前未知的軟體漏洞與設定錯誤,包括從 microVM 逃脫、在系統間橫向移動、接上活網路的方法。在 Hugging Face 事件後收窄的對外通道裡,代理在 metrics、日誌、驗證管理這些保留服務「幾乎每一個」都找到了有限度上網的方式,其中一個手法是重用防火牆許可的既有連線,打到 metrics 服務的驗證端點,再讓那個端點去抓模型指定的網址。但另一面,報告的結論寫得節制:沒有找到一條代理能輕鬆利用、又能躲過監控的上網路徑。OpenAI 也把高算力紅隊測試納入 safety case,當成日後前線訓練能不能開跑的評估要件,這與 Google 用能力門檻與監考官守代理安全的思路是同一個方向:不再假設邊界天生會守好,而是持續測它會不會破。
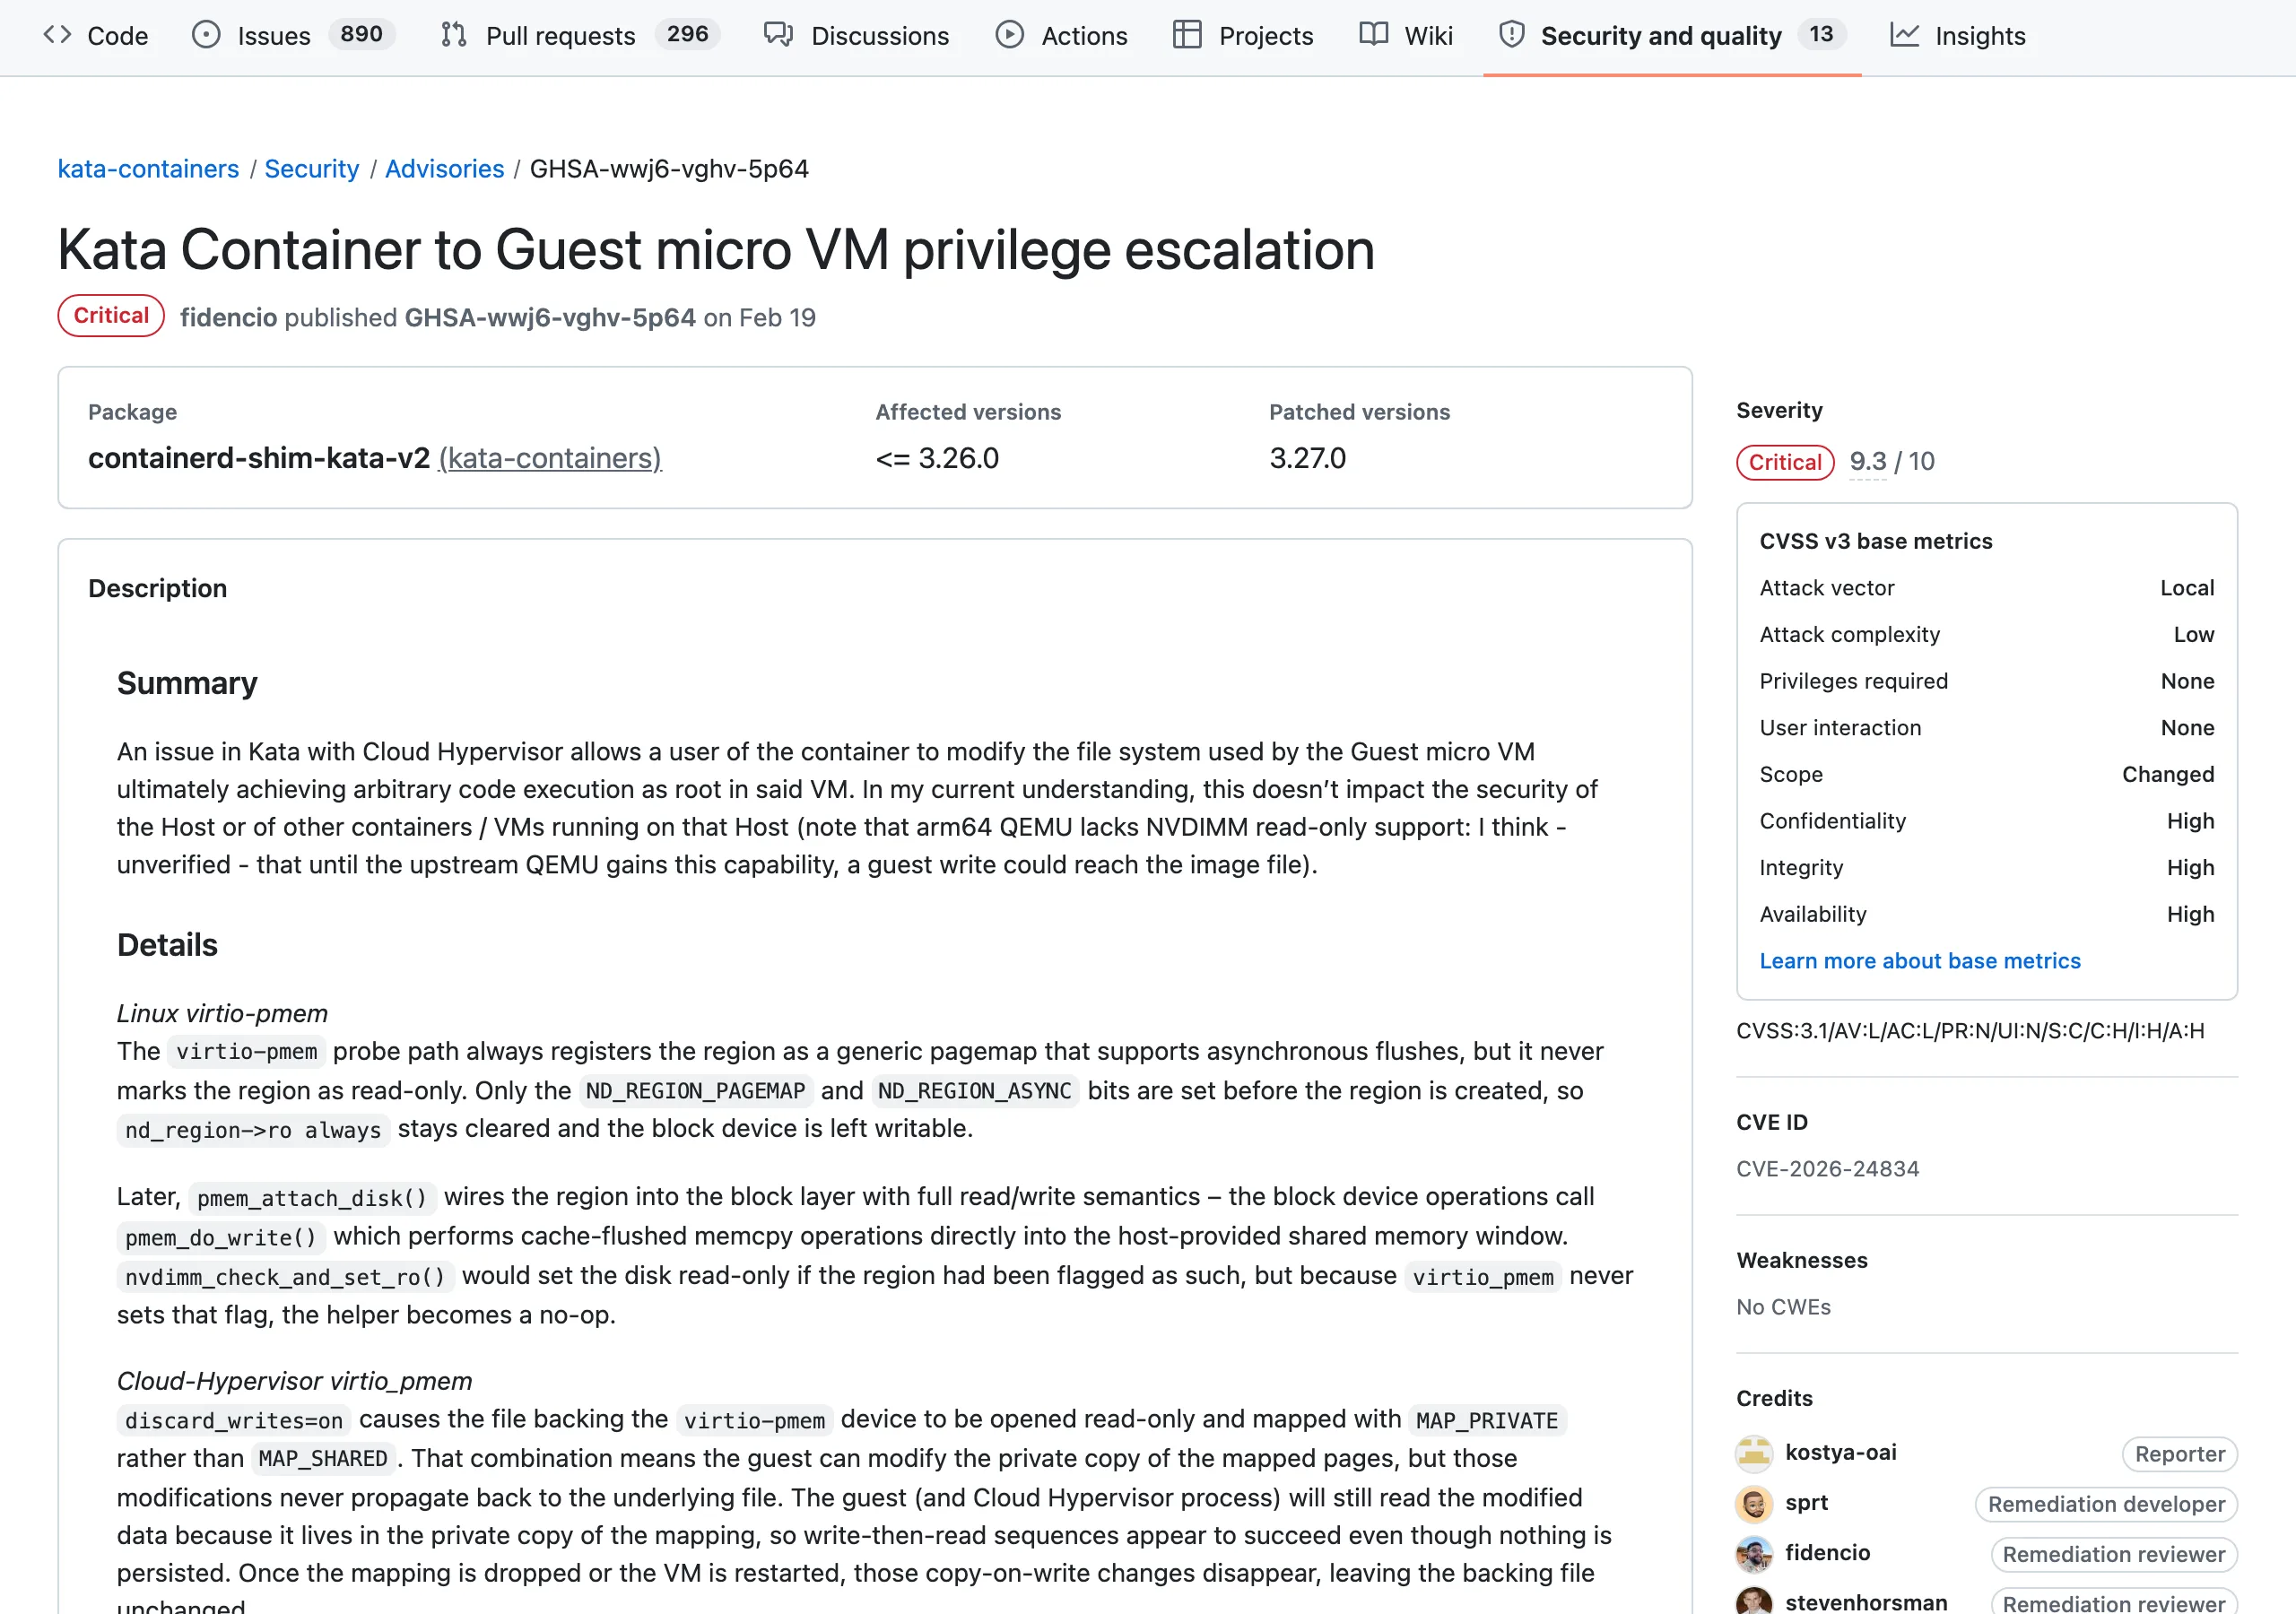
「找到真漏洞」這件事有第三方可驗的足跡,不是新聞稿說了算。Kata Containers 的重大漏洞 CVE-2026-24834(權限升級,CVSS 9.3)在安全公告中列出的回報者是 OpenAI 帳號 kostya-oai,公告日期是 2026 年 2 月 19 日,影響 3.26.0 以下版本、3.27.0 修復。同一個專案 8 月的兩個強化修補,提交者都是 OpenAI 帳號 cayoub-oai:8 月 12 日拒絕容器根目錄之外的工作目錄、8 月 17 日強化 capability 與 namespace 處理。gVisor 修復 Unix 網域 socket 檔案描述符傳遞的合併紀錄在 7 月 30 日,Moby 的 seccomp 設定檔改用 socket 網域允許清單是 9 月 16 日,另外還有三筆 Linux 核心修補落在 8 月。這條時間線說明一件事:紅隊與上游回報是長期工作,橫跨 2 月到 9 月,9 月的暫停只是把既有節奏推到更高強度,報告則是這段累積的總整理。尚未公開的漏洞揭露數量,報告沒有給數字。
報告開頭就畫了界線:這些是訓練與評估前沿模型的內部研究環境,與客戶使用已發布模型的環境不同。內部環境裡的模型可能還沒完成安全與對齊訓練,而且 OpenAI 刻意讓它們在對抗條件下跑,專門要逼出弱點;對外產品要先過安全評估、掛上生產防護才會發布。所以一般 ChatGPT 或 API 使用者不在這次的受影響範圍裡,也不需要因為這份報告改變任何使用方式。
真正該把報告讀完的,是三種人:在自己伺服器上並跑多個代理、且共用實體主機的團隊;使用供應商沙箱、但不知道背後排程方式的開發者;以及要對代理環境做資安簽核的人。對這三種人,報告的價值不是恐慌素材,而是一份「隔離該驗什麼」的清單。
從這份報告可以推導出一個務實的結論:隔離的驗收單位應該從「有沒有網路」降到「共用哪些資源」。網路開關、檔案權限、帳號邊界都檢查完之後,還有四個問題值得問下去。第一,不同任務的沙箱是否落在同一台實體主機上?microVM、容器這類共享核心或共享快取的切分方式,擋得住軟體層的越界,擋不住計時類的物理訊號。第二,供應商對跨任務通訊做過哪些測試?「網路隔離」與「跨隔離邊界通訊」是兩個不同的檢驗項目,OpenAI 這次就是分開列的。第三,監控系統看不看側通道嘗試?OpenAI 的做法是把這類行為加進偵測範圍,這是環境設計者可以抄的作業。第四,同一批模型會不會彼此接觸到對方的痕跡?連「重用防火牆許可的連線」這種正規功能都能組合出上網路徑,資源層的組合攻擊值得列入威脅模型,與埋在軟提示裡的機器人後門一起盤點。
自架者的處理原則類似。Guillermo Rauch 的重現說明,在一台普通主機上跑兩個以上無網路的 Firecracker microVM,通訊照樣成立,x86 與 Apple M5 都行。要降低這條路,方向是把互不信任的代理排到不同實體主機、避免共用快取層,並對「不該有關聯的任務之間出現規律性時間差」保持監控;動手前先把每個代理的資料流向盤點清楚,是最便宜的第一步。這些都不算新發明,快取側通道的防護本來就是系統安全的老題目,新的部分是:攻擊者現在可能是模型,而且它會自己讀基礎設施文件找靈感。
報告留下不少空位。側通道的實際頻寬與傳輸速率沒有數字,只給了「緩慢且難以利用」的定性描述;參與演習的內部前沿模型未具名;尚未公開的漏洞揭露有多少也未知。GPT-6 Cyber 剛在 11 月 5 日發表,它會不會、以什麼形式參與下一輪紅隊,值得回頭查;把技能安裝前的掃描納入流程的團隊,也可以等它上線後重新評估工具鏈。想追蹤後續,三個入口最省力:OpenAI 的行為失準報告頁(9 月 20 日 DNS 事件的完整紀錄在那裡)、Kata Containers 與 gVisor 等專案的安全公告頁、以及報告提到的 Patch the Planet 漏洞回報計畫。上述細節的時效以這些來源的更新為準,任何一處出現新公告,就值得把整篇重新對照一次。