TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

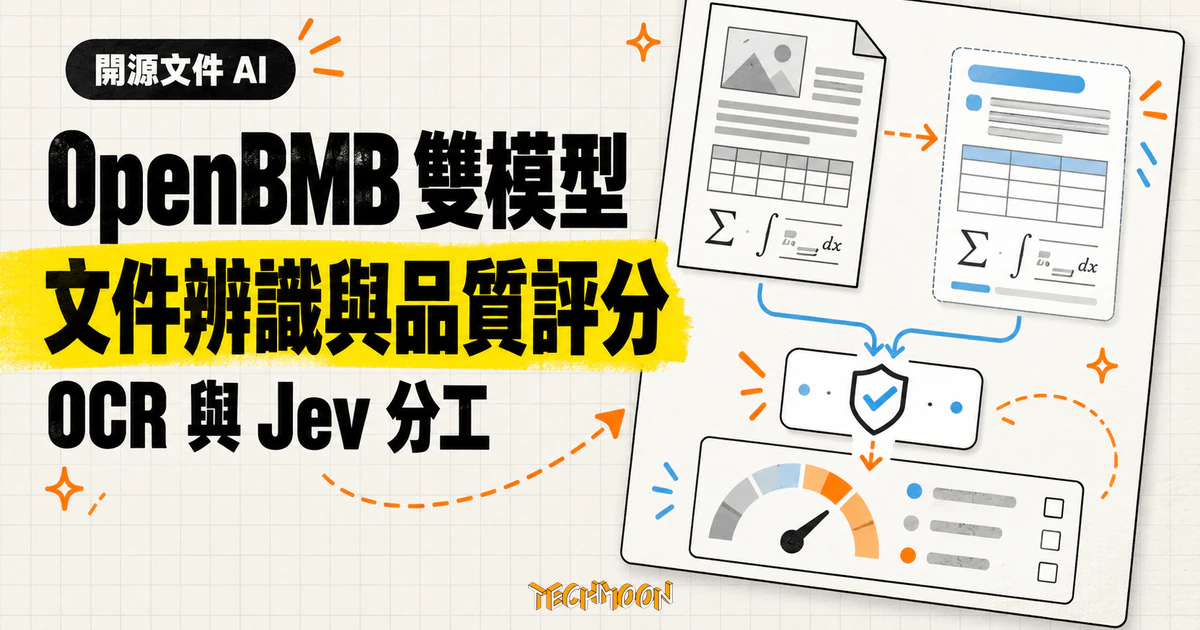
OpenBMB 於 10 月 27 日開源 MiniCPM-OCR 1.0 與 MiniCPM-OCR Jev 兩個模型:前者 1.3B 參數負責中英文文件與 PDF 的文字、表格、公式辨識,後者 2B 參數對照原始影像與辨識結果,對每個區域給出零到一的品質分數,把「哪些結果要人工複核」變成可排序的工程問題。本文核對 GitHub、Hugging Face 與官方模型文件,整理 AUROC 0.936 的正確讀法、部署條件與 Apache 2.0 授權邊界。
用 AI 摘要這篇文章:
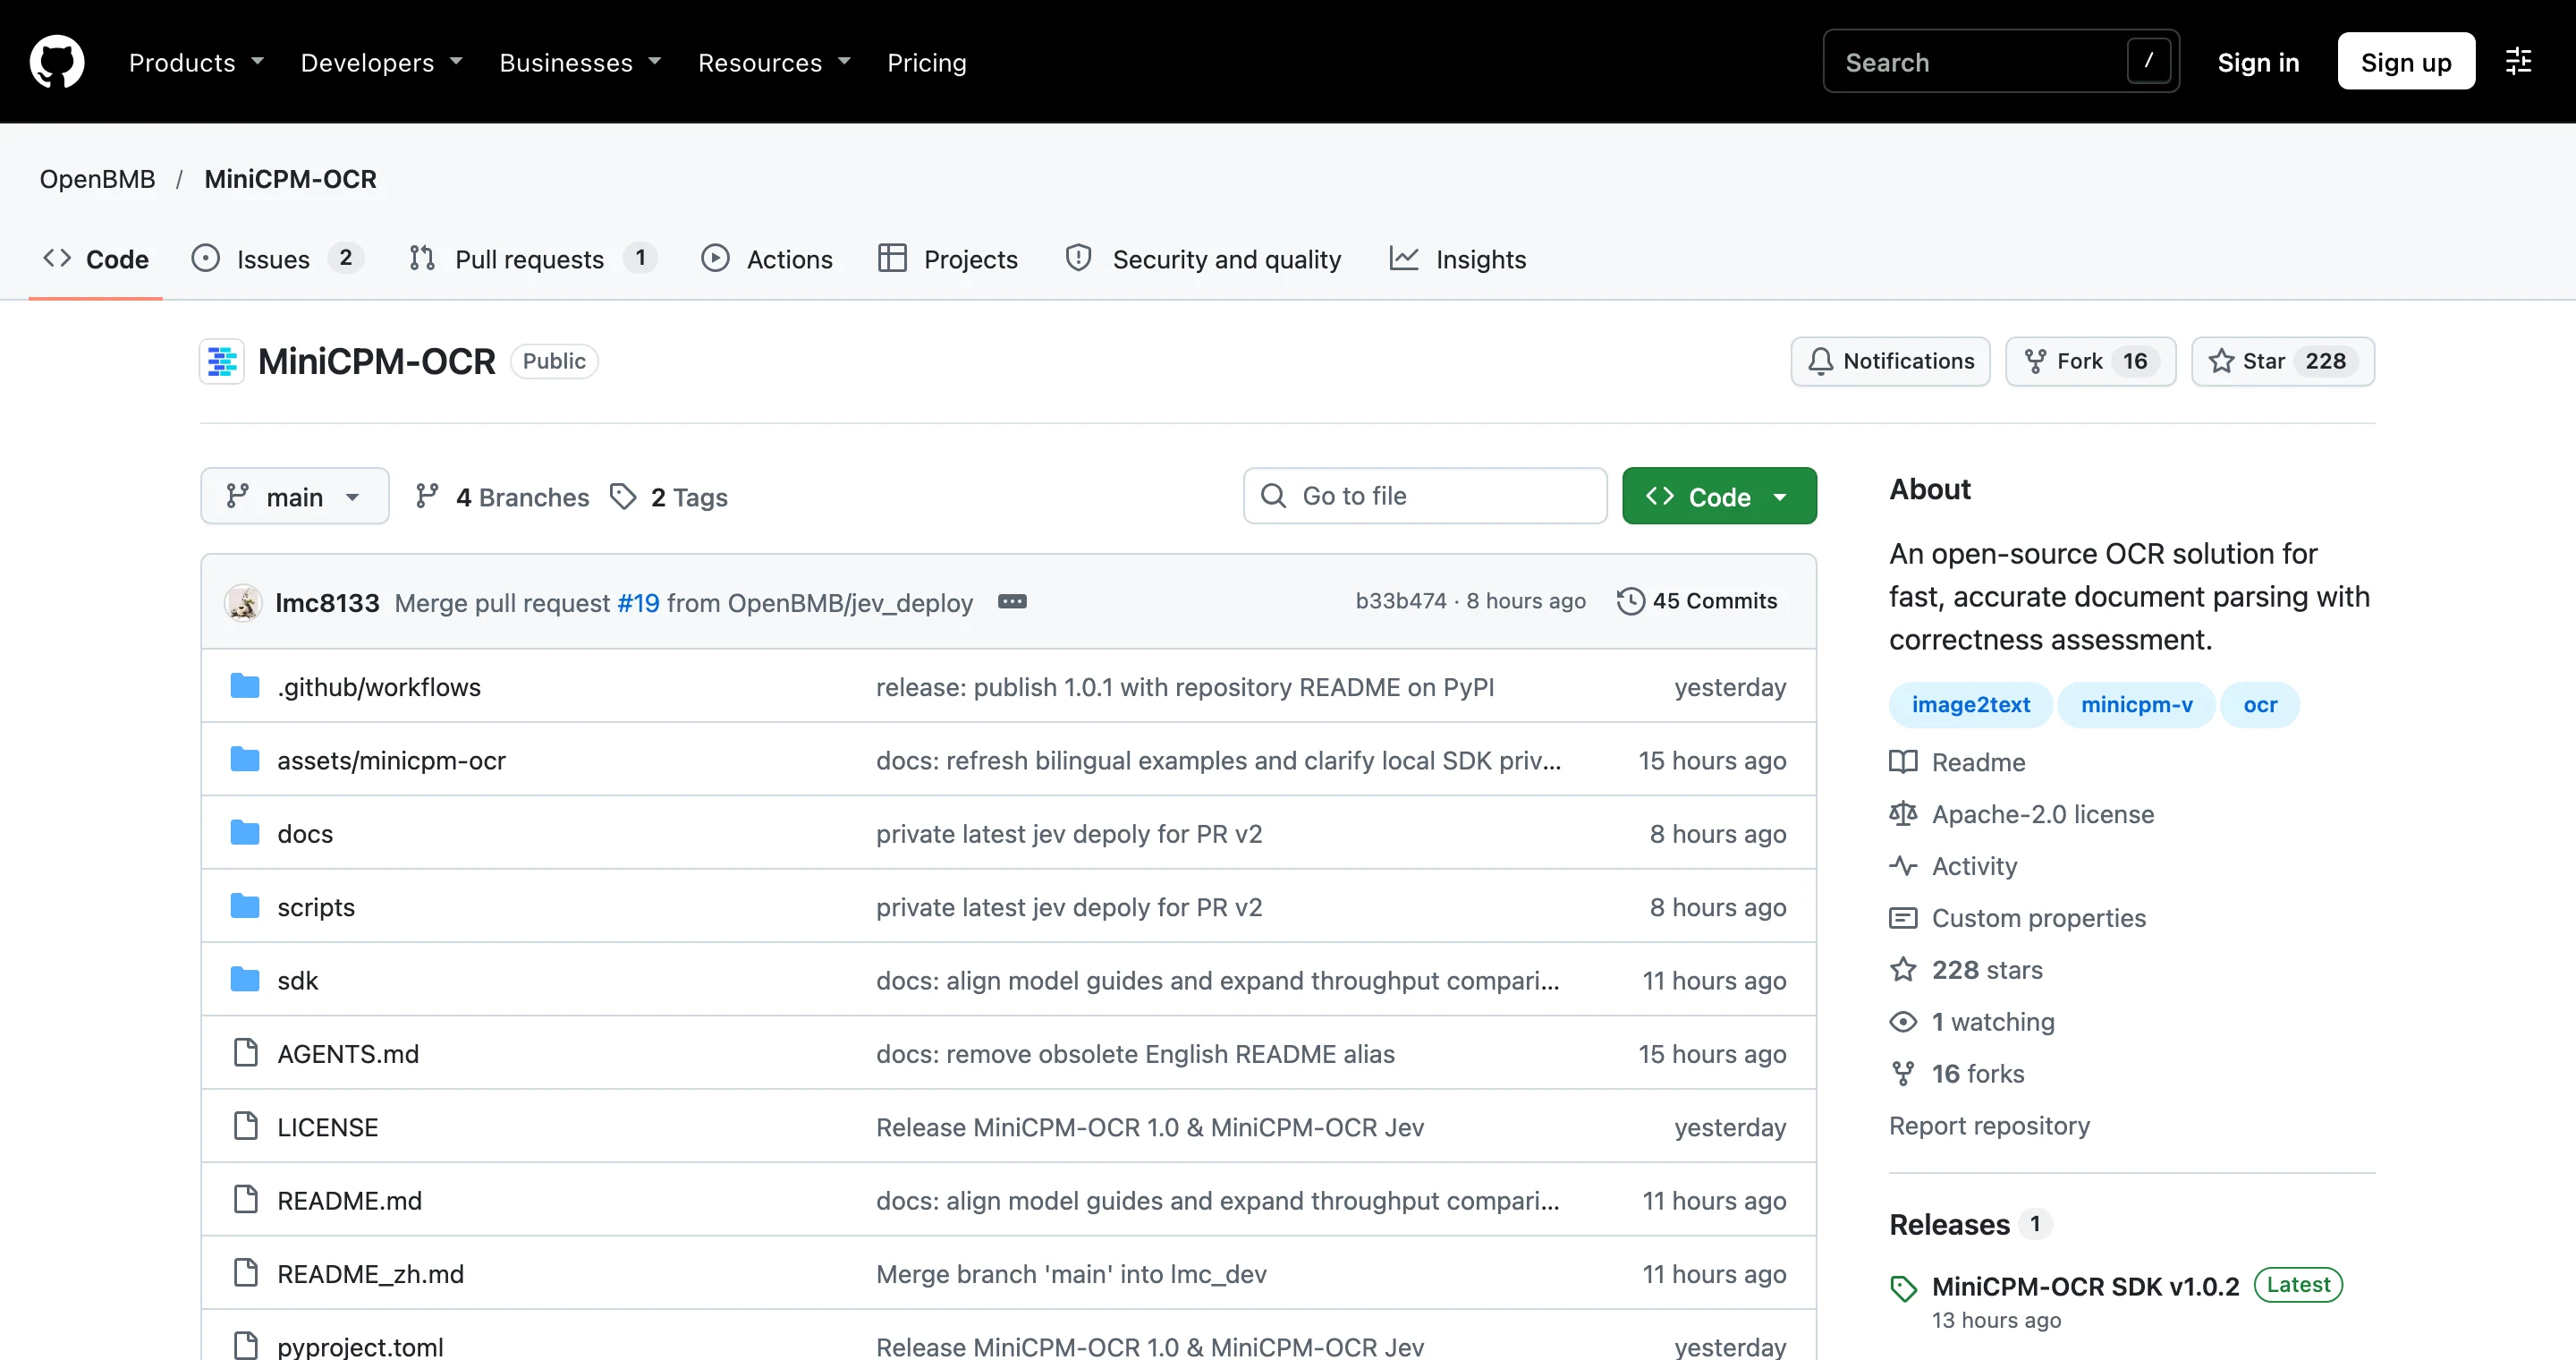
推出 MiniCPM 開源模型系列的團隊 OpenBMB,在 2026 年 10 月 27 日(UTC)公開發布 MiniCPM-OCR 系列,一次開源兩個模型:負責辨識的 MiniCPM-OCR 1.0,以及負責幫辨識結果打分數的 MiniCPM-OCR Jev。官方 X 帳號的公告時間是 27 日 16:52 UTC,換算台灣時間已經是 10 月 28 日凌晨零點 52 分;GitHub 專案同日建立,兩個模型的權重其實早在 10 月 21 日與 23 日就先安靜上傳 Hugging Face,等公告日才正式宣傳。整個專案採 Apache License 2.0,連兩個模型的權重都包含在內。
這次發布真正值得記下的變動,是把文件辨識的品質把關做成了一個獨立模型。過去 OCR 引擎交出辨識結果後,結果對不對、哪些頁面要先人工檢查,通常靠人員抽樣或另寫規則;Jev 把這件事變成模型輸出,對每個文字、公式或表格區域給一個零到一的分數,讓「先檢查哪裡」變成可以排序、可以設定門檻的工程問題。
MiniCPM-OCR 1.0 是 1.3B 參數的辨識模型,官方定位為 MiniCPM-V/o 家族第一個 OCR 專用模型。它吃中英文文件與 PDF,應付掃描、拍照、歪斜、彎曲與翻拍頁面,輸出 Markdown 或 JSON,表格會轉成 HTML、公式保留 LaTeX。辨識範圍除了文字、表格、公式,官方文件還列了圖表與印章,並支援關鍵資訊抽取(key information extraction,直接對圖片指定欄位要 JSON,例如發票的店名與金額,文件不在圖片中時以三個井字號佔位)。
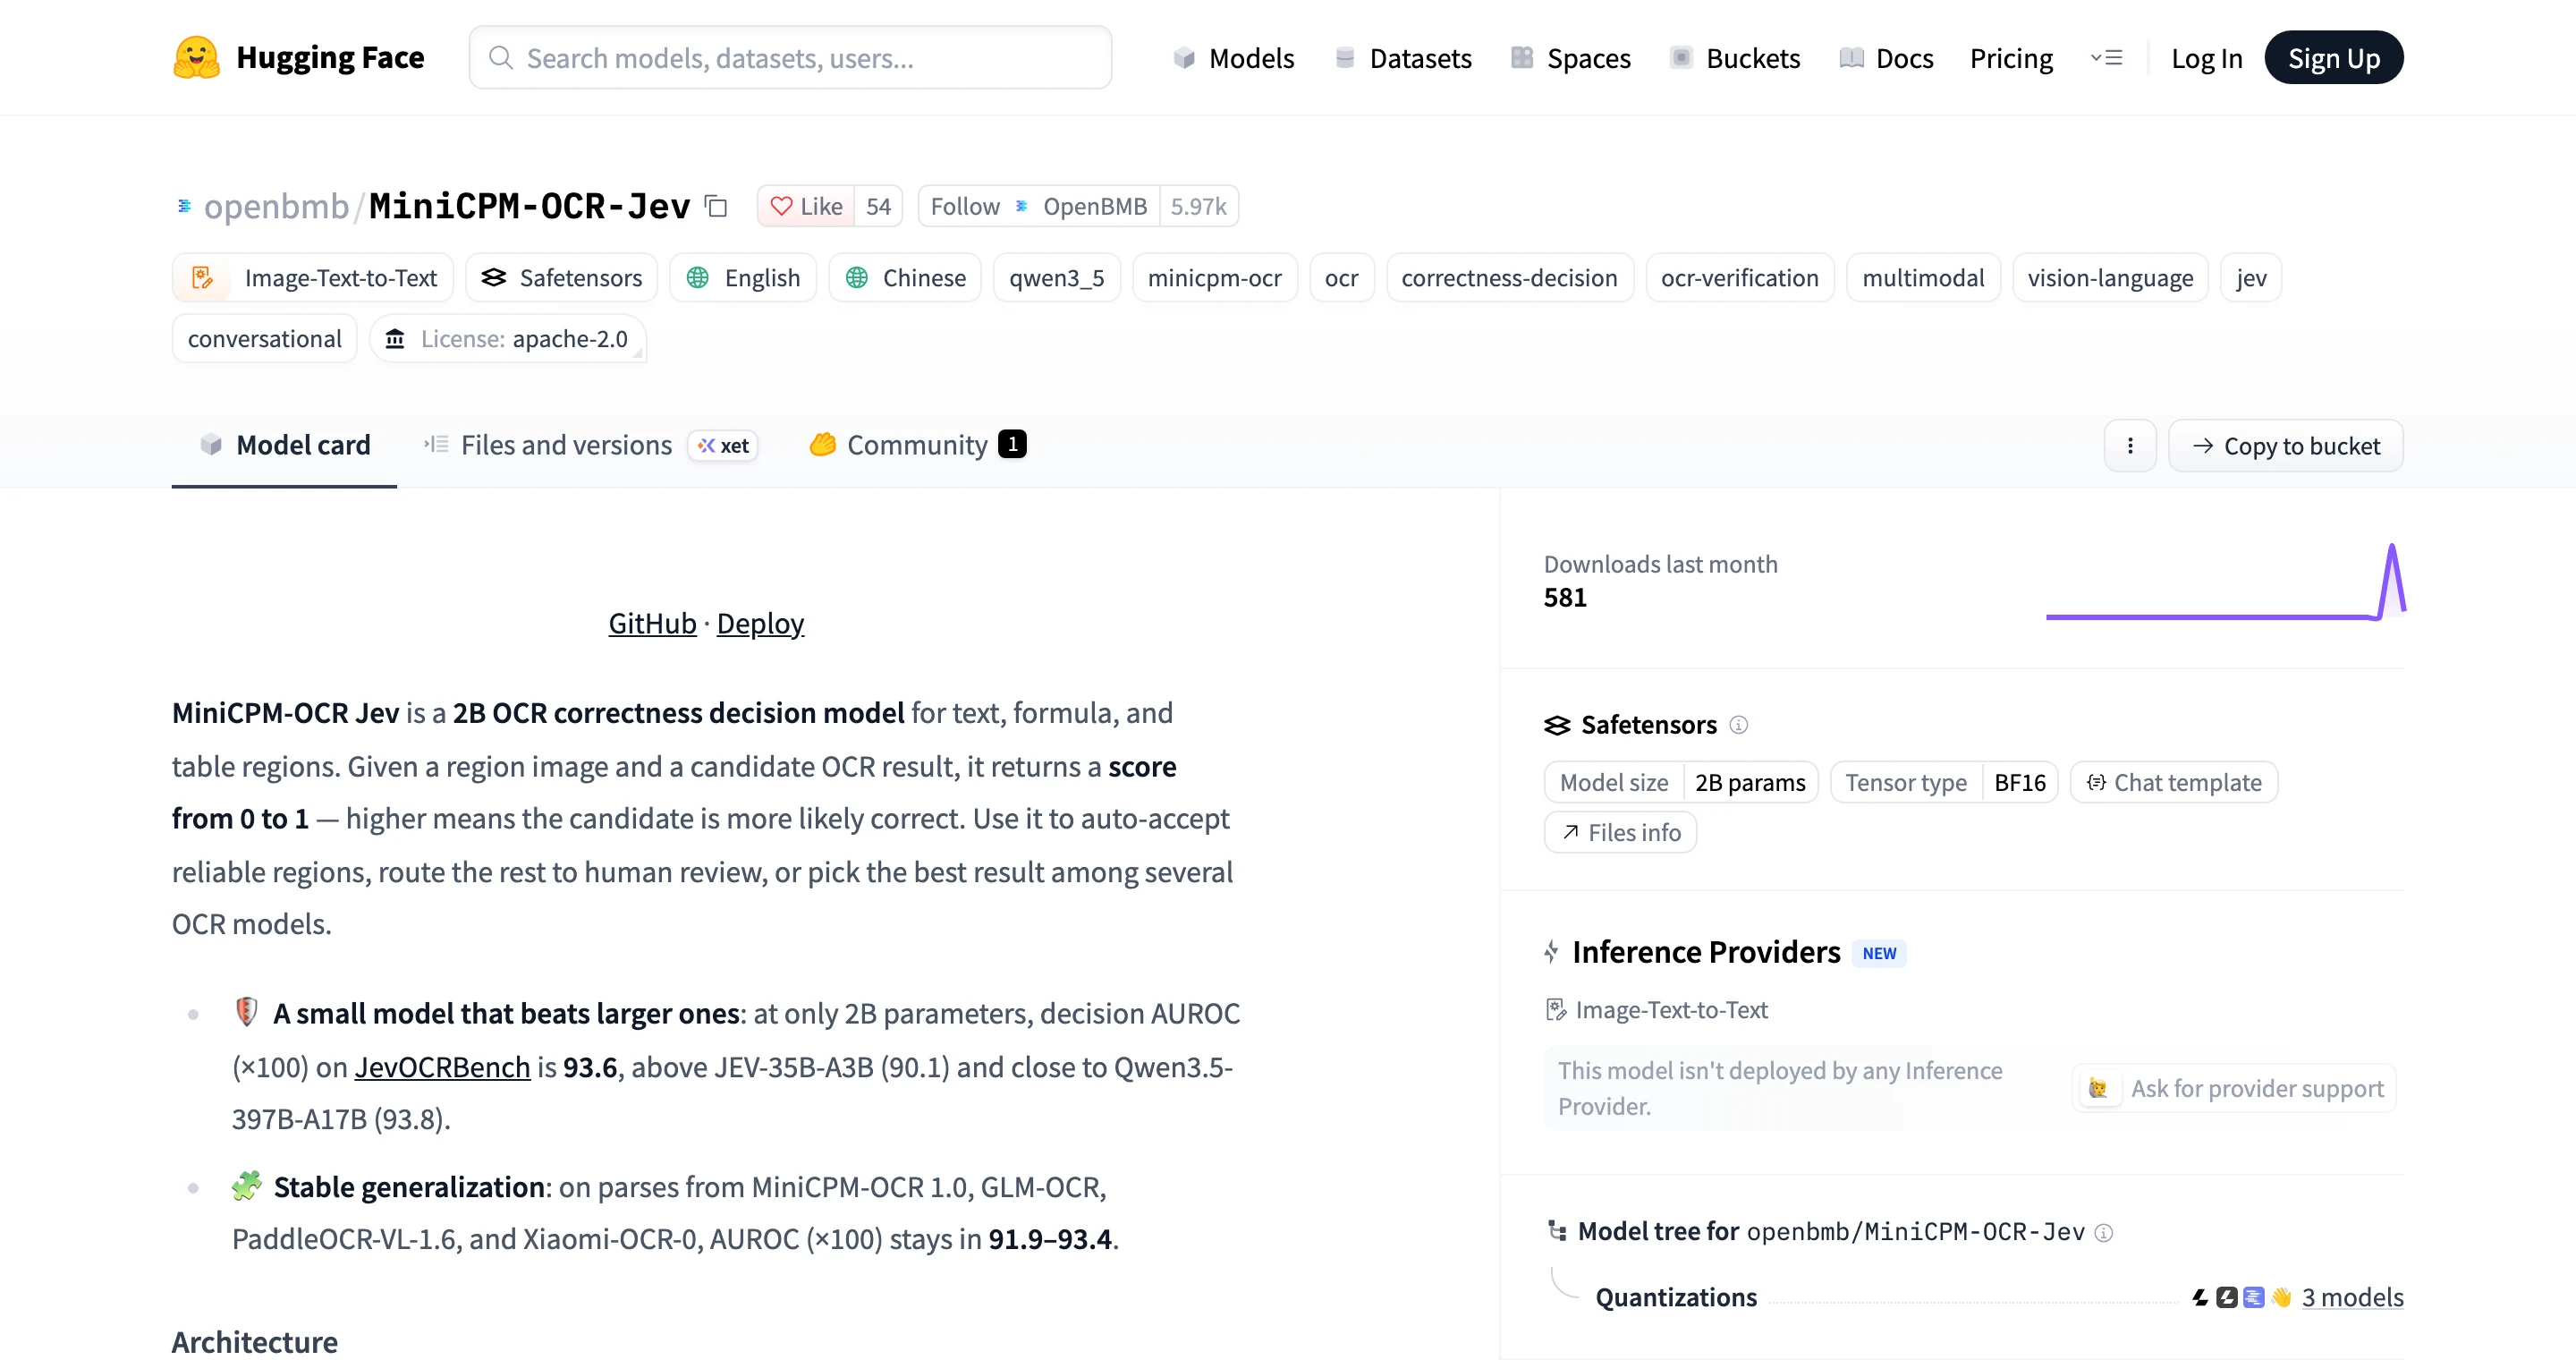
MiniCPM-OCR Jev 是 2B 參數的品質評分模型。官方技術文件寫明它從 Qwen3.5-2B 改造而來,把語言模型的輸出頭換成二元分類頭,任務只剩回答一件事:這個區域的辨識候選文字對不對。它每次看三樣輸入:原始區域影像、候選辨識文字、以及把候選文字重新渲染出來的圖片,然後輸出零到一的分數,分數越高代表模型越傾向判斷該候選正確。
要求渲染圖片這個設計,值得多想一層。純文字候選很難直接跟影像比對,但把候選文字重新畫成圖片後,模型做的就是影像對影像的比較:候選把表格欄位對錯行、公式少一個符號、數字多一個零,渲染出來的版面就會跟原圖對不上。這是從輸入設計讀出來的機制推論,官方文件沒有逐條解釋比對細節,但渲染步驟的存在本身,說明這個模型看的東西比字串比對多。
兩個模型可以分開用,這是設計上的重點。Jev 的評分對象並不限定 MiniCPM-OCR 1.0 的輸出,官方實測報告列了四種解析器的結果都能評:GLM-OCR、PaddleOCR-VL-1.6、Xiaomi-OCR-0 與 MiniCPM-OCR 1.0 本身。換句話說,已經有 OCR 流程的團隊可以只拿 Jev 當分數層疊上去,原本的引擎不必換。
官方文件還示範了第二種用法,把 Jev 當多引擎之間的裁判。同一個區域讓幾個 OCR 模型各自辨識一遍,Jev 對每個候選打分數,同一區域取分數最高的候選,再按原始閱讀順序組回完整文件;全部候選都低於門檻時照樣送人工。這條路有兩個前提要先記住:各候選必須用同樣的裁切與內容邊界,而且 Jev 只能在既有候選裡挑,最終品質上限仍取決於候選們涵蓋了多少、對了多少。API 對應的三種呼叫方式也照這個邏輯設計:單一候選評分用 score,同區塊多候選選最好用 score_best,跨多區塊批次挑選用 score_best_batch。
從產品線的角度看,這次發布也補上 OpenBMB 自家版圖的一塊空缺。官方把 MiniCPM-OCR 1.0 定位成 MiniCPM-V/o 家族的第一個 OCR 專用模型,在它之前這個家族還沒有專做文件的成員;這次不只補了辨識模型,還多配了一個驗證器角色,與辨識模型分工。辨識模型拚正確率、驗證模型拚把關,兩條線各自迭代,這個分工本身就是這次發布最大的新聞點。
安裝方式還有一個 2026 年才看得到的細節:repo 附了一份 SKILL 文件,設計給編碼代理讀取執行,把環境搭建、模型下載到解析第一份文件的流程寫成代理可以直接照做的指令。不想自己讀部署文件的人,把那段指令貼給自己的編碼代理就能起步,這條路線官方列在四種整合方式之首。
官方給 Jev 的成績是 AUROC 乘一百等於 93.6,評測集是自家釋出的 JevOCRBench。這個數字常被誤讀成九成三的正確率,但 AUROC 量測的是分數能不能把對的結果和錯的結果排開:一個完美排序器 AUROC 是 1.0,隨機亂排是 0.5,它本身不告訴你任何一個門檻之下會放過多少錯誤。官方文件自己也寫了提醒,AUROC 不等於自動採用結果的正確率,也沒有通用預設門檻;分數也沒有校準成正確率機率,要把它當機率用,官方要求先驗證分數區間跟實際對錯比例是否吻合。
JevOCRBench 的組成值得攤開看。資料集共 2,267 筆中英文記錄,涵蓋文字、公式與表格,影像取自 OmniDocBench v1.6、Real5-OmniDocBench 與 olmOCR-bench 三個公開評測集,候選文字抽自前沿 OCR 模型的真實輸出,再由人工標註對錯。也就是說,它測的是「真實錯誤長什麼樣」,而不是人造的錯字。
官方的對照數字有兩套。與大模型比較這套:Jev 以 2B 參數拿到 93.6,優於 JEV-35B-A3B 的 90.1,逼近 Qwen3.5-397B-A17B 的 93.8,這是官方自行公布的評測。跨解析器實驗這套:從 JevOCRBench 隨機抽 200 筆,四種解析器各自辨識後由 Jev 評分,AUROC 落在 91.9 到 93.4 之間,最大差距 1.5 分,官方結論是換不同解析器時表現穩定,但同時提醒這只描述這 200 筆樣本與這四種組合。
分數落地時真正要看的指標,官方叫它免複核比例下的正確率:把門檻逐漸調高,自動通過的比例會上升,但被自動通過的結果正確率會下降,兩者是一條往下的取捨曲線。官方放了法律文件、財務收據與複雜文件三種文件類型的曲線圖,圖上沒有給通用數字,因為曲線位置完全取決於文件類型與錯誤分布。門檻開得鬆,進複核清單的頁少、漏掉的錯誤多;開得嚴,人工工作量回升,兩邊都是成本,這正是官方堅持門檻必須自校準的原因。
分數怎麼落地,官方給了三步建議:先收集涵蓋自家文件類型的樣本並逐區標註對錯;用 Jev 評分後在幾個門檻值分別量測自動採用率與被採用結果的正確率;再依能容忍的錯誤程度選門檻,換解析器或文件分布改變時重新校準。文件裡另有一個容易踩的坑:透過 API 或服務呼叫時,回傳欄位要先看 verdict,只有標為 scored 才是真的模型評分,前置檢查、渲染或前向傳遞失敗的固定回傳值不可以當成低分處理。
MiniCPM-OCR 1.0 的官方成績單裡最亮的是 Real5-OmniDocBench 93.68 分,官方以此宣稱達到最先進水準。這個評測集不是 OpenBMB 自家的,而是 PaddlePaddle 釋出的真實文件解析評測集;官方同時宣稱在 OmniDocBench v1.6、Wild-OmniDocBench 與 olmOCR-Bench 上取得領先,一般辨識能力則以 OCRBench v2 的 54.7 分佐證,兩個基準量的是不同任務,官方提醒分數不能直接互比。這些都是官方在指定評測集與計分方式下的自行測試,第三方獨立驗證目前沒有。
速度數字的條件也要看清楚。每秒 1.2 頁的成績,測試環境是 NVIDIA RTX 5090、用 OmniDocBench v1.6 全部 1,651 張圖片、影像層並發為 1;把並發開到 8,可到每秒 2.133 頁,相當於 1.75 倍提速。官方另外宣稱吞吐量約為 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍,同樣是官方自測數字。拿這些數字估算自己機器的產能之前,先確認硬體與輸入條件可比。
加速方案 DSpark 也值得一拆。它是一個 297M 參數的草稿取樣頭,與主模型搭配執行,官方宣稱讓端到端處理效率提升 55%;不用加速的一般解碼不需要它。難得的是官方自己把未定案的部分標了出來:評測頁雷達圖的替代文字註明部分數值仍待確認,評測重現指南也寫著部分細節待補。發布第二天的數字,引用時最好連日期一起記下。
部署面官方主打第一天就支援 vLLM、SGLang、llama.cpp 與 Ollama 四種執行方式,兩個模型的權重都有 BF16、GGUF、AWQ、GPTQ 可選,DSpark 加速頭只配給 MiniCPM-OCR 1.0、不需要加速的一般解碼用不到它;另有支援 FlagOS 的多晶片版本,以及 LLaMA-Factory 與 Swift 兩套微調教學,兩個模型各有一份,Jev 的微調資料格式就是原始區域圖、候選文字、渲染圖加上人工對錯標籤。想快速看效果,官方提供線上示範(中國站與國際站)與免費 API;本機路線則有 pip 套件,這裡有個小坑:PyPI 上的套件名是 minicpm-ocr,Python 的 import 名卻是 minicpmvocr,兩個名字對不上是官方 FAQ 承認的常見問題。
用 vLLM 跑會碰到另一個環境條件:目前的推理環境用 CUDA 13,驅動要在 580 以上,官方 FAQ 給了資料中心卡的相容套件解法。記憶體不夠時的官方建議是把 gpu-memory-utilization 降到 0.7,或把最大模型長度限到 16384;版面分析預設走 GPU,裝了 CPU 版 paddle 的機器要手動把 layout.device 指到 cpu。
授權要分兩層看。專案本身,程式、文件與兩個模型的權重全部採 Apache License 2.0,商用沒有額外條款;但 JevOCRBench 評測資料集的授權是獨立的 data terms,與模型權重不同,把評測資料拿去做自己的基準測試前要先讀那份文件。
資料流向也是本機路線的實際賣點。模型權重開放下載,四種執行方式都在自家機器上跑,文件不出機器就能跑完整條解析與評分管線;官方的線上示範與免費 API 是另一個入口,但雲端服務的帳號條件、用量限制與資料保存規則,官方文件目前沒有寫清楚,把含個資的文件丟上雲端入口前,這些規則值得先查到白紙黑字再決定。
官方對語言的宣稱就一句:支援中英文文件與 PDF。繁體中文、直式排版、手寫內容的任何獨立測試數字,在官方文件裡都找不到,這件事官方也沒有宣稱過。中文文件需求高的團隊,可以對照另外兩條已驗證的路線:RapidOCR 離線就能跑、繁中直接用預設模型,OnnxOCR 則是模型隨原始碼附上、一行指令起服務,兩者 TechMoon 都做過實測。
導入 Jev 的驗收不必大動干戈。挑一批已人工核對過的繁中文件,讓既有 OCR 流程跑完,用 Jev 對每個區域評分,再對照門檻掃一遍:低分區域真的錯得多嗎、高分區域漏掉了哪些類型的錯誤。統一編號、金額、日期這類一個字元錯就代價很高的欄位,就算分數高也值得保留人工複核,因為 AUROC 只保證排序傾向,不保證任何單一區域的對錯。
已經在跑 OCR 流程、又有複核人力可調度的團隊,這週就可以做一輪小樣本測試:拿 Jev 接上現有引擎的輸出評分,用官方建議的門檻校準流程量一次:不同門檻下各攔到多少錯誤、放過多少,這是判斷它值不值得留下的最直接依據。想要一條鏈本機解決文件解析的團隊,MiniCPM-OCR 1.0 的 GGUF 與 Ollama 路線入門門檻最低,先拿自己的文件看輸出品質再談導入;同類的開源選擇還有用視覺模型把 PDF 轉 Markdown 的 Zerox OCR,可以一起放進候選名單比。只想看看效果、不想裝任何東西的人,官方線上示範可以直接丟文件試。反過來說,文件量小到人工檢查不痛、或者流程裡本來就每一份都人工看過的團隊,這次發布對你沒有立即影響,不必跟進。
發布未滿兩天,還有幾件事懸著。官方雷達圖自標部分數值待確認,評測重現指南的細節也還在補;Jev 的雲端 API 文件官方標註即將推出,免費 API 的用量與資料保存規則要等文件齊了才能核對;技術報告或論文目前沒有,評測方法只能看 repo 文件;繁中文件的表現如前述沒有任何官方數字。Hugging Face 模型卡到 10 月 28 日都還在更新,建議 11 月 5 日前回查一次專案頁,確認榜單數字與 API 條款有沒有變動,屆時這些數字可能已有變動。