TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

AI 文字偵測器 Pangram 在 10 月 19 日推出 4.1 版,偵測結果對把握較低的文章改為顯示「最佳估計 4%,可能範圍 0 到 15%」這類區間提示,並新增每段文字屬於人寫、AI 輔助或 AI 生成的機率輸出。官方模型卡顯示英文誤判率從 0.0164% 降到 0.0090%,但英文與多語漏判率同步上升,中文場景的錯誤率官方仍未單獨驗證。
用 AI 摘要這篇文章:
台北時間 10 月 20 日凌晨 2 點 27 分,Pangram 團隊成員 Max Spero 在 X 上宣布 Pangram 4.1 上線,官方模型卡的發布日期是 10 月 19 日,接替 7 月 29 日推出的 Pangram 4。Pangram 是一款 AI 文字偵測服務,主要賣給老師、編輯與研究人員,用來判斷文章有多少比例像 AI 寫的。這次更新沒有換引擎:模型卡明寫輸入、訓練與推論流程全部不變,改的是輸出與介面。最直觀的變化,是偵測結果對把握較低的文章不再只給一個百分比,而是附上一個寫著估計區間的提示框。
AI 偵測工具一直有個先天限制:使用者想要「這篇文章是不是 AI 寫的」的明確答案,工具能給的卻只是統計預測。Pangram 4.1 這次等於把這段落差搬進介面裡,讓使用者直接看到預測的不確定性。圍繞這次更新,最值得問的其實是三件事:那個區間提示到底在量什麼、4.1 比前一版準多少、以及中文文章測得準嗎。以下依照官方模型卡、準確度文章與 API 文件逐一回答。
Spero 貼文附的截圖裡,提示框的標題是「AI percentage could vary」,意思是 AI 比例可能變動。框內寫著估計區間 0 到 15% 的 AI 文字,最下面一行是「Our best estimate is 4%, with a likely range of 0–15%」,最佳估計 4%,可能範圍 0 到 15%。
要讀懂這個數字,得先分清它在量什麼。Pangram 的文件層級輸出裡,fraction 開頭的欄位定義是「以字元數加權的比例」,也就是文章中被判成某個類別的部分占全文多少。官方沒有逐一說明介面百分比對應哪個欄位,但依欄位定義,這類數字指的是「有多少比例的文字像 AI 輸出」,而不是「整篇文章由 AI 寫成的機率」。這兩種意思差很多:顯示 4%,代表模型認為約 4% 的字元像 AI;顯示 15%,也不代表有 15% 的機率整篇都是 AI。
Pangram 的輸出有兩層。片段層級是把文章切成一段段變動長度的文字,每段標上 Human、AI-Assisted、AI-Generated 三選一的標籤;4.1 唯一新增的輸出欄位 class_probabilities,就是每段附上屬於這三個標籤的後驗機率,各一個 0 到 1 之間的數值。文件層級再把各段加總成整篇文章的比例與結論。模型解析度也稍微提高,所以偵測結果裡偶爾會出現更短的片段,官方的說法是這代表判斷切得更細,沒有說這會讓文章更容易被判成 AI。
文件層級的 Human、Mixed、AI 三種結論是按門檻決定的。Pangram 4 的模型卡寫明,至少 90% 的字元被判成人寫才算 Human,至少 80% 的字元被判成 AI 才算 AI,其餘都是 Mixed,而 4.1 對這條規則沒有改動。依門檻推算,4% 的估計值落在人類那一側,但 15% 的上限已經越過 90% 的門檻線,換句話說,同一篇文章的結論有機會在 Human 與 Mixed 之間擺動。範圍提示的價值就在這裡:它讓你看到這個判定可能往上或往下偏。
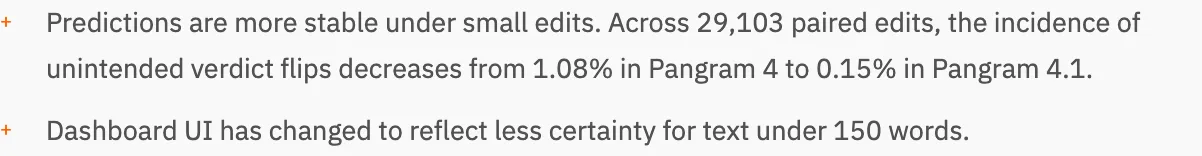
至於什麼時候會出現這個提示框,官方有兩種說法。Spero 的貼文說它用在「比較不確定的文件」;4.1 模型卡則寫儀表板對少於 150 個單字的文字顯示較低的確定性。兩句話沒有完全對齊,官方也沒有交代完整的觸發條件,只能確定短文會顯示得更保守。另外 150 這個數字以英文 word 計,中文文章怎麼折算,官方沒有另給標準。
還有一句話建議照宣稱的等級看待。Spero 說團隊把信心程度「校準得更好」,但 4.1 模型卡裡找不到任何校準評測;Pangram 4 的模型卡甚至明寫,confidence 欄位的高中低三級量的是模型後驗分布的集中程度,「不是校準過的機率估計」。校準有沒有變好,目前只能算官方說法。
模型卡把兩種錯誤都攤開了:誤判是把人寫的文章判成 AI,漏判是把 AI 生成的文章判成人寫。對使用者來說,4.1 的成績單是兩面的。
| 評測項目 | 樣本 | Pangram 4 | Pangram 4.1 |
|---|---|---|---|
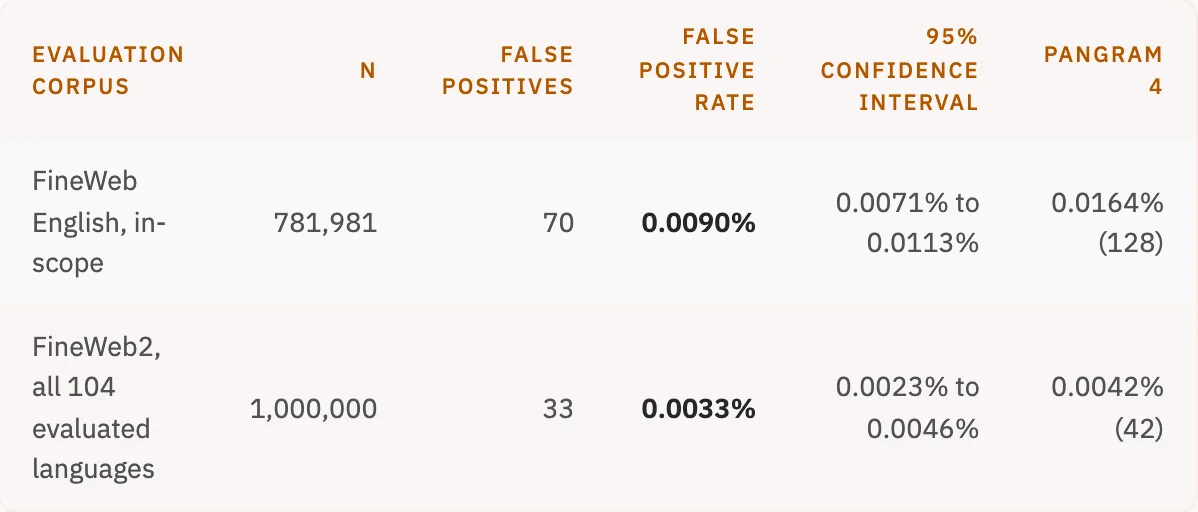
| 人寫英文網頁誤判率 | FineWeb 781,981 篇 | 0.0164%(128 篇) | 0.0090%(70 篇) |
| 人寫文章誤判率(104 種語言) | FineWeb2 100 萬篇 | 0.0042%(42 篇) | 0.0033%(33 篇) |
| 英文 AI 文章漏判率 | 26 個生成模型共 520,000 篇 | 0.3396% | 0.3652% |
| 多語 AI 文章漏判率 | 18 種語言共 190,149 篇 | 1.24% | 1.99% |
| 小幅修改後判定翻轉率 | 29,103 組成對編輯 | 1.08% | 0.15% |
誤判率的改進相當明確:英文網頁從 0.0164% 降到 0.0090%,件數從 128 篇降到 70 篇,減少約四成五;104 種語言合計也從 0.0042% 降到 0.0033%。模型卡還附了 95% 信心區間,兩項都落在區間內。
穩定性是另一個亮點。官方用 29,103 組成對的小幅修改測試,同一篇文章做個微小更動後,Pangram 4 有 1.08% 的機會讓判定結果翻轉,4.1 降到 0.15%。對重複掃描同一批稿件的編輯流程來說,判定不再那麼容易因為改幾個字就變來變去。
漏判率則是退步的。英文 AI 文章從 0.3396% 升到 0.3652%,多語 AI 文章從 1.24% 升到 1.99%,等於每 50 篇非英文的 AI 文章就有一篇左右被判成人寫。Pangram 在 10 月 16 日的準確度文章裡自己說了原因:他們刻意把工具調向寧可漏判也不要誤判,因為誤判會造成真實的傷害。這個取捨沒有改變,只是 4.1 又往漏判那邊多偏了一點。
分生成模型看,好壞互見。Claude 家族的漏判率從 0.195% 降到 0.181%,GPT 家族從 0.316% 微升到 0.323%,Gemini 家族從 0.498% 升到 0.598%,Grok 4.3 從 0.605% 升到 0.720%。也就是說,4.1 對某些模型寫的文章更敏銳,對另一些反而更遲鈍,只看總平均會掩蓋這件事。
模型卡也列了三項第三方評測:非英語母語者的 91 篇人寫文章誤判為 0,另一項 15,936 篇的測試誤判與漏判都是 0,還有一項 39 篇全 AI 文章的漏判為 0。數字漂亮,但 91 篇與 39 篇的樣本太小,參考價值有限,加減看待即可。值得放在旁邊對照的,是官方準確度文章對新模型的追蹤:GPT-6 Astra 0.41%、Claude Fable 5.1 0.36%、Claude Opus 5.5 0.30%、Claude Sonnet 5.5 0.29%,漏判率與舊模型在同一個量級。官方的解釋是新一代模型繼承了前代的寫作風格,所以沒看過的模型不會特別難抓。
引用這些數字時還要注意口徑。準確度文章說 Pangram 4 在 204 萬多篇人寫文件上的誤判率是 0.0041%,但 4.1 模型卡裡同一個 Pangram 4 的英文誤判率是 0.0164%,差了四倍。兩邊用的資料集不同:前者混合官方授權與自有文件,後者是 FineWeb 網頁文字。不同資料集的錯誤率不能直接比較,官方數字也不是你手上那批稿件的保證值。另外 Pangram 4 模型卡多語漏判的件數欄寫 23,578 篇,與 1.24% 對不起來(依樣本數換算約 2,358 篇),引用時以比例為準。
Pangram 的支援語言清單有 24 種,中文在列。4.1 模型卡的分語言誤判表裡,中文子集(FineWeb2 收錄的 2022 年前文章)誤判率是 0.0000%,與 Pangram 4 相同;Pangram 4 模型卡另列了各語言漏判率,中文是 0.7133%。
不過這個 0.7133% 有兩層但書。樣本本身是多語 AI 生成文章,做法是把英文的教學、新聞與評論文章做成 18 種語言的鏡像版本,中文漏判率是在這種樣本上量的,不是台灣本地的學生作業或職場文體。再者,官方文件從頭到尾沒有區分繁體或簡體,也沒有給中文子集的樣本數,4.1 模型卡更沒有再列各語言漏判率,只有多語整體升到 1.99% 這個數字。
評測資料的選法也值得知道。人寫文章的誤判率是用 FineWeb 與 FineWeb2 這類大型網頁語料量的,多語部分刻意只用 2022 年以前收錄的文章。官方沒有解釋這個切點,合理的推測是那之前的網頁語料被生成式模型汙染的機會較低,當「確定是人寫的」樣本比較站得住。代價是這些樣本代表的是網頁上的散文寫作,學生報告、求職信、公司公告的長度與寫法都不一樣,錯誤率不能直接平移到你的場景。
所以比較誠實的讀法是:中文「在支援清單上」,而且英文誤判率的改進看起來也延伸到了多語,但台灣場景的實際錯誤率官方沒有給答案。真的要導入,先拿自己的一批已知來源的稿件跑一遍,比引用任何官方百分比都有用。若想先看看其他偵測工具的實測表現,我們之前測過騰訊的朱雀 AI 檢測,也整理過五款 AI 檢查器的比較。
模型卡的倫理段落寫得很直白:模型錯誤率不是零,錯誤的指控可能帶來名譽損害與情緒創傷。官方承諾持續與使用者及學界溝通如何解讀偵測結果。這段話值得每個想把分數寫進處分流程的人先讀一遍。
具體的限制可以分成幾類。文章長度是最明顯的:官方設計是處理至少 50 個單字、以完整句子寫成的長文,50 到 99 字的短文誤判率約 0.02%、漏判率約 1.29%,拉長到 250 到 499 字後兩個數字分別降到 0.004% 與 0.21%。越短的文字越不可靠,而社群貼文、簡短作業正好都落在危險區。
混合寫作是另一層。被 AI 大幅修改過的文章,約 41% 仍被判成人類、55% 判成混合、3.6% 判成 AI;官方自述遇到混合文字時「偏向判成人類」。反過來說,只用 AI 做文字潤飾的文章有 99.45% 維持人類標籤,這是刻意設計。這代表偵測結果回答的是「文字看起來像誰寫的」,回答不了「作者有沒有用 AI」,單看標籤很容易低估 AI 的參與程度。
文體又多一層。官方列出的範圍外項目包括程式碼與標記語言、目錄與參考文獻、制式或自動產生的文字、機器翻譯、操作說明與食譜、以數學符號為主的內容。詩的誤判率 0.078% 是各領域最高,官方建議這類寫作要另外把關。送件格式也有講究:模型卡建議用純文字或 .docx 檔,少用 PDF,因為 PDF 的解析偶爾會產生預期外的字元痕跡,干擾判讀。順帶一提,Pangram 從 Pangram 4 起就內建 humanizer 偵測,會輸出一個「去 AI 味改寫」的分數(發布時預設門檻 0.91),專門抓那種用工具把 AI 文字洗成人味的做法;這類工具我們也實測過一個案例,可以參考HumanizeAI 的引擎現況。
綜合這些限制,我的判斷是:偵測分數適合用來決定「要不要多看一眼」,不適合單獨用來決定「要不要處分」。老師與編輯若要導入,比較穩的做法是讓被標示可疑的稿件經過第二個人複核,並給作者說明與申訴的機會;而被偵測的人也該知道,這些數字不等於定罪,遇到爭議時完全可以要求對方交代依據。OpenAI 曾經因為準確率不足下架自家的 AI Text Classifier,這段歷史提醒我們:偵測器的分數從來就不是司法等級的證據。
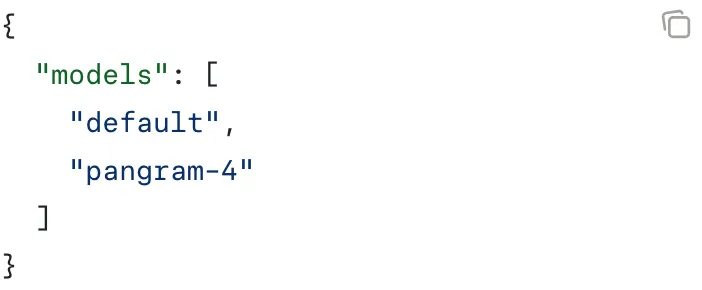
開發者這邊有個時間差的坑。API 文件的模型清單頁,範例回應仍然只列 default 與 pangram-4 兩個選項,頁面最後更新停在 7 月 29 日;偵測端點的回應欄位清單裡,也找不到模型卡宣稱新增的 class_probabilities,範例回應顯示的版本號還是 4.0。文件裡唯一確定的是 default 選項會跟著 Pangram 當前的預設模型走,但現在的預設是哪一版,頁面上看不出來。文件還提醒模型清單會因帳號權限而不同,叫開發者別把清單寫死在程式裡。要串接的人,送出請求前先確認回傳的版本欄位,別假設拿到的就是 4.1;對要把偵測結果存檔對帳的系統來說,版本沒綁死,同一篇文章隔幾天重測出現不同結果也不奇怪。
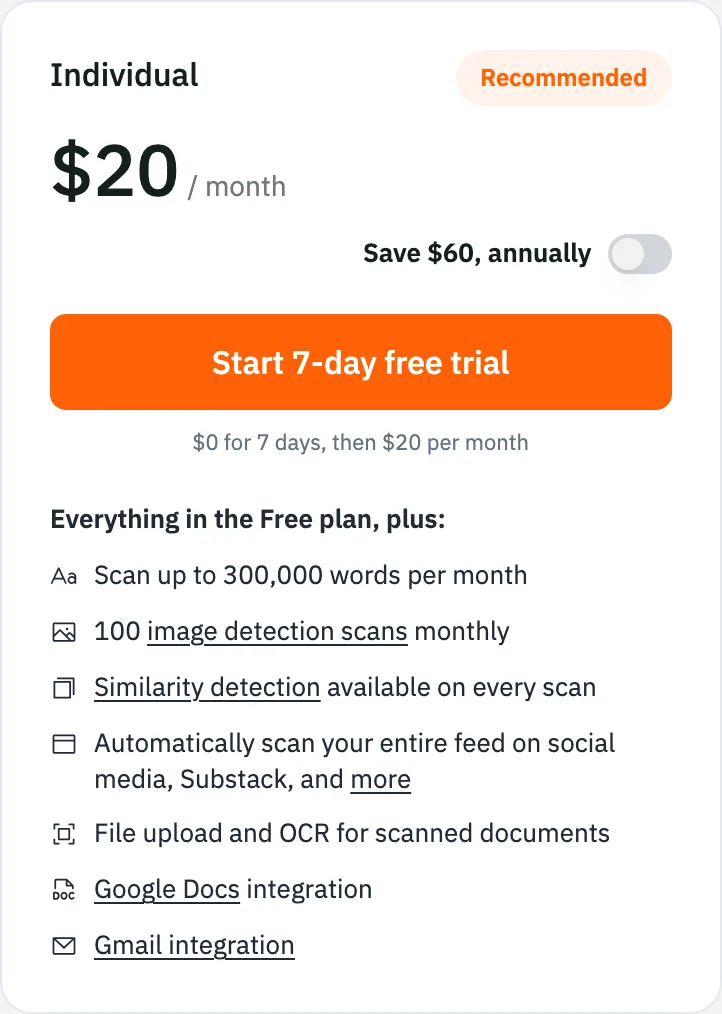
費用方面,定價頁目前標示:個人方案每月 20 美元,附 7 天免費試用,每月可掃描最多 30 萬字,外加 100 次圖片偵測;專業方案每月 65 美元,字數與圖片掃描都是五倍,每月另附 200 美元的 API 額度;團隊方案每月 40 美元含兩個席位。免費方案存在,個人方案卡片的功能清單開頭寫「包含免費方案的一切功能」,但頁面沒有列出免費版的額度細節,要試的人得自己註冊看。
這次更新把「不確定」從模型內部搬到使用者眼前,方向是對的,但該給的配套還沒給齊:API 文件補上 4.1 與 class_probabilities 的時間點、範圍提示的完整觸發條件、中文場景的錯誤率,這三件事官方都還沒有交代。導入的人盯著模型卡與 API 文件的更新就好;一般使用者若只想拿它當第一道篩子,記得範圍提示只是在告訴你「這個數字會動」,它讓分數更誠實,沒有讓分數變成證據。