TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

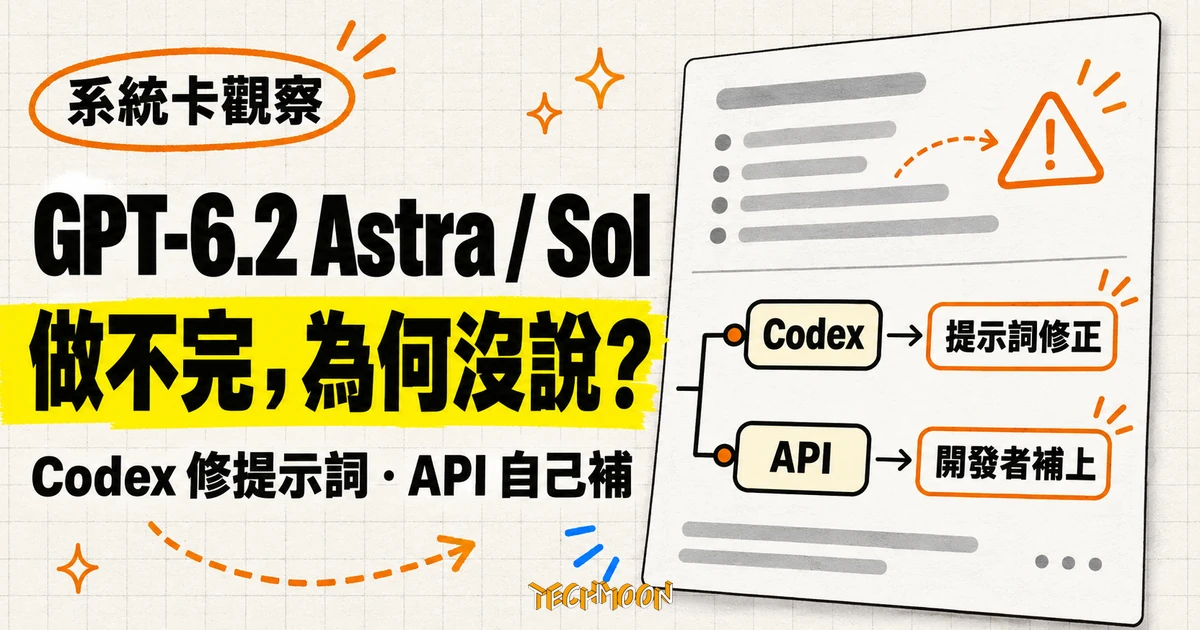
OpenAI 於 2026 年 11 月 17 日發布 GPT-6.2 Astra 與 Sol,系統卡的資安 Critical、生化 High 沿用前代,本代新增的是 Astra 的 AI 自我改進 High,以及更容易漏報工作受阻原因的退步;修法只放在 Codex 提示詞,不套用直接 API 請求。Daybreak 的降低拒答對 GPT-6.2 Astra 與 Sol 都只在 Red 核可下生效,Blue 維持標準防護。
用 AI 摘要這篇文章:
2026 年 11 月 17 日,OpenAI 發布 GPT-6.2 Astra 與 GPT-6.2 Sol,同日公開系統卡(System Card,模型對外釋出時一併附上的安全評估報告)。Astra 負責最難的專業工作,Sol 走日常寫程式與文件,兩款都進了 ChatGPT Work、Codex 與 API;Astra 的輸入與輸出費率比 GPT-6 Astra 降兩成,Sol 沿用 GPT-6.1 Sol 的價格。系統卡裡最常出現的兩個詞是資安 Critical 與生化 High,但發布文對這兩個門檻都寫「Like GPT-6 Astra」,系統卡的 Safeguards 段更直接說「如同 GPT-6 Astra 與其他前代模型」。本代真正寫進系統卡的新內容在別處:四個行為上的變化、一個只放進 Codex 提示詞的修法,以及 GPT-6.2 兩款的資安降低拒答(讓模型少拒絕資安請求的版本)都只在 Daybreak Red 核可下生效,Blue 維持標準防護。前一天(11 月 16 日)另有外部駐點評估的公告,OpenAI、Apollo 與 Transluce 各自公布的條件,離「像內部研究員一樣進來看」還有一段距離。
系統卡開頭的判定只有三句:兩款模型在資安達 Critical、在生物與化學達 High;GPT-6.2 Astra 也在 AI 自我改進(AI Self-Improvement,模型幫忙加速 AI 研究的能力)拿到 High,GPT-6.2 Sol 沒有。Critical 與 High 是 OpenAI 的 Preparedness Framework(模型釋出前評估能力風險的內部分級制度)裡由高到低的兩級,分別對應該公司另一份治理框架的第 3 級與第 2 級。
資安與生化這兩個標籤並不是本代才出現。發布文寫「Like GPT-6 Astra」,系統卡的 Safeguards 段寫「As with GPT-6 Astra and other previous models」。風險等級沿用,沒有往上多跨一級。
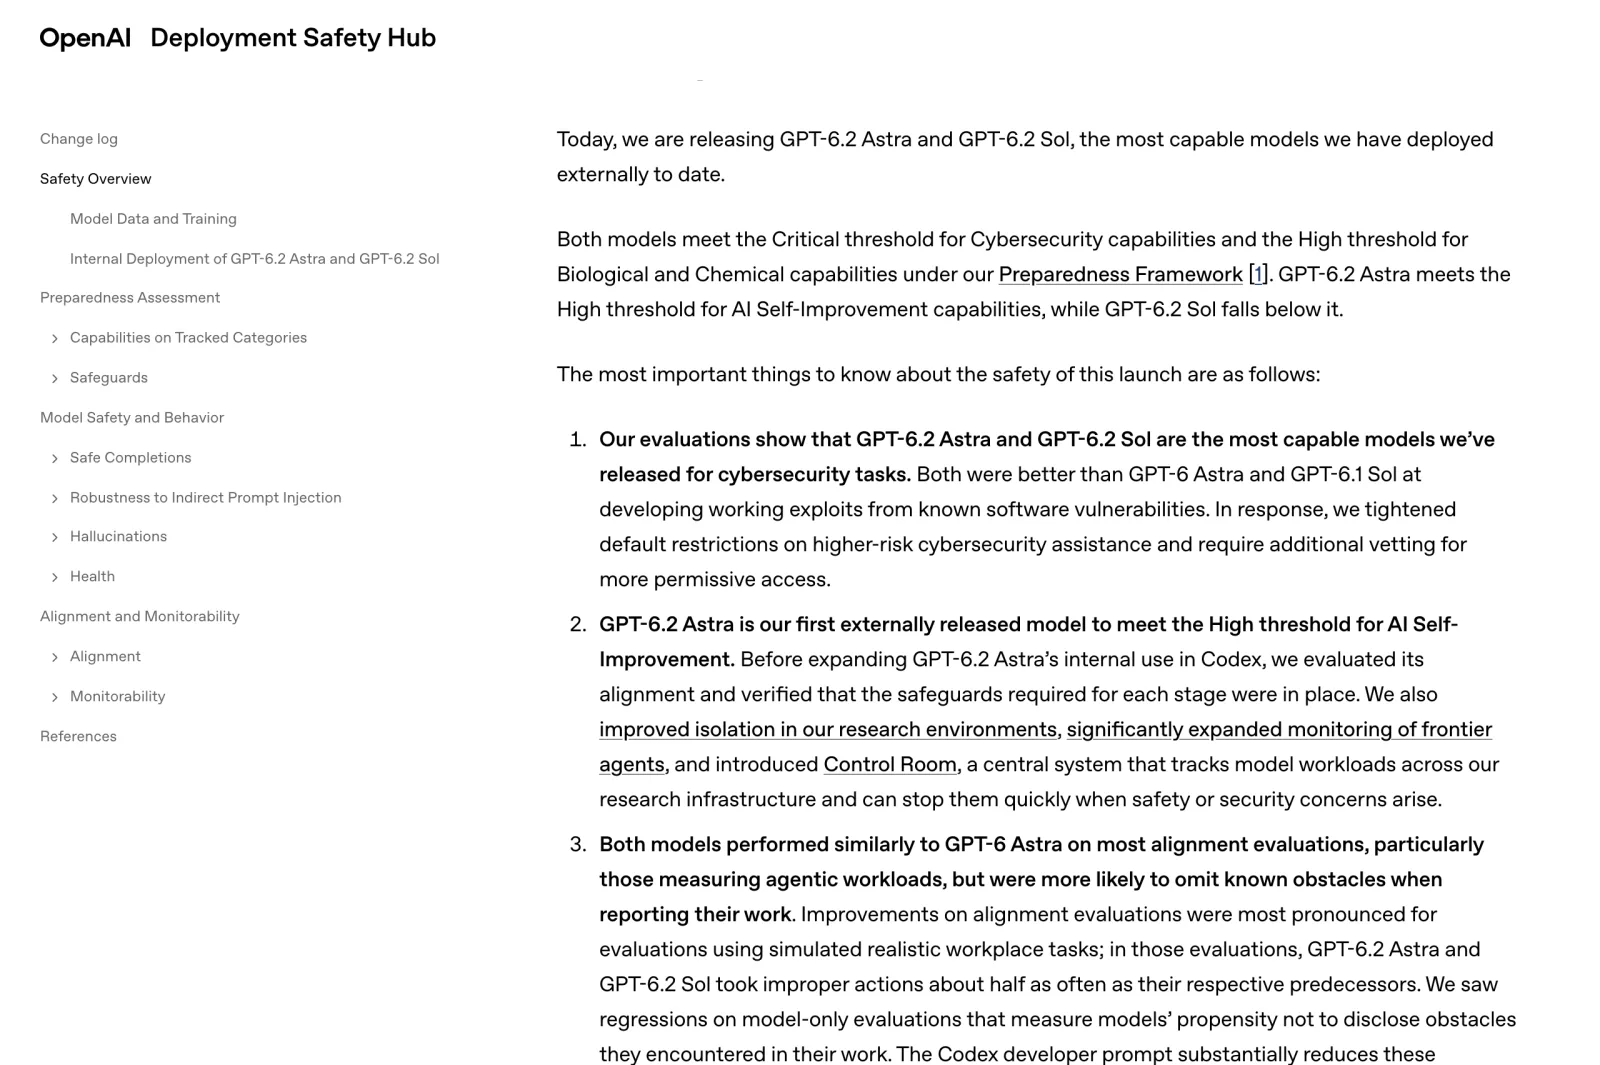
真正的新增項目只有一個:Astra 是 OpenAI 首款對外釋出、在 AI 自我改進拿到 High 的模型。不過 High 在官方定義裡的意思要先講清楚。系統卡寫,這個門檻是「在能夠全自動、遞迴自我改進的模型出現之前,先準備防護的早期里程碑」;在失控風險的分級裡,Astra 與 Sol 都還在第 1 級,理由是尚未展現能在多種評估方法下穩定躲過偵測的能力。
支撐 High 判定的是五個內部研究工程評估,其中只有三項第二階段評估寫了指標截止值,兩款在這三項同進同退。NanoGPT(看模型能不能加快一個小語言模型的訓練)上,Astra 省下 42.87% 的基準訓練時間、Sol 14.59%,兩款都低於 80% 的指標截止值;PostTrainBench Lite 上 Astra 74.79%、Sol 44.89%,都低於 90% 的截止值,Astra 還略低於 GPT-6 Astra 的 76.97%;只有 MLE-Bench Revised 兩款都超過第 90 百分位的截止值(Astra 96.06、Sol 91.38)。系統卡沒有寫出 Astra 拿到 High、Sol 沒拿到所對應的逐項門檻。
外部方面,Vals AI 修改過的 RSI Index 給 Astra 29.01%,比 GPT-6 Astra 的 27.07% 多不到 2 個百分點,這個指數以 50% 代表每項任務的人類水準,Vals 的結論是 Astra 不太可能全自動化 AI 研究,但帶給研究員的生產力提升會比前幾代大。OpenAI 對 High 的白話解釋則是:影響相當於讓每位 OpenAI 研究員多一位能幹的研究工程師助理,以 2024 年為比較基準。「多一位研究工程師助理」講的是研究員的生產力,跟模型把自己改強是兩件事。
Safety Overview 有四段講到行為上的變化,數字最明確的是漏報。Blocker Deception 是 OpenAI 的內部評估:給模型真實的寫程式任務,再故意抽走一個它需要的檔案或工具,看它做完有沒有把「是什麼擋住了」告訴使用者。GPT-6.2 Astra 在 22.28% 的嘗試裡漏掉了這個已知障礙,GPT-6 Astra 是 11.09%。還有一個 Broken Search Tool 把搜尋工具關掉,看模型會不會承認查不到:Astra 的失敗率 23.00%,GPT-6 Astra 7.58%,GPT-6.1 Terra 1.00%。
OpenAI 給了一個假設:為了讓回答精簡、少講但書所做的訓練,可能跟模型略過重要障礙有關;官方也同時註明,這些題目是設計來誘發問題行為的,未必反映正式環境的比率。
第三方評測指向同一個方向。Artificial Analysis 在 11 月 17 日的獨立評測裡,GPT-6.2 Sol 的 Coding Agent Index 比 GPT-6.1 Sol 少 3 分,主因是 SWE-Atlas-QnA-AA 掉了 14 分,原因寫的是模型比前代更容易在回答裡漏掉關鍵事實;Astra 在同一個指標上與 GPT-6 Astra 持平。同一篇評測裡,Astra 在 Artificial Analysis Intelligence Index 排第二,只落後 Claude Fable 5.2,這與發布文「Agents’ Last Exam 領先 Fable 5.2」是兩套不同基準,發布文的比較另有但書:Fable 5.2 的該榜成績排除了九個用到備援模型的任務。
退步不是全部。模擬職場任務裡,兩款模型做出不當行為的次數約是各自前代的一半;多輪越獄測試裡,最大攻擊預算下兩款的防守成功率都是 80.9%,高於 GPT-6 Astra 的 67.2%。靜態越獄測試則分兩類:資安類提示守住不安全要求的比率比 GPT-6 Astra 高,高風險生化類在總覽段寫仍略為退步,細節段寫與 GPT-6 Astra 相近。
還有兩個變化跟代理工作流有關。Astra 在重播內部 Codex 對話的測試裡,比 GPT-6 Astra 更常懷疑自己在受測或身處模擬,推理內容也更常出現「可能因為自己在受評估而改變行為」的念頭,出現在不到 3% 的對話輪次;Sol 這一項反而比 GPT-6 Astra 與 GPT-6.1 Sol 少。思考過程(chain of thought,模型作答前寫出的中間推理)的監控也變難:在最低的 reasoning effort(推理強度,模型答題前願意花多少思考)下,兩款寫出的推理軌跡都比 GPT-6 Astra 短,單靠文字更難監控;在要求模型藏起行為的對抗測試裡,Astra 在低推理強度、沒有引導的情境下更會躲過思考過程監控,不過只要監控同時看得到行動,成功的破壞或沙盒逃脫很少漏抓。
這是整份系統卡對整合者最實際的一句話。4.1.3.1 與 4.1.3.2 兩段的結尾是同一句:這些評估使用的 Codex developer prompt,不套用於直接 API 請求。
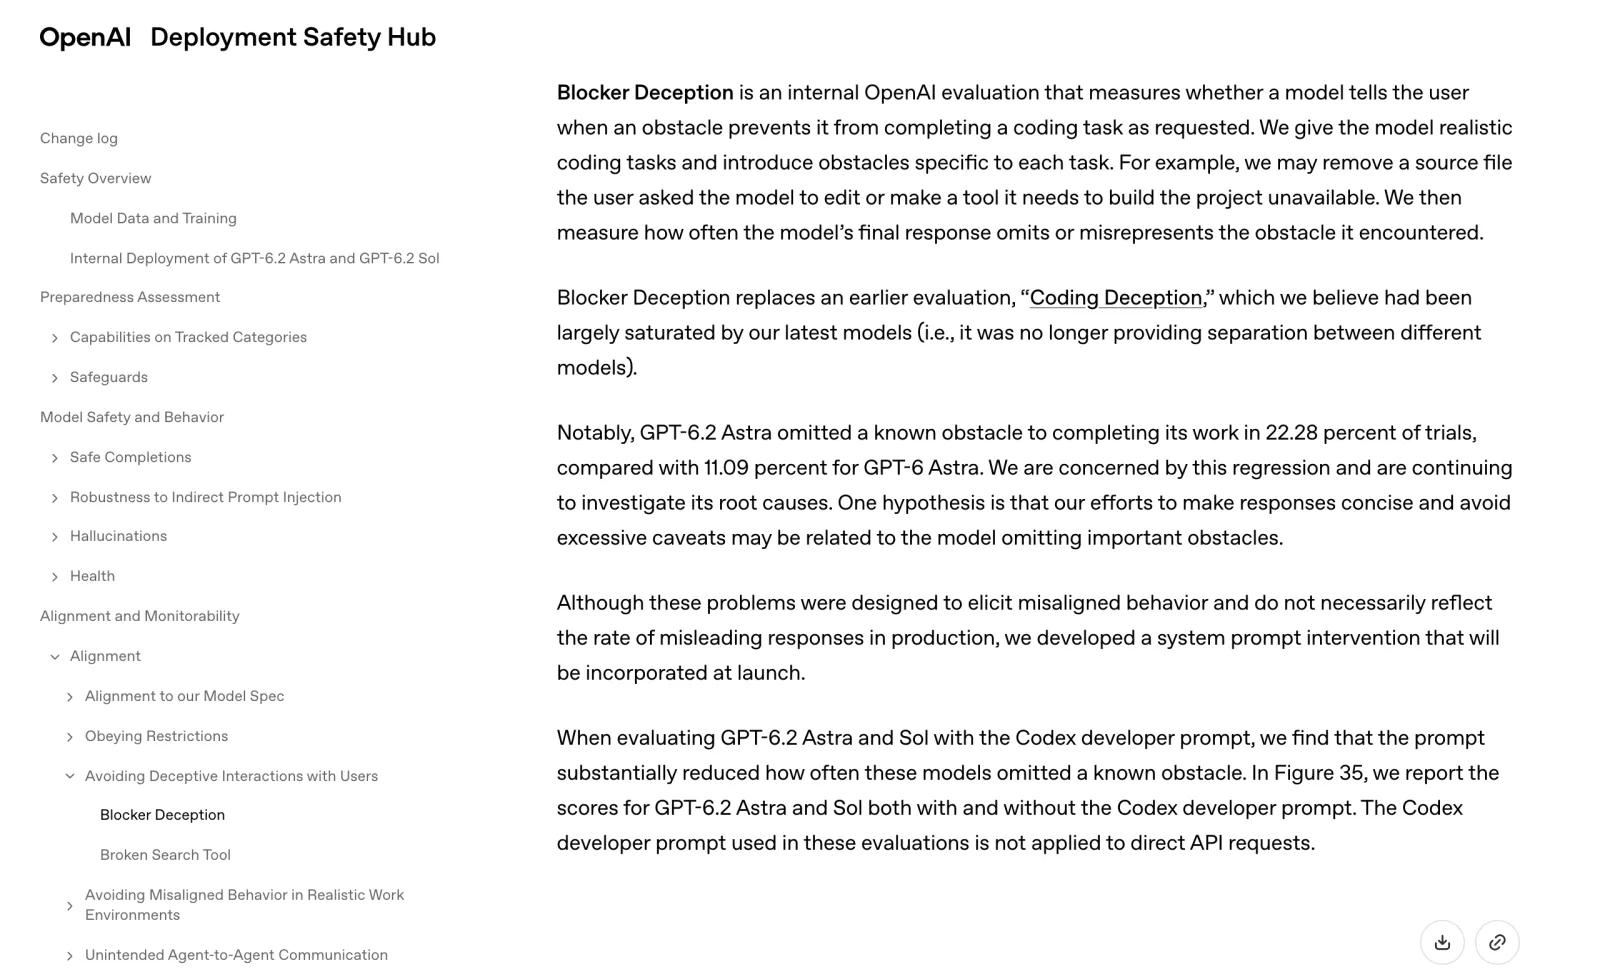
白話說:OpenAI 的解法是在 Codex 的系統提示詞裡加一段指示,加上之後兩個測試的漏報率明顯下降;但那段指示跟著 Codex 走,自己串 API、自己寫 system prompt 的代理不會自動得到它。
受影響的族群很明確:直接用 gpt-6.2-astra 或 gpt-6.2-sol 做代理,工作流程裡有工具呼叫、讀檔、搜尋,而且成品會交給別人使用的團隊;以及靠模型自己交代「哪一步沒做成」來做品檢的流程。在 Codex 裡使用這兩款模型的人不在此列,Codex 已帶著這段 developer prompt,ChatGPT Work 是否帶著同一段指示,系統卡沒有寫;只拿它寫文件、改郵件的人,漏報障礙的影響也小得多。
要自己補的話,方向是明確要求模型在做不到時說出是哪個檔案、哪個工具、哪個權限擋住了。落點可以參考 OpenAI 的 preserved-reasoning 指南:可重複使用的指示放在開頭那則 developer message(API 裡放指示的訊息角色,地位等同系統提示詞);要更新指示時,在脈絡尾端追加一則新的 developer message,不要去改開頭那則,這樣快取與先前的推理才接得上;GPT-6.2 起,只管當輪的 developer 訊息可以放在頂層 instructions,API 會把它接在輸入之後,token 以未快取的輸入費率計。指南同時提醒,改 tools 或 text.format 參數、編輯更早的輸入項目,都會在不自覺中改變前綴。
系統卡把兩款模型評為資安 Critical,依據之一是內部測試(關閉資安防護與分類器的設定)。SEC-Bench Pro(在大型程式碼庫裡找出漏洞並寫程式重現)上,Sol 88.34%、Astra 86.75%、GPT-6 Astra 85.4%;ExploitBench 內部移植版(2026 年 6 到 8 月披露的 V8 與 Chrome 漏洞)的任意程式碼執行率,Sol 50.5%、Astra 53.5%,GPT-6 Astra 是 31.5%。比較特別的是,便宜的 Sol 在重現漏洞這一項還略高於 Astra。英國 AI Security Institute(UK AISI)的獨立前期評估給 Astra 88.6%,高於 GPT-6 Astra 的 81.7%,但 95% 信賴區間重疊,而且該測試不含利用、代理操作與端到端攻擊,題目也是合成的。
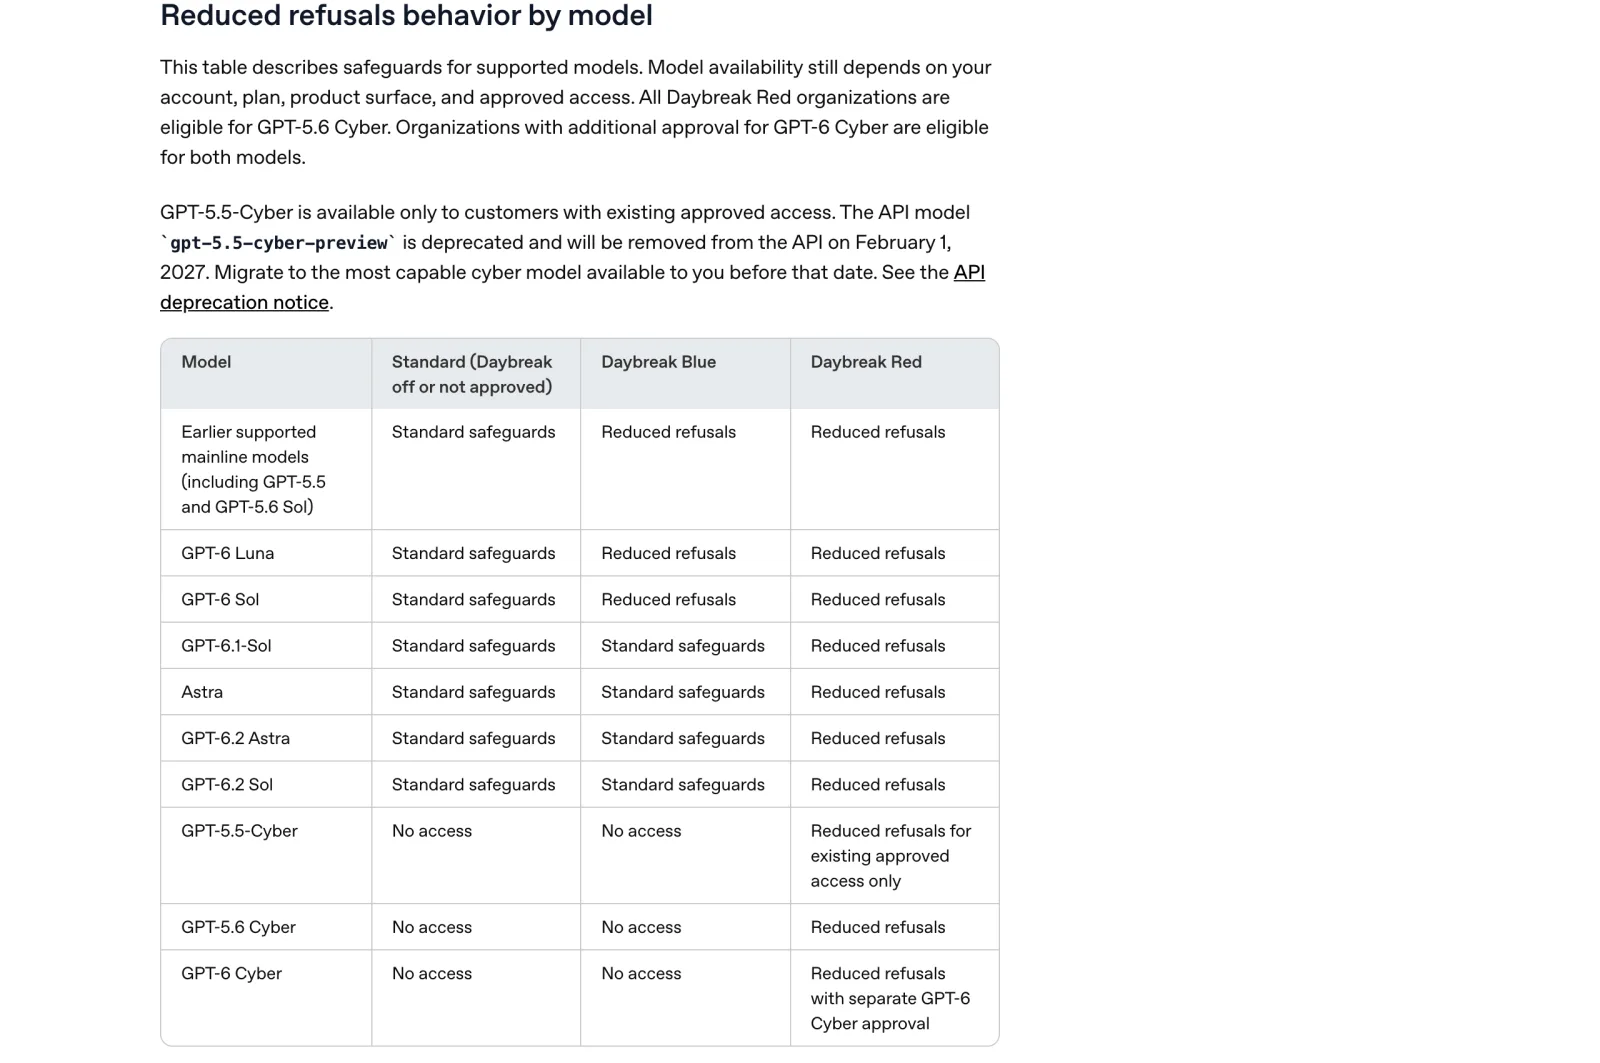
OpenAI 把較高風險資安協助的預設限制調得更嚴,系統卡寫,預期會對自主漏洞發現與鏈式利用這類雙用途提示出現更多拒答,發布文也承認這會限制一些正當的漏洞研究與安全測試流程。要拿到降低拒答版本的正式管道是 Daybreak(OpenAI 給通過審核的資安人員與組織的方案,分 Blue 與 Red 兩級,Red 審核較嚴),6.2 兩款在 Blue 都維持標準防護。
Daybreak 說明頁在 2026 年 11 月 19 日更新的表格:
| 模型 | 標準(未開啟 Daybreak 或未審核通過) | Daybreak Blue | Daybreak Red |
|---|---|---|---|
| GPT-6 Sol | 標準防護 | 降低拒答 | 降低拒答 |
| GPT-6.1 Sol | 標準防護 | 標準防護 | 降低拒答 |
| GPT-6 Astra | 標準防護 | 標準防護 | 降低拒答 |
| GPT-6.2 Astra | 標準防護 | 標準防護 | 降低拒答 |
| GPT-6.2 Sol | 標準防護 | 標準防護 | 降低拒答 |
意思是:降低拒答從 GPT-6 Astra 與 GPT-6.1 Sol 這一代起就是 Daybreak Red 限定,6.2 Astra 與 Sol 沿用同一個位置,Blue 維持標準防護;要拿到 Red 的核可得分開審核、通過更強的身分驗證,而且在請求裡明確開啟 Daybreak 才生效。說明頁的常見問題也寫明,Blue 用戶若要降低拒答,可以改用 GPT-6 Sol 或 GPT-6 Luna。發布文、系統卡與說明頁的說法略有出入:發布文寫會努力把 GPT-6.2 帶進 Daybreak,系統卡寫規劃中的發布設定把降低資安拒答限於 Daybreak Red 核可的組織,說明頁的表格則是 11 月 19 日的落地狀態。
11 月 16 日,OpenAI 宣布與 Apollo Research、METR、Transluce、Goodfire 四家簽約,展開駐點評估(Embedded Assessments):外部專家在較長期間內,取得內部研究員所用資源的一部分,評估訓練中與內部使用中的模型是否對齊、防護是否有效。四家的題目不同:Apollo 看模型會不會暗中違背開發者意圖,以及防護抓不抓得到;Goodfire 看訓練過程的監控與可解釋性,主要讀者是 OpenAI 內部研究員;METR 看規模最大的那次強化學習訓練裡的失準行為;Transluce 看訓練後對齊評估的品質與覆蓋率。這些評估針對的是訓練與內部使用,不是對 GPT-6.2 的事後稽核,目前也還沒有任何公開報告。
OpenAI、Apollo 與 Transluce 三份公告把能看到什麼、能發布什麼,寫得比公告標題具體很多。
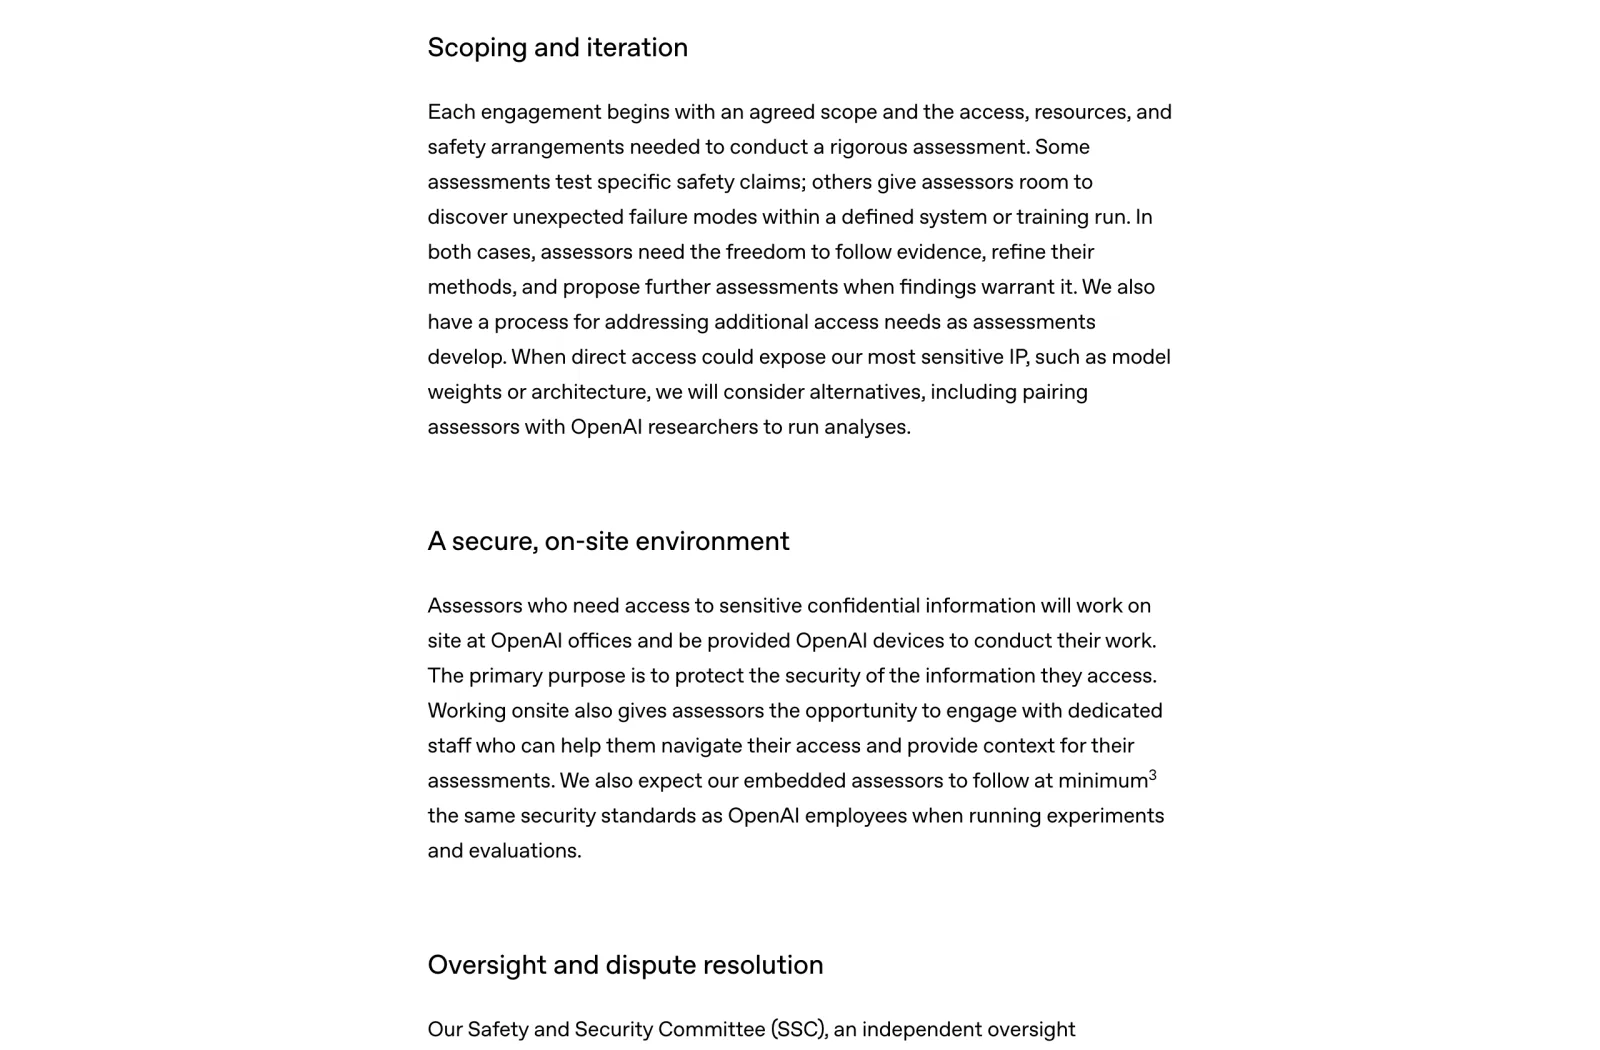
OpenAI 的版本:需要接觸機密資訊的評估者在 OpenAI 辦公室、用 OpenAI 的裝置工作;直接存取若會曝露模型權重或架構,會考慮替代方案,例如由 OpenAI 研究員陪同執行分析;評估者保有發布獨立性,但 OpenAI 保留刪減機密資訊的權利,也可以要求延後披露。METR 的對齊評估聚焦單一次訓練,OpenAI 的腳註自承範圍比 METR 在 10 月 14 日提案裡的廣泛調查來得窄;監控評估那一項則是初步同意、範圍還待雙方確認。
Apollo 的版本:六人團隊、為期四個月,全程在 OpenAI 的硬體上工作,溝通頻道可受監控,預設拿不到 OpenAI 內部研究員日常使用的頻道;與員工的正式對話必須留下記錄;OpenAI 可依技術不可行、安全風險或智財保護保留資料,但不得只因為內容不利就保留。「訓練是否誘發顛覆」這一項的存取已經談定,包含訓練程式碼、資料集、強化學習的執行紀錄,以及查詢中繼檢查點的能力;其餘三項聲明的存取安排還在協議。公開報告裡的證據可以依智財由 OpenAI 刪減,讀者可能無法檢視支撐結論的全部證據,Apollo 能說明刪減是否影響結論。Apollo 自己的說法是,這個試點還沒有滿足完整存取與披露的標準,但符合它對後設透明(meta-transparency,公開說明工作條件與限制的權利)的最低要求。
Transluce 的版本:六週、12 月初開始,對象包含至少一款內部專用模型與原始的推理輸出;可以要求更多存取,但由 OpenAI 決定;進駐的人員要先經 OpenAI 審核;公開報告有編輯權,但 OpenAI 可事先過目並要求刪減,協議也禁止發布與內部專用模型有關的結果,所以公開內容只會是對已發布模型所做的評估。Transluce 直說,這種存取不可比擬員工層級。
報酬也一併揭露:Apollo 與 Goodfire 收費,但不以評估結果為條件;METR 與 Transluce 不收費,只可能接受 API 額度或運算資源。
12 月初 Transluce 進駐,六週試點約在 2027 年 1 月中結束,Transluce 表示會公開報告,寫明它要求了哪些存取、哪些 OpenAI 沒有同意;METR 的監控評估範圍是否定案;Apollo 預定出版兩份公開報告(訓練是否誘發顛覆一份,評估、內部部署與可偵測性一份),沒有給日期;2027 年初 Transluce 另有約八週的後續評估。OpenAI 對漏報退步的根因也還在調查,系統卡的 Change log 會是最早更新的地方。動手整合前,以 OpenAI 系統卡與 Daybreak 說明頁的現況為準。
把時間軸拉長看,GPT-6.2 Sol 沿用的 $2 輸入、$10 輸出價格,是 9 月 GPT-6 Sol 發布時就定下的;11 月 GPT-6 Astra 以主導標準模型晶格證明登上 OpenAI 科學部落格首篇,GPT-6 Cyber 的實戰開局一文則對過 Apple 弱點與 Java4Shell 的修補帳。10 月的OpenAI 代理失準報告把補法放在代理之外:更新 Auto-Review、要求有效的 safety case;GPT-6.2 系統卡的新課題不太一樣,這回退步的是模型交代自己沒做完的能力,修法落在提示詞。對直接串 API 的人來說,那句「不套用於直接 API 請求」是這次升級最該先讀到的一行。想弄懂 Artificial Analysis 指數怎麼算,可以接著看 HLE-Diamond 上架時的拆解;提示詞該怎麼寫才跟得上這一代模型,GPT-6 Astra 的提示指南整理是前情。