TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

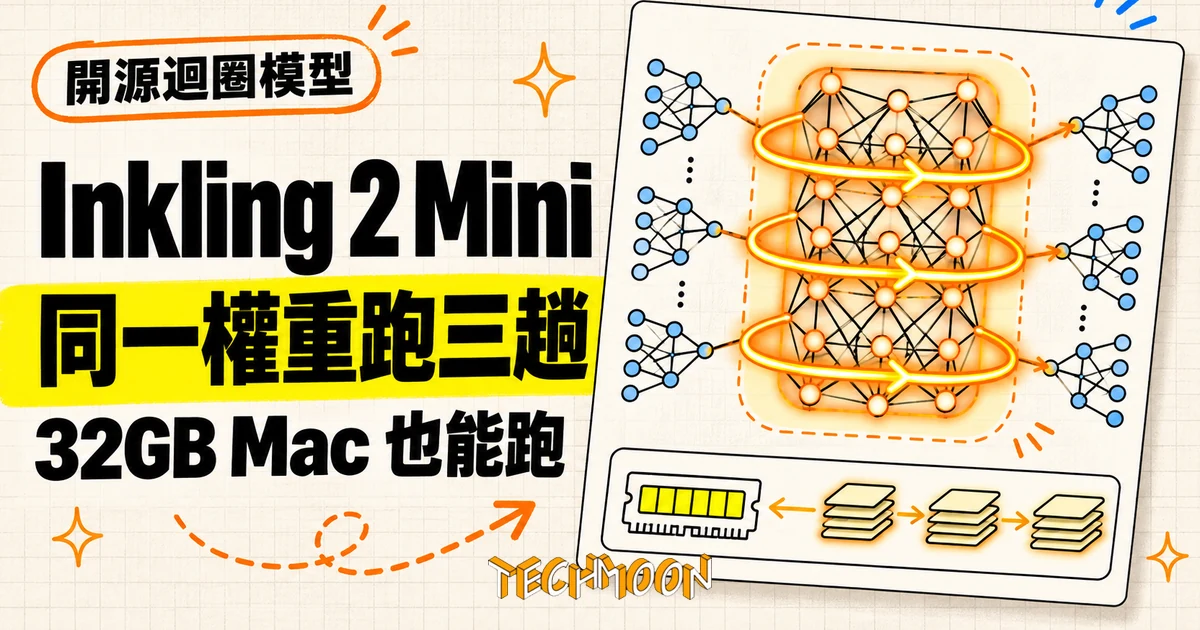
Thinking Machines 2026-11-20 開源 Inkling 2 Mini:26.4B 總參數的多模態 MoE,中段 12 層每個 token 跑三趟,用迴圈把每 token 有效算力推到 5.4B;Hugging Face 實檔 18.78 GiB,32GB 以上 Mac 經 Ollama 官方支援,vLLM 首日支援尚未進 stable 版。
用 AI 摘要這篇文章:
Thinking Machines 在 2026 年 11 月 20 日開源了 Inkling 2 Mini:26.4B 總參數的多模態 MoE 模型,Apache-2.0 授權,權重放在 Hugging Face 上直接下載。它真正特別的地方在架構:中段 12 層每處理一個 token 就跑三趟,權重共享、重複使用,官方稱之為迴圈模型(looped transformer)。這個設計讓一份 24 層的檔案做出 48 層的推論深度,也讓幾個帳本上的數字跟著翻倍:每個 token 的有效啟動參數是 5.4B(規格表標 3.4B)、KV 快取有 48 份。想把它跑起來的人,現在還要多記一件事:vLLM 的 stable 版 0.34.0 尚未收錄它,第一天要靠專用容器映像或 nightly 版。
官方文件裡能核對的數字攤開來看:迴圈到底換到什麼、速度與記憶體的取捨長什麼樣、三條部署路徑各需要什麼,以及官方自己在 model card 裡先承認的限制。
一般 transformer 每生成一個字,就從第一層走到最後一層一次。Inkling 2 Mini 的 24 層切成三段:前奏(第 0 到 5 層)與尾聲(第 18 到 23 層)各跑一次,夾在中間的迴圈核心(第 6 到 17 層)跑三次。權重只有一份,三趟用的是同一組參數,所以模型儲存 24 層,每個 token 實際拜訪 48 個層。這是 vLLM 官方部落格與模型設定檔都寫明的結構,不是宣傳話術。
三趟之間怎麼傳遞資訊?第二、第三趟不是把上一趟的輸出直接餵進來,而是每個子層的輸入(注意力的查詢、鍵、值投影與 MLP 輸入,共四種)各自讀取一份「訊息」,由上一趟的輸出經過學習過的閘控合併進來,閘控在訓練初期會擋掉整份訊息,讓迴圈從接近一般模型的行為出發再慢慢打開。12 層乘上 4 種輸入,後面兩趟每個 token 各讀 48 份訊息。每一趟還各自保有一份記憶:每個核心層的 KV 快取(把算過的注意力中間結果暫存起來,之後的 token 不用重算)與短序列狀態快取都是每趟一份。於是這個 24 層的模型有 48 份 KV 快取、48 份狀態快取,多出來的 24 份全部來自迴圈的第二、第三趟。
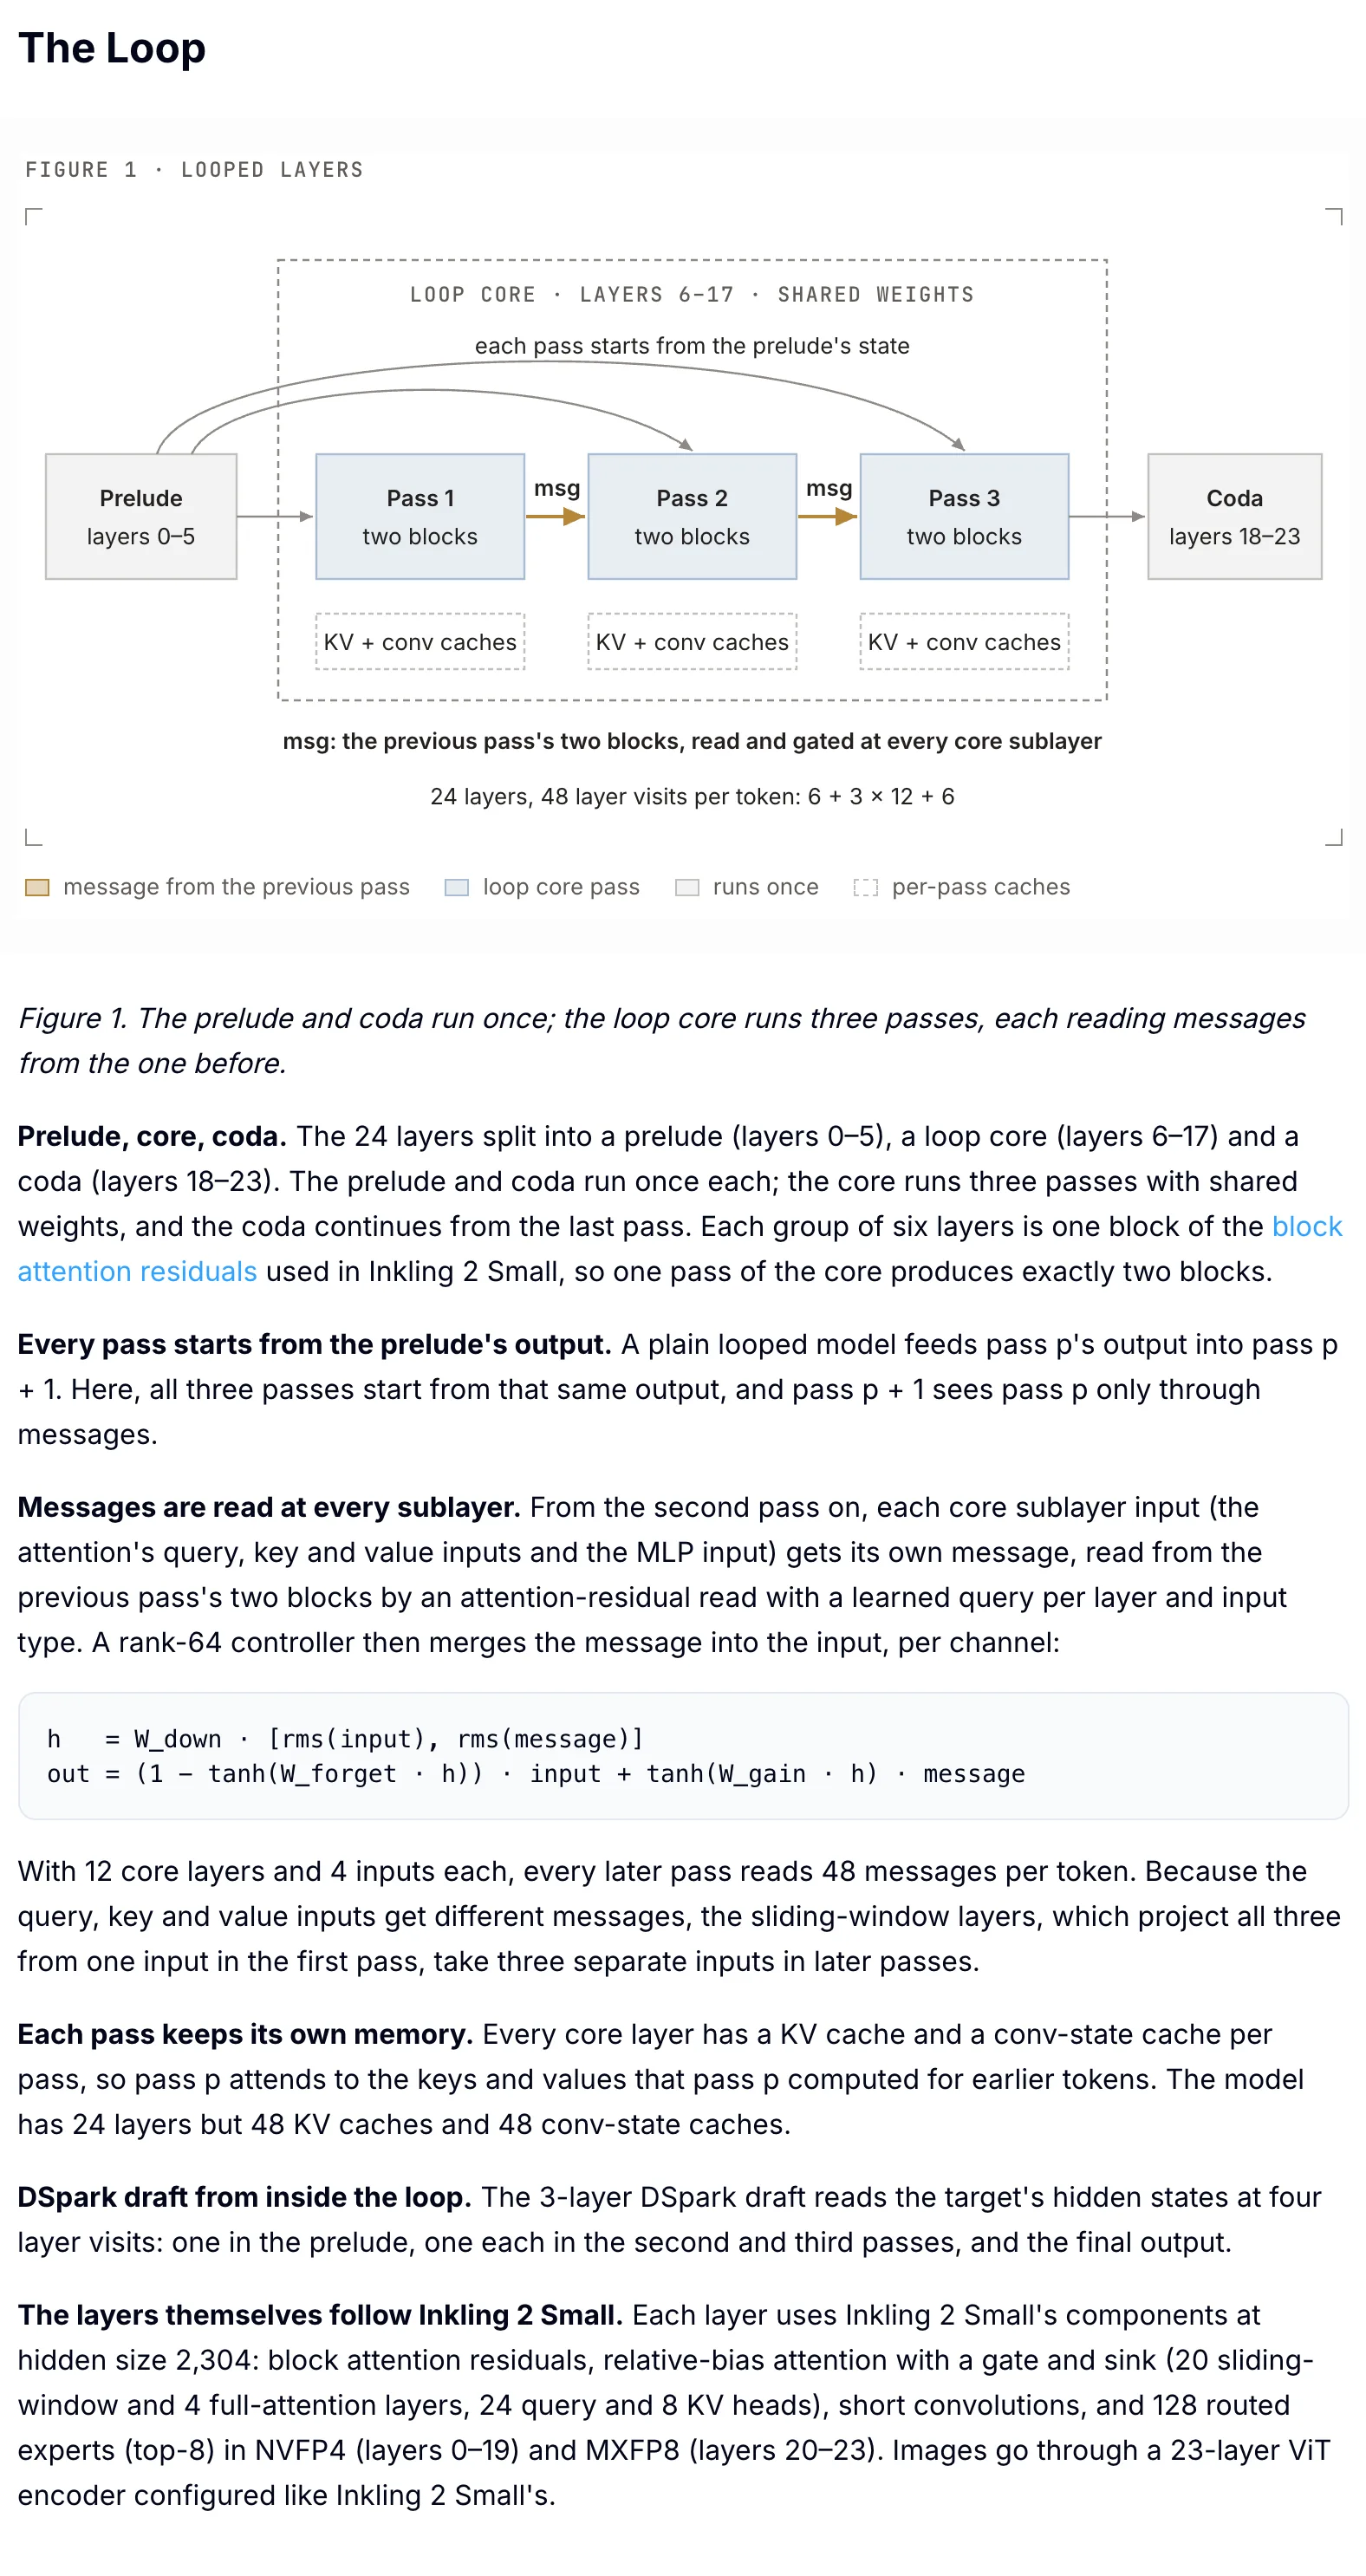
對照模型設定檔可以再核對幾個結構數字:隱藏維度 2,304,24 個查詢頭、8 個 KV 頭、每頭 128 維,其中 20 層是滑動視窗注意力(視窗 1,024 tokens)、4 層是全注意力。滑動視窗層的快取本來就有長度上限,全注意力層的快取才會隨上下文線性成長;4 個全注意力層裡有 2 個落在迴圈核心,所以全注意力快取同樣被迴圈放大。
模型卡上的參數標示是 26.4B 總參數、3.4B 啟動參數,但底下跟著一行容易被略過的註記:每多跑一趟迴圈,大約多出 1.0B 的有效啟動參數;跑三趟就是每 token 5.4B。同場發布的研究版 TML-d24-varloop-research 把階梯寫得更完整:1 趟 3.4B、3 趟 5.4B、5 趟 7.4B。Ollama 的模型頁在描述欄直接寫 5.4B active,等於把有效口徑當成主要標示。
這個帳本為什麼重要?因為啟動參數是人們抓推論速度的第一直覺。拿 3.4B 去估延遲,會系統性低估每個 token 的計算量。官方在公告裡給過一組對照數字:訓練時,不迴圈的版本只省 7.5% 算力,但推論時要多花 140% 的算力才能追平迴圈版的損失。換句話說,迴圈把訓練投資換成了推論時的重複使用,代價是每個 token 都付三次中段計算。
26.4B 這個檔案體積也有來歷。模型訓練初期是 8 選 384 專家的稀疏結構,訓練中期剪掉三分之二專家留下 128 個,再用 1T tokens 從較大的內部模型蒸餾回復效能,之後 SFT 加上總量 2.2T tokens、2,000 步的 RL。權重以 NVFP4(前 20 層)與 MXFP8(後 4 層)訓練並直接部署,官方強調部署精度與訓練精度相同,沒有訓練後再量化的轉換損失;這是官方說法,獨立複核還沒出現。
為什麼迴圈放在中段?官方做過對照實驗:同樣三趟,跑中段 12 層在 28 項評測裡有 27 項優於跑最後 12 層,訓練 2,000 步時的等效算力增益是 1.51 到 1.91 倍,跑最後 12 層只有 1.24 到 1.36 倍。背後的假設是中段層承擔抽象推理、首尾層負責在嵌入與內部表徵之間做轉換,把重複計算花在推理密集的段落才划算。這組數字同樣出自官方,但實驗設計與量測口徑都寫得完整,是判斷「迴圈值不值」少見的第一手材料。
迴圈的核心承諾是「同一份權重,多想幾遍再回答」。vLLM 部落格給出一份很難得的取捨表:在一片 GB200 上(TP1、4K 上下文、只量前向),varloop 研究版 1 趟的解碼單步是 1.51 毫秒(批次 1)與 3.81 毫秒(批次 32),KV 快取容量可容 35.2 萬 tokens;3 趟分別是 3.85 與 8.11 毫秒,容量降到 17.5 萬。速度慢了 2.5 倍、快取容量砍半,這就是「多想幾遍」的單價。要提醒的是,這些是官方自行量測的數字,而且 Inkling 2 Mini 本體固定三趟不能調,可調的只有研究版。
表格裡還有一個反直覺的細節:把三趟的 KV 快取合併成共享一份,解碼速度幾乎不變(3.86 毫秒),快取容量卻只回升到 19.4 萬 tokens,比直接少跑一趟的 23.3 萬還少。原因寫在後面:狀態快取仍然是每趟一份,共享 KV 省下的比想像少。這也是帳本視角的價值,直覺在這種混合結構上經常失準。
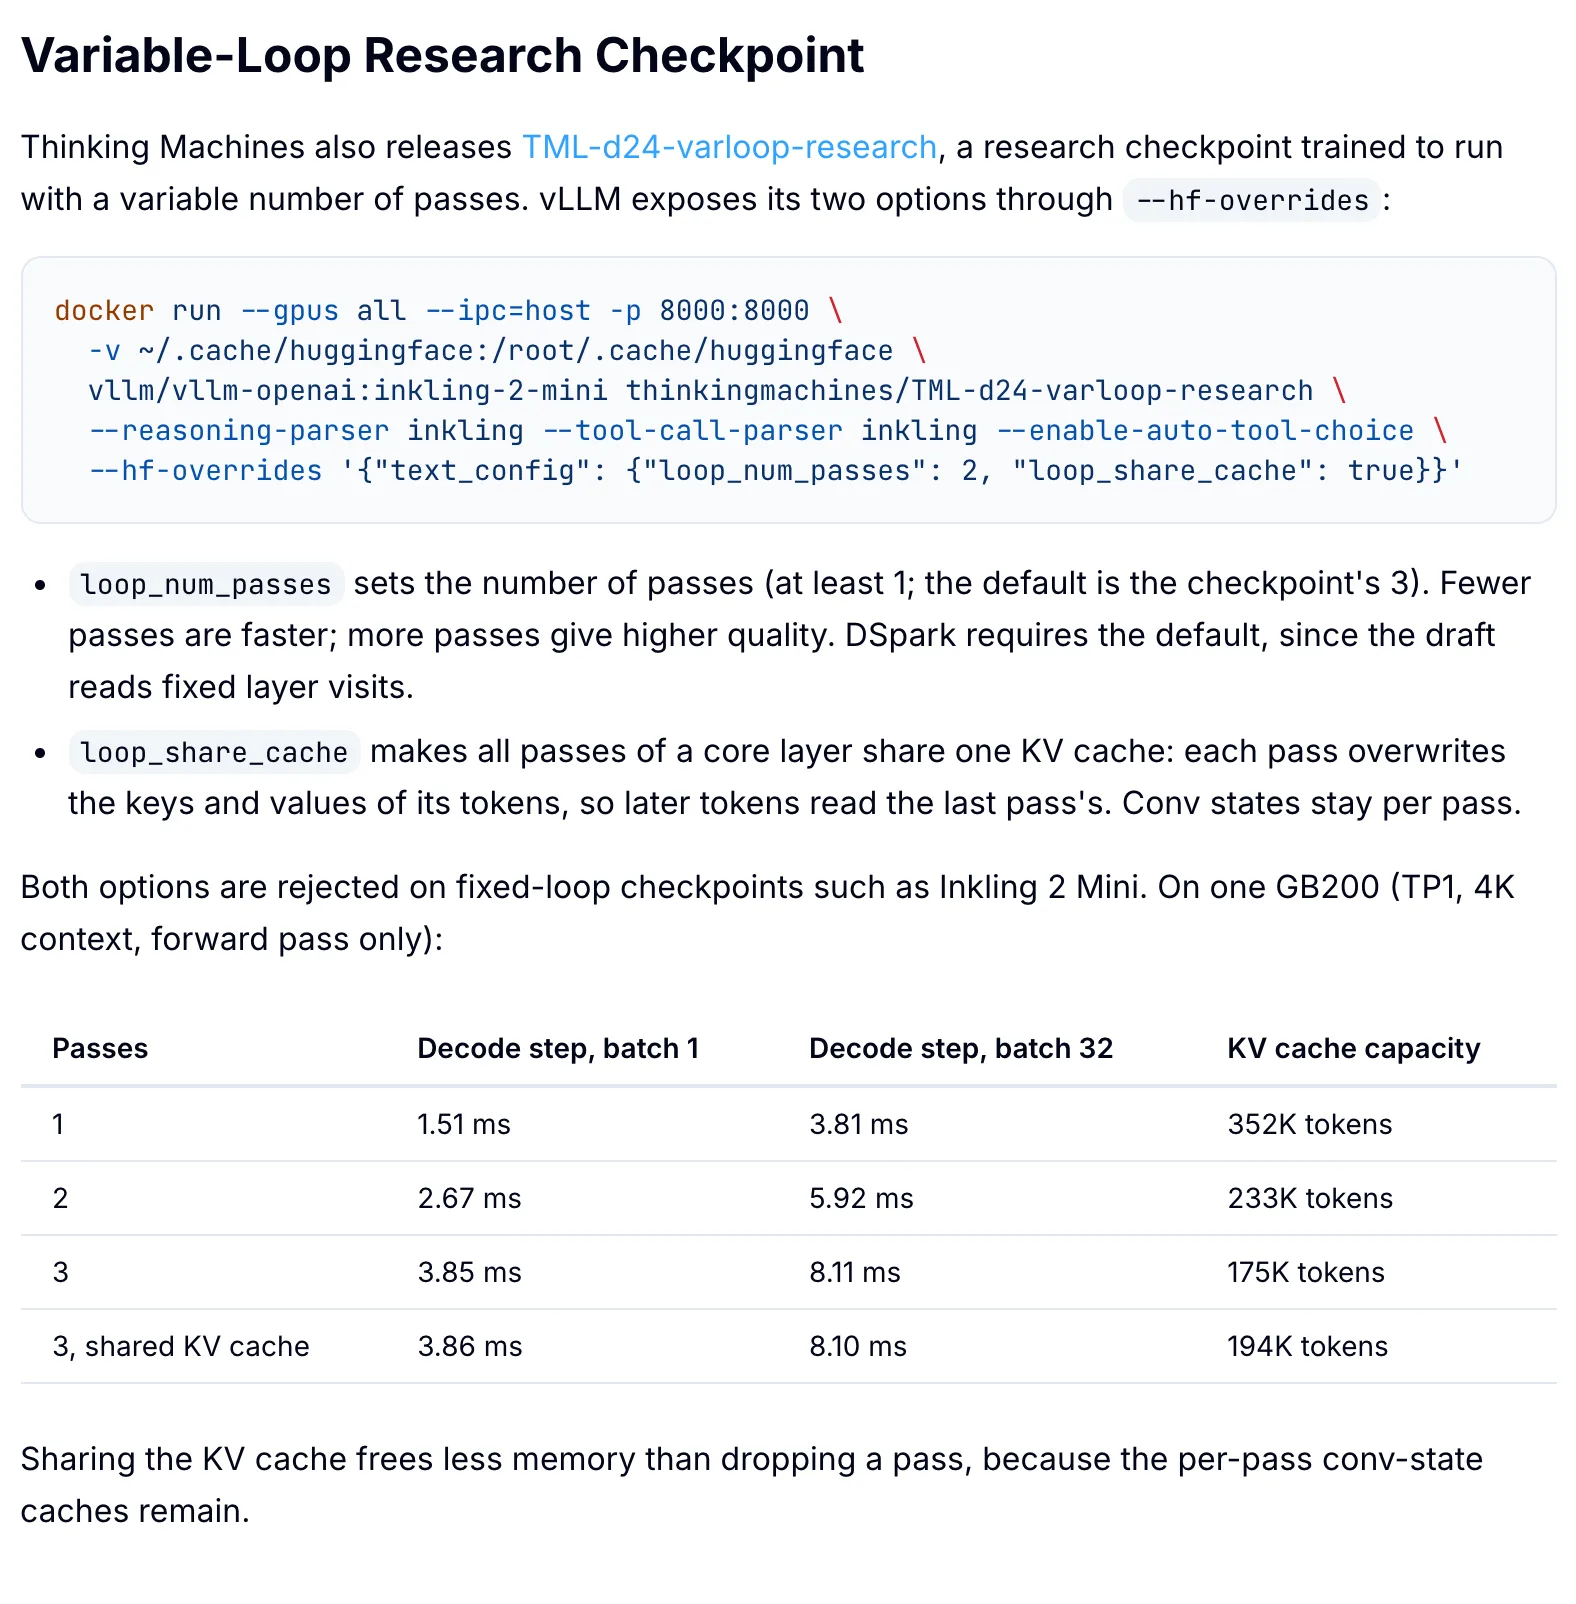
把快取份數與容量對起來看,數字是自洽的:1 趟時模型有 24 份 KV 快取,容量 35.2 萬 tokens;3 趟時 48 份,容量 17.5 萬,快取份數翻倍、容量幾乎正好減半。再往結構裡看一層,48 份快取並不相同:滑動視窗層(20 層,視窗 1,024 tokens)的快取有長度上限,真正隨上下文線性成長的只有全注意力層的快取,而 4 個全注意力層有 2 個在迴圈核心裡、各被展開成三份,所以長上下文的記憶體壓力同樣被迴圈放大。
品質端,官方的研究數字(一樣是自報)指向:迴圈加深對序列推理與長上下文檢索最有感,no-CoT 的時間視界從 1 趟的 16 秒升到 3 趟的 37 秒;對封閉書本的知識型問題幾乎無感,知識量主要還是總參數的函數。官方也明講,知識密集評測不會因為多跑幾趟而進步,模型是靠搜尋與工具使用補這個缺口。
第一條路是 vLLM。這裡有個第一天的陷阱:拿 pip install vllm 裝到的 stable 0.34.0,模型註冊表裡只有舊的 TML Inkling 架構,沒有 Inkling 2 Mini 用的 Inkling2Loop。對照 vLLM 主線的註冊表,Inkling2Loop 已進 main,官方 recipe 頁也明寫需要 0.35.0+ nightly;在 0.35 進 stable 之前,正式路徑是專用映像 vllm/vllm-openai:inkling-2-mini(11 月 20 日 21:36 UTC 推上 Docker Hub)。官方給的啟動指令:
docker run --gpus all --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:inkling-2-mini thinkingmachines/Inkling-2-Mini \
  --reasoning-parser inkling --tool-call-parser inkling --enable-auto-tool-choice \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"probabilistic"}'
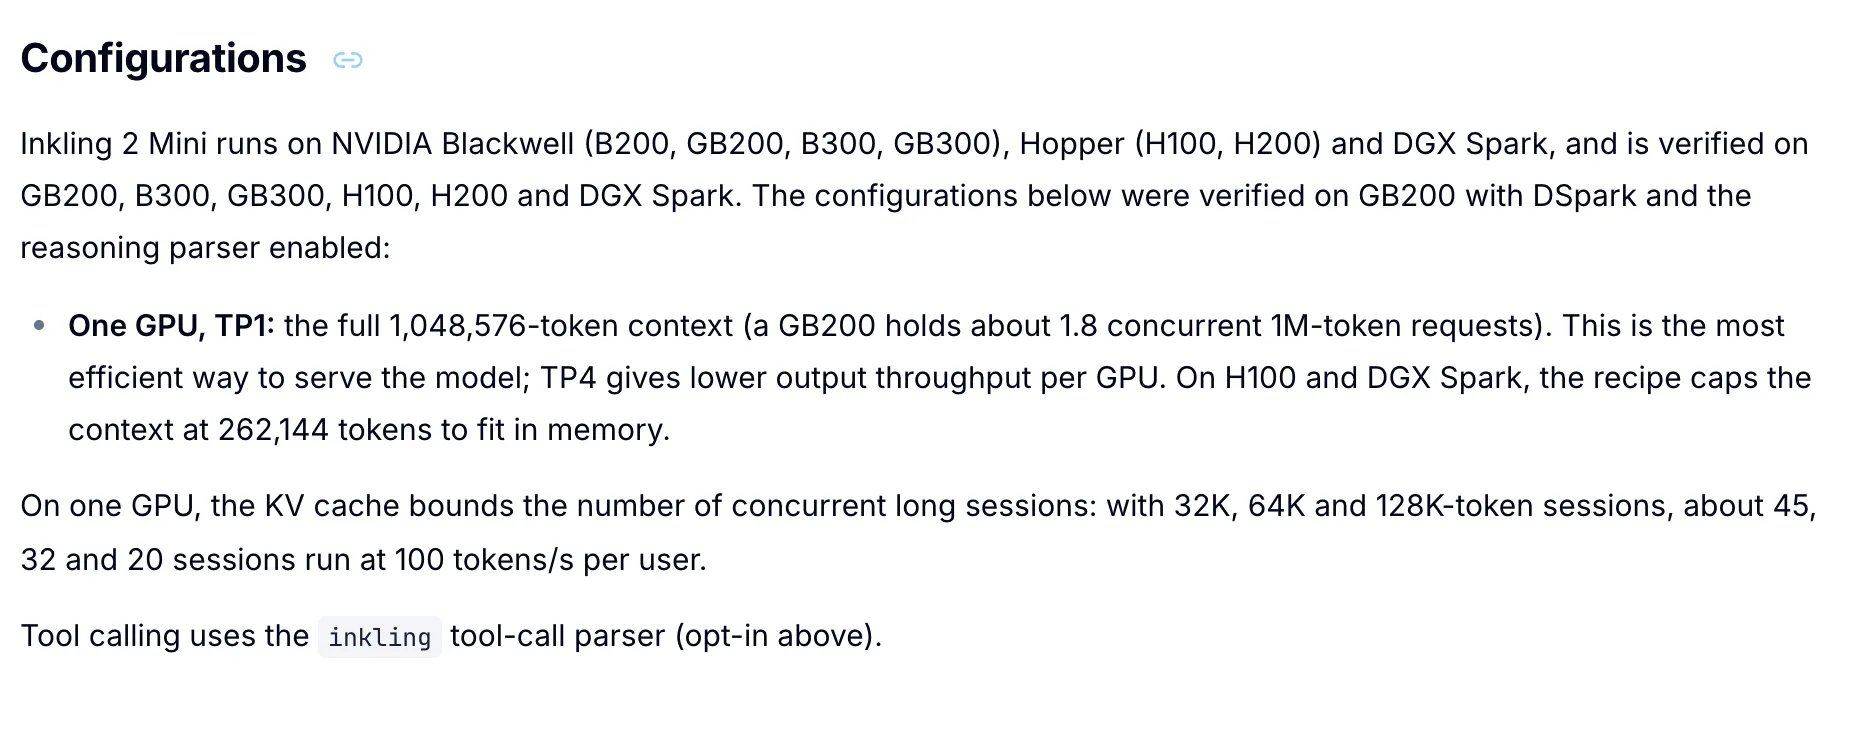
指令裡兩個 inkling 剖析器分別處理推理文字與工具呼叫,最後一段是隨檔案附送的 DSpark 推測解碼:3 層草稿模型在生成過程中讀主模型四個層拜訪位置的隱藏狀態,每步先猜 7 個 tokens 再交給主模型驗證,猜中就省下逐字生成的時間。兩個使用細節值得記下:草稿模型讀的是固定層位置,所以只在預設三趟下有效,varloop 研究版改趟數時要整組關掉;recipe 也提醒驗收率與提示內容高度相關,拿隨機文字做基準幾乎全部猜不中,量測請用真實語料。硬體支援落在 NVIDIA Blackwell、Hopper 與 DGX Spark;recipe 在 H100 與 DGX Spark 上把上下文上限設為 262,144 tokens 以塞進記憶體。官方自報的量是:單片 GB200、TP1,32K 上下文的代理工作階段約 4,400 output tokens/s(每人 100 tokens/s),同時約 45 個 32K 工作階段,64K 與 128K 分別約 32 與 20 個。關於 vLLM 這個引擎本身的記憶體配置邏輯,可以搭配前一版 0.34.0 的拆解(/vllm-pagedattention-fp8-24gb/);API 端點與 OpenAI 規格相容,既有 client 只改 base_url 就能接。
第二條路是 Mac。公告寫明 launch 時支援 32GB 以上記憶體的 Mac(MacBook、Mac mini)走 Ollama,一條 ollama run inkling-2-mini 就能開始。下載量看得到需求:到 11 月 22 日已累積 2.8 萬次下載。想自己挑量化等級的人可以走 llama.cpp 的 GGUF,Unsloth 已上全套檔案,實際體積如下:
| 檔案 | 體積 | 32GB Mac 的位置 |
|---|---|---|
| UD-Q4_K_M 主模型 | 15.47 GiB | 裝得下,留得出快取空間 |
| UD-IQ4_XS 主模型 | 14.65 GiB | 同上,再省一點 |
| UD-Q8_K_XL 主模型 | 21.30 GiB | 權重就吃掉大半,很勉強 |
| 視覺投影檔(mmproj) | 0.60 GiB | 用圖像輸入才需要 |
主模型之外記得加計投影檔與 KV 快取:UD-Q4_K_M 加投影是 16.07 GiB,32GB 統一記憶體的機器扣掉系統保留後還剩十多 GB 可用,空間是夠的,但 1M 上下文那種規格在單機 Mac 上就別想了。依設定檔粗算:全注意力快取每 token 約 32 KiB(8 份全注意力快取,每份 8 個 KV 頭乘 128 維、鍵值各一份),百萬 tokens 光這一項就要約 32 GiB,還沒算 40 份滑動視窗快取與模型本體。對照 Mac 跑本地大模型的記憶體帳(/mac-64gb-128gb-unified-memory-llm/),32GB 正好是這個模型的官方門檻線;16GB 的機器不論顯卡或 Mac,想跑表格裡的 Q4 級品質都不用考慮(/rtx-16gb-local-llm-vram-math/)。
第三條路是 Hugging Face transformers 直接載入,或 SGLang、NVIDIA Dynamo 等其他執行環境;要做 RL 後訓練,官方列了 SkyRL。權重本體的實檔數字:主模型是單一個 18.19 GiB 分片,加上 0.59 GiB 的推測草稿權重,合計 18.78 GiB,與官方「約 20GB」的說法一致。
把三條路收斂成一句話:手上有 32GB 級 Mac、主要跑英文代理任務或想研究迴圈行為的人,現在就值得用 Ollama 裝來玩;生產環境要上 vLLM 的人,等 0.35 stable 收錄再動,這幾天先用專用映像驗證流程;中文輸出是主力用途的人,先等社群實測再決定,官方那句斷句與混用的自述不該忽略。
Model card 的限制段值得整段讀,因為廠商很少寫得這麼具體。對台灣讀者最直接的一條:官方自承在中文測試裡觀察到斷句生硬與語言混用,非英文輸出品質會下降。要做中文客服或中文寫作助手的人,這條就是降期待的訊號。其他自曝項目還包括:多輪對話與多約束指令不是強項,MultiChallenge 50.0% 與 ComplexConstraints 33.4% 都落後 Qwen3.8-27B(/qwen38-super-adapter-harness-merge/;這兩個數字也是官方自報的對照);代理任務的可靠性低於大模型,官方明講它可能未經確認就刪改檔案;推理努力調到最低也關不掉推理;除錯時可能陷入長循環,建議限制輸出長度與代理步數。
讀評測表時也要記得口徑。公告裡那一大張領先表,對照組是 Gemma 4 31B、Muse Glimmer、Qwen3.8-27B、Nemotron 3.5 Super VL,全部分數由 Thinking Machines 自行量測填入。DeepSWE v1.1 的 48.2% 很亮眼,但它是「官方自報、自選對照」的數字,排行榜性質的引用要等第三方複核。
迴圈模型引起的安全疑慮很具體:模型可以在不寫出推理文字的情況下做更多計算,監看思考鏈(chain of thought)的安全機制會不會因此失效?官方這次連研究資料一起公開。量測方向相當溫和:更多趟數讓思考鏈變短(5 趟平均 1,661 tokens,1 趟是 3,703),但句子長度與詞彙可讀性指標不變,減少的主要是猶豫與回頭修正的次數(「等等」「其實」這類猶豫詞的出現次數從平均 9.7 次降到 3.6 次);純序列推理的任務隨趟數一路進步到 10 趟,超過訓練時用過的 5 趟也不崩壞。代理環境的量測用的是 LinuxArena:在只能看到工具呼叫與輸出的監看條件下,改裝成有求必應版的 Inkling 2 Mini 隱匿成功率 3.9%,與迴圈趟數沒有上升趨勢;換更強的 Qwen3.8-27B 當監看器,幾乎全部攻擊都會被抓到。不過這些仍是發布方自己的初步研究,而且實驗裡的變數很多(監看器強度、攻擊政策、樣本數 184 組配對),他們也明講 varloop 研究版就是為了讓社群能自己驗證這件事,並與 NDIF、Goodfire 合作做可解釋性研究。對部署者來說,短期結論是:既有以思考鏈為基礎的審計流程不必推倒,但值得追蹤後續獨立研究。
三件事目前沒有定論。第一,vLLM 0.35 的 stable 版何時收錄 Inkling 2 Mini(依近期兩週一版的節奏,十二月初是觀察點),收錄前 pip 安裝的官方路徑不存在。第二,中文輸出的實際表現:官方給了一句自述,但台灣場景的實測回報與社群複核都還沒出現,Q4 量化版的中文表現又是另一個變數。第三,32GB Mac 走 Ollama 的實際速度與記憶體佔用,目前只有官方的支援聲明,沒有獨立量測。動手前以官方文件現況為準。