TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

NBER 工作論文掃過 22.6 萬名美國 STEM 博士畢業生的論文摘要,2026 年 29.4% 被商用偵測器 Pangram 標記含 AI 生成文字,全文口徑換算約 31%。用得最多的是非英語系國家出身與排名後段系所的學生;同屆比較下,論文含 AI 寫作者進學術界的比例少 7.4 個百分點,作者群明言這是相關而非因果。
用 AI 摘要這篇文章:
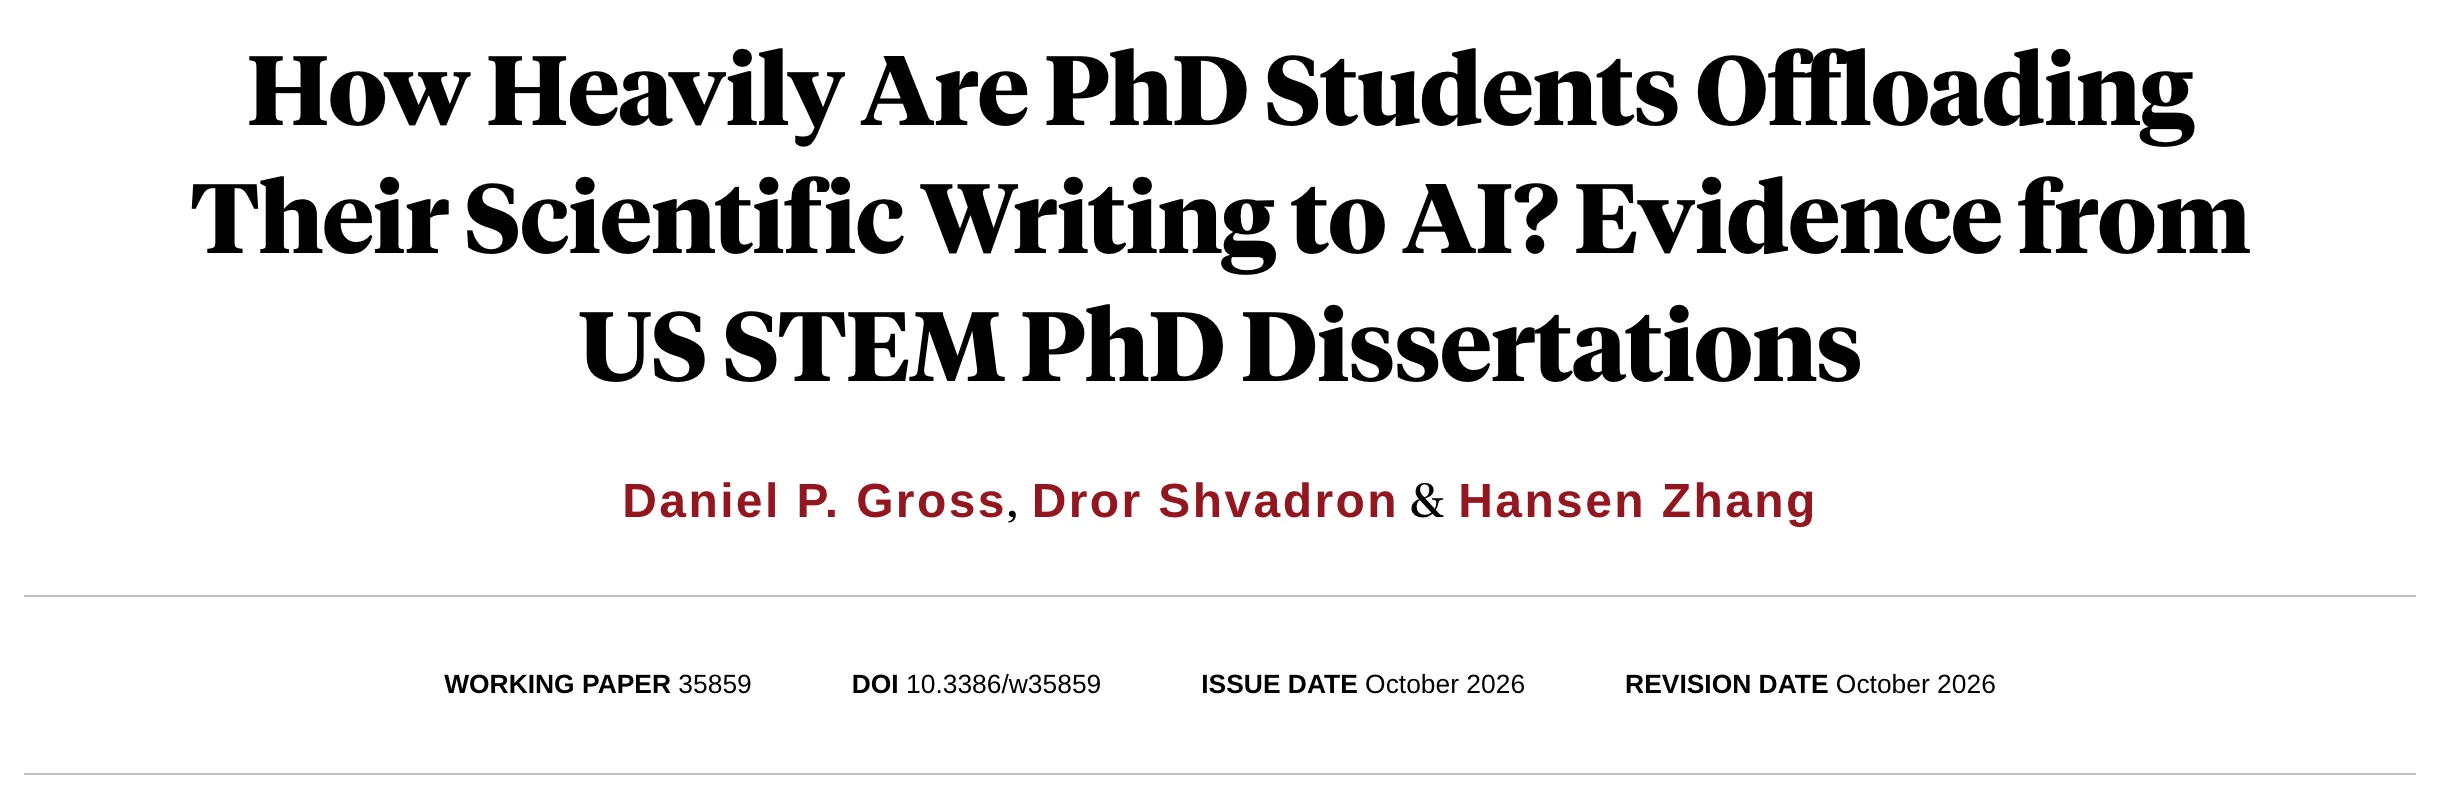
美國國家經濟研究局(NBER)10 月上旬公開工作論文 w35859,杜克大學 Fuqua 商學院的 Daniel P. Gross、Hansen Zhang 與多倫多大學 Rotman 管理學院的 Dror Shvadron,把 2019 年到 2026 年 5 月之間在美國取得 STEM 博士學位的 226,911 名畢業生幾乎全數納入樣本,用商用偵測服務 Pangram 逐一判定論文摘要是否含 AI 生成文字。2026 年畢業生的論文有 29.4% 摘要被標記,三年前這個比例是 1.7%。同一份研究再把畢業生接上 LinkedIn 職涯資料:控制學校、領域與畢業年之後互相比較,論文摘要含 AI 寫作的美國出身畢業生,進入學術界任職的比例少了 7.4 個百分點。
29% 這種數字在社群平台上很容易被讀成「三成博士找 AI 代寫論文」,這個讀法超出了證據範圍。它量到的是摘要被偵測器判定含 AI 生成文字,而摘要在研究設計裡本來就只捕捉論文的一部分;研究團隊還自己換算過,只看摘要會低估,改用全文口徑估計,2026 年約是 31%。這份研究真正有資訊量的地方在於兩個分布:誰在用,以及用的人畢業後去了哪。NBER 今年稍早才用同一套量化路數量過 AI App 供過於求的問題,這份論文則把尺度放進博士訓練本身。
作者群之所以挑「寫作」當測量點,論文裡有一段清楚的理由:研究寫作是把想法講到精確的階段,邏輯與方法的漏洞往往就是在寫的過程被發現和修掉;把研究整合、講出來的經驗,可能是學生成為更有效的批判評估者、加深理解自己工作的一條路。把這段力氣外包給 AI,短期的生產力換來的可能是長期訓練上的折損。這是研究設計背後的世界觀,也是後面所有數字爭議的源頭。
資料基礎是 ProQuest 的全球博碩士論文資料庫,再補上未收錄進資料庫的大學典藏系統。研究團隊將樣本與美國國家科學基金會每年對博士畢業生的普查(Survey of Earned Doctorates)交叉比對,生命科學、物理科學與數學領域的涵蓋率接近母體,工程領域約 85%。226,911 人之中約有 300 份論文缺摘要或無法評分,進到評分階段的是 226,591 篇摘要,偵測器指定為 Pangram 3.3.2 版,這項服務已陸續用在同類研究上。
偵測工具可不可信,是最先要回答的問題。團隊拿 ChatGPT 問世之前(2019 到 2022 年)的約 126,000 篇摘要回測,Pangram 只標記了 6 篇,誤判率低於 0.01%;非英語系國家出身的學生在這批樣本的標記率是 0%,與英語系出身相同,說明偵測器沒有把「英文寫得不道地」誤判成 AI。
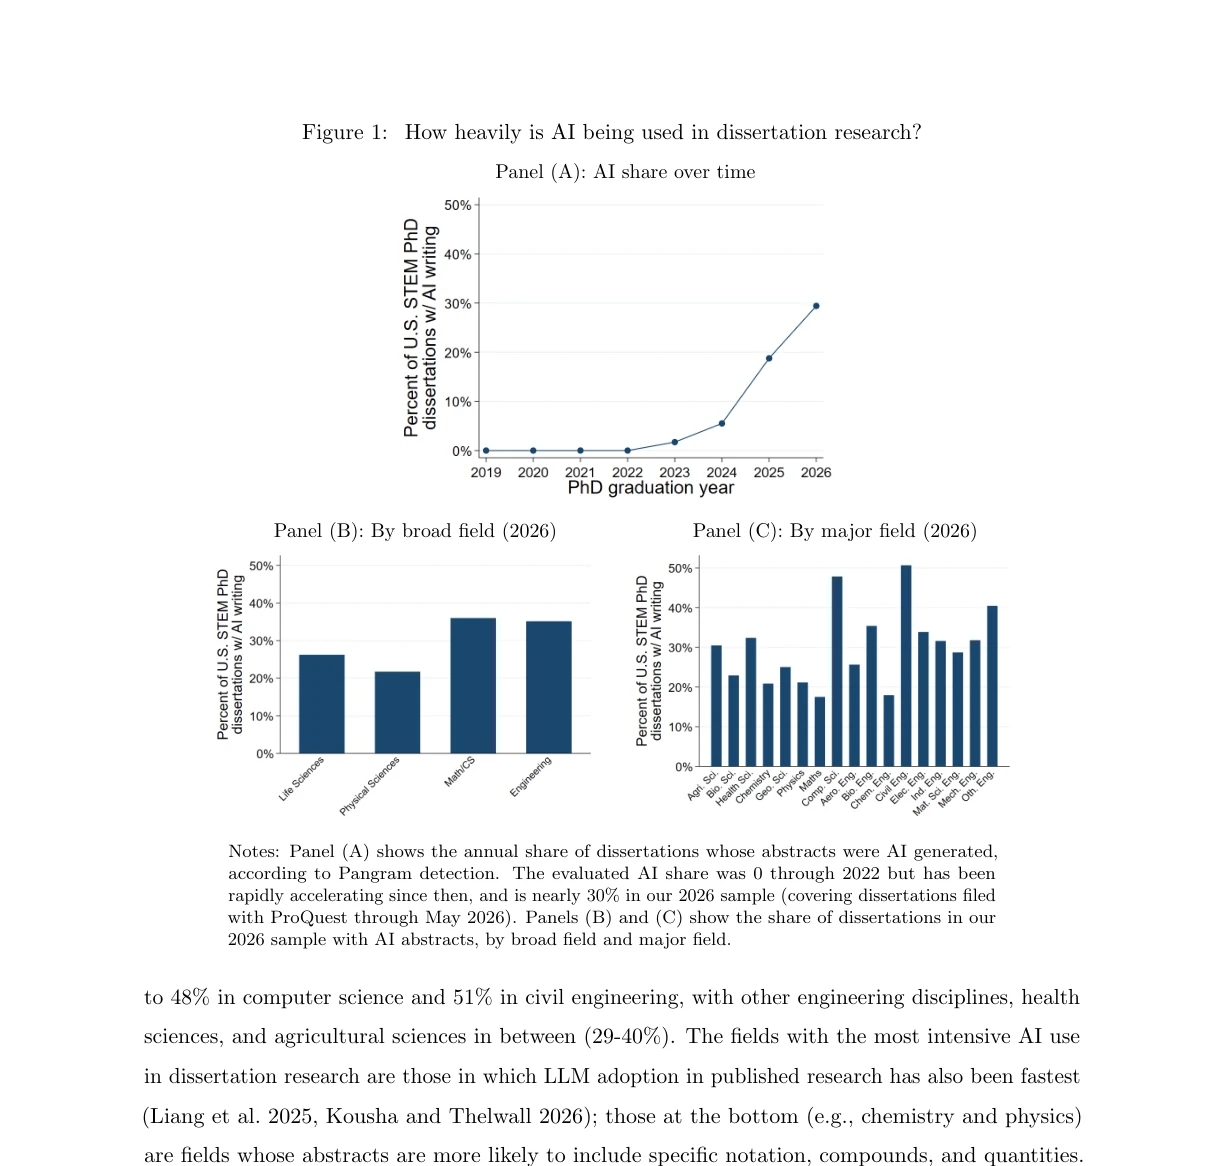
逐年數字是 2023 年 1.7%、2024 年 5.5%、2025 年 18.8%、2026 年(收錄至 5 月)29.4%。對照其他針對期刊論文與預印本的研究,2024 年電腦科學與生醫領域有 13% 到 22% 的摘要經判定經過 LLM 修改,同年度博士論文的對應估計只有約 5%,作者的解讀是博士研究在 AI 採用上落後整體科學活動一到兩年,而追趕速度很快。
為確認摘要足以代表全文,團隊按領域與年份分層隨機抽取 340 份完整論文全文送驗,再以條件機率換算回整體樣本:2024 年約 8%、2026 年約 31% 的論文含 AI 寫作,並明言這些估計應視為下限。換算前後的對照本身就是一個提醒:2024 年摘要口徑 5.5%、全文口徑約 8%,兩種視角差了快一半:只看摘要,會系統性地把事情看淺。NBER 的制式聲明也適用於此:工作論文供討論用途,尚未經過同儕審查;論文頁面載明 2026 年 10 月 1 日發布、10 月 6 日修訂,X 上的討論潮從 10 月 5 日開始。
2026 年畢業生裡,先前學歷在非英語系國家完成的學生有 41% 摘要被標記,英語系國家出身是 23%。分國家看,伊朗 51%、南韓 49%、中國 44%、印度 43%,加拿大與英國出身和美國出身沒有差異。差距還在逐年放大:2023 年兩邊是 2.8% 對 0.9%,2025 年已是 28% 對 14%;控制學校與領域後,三個年度的差距分別是 1.5、3.7、11.7 個百分點。
學校層級呈現同一個方向:研究型大學 R1 是 28%,R2 是 31%,其他博士授予機構 37%。在 R1 大學內看 2025 到 2026 年畢業生,同一領域裡排名前 10 的系所約 15%,排名 90 到 100 的系所約 26%,平均每往後十名增加約一個百分點;控制出身背景後,斜率從每往後一名約 0.10 個百分點降到 0.07,估計依然精確;作者群推算約三分之一的梯度來自頂尖系所招收較多國際學生的結構差異,其餘在控制出身後依然穩定存在。
領域之間的差距更大:數學與電腦科學 36% 最高,工程 35%,生命科學 26%,物理科學 22%。細分到具體學門,數學與統計是 17%、化學工程 18%,電腦科學 48%、土木工程 51%。
三組分布疊起來看,圖像與「頂尖學生偷懶」的直覺剛好相反,更像寫作負擔最重的人先拿走了工具:英文寫作構成額外成本的人、身處研究強度較低的後段系所。對「AI 寫作等於品質低落」這個流行判斷,分布本身就是一個修正訊號。
附錄裡還有一組擴散估計把「環境」這個變數補進來:同一系所前一屆畢業生的 AI 標記比例每高 10 個百分點,下一屆畢業生自己的摘要被標記的機率就高約 3 個百分點;換成同一指導教授的前一期學生,對應數字約 2 個百分點。作者群的解讀相當節制:這說明 AI 使用在訓練環境裡群聚,成因可能是同儕影響、共享規範、取得管道或指導者的習慣,但不能當成外生變異來用,因為同樣的環境也可能直接影響畢業生的出路。
研究透過 Revelio Labs 的 LinkedIn 資料,追蹤 2023 到 2025 年 R1 大學畢業生在 2026 年的職業,迴歸式控制了學校與領域的組合以及畢業年,比較同一環境裡的同屆畢業生。出身背景的判定方式是把 LinkedIn 學經歷裡的高中或大學部就讀國家當作代理,約六成樣本有這項資料。美國出身的畢業生中,論文含 AI 寫作者進學術界的比例少 7.4 個百分點(學術界基準約 44%,相當於相對少了 17%),進業界的比例多 8.0 個百分點(基準約 50%),政府部門沒有差異。留在學術界的人裡,這群畢業生擔任非終身職路線職位的比例高 5.4 個百分點(基準 12%),終身職與博士後則沒有顯著差異。外國出身畢業生的差距大幅縮小。
作者群對這組數字的態度寫得很明白:這是相關分析,同時支持兩種方向相反的解讀;他們也直說,目前把證據看成暗示 AI 使用對研究能力有不利影響,但兩種讀法都還沒有被排除。往因果方向讀,用 AI 寫論文的畢業生可能有訓練缺口,使其難以走上研究職涯;往反方向讀,本來就打定主意去業界的學生,自然不會把力氣投注在論文打磨上。團隊檢驗了「低投入」的替代標記,發現論文頁數與 AI 使用沒有關聯,但頁數是粗略指標,排除不了其他解釋。同樣把就業端的 AI 效應量化、也同樣把機制留給時間的研究,可以對照 Bezos 的 AI 缺工預言背後那套機器人成本帳。
結論段的措辭值得照錄。作者群寫道,這份研究的證據「暗示有代價」,但所檢視的終點無法完全回答 AI 使用是否真的侵蝕了研究職涯的準備;把寫作視為迫使精確理解的觀察者會傾向相信,把科學溝通視為可與研究本身分離的工具的人會不同意。要收案,得等「較少獨立發表、較少贏得競爭型研究經費」這類直接反映研究能力的指標累積出來,並補上因果評估設計。
論文首頁的謝誌有兩行會改變讀者對這份研究的位置判斷。研究團隊感謝 Pangram 提供 API 額度與折扣價,也就是偵測服務的供應商和研究之間有商業關係;同一段落載明 Claude Fable 5.1 用於實證結果討論段與部分資料附錄的初稿,全部 AI 生成文字都經大幅人工修訂。一份測量 AI 寫作的研究自己揭露了 AI 寫作與偵測器廠商的雙重關係,這是透明度的加分,也是讀這些數字時該帶著的背景條件。
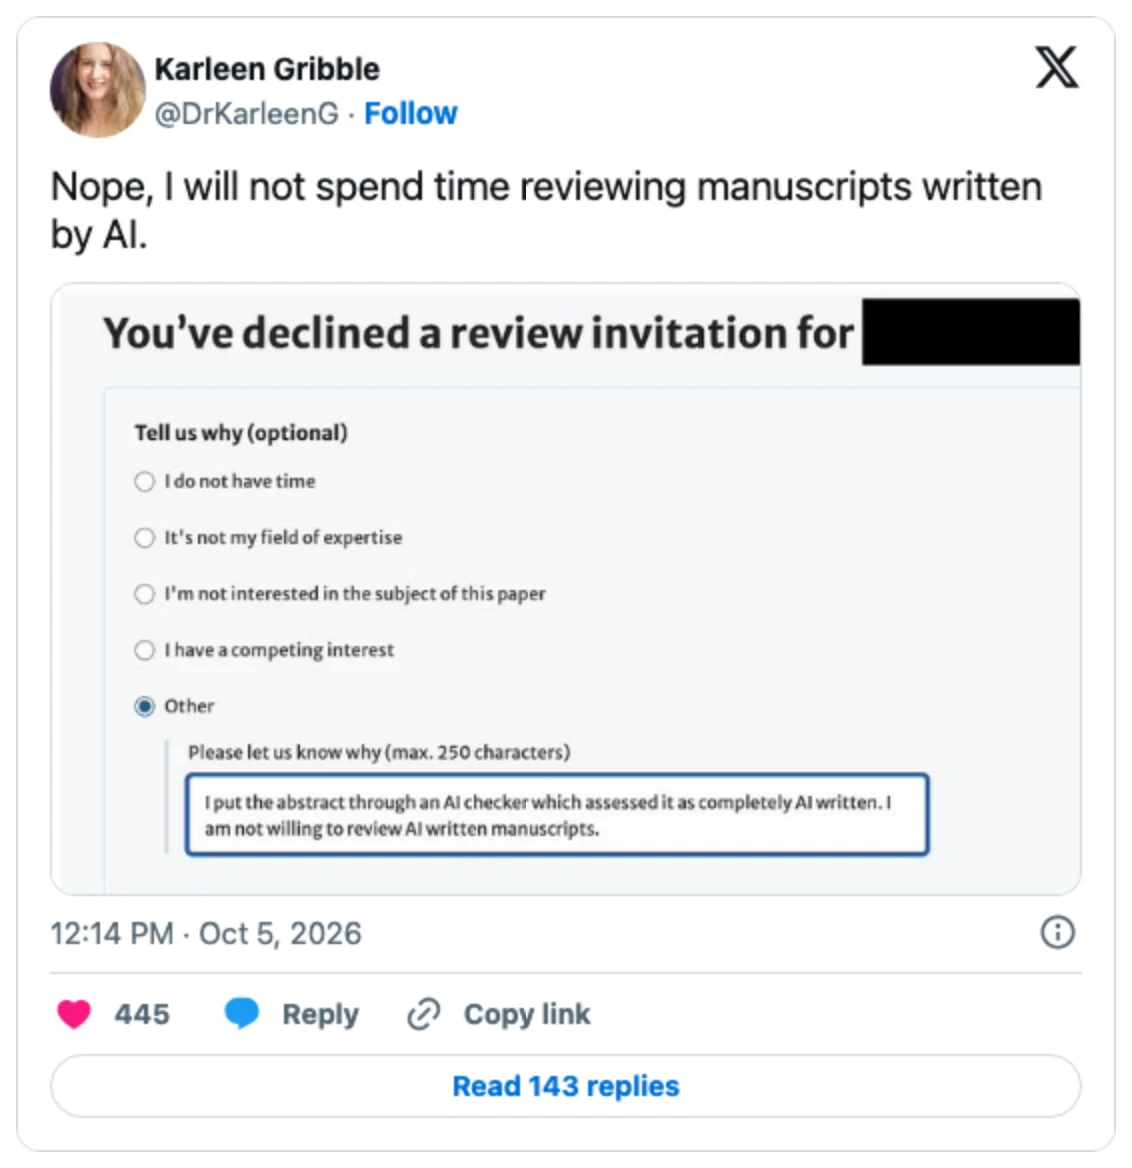
論文公開當天,X 上的反應正好沿著作者預期的兩個陣營展開。10 月 5 日,獲期刊邀請審稿的學者 Karleen Gribble 貼出她拒絕這封邀請的表單畫面:表單上列著「沒有時間」「不是我的專業領域」「對主題沒興趣」等制式選項,她勾了「其他」,在理由欄寫下她把稿件摘要送進 AI 檢查器,判定完全由 AI 寫成,因此不願意花時間審 AI 寫的稿件。她的對象是期刊投稿,與博士論文是兩件事,但這張表單把「偵測器判定成為審稿門檻」的現實搬上檯面。想在中文語境親自試試偵測器讀法的讀者,可以參考 騰訊朱雀 AI 檢測的實測筆記。
同日其他幾則回應分居兩側(台北時間 10 月 5 日中午到深夜)。Ross Prager 質疑這是另一場學術圈的美德表演:如果 AI 使用有透明揭露,又能幫研究者把科學講得更清楚,問題到底在哪。達特茅斯學院經濟學教授 Paul Novosad 的判斷則不留模糊空間:不管喜不喜歡,AI 寫作就是低品質、低投入的訊號。Misha Teplitskiy 貼出論文摘要頁面,把就業發現那句標上重點分享,配文翻成中文就是一句:「論文裡的 AI 寫作與不進入學術研究相關」。把 AI 產出當成必須有人負責的訊號而非自動加分項,這條討論線與 Shopify 執行長 Lütke 的 「AI 垃圾手榴彈」比喻是同一個爭論的兩次爆發。
依目前的增速推算,作者群預期 2028 年大多數美國 STEM 博士論文都會含 AI 生成內容。論文結尾指出,與期刊論文不同,博士學位本來就有「現場口試」這個驗證機構,作為專業知識與理解度的測試,以及學位授予的條件,其重要性可能會隨之提高。最後一句提問留在紙上:下一個世代的科學家,究竟是受到訓練,還是只取得了憑證。
台灣讀者能搬走的是一組可遷移的讀法,結論本身搬不動。它量測的母體是美國 STEM 博士,分布背後的英文寫作負擔、系所排名結構與就業市場都長在美國情境裡;但「偵測器標記的是文字特徵,不是研究品質」「採用沿著寫作負擔分布」「就業關聯需要因果設計才能定論」這三條判讀原則,放在任何討論 AI 寫作的場合都適用。
這份研究的數字有四個明確的未定案之處。工作論文尚未經同儕審查,數字可能隨版本調整;偵測器的漏判率未量化,所有比例是下限;就業關聯的因果方向要等獨立發表與競爭型經費等指標累積;論文追蹤的職涯資料停在 2026 年,後續版本應回頭核對 NBER 頁面上的修訂狀態。在此之前,29% 是一個測量邊界清楚、但解讀空間同樣清楚的數字。