TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

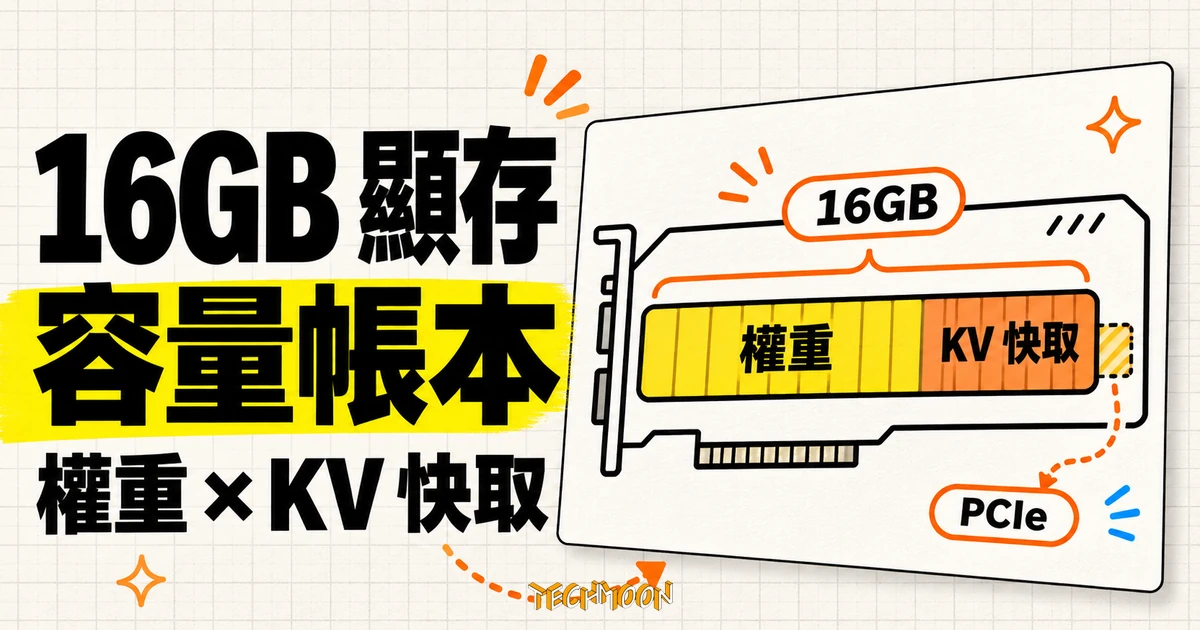
llama.cpp 在 2026 年 11 月 13 日發布 1.0,FP8 KV 快取與主記憶體 MoE 專家快取兩項新功能直接改寫 16GB 顯示卡的帳本:9B 全速駐留、14B 當日常主力、27B 的 Q4 檔案本身逼近帳面容量,35B 級 MoE 則多了一條官方支援的繞路,塞不進的部分要走慢約十五倍的 PCIe 備援道。
用 AI 摘要這篇文章:
llama.cpp 在 2026 年 11 月 13 日發布 v1.0.0,把推論函式庫與底層張量庫 ggml 一起推上 1.0,並宣布從此依語意化版本管理介面變更。對手上已經有 16GB 顯示卡的人,這次更新真正值得記的不是版號,而是兩個直接改寫顯示卡記憶體(VRAM)帳本的功能:FP8 格式的 KV 快取,以及把 MoE 模型的專家權重放進主機 RAM 的快取機制。先講結論:在 16GB 這個容量級距,9B 等級的 Q4 量化模型可以全速駐留、14B 是日常主力、27B 的 Q4 檔案本身就逼近帳面容量,而 35B 等級的混合專家模型(MoE)現在有一條官方支援的繞路可走。這份帳本可以逐欄攤開來算。
16GB 顯示卡能跑多大的模型,答案可以攤成一張表。檔案大小取自 Hugging Face 上 unsloth 量化倉庫的實際檔案(2026 年 11 月 21 日查詢),KV 快取欄位依各家官方 config.json 的層數與 KV 頭數推算,全部以 GiB 計。
| 模型與量化 | 權重檔案 | 加 8K 上下文 KV(推算) | 16GB 全駐留判定 |
|---|---|---|---|
| Qwen3.5-9B Q4_K_M | 5.29 GiB | 約 5.5 GiB | 可以,餘裕最大 |
| Qwen3-14B Q4_K_M | 8.38 GiB | 約 9.6 GiB | 可以,日常主力 |
| Qwen3.8-27B UD-Q4_K_S | 14.30 GiB | 約 14.8 GiB | 極緊,緩衝區所剩無幾 |
| Qwen3.8-27B UD-Q4_K_M | 15.43 GiB | 約 15.9 GiB | 放不進 |
| Qwen3.6-35B-A3B UD-Q4_K_M | 20.61 GiB | 約 20.8 GiB | 全駐留不可,改走 -cmoe |
幾個直接可用的判讀:Qwen3.5-9B 的 Q4_K_M 只有 5.29 GiB,就算把上下文拉長、換上 Q6_K(6.95 GiB)都還有換手空間;Qwen3-14B 是上一世代模型,權重放得進去,但它的 KV 快取每 token 成本是 27B 新架構的 2.5 倍,長上下文場景要先算過;Qwen3.8-27B 兩個 Q4 版本一個 15.43 GiB、一個 14.30 GiB,數字上看 14.30 GiB 似乎塞得進 16 GiB,但推論引擎的計算緩衝區、作業系統的桌面開銷都還沒扣,實務上把它視為放不進比較安全;Qwen3.6-35B-A3B 檔案超過 20 GiB,全駐留無望,但它正是 1.0 新功能設計的目標族群。
表裡的「判定」欄純粹是容量結論:能不能裝下是一回事,裝下之後跑多快是另一回事,速度由頻寬決定。
v1.0.0 的發布說明列了一長串變更,跟 16GB 帳本直接相關的有兩項。
第一根槓桿是 FP8 KV 快取。KV 快取是模型一邊生成一邊記住前文的暫存空間,傳統上用 f16 儲存。1.0 新增 -ctk/-ctv f8_e4m3 參數,把這塊快取壓到每個數字 1 byte,容量直接砍半。對長上下文使用者這是免費的空間:同一張卡,同樣的 VRAM 預算能餵兩倍的上下文長度。Q8_0 等級的 KV 量化先前就有,FP8 是精度與空間的另一個取捨點。
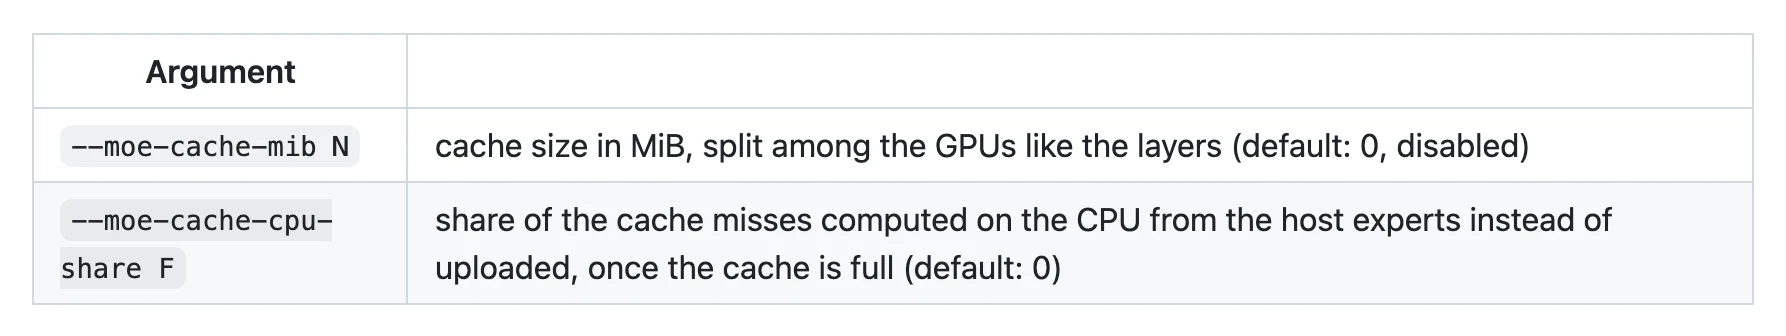
第二根槓桿是主記憶體 MoE 專家快取。混合專家模型把多數參數放在「專家」裡,每個 token 只動用其中一小群,這代表沒被選中的專家其實不需要待在 VRAM。官方文件把這條路寫成一組明確參數:-cmoe 把專家留在主機 RAM、--moe-cache-mib 指定多少 MiB 的 VRAM 用來快取最常被選中的熱門專家、--moe-cache-cpu-share 決定快取滿了之後有多少比例的缺漏交給 CPU 就地計算。倉庫裡還附上一支 moe-cache-tune.py,它會把你的伺服器啟動六次、實測兩種快取大小與三種 CPU 分攤比例,然後印出建議參數。
除了這兩項,1.0 也把棄用已久的公開 API 清乾淨、將投機解碼的 NextN 介面推進主標頭檔,並強化了 llama-server 對 SSRF、CORS 與 DNS rebinding 的防護。ggml-org 在發布部落格裡的定位講得明白:三年半以來下游應用越來越多,穩定的介面邊界是對這些依賴者的承諾,之後破壞性變更一律以主版本號反映、新功能與模型支援走次要版本號、除錯走修補號。對一般使用者,這代表 Ollama、LM Studio 這類包著 llama.cpp 引擎的應用,未來升級時的介面風險有號碼可以對照;部落格同時列出 Homebrew、Winget、conda-forge 與 Docker 等發佈管道的持續擴張計畫,安裝路徑只會越來越短。
量化模型的權重就是一個檔案,檔案多大、VRAM 就要先付多少,這是帳本裡最硬的一欄。Q4_K_M 是 4-bit 中等精度的主流選擇,各家模型在 Hugging Face 上的量化倉庫都會列出每個檔案的實際大小:Qwen3.5-9B 是 5.29 GiB,Qwen3-14B 是 8.38 GiB,Qwen3.8-27B 的動態版本是 15.43 GiB。
這裡有個單位陷阱。顯示卡標稱的 16GB,容量單位其實是二進位的 GiB,而 VRAM 還要分給桌面、瀏覽器與推論引擎的計算緩衝區。換句話說,15.43 GiB 的模型檔對上 16 GiB 的帳面容量,表面上剩 0.57 GiB,扣掉這些必要開銷後是負數。判斷放不放得進,拿檔案大小直接對 16 GiB 比就已經很緊,更不用說還有下一欄要付。
如果願意把量化再壓一階,27B 也有 IQ3 等級的選擇(約 11.2 GiB),空間立刻寬鬆,代價是文字品質的折損由你自己判斷。一般建議把 3-bit 視為「跑得起來先看看」的等級,正式使用回到 Q4 以上。
KV 快取的成本公式不複雜:每 token 的位元組數,等於 2(鍵與值)乘上需要快取的層數、每層 KV 頭數、每頭維度,再乘上每個數字的位寬。各家架構給的參數差很多,同一條公式會算出很不一樣的帳。
新世代的 Qwen3.5 與 Qwen3.8 採混合架構:每四層只有一層是全注意力層(需要 KV 快取),其餘是狀態固定的線性注意力層,成本不隨上下文長度成長。以 Qwen3.8-27B 為例,config.json 寫明 64 層中每四層一層全注意力、4 個 KV 頭、每頭維度 256,用 f16 算下來每 token 約 64 KiB:8K 上下文要 512 MiB,32K 要 2 GiB。Qwen3.5-9B 是 32 層取 8 層、同樣 4 頭 256 維,每 token 約 32 KiB,16K 上下文也只要 512 MiB。
對照之下,上一代的 Qwen3-14B 是每一層都要 KV 快取的傳統架構:40 層、8 個 KV 頭、每頭 128 維,f16 每 token 約 160 KiB,是 27B 新架構的 2.5 倍。也就是說,參數量更大的新世代模型,長上下文的記憶體成本反而更低。挑模型的時候別只看參數量,架構世代對帳本的影響跟參數量一樣大。表中 KV 欄便是照這條算式逐項得出;這些是依官方架構參數得到的推算值,各家引擎的實際配置可能略有出入,但數量級不會變。
而 1.0 的 FP8 快取在這一欄的效果可以直接換算:27B 的 32K 上下文從 2 GiB 降到約 1 GiB,等於把表中 27B 那兩格的判定往外推了一格。它推不動第一欄:權重該多大還是多大。
權重加 KV 超過 VRAM 時,llama.cpp 的傳統解法是分層放置:-ngl 參數決定多少層留在顯示卡,剩下的層落在主機 RAM,由 CPU 計算。這個參數的預設值是 auto,多數時候會自動把能塞的都塞進 VRAM;塞不下之後,留在主機的層改由 CPU 就地計算,官方文件對這條路的評價是模型有一部分要跑在相比之下更慢的系統 RAM 上,並建議把減少 -ngl 留給最後手段,先降上下文長度或併發數。
瓶頸的差距可以用頻寬量化。RTX 5080 的 GDDR7 頻寬是 960 GB/s,RTX 5070 Ti 是 896 GB/s;而會被搬進顯示卡的資料走的是 PCIe 5.0 x16,單向吞吐量 63.0 GB/s,與 GDDR7 相差約十五倍。這條路上最明確的流量是 MoE 專家上傳:快取沒命中的專家要從主機 RAM 經 PCIe 進顯示卡,每個 token 上傳 2 GB 的理論上限就是每秒約 31 個 token,上傳 5 GB 掉到約 12 個;至於整層留在主機由 CPU 計算的配置,文件沒有給量測數字,只以「相比之下更慢」定性。實際數字只會更低,因為這條路還有排隊與同步的開銷。960 GB/s 的帳面頻寬,只有在整個模型都駐留 VRAM 時才用得到。
這也是為什麼「跑得起來」跟「跑得動」在 16GB 這個級距是兩個問題。把 27B 硬塞進「權重在卡上、少數層在 RAM」的配置,引擎不會報錯,速度卻會從順手變成等待。同樣的算式也說明了 5080 與 5070 Ti 的差別:兩張卡都是 16GB、能裝下的模型完全相同,頻寬差那 64 GB/s 只影響全駐留時的速度檔次,救不了溢出的崩跌。
Qwen3.6-35B-A3B 這類混合專家模型給了另一種走法。它的 config.json 寫著 256 個專家、每個 token 只選 8 個,也就是每 token 真正動到的參數約 3B,但知識量是 35B 級。它的 Q4_K_M 檔案 20.61 GiB,其中多數體積是那些偶爾才被選中的專家。
1.0 的 -cmoe 路線正好對上這種體質:注意力與共用權重留在 VRAM,專家群放主機 RAM,再撥一塊 --moe-cache-mib 的 VRAM 快取熱門專家。token 生成時,快取命中的專家直接在卡上算,沒命中的從 RAM 上傳,而 --moe-cache-cpu-share 讓 CPU 分攤一部分上傳壓力。要注意這套快取的受益場景是單人解碼與投機解碼這種小批次流量;文件寫明大批次請求仍然會把用到的專家整批上傳,多人共用的伺服器場景別期待同一套參數通吃。官方文件還提醒了一個反直覺的細節:如果主機端專家以 mlock 等模式釘在記憶體裡,顯示卡能以鏈路全速上傳,CPU 分攤未必有幫助;專家走 mmap 預設時,快 CPU 與快 RAM 才有明顯收益。這種參數組合正是 moe-cache-tune.py 存在的原因,它用兩種快取大小乘上三種 CPU 分攤比例共六次實測,換一組建議值,比自己猜快。
代價也要照算:主機 RAM 要真的夠(20 GiB 級的模型就要 20 GiB 級的 RAM 餘裕)、PCIe 頻寬仍是瓶頸的一部分、而快取參數在不同機器上要重調。這條路把 16GB 卡的能力上限從「14B 全駐留」延伸到「35B 級 MoE 可用」,但它是用工程換來的,不是魔術。
帳本是能力的問題,市況是成本的問題,後者這個月正在惡化。同一波 AI 需求也把上游的產能合約拉緊,輝達近一個月的供應鏈承諾公告就是把產能分配權提前寫進合約的例子。Tom’s Hardware 在 11 月 4 日報導,Nvidia 官方商店繼 5090 之後也把 RTX 5080 下架,街頭價格來到建議售價的 2.2 倍;5080 的建議價是 999 美元(2025 年 1 月 30 日上市),換算實價約 2,200 美元。同為 16GB 的 5070 Ti 建議價 749 美元、頻寬少約 7%,市價同樣隨行就市。市場報導的數字時時在變,這裡引用的是 11 月 4 日的報導時點,實際下單前請以當日行情為準。
如果目標就是 16GB 跑本地模型,帳面上最便宜的入場券是 RTX 5060 Ti 16GB:建議價 429 美元、同樣 16GB GDDR7,但匯流排只有 128-bit、頻寬 448 GB/s,不到 5080 的一半。用前面的算式看,它裝得下的模型跟 5080 一模一樣(容量相同),全駐留時的速度上限卻直接折半,溢出場景的崩跌起點也更早。省下的錢,是用速度上限換的。
在伺服器端有另一種分工:多人共用、顯卡更大時,記憶體配置可以交給推理引擎處理,vLLM 的 PagedAttention 與 FP8 路線就是為 24GB 級顯卡撐起多人同時發問的設計;單人使用、檔案自己管的場景,回到 llama.cpp 這類工具把帳本握在自己手上。而 12GB 級顯卡的事前功課,Strata 與 DeepSeek V4.1 Flash 的部署分析先前已算過一輪,16GB 的帳本只是欄位數字不同、方法完全相同。
把邊界講清楚。其一,表裡所有速度相關的數字都是頻寬除出來的理論上限,不是任何顯卡上實測的吞吐量;實際數字受驅動、電源、散熱與引擎版本影響,只會低於上限。其二,KV 快取欄位依官方 config.json 推算,各推論引擎對線性注意力層的狀態配置不同,實際佔用會有小幅出入。其三,作業系統與桌面環境吃掉多少 VRAM 因機而異,Windows 上跑多螢幕高解析度的讀者要再多預留一格。
值得回看的三個時間點:llama.cpp 的 1.x 系列會以次要版本號繼續進場,FP8 快取與 MoE 快取的參數介面是否微調值得跟;Qwen3.8-27B 之後的下一世代若把全注意力間隔再拉大,KV 帳還會再降;而 5080 的通路價格決定這份帳本入口的門票多少。帳本方法本身不會過期:權重檔案大小、KV 每 token 成本、PCIe 備援道頻寬,三個欄位對下一張顯卡、下一個模型一樣適用。