TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

朱雀 AI 檢測助手是騰訊朱雀實驗室的免費 AI 生成偵測工具,網頁直接測文字、圖片與影片。實測免費額度、逐段機率輸出與資料流向,看懂它當初篩工具哪裡稱職、當審核證據哪裡會出事。
用 AI 摘要這篇文章:
收到一張說不上來哪裡怪的圖,或是一段太順、太像機器寫出來的文字,多數人的下一個動作就是上網找偵測工具。朱雀 AI 檢測助手是騰訊朱雀實驗室直接放在網頁上的免費服務,瀏覽器打開就能把文字、圖片甚至影片丟進去測,不用安裝任何東西。我把它從免費額度、輸出形態、官方成績到資料流向整個查過一輪,也親自把內容送進它的偵測流程。先講結論:把它當初步過濾的工具很稱職,把它當最終判決會出事,而這條線官方自己畫得比你想像的更清楚。
朱雀 AI 檢測的網址掛在騰訊朱雀實驗室的網域底下,從台灣連線直接開得動,不需要另外想辦法。朱雀實驗室是騰訊安全平台部門 2019 年成立的安全研究團隊,長期做 AI 安全的攻防研究,研究發表過 Black Hat 與多個頂級 AI 研討會,也開源過用來測試 AI 系統安全性的紅隊工具 A.I.G。換句話說,這個偵測工具背後不是突然冒出來的小工作室,而是一個有研究能量的資安團隊的對外作品。這個檢測頁在網際網路檔案館 2025 年 2 月就有快照,檢測模型的更新時間停在 2026 年 7 月 21 日,至少到近期都還有人在維護。
介面對中文瀏覽器給的是簡體中文,名詞要自己轉換一下才習慣,不影響操作;瀏覽器設成英文的話會自動切換成英文版。頁面分成文字與圖片影片兩個分頁,文字可以貼上或上傳 txt、docx 檔,圖片收 png、jpg、webp,影片收 mp4、mov、avi。
免費次數是最值得先搞清楚的數字。我實際打開時,兩個分頁的偵測按鈕都寫著今日剩餘 5 次;但官方常見問答寫的是訪客每天文字與圖片各 3 次免費。兩處口徑對不上,建議以現場按鈕顯示的為準。想要更多次數就登入,官方說法是登入後每天文字 20 次、圖片影片 30 次,測完給回饋還能再加 5 次,有次數上限。登入方式有兩種,微信掃碼或 Google 帳號,不想碰微信的人用 Google 帳號就能解決。
送測前還有幾條規格線。文字長度要夠,下限是 350,中文以字計、英文以詞計,湊不滿會直接被擋下來;上傳檔案最大 10MB。圖片的長寬都要超過 300 像素,我拿一張 48 乘 48 的小圖測試,系統明確拒收並提示尺寸規定。每次送測都會先過一道騰訊的拖曳圖形驗證,把機器人擋在外面。
我也用無頭瀏覽器各送了一次文字與圖片。文字送出後伺服器回覆當日次數已用完並顯示服務超時,圖片則停在檢測中超過一分鐘沒有結果。這不代表一般瀏覽器也會如此,碰到回應卡住或次數顯示異常時,隔一陣子再試是比較實際的做法。另外官方在同站做了一個五題計分的小遊戲,讓你自己盲測哪張圖是 AI 生成的,測的是人的眼力,順便體會機器的難處。
還有一個小細節值得記下來:官方在站上掛著重要聲明,強調這個網站是唯一官方平台、檢測完全免費、沒有經營任何公眾號、小程式或付費課程,提醒大家提防假冒。官方會特別把這段掛出來,顯然認為仿冒與收費詐騙的風險真實存在。你自己要付錢才測得到的朱雀,八成不是朱雀。
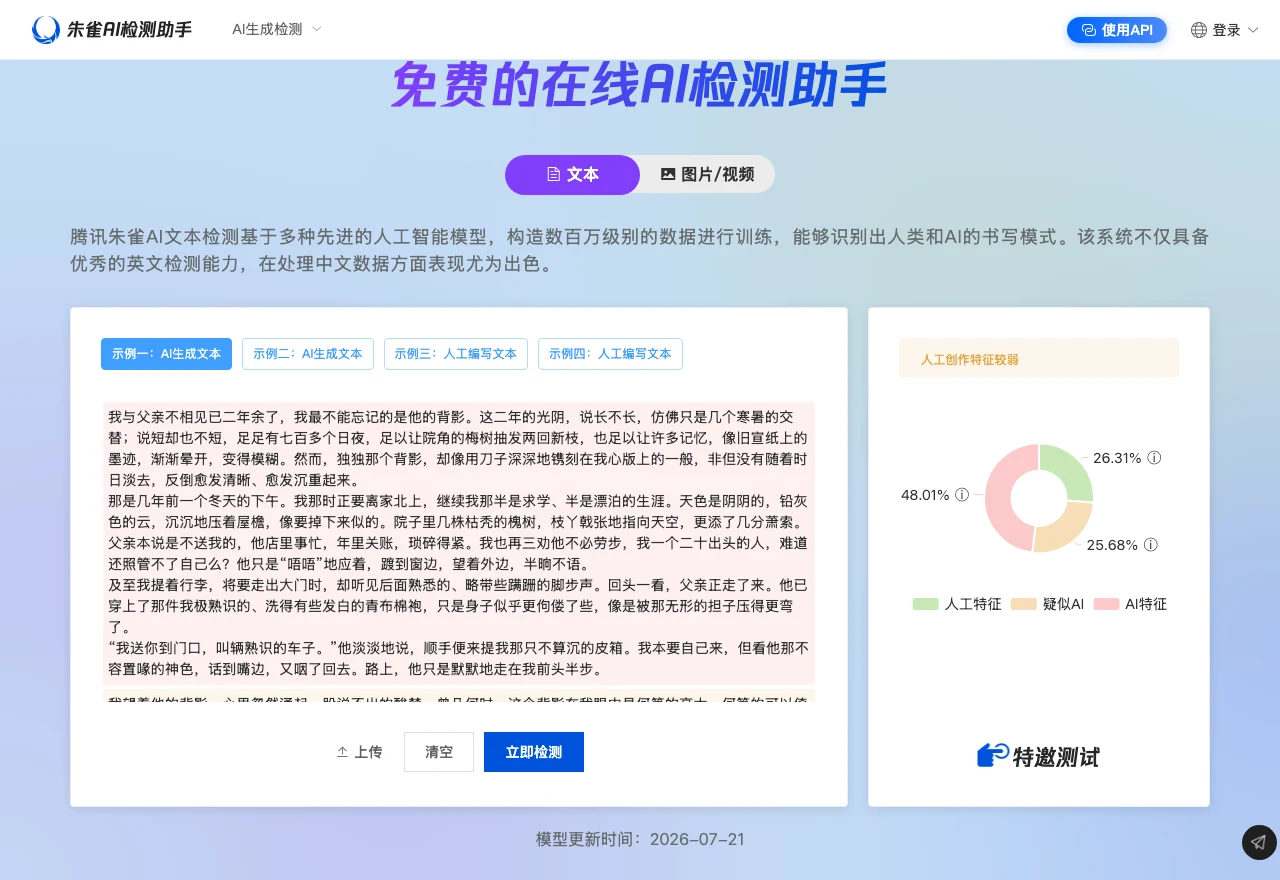
很多人對偵測工具的期待是丟一段文字進去,得到「這是 AI」或「這是人寫的」一句話。朱雀實際給的東西比這複雜,也誠實得多。以文字來說,你會拿到兩層輸出:整份文字的信心度,以及每一段落各自被歸入的分類。分類有三種,人類、AI、疑似 AI,占比會畫成圓餅圖攤給你看,結果卡再配一句總結標籤。
官方放在頁面上的四組示範很值得逐個看。第一組標示為 AI 生成的散文,模仿朱自清背影的開頭往下寫,被判 73.7% 傾向 AI,段落分布是 26.31% 人工、48.01% AI、25.68% 疑似,結果卡的標籤寫的是人工創作特徵較弱。第二組是英文的 Transformer 論文摘要,直接被判到 100%。第三、四組標示為人工編寫,內容是同一篇平價監視攝影機追蹤論文的中英文摘要,兩個都拿到 0%。這四組數字透露的訊息是:它不是全有全無的二分法,連 AI 仿寫經典散文這種刻意模仿人類風格的東西,它也只給七成多的信心,剩下的段落被切成疑似。
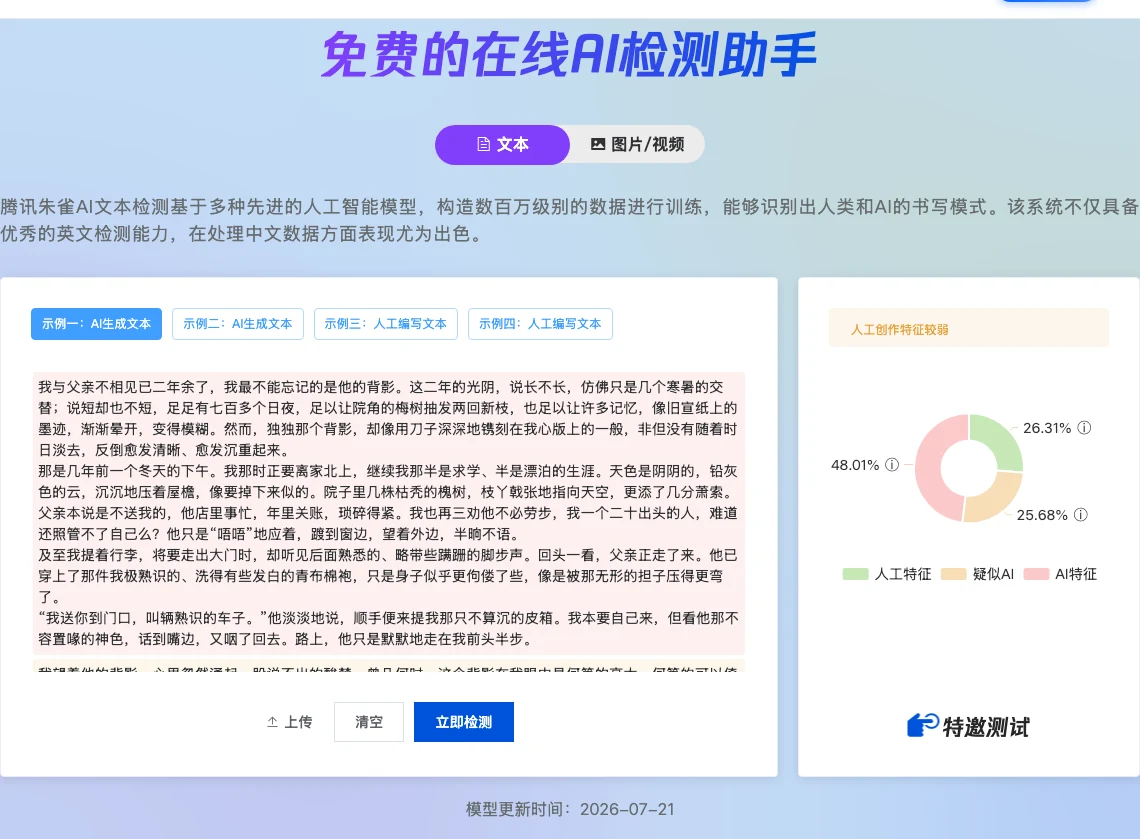
這種逐段輸出對實際拿來做事的人很有價值。假設你是老師,整份報告被判 60% 傾向 AI,先別急著定罪,點開逐段分布看:如果只有文獻回顧那幾段被標 AI,引用的文獻摘要本來就常有機器翻譯或資料庫文字,誤判機率不低;如果是學生自己的分析段落整片被標,才值得進一步對談。逐段資訊把「一份分數」還原成「哪裡可疑」,這是多數同類工具沒給到的顆粒度。
圖片端的輸出同樣有兩層。一個是它稱為 AI 濃度的機率分數,示範圖會顯示像 86.01% 這樣的數字,配上「容易被多個平台判定為 AI 生成」的結論標籤;另一個是一段以多模態模型寫的解讀文字,描述畫面裡有沒有違反常識的細節。示範中一張被標為真人創作的卡通插畫,解讀文字對畫面場景符不符合日常常識給出整體結論,等於在機率分數之外多了一層「畫面合不合理」的檢查。
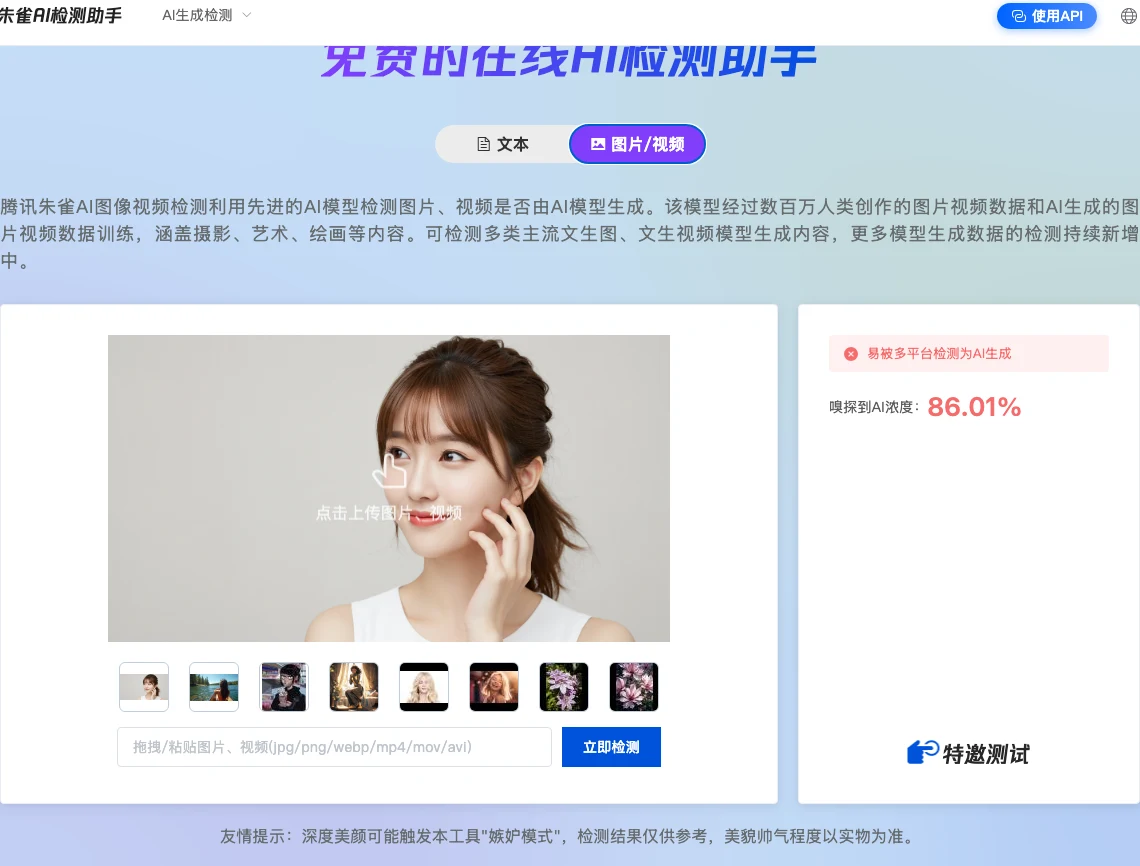
這兩層輸出會打架,而且證據就出在官方自己的示範資料裡。示範集中有一張代號 fake_3 的圖片,機率分數是 99.92%,幾乎是全 AI 的判斷;旁邊的解讀文字寫的卻是未發現明顯 AI 生成痕跡。分數和文字結論一個說東一個說西。對一般使用者的意義很直接:引用這個工具的結果時,分數和文字要一起看,只挑其中一層講,你引用的可能正好是錯的那層。這個矛盾也可能只是示範資料整理時的失誤,但無論是哪種原因,使用者看到的當下就是會被誤導,而官方還沒有修正它。
還有一個容易被忽略的性質:分數會漂移。官方常見問答自己承認,同一份內容在不同時間送測可能得到不同結果,因為偵測模型持續在更新換版。今天測出 90%,下個月再測變成 70%,不代表你的內容變了,可能是模型換了。要留證據的人,把送測日期和分數一起截圖存檔,別只記分數。
頁面下方有一整區評測成績,寫得非常漂亮:文字基準 HC3 判 99%,RAID 基準在誤報率壓在 5% 的條件下攔截率寫到 99.95%,有兩個英文基準直接寫 100%;圖片基準落在 96% 到 99.6% 之間,影片基準 95.5%。旁邊的情境宣稱更猛,社群 AI 美圖檢出準確率 98% 以上、學術場景整體準確率超過 92%。但這些數字有兩個前提要放大看。它是站方自己跑出來、自己公布的,沒有第三方覆核;表格上的對手全部以單一英文字母代號呈現,圖片與影片組是 T、H、S、C、I、R、Z,文字組是 G、C、T,行銷區的對照表更是只挑了三家來比。匿名對手加自家主辦加自選基準,這種成績表的行銷成分遠高於採購參考價值
可以參考的是它自我要求的下限:連官方自己都說不是 100%,你在頁面上看到的 100% 只是某個特定基準下的得分,換一組資料就不保證。
官方倒也沒有把話說滿。常見問答裡明白寫著它無法達到百分之百的識別準確率,網路小說、小學生作文這類表達方式通用的文字有一定機率被誤判,動漫圖與寫實人物照片這類和真實創作極為相似的圖片也有一定機率被誤報。它甚至給了理由:人類創作本身就有大量相似表達、訓練資料涵蓋不到小眾場景、生成技術還在快速演化,偵測端的追趕有時間差
圖片分頁還放了一句官方的玩笑話,說深度美顏可能觸發它的嫉妒模式,提醒你判定僅供參考、美貌帥氣程度以本人為準。玩笑歸玩笑,背後的事實是美顏與修圖確實會干擾判定,拿它測人像照之前,先把當事人有沒有開美顏放進變數裡。
偵測這件事的難,連做出 ChatGPT 的 OpenAI 都認了。OpenAI 自家的 AI 文字分類器上線不到半年就因為正確率不足而下架,有興趣看這段歷史的人可以參考我們之前整理的 AI Text Classifier 是什麼與下架原因。產業現實是:生成模型與偵測模型是貓抓老鼠的關係,任何單一工具的分數都不該被當成定論,朱雀也不例外。
隱私這題要分兩層看,一層是官方怎麼說,一層是技術上發生什麼事。官方在常見問答裡的承諾寫得很白:用戶資料不會用於檢測任務之外的任何用途,輸入內容只用於即時處理,系統會在回應完成後清除記錄,不會和訓練資料庫產生交互。這是官方的說法,採信到什麼程度由你決定。
技術上可以觀察到的事實是這樣:你上傳的檔案會先經過站內的上傳介面,存進騰訊雲端儲存服務位於廣州的節點,再交給偵測流程處理,官方示範圖檔本身就放在同一個儲存空間裡;整個過程帶著一套裝置指紋識別,搭配前述的圖形驗證做風控。把這段講白一點:你的內容會離開你的電腦,落到中國境內的騰訊機房,這是流程設計使然,沒有本地處理的選項。貼文字測的內容會透過即時連線送進偵測服務,這點從送測流量就能確認。
另外要注意,這個工具沒有獨立的隱私政策頁面,前述承諾全部以常見問答的形式存在,想找一份正式的法律文件來對照,目前找不到。如果你的內容還沒公開、具商業機密性質或涉及當事人隱私,送測前值得把這幾件事放進天平。已經公開的內容或本來就要發布的東西,風險就小得多。
朱雀不只給網頁,還提供 API。它掛在騰訊雲 EdgeOne 的模型服務底下,模型代號 zhuque-text,每個月有 50 萬 token 的免費額度,回傳的欄位和網頁版一致,包含信心度與逐段分類,還有一個參數能指定要不要逐段輸出。對想在自己產品裡加 AI 偵測的開發者,這條路比爬網頁正規得多。
不過兩份官方文件對支援範圍的說法有落差。偵測頁面的常見問答說 API 支援文字與圖片兩種模型;騰訊雲的開發文件卻寫著目前僅支援文字,圖片偵測要另外洽談企業方案。要接的人以騰訊雲文件為準,把圖片需求先當成沒有,避免做到一半發現規格和期待對不上。
回到最開始的問題:這個工具值不值得放進書籤列?我的答案是看你要它做什麼。
它稱職的場景都是初篩。你是編輯,收一堆投稿,先用它把明顯機器生成的稿子挑出來再人工細看;你是老師,收到可疑的報告,把它當輔助線索之一;你在社群看到一張太完美的照片,測一下決定要不要轉發。這些情境的共同點是最終決定權在你手上,工具只是幫你縮小範圍。實際操作上,看結果時至少做兩道保險:總分之外一定點開逐段分布看分布合不合理,被判 AI 的段落自己讀一遍找具體理由。找不到具體理由的高分,先當待查,別當結論。
它會出事的場景,是把分數當制裁依據。官方在頁面上掛的聲明寫得非常直白:本工具僅用於輔助檢測文字中可能存在的 AI 生成特徵,不作為內容真偽與版權歸屬的最終判定依據;把檢測結果用於審查、封禁、降權、仲裁等行為所引發的後果與糾紛,由使用方自行承擔。換句話說,官方早就把責任劃清了,你要拿它開除學生、退作者稿、下架別人作品,出事的時候帳算在你頭上,工具不陪你扛
再加上前面看到的,示範資料裡分數與解讀會互相矛盾、匿名對手的成績表無從驗證、同一內容跨時間分數會漂移,任何一條都足以讓單一分數失去當鐵證的資格。
與它相鄰的需求也順手整理。查圖片而不想把檔案交出去的人,不上傳就能驗 AI 簽章的本地工具是另一條路;關心 AI 生成圖片能不能商用的授權問題,號稱無版權爭議的圖片生成服務那篇有完整的拆解。朱雀的本分是回答這東西像不像機器做的,授權與版權從來就不在它的回答範圍裡。
最後一句話收斂:把它當金屬探測門,人人可以過,嗶叫的再拿出來人工檢查;把它當法官,第一個被告到的會是你自己。