TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

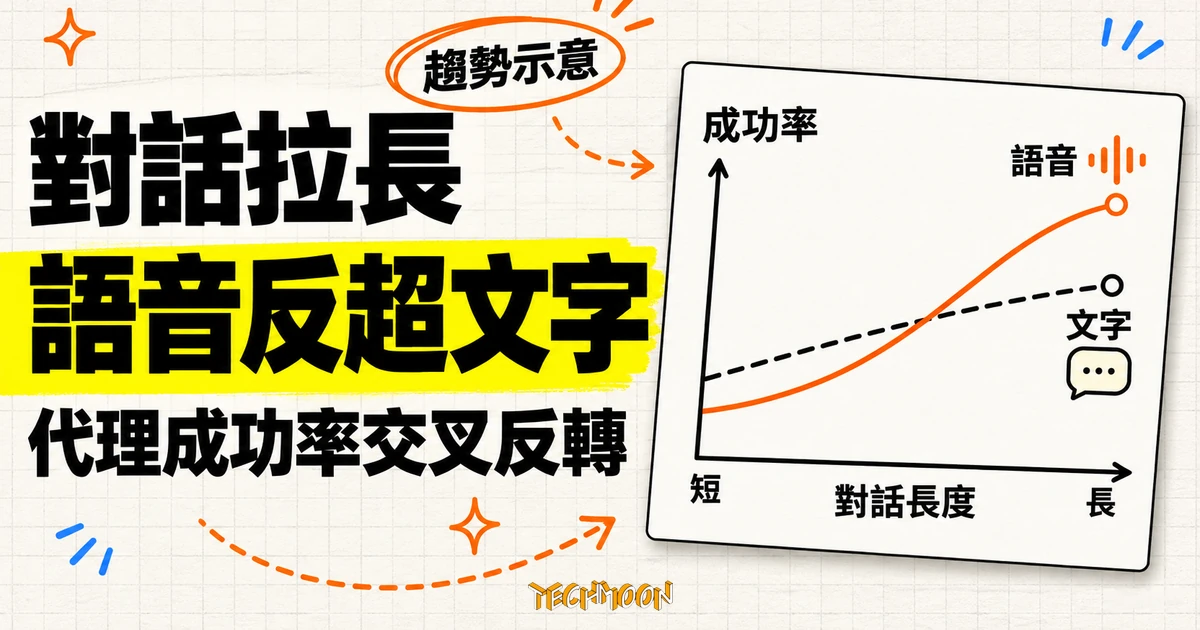
ElevenLabs 分析 469 個正式環境代理:對話不到一分鐘文字領先 8.7 個百分點,超過兩分鐘語音 45.4% 對 34.5%,相對增幅 31.7% 常被誤寫成百分點;成功案件 4.6 對 7 分鐘、90 個代理中 78% 語音較快,延遲觀察顯示 15 秒內掛斷從 21.1% 降到 3.8%。賣語音代理的公司公布對語音有利的數字,引用時要連分母與範圍一起搬。
用 AI 摘要這篇文章:
ElevenLabs 在 2026 年 11 月 2 日公布了一份語音客服分析,11 月 3 日又更新過一次內容,文章標題是 Why voice wins for complex, stressful conversations,作者是 ElevenAgents 產品與成長團隊的 Jake Tennant,與 ElevenLabs 行銷團隊的 Alanna Brown。比較的對象是電話與 WhatsApp 語音通話,對上文字客服對話。官方開場用三個數字帶結論:超過兩分鐘的對話,語音成功率高出約 32%;這些成功的長對話,語音快了大約三分之一;航班取消的模擬情境裡,85% 的參與者偏好語音。這三個數字在轉述裡經常被濃縮成一句「語音贏了」。不過翻回官方部落格與研究圖表,這份資料真正值得記住的是一條交叉曲線:對話不到一分鐘時,文字的成功率其實領先;超過兩分鐘之後,語音才把局面翻過來。
官方 X 貼文給出樣本規模:469 個在正式環境同時運行語音與文字的代理。部落格本文的寫法保守一些,只說數百個正式環境代理;資料期間是 2026 年 7 月到 9 月,每個代理都至少有 50 段語音對話與 50 段文字對話,比較方式是每個代理跟自己的另一個管道比,不把所有對話倒進同一個池子。這個設計決定了後面每個數字能回答的問題,以下把交叉點、處理時間、延遲觀察與情境實驗分開看。
官方圖表把對話依長度分成三組,副標寫明 Success rate per agent,也就是先算出每個代理各自的表現,再依對話長度分組呈現。不到一分鐘的組別,文字成功率 28.1%,語音 19.4%,文字領先 8.7 個百分點;一到兩分鐘的組別差距縮小,圖上標註語音領先 2.7 個百分點,但這一組沒有標出兩個管道各自的數值,只能從縱軸位置約略估計,正文對這組的描述是兩者大致相當;超過兩分鐘的組別,語音 45.4%,文字 34.5%,語音領先 10.9 個百分點。兩條線的交會就落在中間那段,往右開口越拉越開。
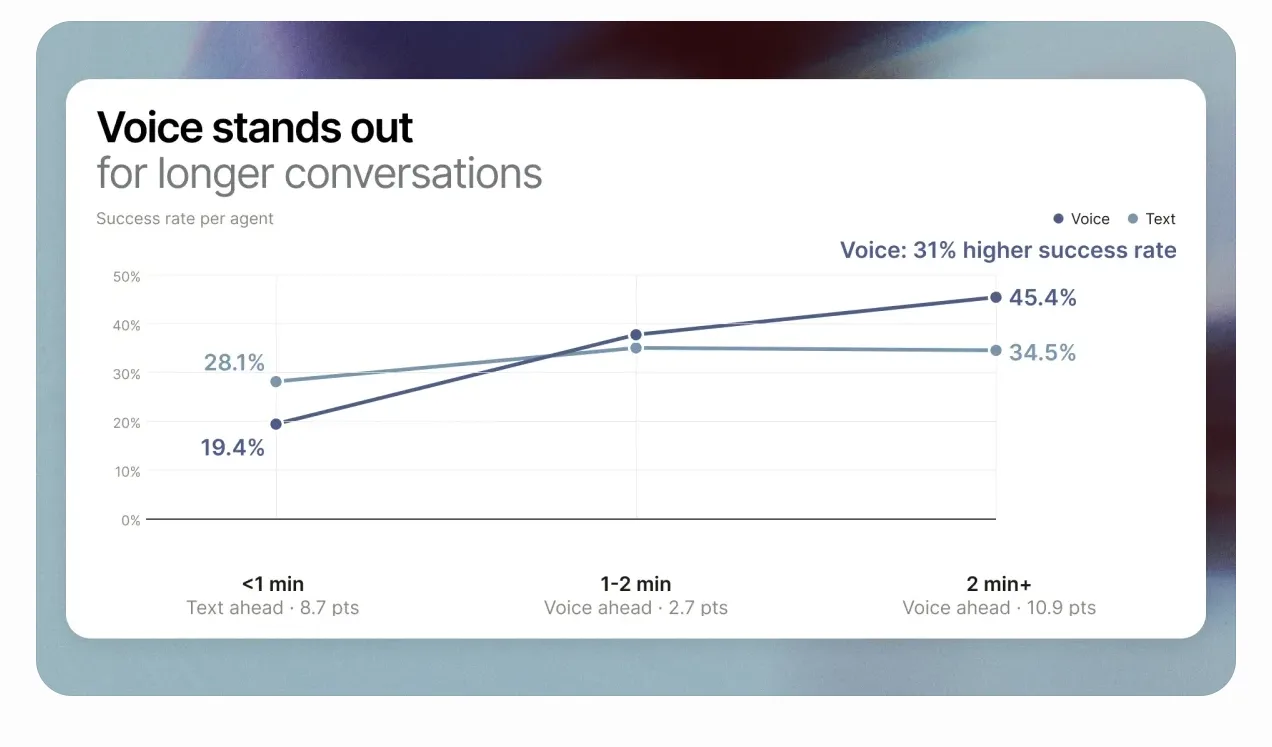
這裡有個很容易轉述錯的地方。官方摘要寫語音的成功率高出約 32%,這是相對增幅:10.9 個百分點相當於文字端 34.5% 的約三分之一,官方把相對增幅計為 31.7%、圖上註解寫 31%,引用時兩種都對,就是不能換算成百分點。若把這句話寫成成功率增加 32 個百分點,差距會被放大將近三倍,也對不上圖上任何一組數字。同一份資料裡,官方另註明超過兩分鐘的組別中,接近三分之二的代理在語音端有明顯較好的表現;換個方向讀,就是仍有超過三分之一的代理沒有跟上這個趨勢。比例與個體是兩件事,這句話對打算全面導向語音的團隊特別有用。
官方用對話長度當複雜度的替代指標,並自己承認這個衡量並不完美,還特別點名文字端:顧客可能在訊息之間停頓,讓對話時間看起來比實際工作更長。嚴格來說,這條曲線證明的是不同時間組別出現了不同結果,並不能直接推成某類問題天生屬於語音。
超過兩分鐘而且成功的對話裡,語音平均 4.6 分鐘完成,文字約 7 分鐘,語音端少掉約三分之一的時間。官方進一步只挑出兩種管道都有足夠成功長對話的 90 個代理來比速度,其中 78% 在語音端較快。
這組數字與成功率回答的問題不同。時間只計入成功的案件,失敗的對話與不到兩分鐘的對話都不在裡面,因此不能推成所有進線平均縮短三分之一;78% 的分母是 90 個代理,與整體 469 個也不是同一群體。把範圍連同數字一起引用,結論才站得住。
官方在後文談長對話的考驗時,把條件講得更完整:對話拉長後,代理要記得住前後脈絡、接得上自家系統,能自己完成改訂或退款,不必把顧客轉交人工。換句話說,超過兩分鐘的勝利並非只靠換了語音這個管道,還預設了代理真的有把事情做完的能力;反過來講,若代理接不上系統、只能給制式回覆,把管道換成語音,圖表右端的好成績也輪不到它。
方法論段落寫得相當清楚:成功條件由各業務自訂,某個代理的成功可能是完成訂位,另一個可能是解掉支援問題。既然成功定義不同,45.4% 這種數字只在各自業務的定義內有意義,不能拿去跟別家公司的客服成功率比高低。
自比的價值在於隔離業務差異。官方解釋,如果把所有對話混合計算,一個剛好以語音為主、又剛好成功率偏高的業務,會讓語音看起來比較好,即使語音對那個業務沒有產生影響;每個代理跟自己比,就把這層混淆消掉了。這是這份研究比一般廠商白皮書嚴謹的地方,代價是結論的適用範圍也停在這批代理的業務組合上,沒有揭露的業務類型分布,外界無從判斷哪些行業被抽得多、哪些根本不在裡面。
延遲是另一段獨立觀察。官方分析 315 個換用更快語言模型的代理對話:平均端對端延遲下降 16%,同時成功率相對提升 26%;從換用更快模型前到換用之後,15 秒內結束的通話佔比從 21.1% 降到 3.8%,這類通話往往在問題還沒展開前就結束了。端對端延遲一般泛指顧客等待整套系統回應的時間。官方的解讀是延遲在通話開場最關鍵:回應太慢,來電者會以為線路有問題而掛斷,撐過開場,問題才有機會被說完。
要注意官方用的是相關描述,沒有給出因果宣稱。模型換快的同時,任務組成與系統設定也可能一起變動,這組數字支持團隊回頭檢查自己的延遲與提早掛斷情形,但直接推成延遲降 16% 就會帶來 26% 成功率,已經超出證據能支持的範圍。對考慮語音代理的團隊,這段比較實際的訊號是:開場回應速度要當成獨立指標來盯,它決定後面所有優勢有沒有上場機會。延遲與任務完成率也是外部語音代理排行榜常見的欄位,例如 Phonic 發表 Phonic-1 語音代理時引用的 Artificial Analysis 榜單就同時列了首次出聲時間與任務成功率,兩者向來是分開計分的。
文章開頭把研究動機講得很直白:問題又複雜、壓力又大的時候,人們傾向用講的把它談完,不想用打字慢慢敲。情境實驗找來 98 位參與者,模擬航班取消後的改訂情境,每人依隨機順序各用一次語音代理與文字代理,完成後填寫問卷。85% 表示偏好語音,主要理由是解決速度與同理感。值得一提的是設計上的對稱:每位參與者兩種管道都用過,順序隨機,與代理端每個代理跟自己比較是同一種思路,都在消掉個體差異的干擾。
偏好與完成率是兩種指標。覺得語音舒服,不代表工作真的被完成;反過來說,成功處理也不保證顧客最喜歡那個管道。官方文章連結的航班情境影片屬於產品示範,不是這 98 人的實驗紀錄,引用時應把兩者分開。官方也在文中提出機制解釋:人說話的速度約是打字的三倍,口頭對話讓雙方持續往來,不必像文字訊息那樣中間停等。這個解釋方向合理,但屬於宣稱,研究本身並沒有直接驗證它;官方甚至提醒,聲音聽起來要平穩、有同理感,尤其是顧客已經不耐煩的時候,這已經是產品面的建議,不屬於研究結論。
這份研究的利益歸屬值得攤開。ElevenLabs 的產品線包含語音代理平台 ElevenAgents,文章結尾也直接寫明這是他們正在打造的東西:同一個代理、跨語音與文字共享知識與系統整合。研究結論與產品賣點方向一致:官方文案強調一個代理就能吃下兩種管道,而這份研究畫出的交叉點恰好也在說兩種管道各有舞台。數字本身沒有因此失效,但引用時應該連同出處與利益關係一起交代。
更實際的限制是原始對話資料並未公開。方法論只寫了納入條件與比較方式,沒有原始紀錄、業務類型分布或各代理的個別結果,外部無法重算任何一個百分比;引用時最穩妥的句式,是連樣本與時間一起寫進去,例如依 ElevenLabs 於 2026 年 11 月初發布、樣本為 469 個正式環境代理的分析。文章在 11 月 3 日更新過一次,內容仍可能調整;資料期間是 7 月到 9 月,之後語音模型一路在換,這些數字有明確的保存期限,引用時附上日期是基本動作。
從產品節奏看,這份研究出現的時點也有脈絡:ElevenLabs 十月下旬才推出 Eleven Realtime 的 Mini 與 Max 兩級即時語音代理,把延遲與託管責任一起收進平台;再往前,Studio 4.0 則把第三方影片模型接進自家剪輯工作台,同樣是把自己的服務包在別人的模型外面。這次的研究等於替語音代理產品線補上什麼情境該用語音的論據。
如果接受這條曲線,最直接的應用是分流而非選邊。查訂單狀態、改單一欄位這類短任務,文字的完成速度快、成功率也高;需要多輪釐清、涉及情緒與補償的複雜處理,語音在完成機會與處理時間兩端都有優勢。這是從研究結構推導的建議,官方文章並沒有直接下這個結論。
導入前最先要補的不是管道,而是驗收條件。研究裡每個業務的成功定義都不同,團隊得先寫下什麼算完成:資料是否真的更新、退款是否真的發出、轉人工的原因是否留在紀錄裡。說完成不等於完成,驗收要看環境的最終狀態,不能只看代理自己的回報;條件沒有先寫死,兩個管道的數字根本無法比較,也談不上分流;這個主題可以另看 AI 代理任務驗收的常見漏洞。
延遲則是語音端的入場券。如果開場回應壓不到能接受的區間,15 秒內掛斷那組數字提醒你,曲線右端的優勢根本沒有登場機會;把整段對話時長、顧客每次等待、成功案件耗時分開記錄,才看得出長對話究竟卡在哪個環節。這篇文章 11 月 3 日更新過一次,資料期間是 7 月到 9 月;之後模型與產品持續在變,這幾個百分比不會永久有效。
至於語音是否會全面取代文字客服,這份研究給的答案剛好相反:它畫出的交叉點,正是兩種管道各自該守住的位置。